
Resumen
La optimización de preferencias modifica un modelo generativo ajustando juicios comparativos y restringiendo la desviación respecto de una política de referencia. Este artículo distingue entre el proceso de comparación observado, un modelo latente de recompensa escalar y la política seleccionada por un objetivo de optimización. Deriva la solución para dos respuestas de la maximización de recompensa regularizada mediante KL, analiza la invariancia ante desplazamientos de la recompensa y construye un ciclo de preferencias de tres grupos que ninguna utilidad única de Bradley–Terry puede reproducir exactamente. La optimización directa de preferencias se trata como una reparametrización útil dentro de sus supuestos, y no como una identificación de los valores humanos. Las comprobaciones finitas ejecutables verifican la política analítica, la invariancia ante desplazamientos y el ciclo. Las figuras ilustran pérdidas y políticas declaradas, no mediciones de preferencias humanas ni pruebas de referencia de alineamiento.
1. Distinguir juicios, recompensas y políticas
Un conjunto de datos de preferencias contiene eventos: una persona o un evaluador ve una entrada y dos respuestas candidatas bajo una presentación determinada y, a continuación, emite un juicio. Un modelo de recompensa asigna puntuaciones numéricas destinadas a explicar esos eventos. Una política produce respuestas futuras. Estos tres objetos están conectados por decisiones de modelado, pero no son el mismo objeto. Una política puede mejorar la concordancia con los juicios recopilados sin establecer que sus salidas sean verdaderas, seguras u óptimas para todos los usuarios.
La distinción importa porque tanto la selección de comparaciones como las instrucciones de anotación afectan a las observaciones. Mostrar dos resúmenes concisos plantea una pregunta distinta de comparar un resumen conciso con una respuesta larga y especulativa. Un modelo entrenado con las etiquetas resultantes hereda este marco de muestreo. Por tanto, la pregunta científica pertinente es qué proceso de preferencias aproxima el modelo y cómo se generaliza esa aproximación. Interpretar una pérdida de entrenamiento baja como el descubrimiento de una utilidad humana objetiva elude esa pregunta en lugar de responderla.
2. Un modelo de comparaciones por pares establece un supuesto explícito
El artículo clásico de Bradley–Terry proporciona la referencia histórica de las comparaciones por pares. Aquí se ha verificado su identidad bibliográfica, aunque el texto completo del editor no fue accesible durante esta revisión; no se atribuye ningún teorema histórico detallado a ese texto no leído. La forma logística de comparación también se explicita en el artículo de DPO consultado.
Para este artículo, se supone que cada candidato tiene una puntuación real y que la probabilidad de elegir el primero es la función logística de la diferencia de puntuaciones. Se trata de un modelo estadístico de juicios repetidos, no de una definición de la preferencia en sí. Implica que el logaritmo de las odds de una elección frente a otra equivale a una diferencia de puntuaciones. Un desplazamiento aditivo común de todas las puntuaciones se cancela. Multiplicar las puntuaciones modifica las probabilidades de elección, salvo que también cambie la escala del ruido de comparación. Así, el origen de la escala no es identificable a partir de las comparaciones, y la escala numérica solo tiene significado en relación con un modelo de observación elegido. [1], [3]
3. La recopilación de retroalimentación forma parte del sistema de aprendizaje
Christiano y sus colegas demuestran el aprendizaje de recompensas a partir de comparaciones humanas de segmentos de trayectorias y el uso de esas recompensas aprendidas para el aprendizaje por refuerzo. Esto separa el aprendizaje del objetivo de la optimización del comportamiento. La demostración no convierte en representativo todo futuro conjunto de datos de preferencias ni elimina la necesidad de evaluar el comportamiento aprendido.
Considérese un proceso de recopilación de comparaciones que extrae ambos candidatos de una política de referencia de alcance reducido. Puede obtener etiquetas muy coherentes dentro de esa región, mientras deja otras salidas casi sin restricciones. Optimizar una recompensa ajustada puede entonces desplazar la distribución de salidas hacia regiones escasamente observadas. Recopilar nuevas comparaciones puede reducir esa brecha, pero introduce un bucle de retroalimentación: la política influye en qué ejemplos se juzgan después. Un sistema auditable registra el generador de candidatos, la población de evaluadores, las instrucciones, el tratamiento de los empates y las probabilidades de muestreo. Sin esos registros, la discrepancia entre dos políticas entrenadas puede reflejar poblaciones de anotadores distintas, en lugar de un algoritmo de optimización superior. [2]
4. La regularización KL selecciona una política respecto de una referencia
Para una entrada fija y un conjunto finito de respuestas, se maximiza la recompensa esperada menos beta por la divergencia KL respecto de una distribución de referencia con soporte positivo. Un multiplicador de Lagrange para la normalización produce una política proporcional a la probabilidad de referencia multiplicada por la exponencial del cociente entre la recompensa y beta. El objetivo es estrictamente cóncavo en el símplex con soporte para beta positiva, por lo que esta solución es única en él.
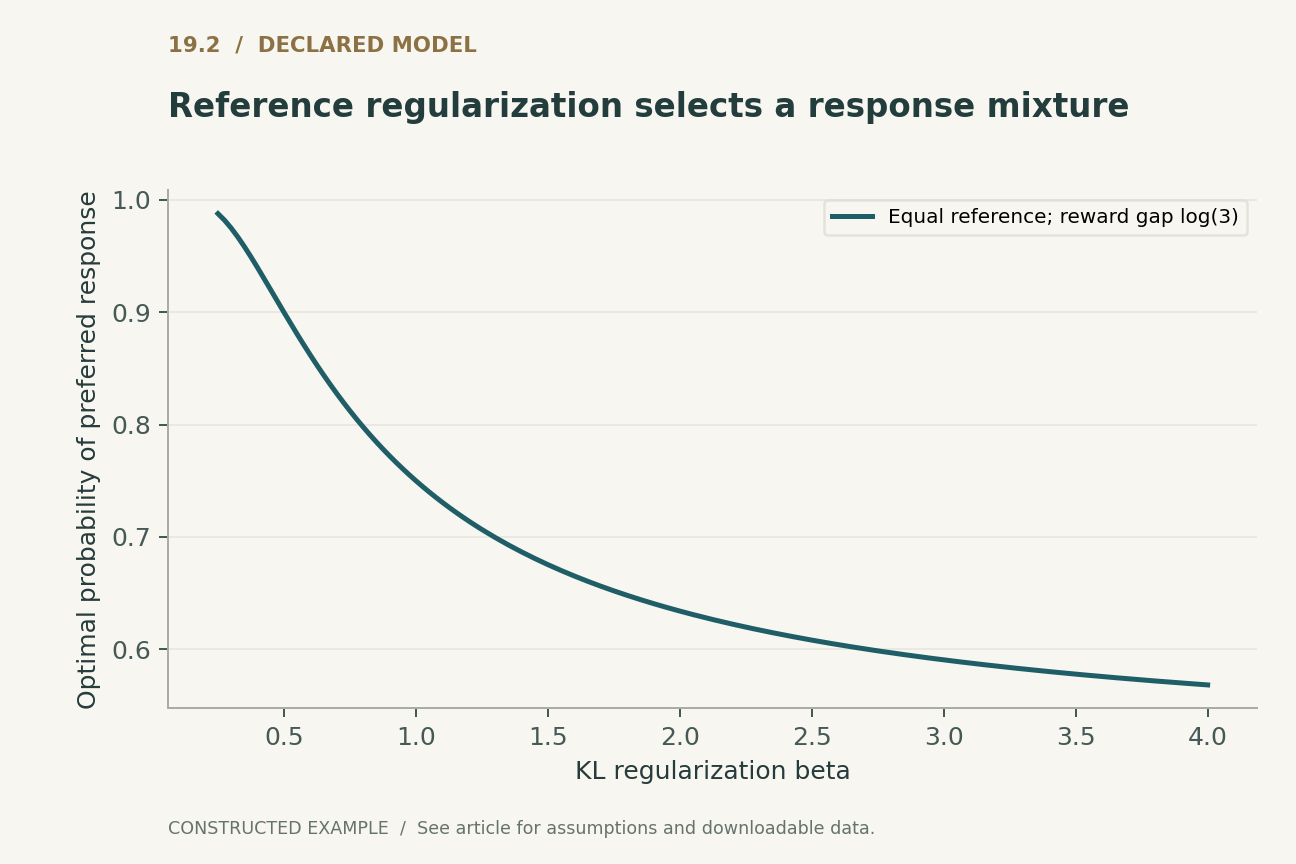
En una construcción con dos respuestas, supóngase que la referencia asigna una probabilidad de un medio a cada respuesta y que su diferencia de recompensa es el logaritmo de tres. Con beta igual a uno, la política óptima asigna una probabilidad de tres cuartos a la respuesta preferida. Aumentar beta acerca la política a la referencia; reducirla concentra la probabilidad en la recompensa más alta. Nuestra figura de la política muestra exactamente esta construcción. No es una escala de recompensa humana ajustada. Cambiar las probabilidades de referencia modifica la política seleccionada incluso si la diferencia comparativa de puntuaciones permanece fija, lo que demuestra que el objetivo de optimización contiene más que el orden observado.
5. La optimización directa cambia la parametrización
Rafailov y sus colegas derivan la optimización directa de preferencias expresando las recompensas mediante logaritmos de cocientes entre las probabilidades de la política y las de referencia. En una comparación de Bradley–Terry, el término de normalización dependiente de la entrada se cancela. Esto proporciona un objetivo de política basado en la verosimilitud comparativa sin una red de recompensa aprendida por separado.
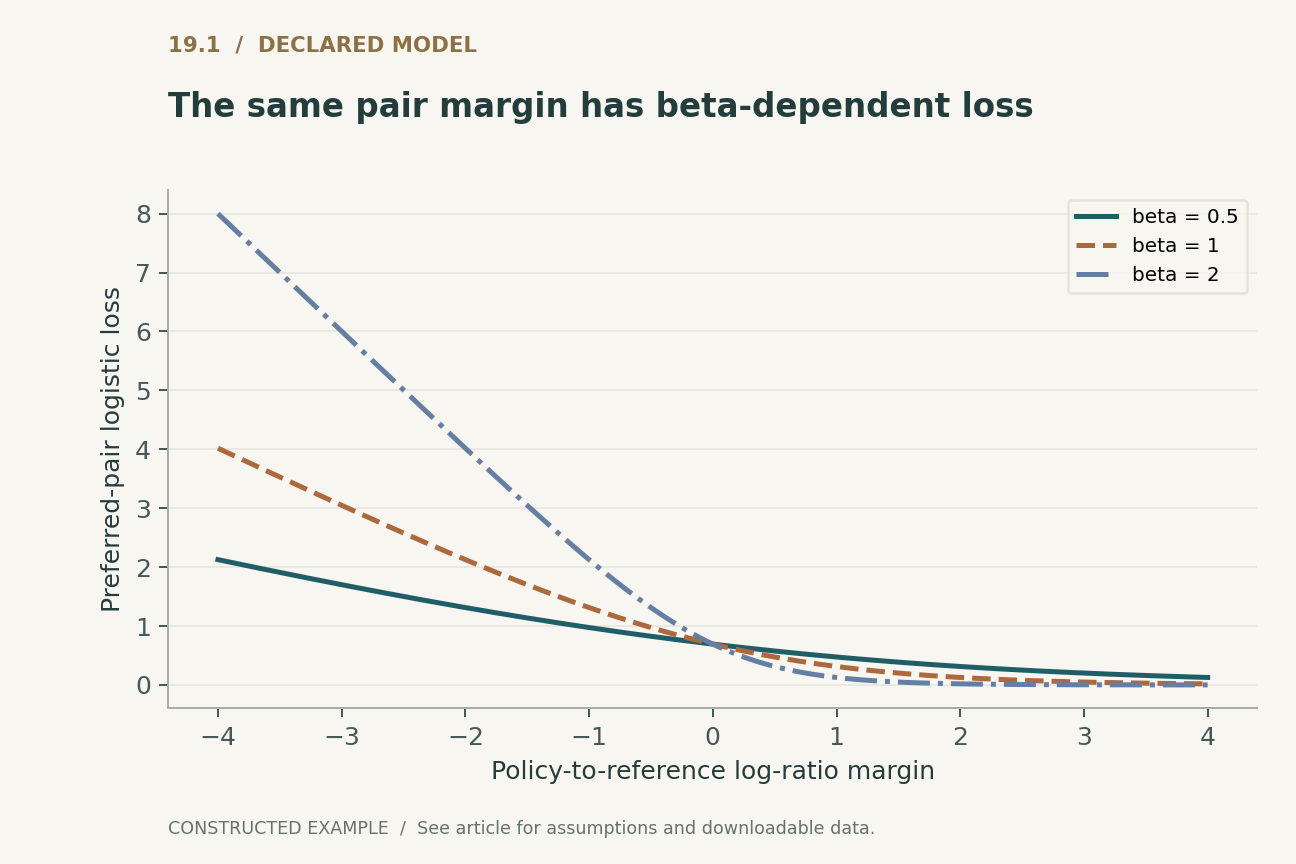
La cancelación es algebraica; no demuestra que un modelo de lenguaje parametrizado arbitrario alcance el óptimo global ni que una retroalimentación finita satisfaga la ley de comparación supuesta. En el caso de dos respuestas, la pérdida puede estudiarse directamente como función de un margen de logaritmos de cocientes. Un margen positivo mayor reduce la pérdida del par preferido, y beta controla su escala. La primera figura representa esta función declarada para varios valores de beta. Con margen cero, todas las curvas equivalen al logaritmo de dos. Esta intersección común es una comprobación útil de la implementación, pero una pérdida por pares idéntica puede coexistir con comportamientos de generación distintos en entradas o respuestas ausentes de los datos de comparación. [3]
6. Los orígenes de la recompensa desaparecen, pero el soporte sigue importando
Si se suma una constante específica de la entrada a la recompensa de cada respuesta, tanto sus probabilidades de comparación como su política óptima según KL permanecen inalteradas. La normalización exponencial absorbe la constante exactamente. La comprobación ejecutable verifica esta invariancia con varios vectores finitos de recompensas y desplazamientos. Esta falta de unicidad es inocua cuando el objetivo es seleccionar la misma política óptima; resulta engañosa si la magnitud absoluta de la recompensa se presenta como una cantidad medida directamente.
La condición de soporte es igualmente importante. Una probabilidad de referencia igual a cero hace que una masa positiva de la política en esa respuesta sea incompatible con una KL directa finita. Las fórmulas formales que implican un logaritmo del cociente entre política y referencia necesitan un dominio en el que el denominador sea positivo. Los modelos de lenguaje suelen asignar matemáticamente probabilidades de tokens no nulas, pero el truncamiento, el filtrado de candidatos y la precisión finita pueden generar exclusiones efectivas. Por tanto, el procedimiento de generación desplegado merece una descripción propia de su soporte. Un objetivo de entrenamiento sobre probabilidades de secuencias no caracteriza automáticamente un decodificador con filtrado.
7. Las preferencias agregadas pueden ser cíclicas
Se construyen tres grupos de evaluadores de igual tamaño con ordenaciones deterministas A por encima de B por encima de C, B por encima de C por encima de A, y C por encima de A por encima de B. En la población combinada, dos tercios prefieren A a B, dos tercios prefieren B a C y dos tercios prefieren C a A. Cada ordenación individual es transitiva; las probabilidades agregadas por pares forman un ciclo.
Un modelo logístico de puntuaciones escalares no puede ajustar exactamente las tres probabilidades. La suma de las tres diferencias de puntuación a lo largo de un ciclo debe ser cero, mientras que los tres logaritmos de odds observados suman tres veces el logaritmo de dos. Esto es un testigo finito de una especificación incorrecta del modelo, no una afirmación de que todo conjunto real de datos de preferencias contenga tal ciclo. Un modelo escalar ajustado debe adoptar una solución de compromiso, y un único valor de recompensa oculta qué grupo sale perjudicado en ella. Informar del desacuerdo entre subgrupos o permitir un modelo condicional más rico puede revelar información que una tasa de victorias agregada suprime. La precisión de la optimización no puede corregir una representación estadística incompatible.
8. La concordancia con las preferencias no es verificación factual
Bajo algunas instrucciones, puede preferirse una explicación fluida pero sin respaldo a otra precisa pero torpe. A la inversa, un evaluador al que se pida comprobar las citas puede favorecer una respuesta distinta. Estas posibilidades se desprenden de la distinción entre el proceso de observación y la propiedad de la tarea, no de suponer que los anotadores son irracionales. Una etiqueta de preferencia mide el juicio que se ha suscitado.
Por tanto, para un asistente académico, el respaldo factual debería contar con sus propias comprobaciones observables: existencia de las fuentes, correspondencia entre afirmación y fuente, coherencia de las ecuaciones y comportamiento de corrección. Estas comprobaciones pueden incluirse en las instrucciones de evaluación o anotación, pero su éxito debería seguir comunicándose por separado de una puntuación global de preferencia. Asimismo, la inocuidad, la brevedad y la realización de la tarea no tienen por qué estar perfectamente correlacionadas. Una recompensa compuesta codifica una compensación entre ellas. Los pesos y la población de evaluadores son decisiones de gobernanza y de producto, no cantidades que una verosimilitud por pares pueda inferir de manera única a partir de observaciones incompletas.
9. Verificar el mecanismo finito antes de ampliar el alcance de la afirmación
El código complementario contrasta el óptimo de dos respuestas con una malla densa de probabilidades de políticas candidatas, utilizando recompensas exactas y la referencia declarada. Verifica que la solución analítica alcanza un valor del objetivo al menos tan alto como el de cada punto de la malla, dentro de la tolerancia numérica. También comprueba la normalización y la invariancia ante la adición a las recompensas para distribuciones finitas pequeñas. Se trata de una prueba de coherencia numérica de un objetivo finito cóncavo, no de evidencia de convergencia en un espacio de parámetros neuronales.
Una enumeración independiente construye las tres ordenaciones de los evaluadores y cuenta sus elecciones por pares. El ciclo resultante se compara con la condición necesaria de suma cero para los logaritmos de odds escalares. La pérdida DPO representada se comprueba en cero y en márgenes seleccionados, y la curva de la política con beta igual a uno se contrasta con tres cuartos. Para este artículo no se realizó etiquetado humano, generación de continuaciones, entrenamiento de modelos de recompensa ni ajuste fino de políticas. El protocolo experimental propuesto más abajo requiere esas observaciones adicionales.
10. Evaluar un proceso, no un eslogan escalar
Un estudio defendible de optimización de preferencias fija el proceso de comparación, el modelo de referencia, el soporte, la regularización y la población de evaluación reservada. Informa de la concordancia con las etiquetas y del comportamiento bajo la decodificación real, incluidas entradas ajenas a la distribución de recopilación de retroalimentación. También mide las propiedades de la tarea que importan independientemente de la preferencia. Una tasa global de victorias solo resulta informativa junto con su conjunto de comparación y la incertidumbre y los desacuerdos que agrega.
La interpretación resultante es precisa. Los datos comparativos pueden identificar algunas diferencias de puntuación bajo un modelo de observación elegido. La regularización KL selecciona una política utilizando tanto esas diferencias como una distribución de referencia. Una pérdida directa de política puede simplificar la optimización sin resolver todos los problemas de representación, soporte o pluralidad de preferencias. Estos límites no son motivos para abandonar el aprendizaje de preferencias; especifican qué evidencia requeriría una afirmación más fuerte. Para un sistema fiable, conservar la procedencia de los juicios y los límites del modelo ajustado es tan importante como reducir su pérdida.
Ejecutado localmente · Alcance acotado
Óptimo KL finito, invariancia ante desplazamientos de la recompensa y preferencias poblacionales cíclicas
Recompensas finitas asignadas y tres grupos con ordenaciones deterministas. La comparación con una malla es una comprobación de coherencia numérica, no de convergencia neuronal ni una medición del alineamiento humano.
Se superaron 41 aserciones. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el testigo registrado
{
  "policy_grid_points": 10001,
  "beta_values_checked": [
    0.25,
    0.5,
    1.0,
    2.0,
    4.0
  ],
  "optimal_preferred_probability_beta1": 0.75,
  "cycle_pair_probabilities": [
    0.6666666666666666,
    0.6666666666666666,
    0.6666666666666666
  ],
  "cycle_logodds_sum": 2.0794415416798353,
  "scalar_score_required_sum": 0.0
}
Ejecutor del ejemplo · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Modelo logístico de observación de Bradley–Terry supuesto, también explícito en el artículo de DPO consultado. Representa probabilidades por pares; no es una ley universal del juicio humano.
(2) Óptimo para un conjunto finito de respuestas de la recompensa esperada menos beta por la KL directa respecto de una referencia positiva. Con masas de referencia iguales y una diferencia de recompensa log(3), la probabilidad de la respuesta preferida es 3/4 en beta=1.
(3) Objetivo DPO de Rafailov et al.; requiere comparaciones dentro del soporte. Su equivalencia de modelos no certifica la convergencia de la optimización neuronal ni la representatividad de la retroalimentación.
(4) Condición necesaria para un único modelo logístico de puntuaciones escalares con una entrada fija. La mezcla equiponderada construida de tres ordenaciones cíclicas produce 3 log(2), lo que la incumple.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Objeto | Qué registra | Supuesto adicional necesario |
|---|---|---|
| Juicio por pares | Una elección bajo una presentación y unas instrucciones | Representatividad del proceso de comparación |
| Recompensa escalar | Una explicación ajustada de las probabilidades de elección | Adecuación e identificabilidad del modelo de observación |
| Política óptima según KL | Compensación entre recompensa y desviación respecto de la referencia | Soporte, escala de recompensa y condiciones de optimización |
| Tasa de victorias en datos reservados | Concordancia respecto de un comparador y una población de evaluadores | Generalización a nuevos usuarios, tareas y propiedades independientes |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de referencia de sistemas en producción ni de hardware. Los modelos finitos ejecutados por separado están documentados en las comprobaciones ejecutables.
- Registrar la generación de candidatos, la población de evaluadores, las instrucciones, los empates y la procedencia de los juicios.
- Separar la retroalimentación utilizada para el ajuste, la selección del modelo y la evaluación final del comportamiento.
- Fijar la política de referencia, la convención de probabilidades de secuencia, el decodificador y la escala de regularización.
- Medir el desacuerdo entre subgrupos, la coherencia de las etiquetas repetidas y los patrones cíclicos de preferencias.
- Informar de la verificación factual o específica de la tarea por separado de la concordancia con las preferencias y de las tasas globales de victorias.
- Someter a pruebas de estrés nuevas poblaciones de entradas y salidas fuera del soporte, publicando la incertidumbre y ejemplos de fallos.
Qué establecen las fuentes primarias
Ralph Allan Bradley, Milton E. Terry · 1952 [1]
Contribución. Identifica la publicación clásica de comparaciones por pares utilizada como referencia histórica del modelo.
Límite. El texto completo del editor no fue accesible; no se reivindica ningún teorema no leído, y el modelo logístico se especifica aquí de forma independiente.
Localización de la fuente. Registro bibliográfico: Biometrika 39(3/4), 324–345.
Paul F. Christiano, Jan Leike, Tom B. Brown et al. · 2017 [2]
Contribución. Demuestra el aprendizaje de una recompensa a partir de comparaciones humanas de trayectorias y la optimización del comportamiento con ella.
Límite. Las demostraciones específicas de tareas no identifican preferencias universales.
Localización de la fuente. Método y bucle de aprendizaje de preferencias.
Rafael Rafailov, Archit Sharma, Eric Mitchell et al. · 2023 [3]
Contribución. Reparametriza un objetivo de preferencias regularizado mediante KL a través de cocientes entre política y referencia.
Límite. Requiere sus supuestos sobre el modelo de comparación y el soporte; el ajuste neuronal finito añade errores de estimación y optimización.
Localización de la fuente. Secciones 3–5 y apéndice A.
Límites de este análisis
- Los ejemplos utilizan conjuntos finitos de respuestas y recompensas asignadas, en lugar de modelos de lenguaje entrenados.
- La publicación original de Bradley–Terry se verificó bibliográficamente; su texto completo no fue accesible durante esta revisión.
- El ciclo de tres grupos es un testigo construido de incompatibilidad, no una estimación empírica del desacuerdo humano.
- No se realizó ningún experimento de ajuste fino de políticas ni de anotación humana; estas son evaluaciones propuestas.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre el acceso a las fuentes y sus versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué metadatos de anotación son suficientes para distinguir el error del modelo del desacuerdo en la población de evaluadores?
- ¿Cómo debería la recopilación de retroalimentación distribuir las comparaciones fuera del soporte familiar de la política actual?
- ¿Cuándo son preferibles los modelos de preferencias condicionales o no escalares a una recompensa escalar agregada?
Referencias
- Ralph Allan Bradley, Milton E. Terry. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika (1952). 10.2307/2334029.
- Paul F. Christiano, Jan Leike, Tom B. Brown et al.. Deep Reinforcement Learning from Human Preferences. Advances in Neural Information Processing Systems 30 (2017). Primary source.
- Rafael Rafailov, Archit Sharma, Eric Mitchell et al.. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Advances in Neural Information Processing Systems 36 (2023). 10.52202/075280-2338.
Acceso a la fuente [1]. Se verificaron los metadatos primarios del número de la revista. El artículo directo y el texto completo del editor no estuvieron disponibles mediante la herramienta de navegación; no se reivindica una auditoría de teoremas del texto completo.
Acceso a la fuente [2]. Se inspeccionaron el registro primario y secciones seleccionadas accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Acceso a la fuente [3]. Se inspeccionaron el registro primario y secciones seleccionadas accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Nota de versión. El orden de autoría sigue el PDF original de la conferencia; su página de destino HTML ordena a Ermon y Manning de forma distinta.
Las identidades bibliográficas se contrastaron con los registros primarios de los editores y autores. Las notas de acceso a las fuentes y de versión que figuran a continuación describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Escrito y autorrevisado técnicamente por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, con Python y CSV proporcionados. No son mediciones de productos desplegados ni reproducciones de pruebas de referencia de rendimiento.
Este borrador local no tiene constancia de revisión por pares independiente ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.