
要旨
選好最適化は、比較判断に適合させ、参照方策からの乖離を制約することによって生成モデルを変更する。本稿は、観測された比較過程、潜在的なスカラー報酬モデル、最適化目的によって選択される方策を区別する。KL正則化付き報酬最大化における二応答の場合の解を導出し、報酬のオフセット不変性を解析するとともに、単一のBradley–Terry効用では厳密に再現できない三集団の選好循環を構成する。直接選好最適化は、人間の価値の同定としてではなく、その仮定の範囲内で有用な再パラメータ化として扱う。実行可能な有限検証によって、解析的な方策、オフセット不変性、循環を確認する。図は明示した損失と方策を示すものであり、人間の選好の測定やアラインメントのベンチマークではない。
1. 判断、報酬、方策を区別する
選好データセットには事象が含まれる。ある人または評価者が、特定の提示形式の下でプロンプトと二つの候補応答を見て、判断を下す。報酬モデルは、それらの事象を説明するための数値スコアを割り当てる。方策は将来の応答を生成する。これら三つの対象はモデル化上の選択によって結び付けられるが、同じ対象ではない。方策は、収集された判断との一致を改善しても、その出力が真実であり、安全であり、あらゆる利用者にとって最適であることを確立するわけではない。
この区別が重要なのは、比較対象の選択とアノテーションの指示の双方が観測に影響するためである。簡潔な要約を二つ提示することは、簡潔な要約と長く推測的な回答を比較することとは異なる問いを投げかける。得られたラベルで訓練されたモデルは、この標本抽出の枠組みを引き継ぐ。したがって、科学的に問うべきなのは、モデルがどの選好過程を近似し、その近似がどのように汎化するかである。訓練損失の低さを客観的な人間の効用の発見と見なすことは、この問いに答えるのではなく、問いを迂回することである。
2. 一対比較モデルは明示的な仮定を置く
Bradley–Terryの古典的論文は、一対比較の歴史的な参照文献を提供する。本稿ではその書誌的同一性を確認したが、本レビューの実施中、出版社の全文にはアクセスできなかった。そのため、未読の本文に詳細な歴史的定理を帰属させることはしない。ロジスティック型の比較形式は、閲覧したDPO論文にも明示されている。
本稿では、各候補が実数値のスコアを持ち、最初の候補が選ばれる確率がスコア差のロジスティック関数であると仮定する。これは反復される判断の統計モデルであり、選好そのものの定義ではない。このモデルは、一方を他方より選ぶ対数オッズがスコア差に等しいことを意味する。全スコアに共通する加法的なシフトは相殺される。スコアに定数を乗じると、比較ノイズの尺度も同時に変わらない限り、選択確率は変化する。したがって、尺度の原点は比較から同定できず、数値的な尺度は選択された観測モデルに対してのみ意味を持つ。 [1], [3]
3. フィードバック収集は学習システムの一部である
Christianoらは、軌跡区間の人間による比較から報酬を学習し、その学習した報酬を強化学習に用いることを実証している。これは、目的の学習と行動の最適化を分離する。この実証によって、将来のあらゆる選好データセットが代表性を持つようになるわけでも、学習された行動を評価する必要がなくなるわけでもない。
両方の候補を範囲の狭い参照方策から抽出する比較収集過程を考える。その領域内では非常に一貫したラベルが得られても、他の出力はほとんど制約されないままになりうる。その後、適合した報酬を最適化すると、出力分布が観測の乏しい領域へ移る可能性がある。新たな比較の収集はこの隔たりを縮めうるが、フィードバックループを導入する。すなわち、次にどの例が判断されるかに方策が影響する。監査可能なシステムは、候補生成器、評価者母集団、指示、同順位の扱い、標本抽出確率を記録する。これらの記録がなければ、訓練済みの二つの方策の不一致は、最適化アルゴリズムの優劣ではなく、アノテータ母集団の違いを反映している可能性がある。 [2]
4. KL正則化は参照に対して相対的に方策を選択する
固定したプロンプトと有限の応答集合に対し、期待報酬から、正の確率を持つ参照分布に対するKLダイバージェンスのベータ倍を引いたものを最大化する。正規化のためのラグランジュ乗数を用いると、参照確率に、報酬をベータで割った値の指数関数を乗じたものに比例する方策が得られる。ベータが正のとき、目的関数は台に対応する単体上で狭義凹であるため、その上で解は一意である。
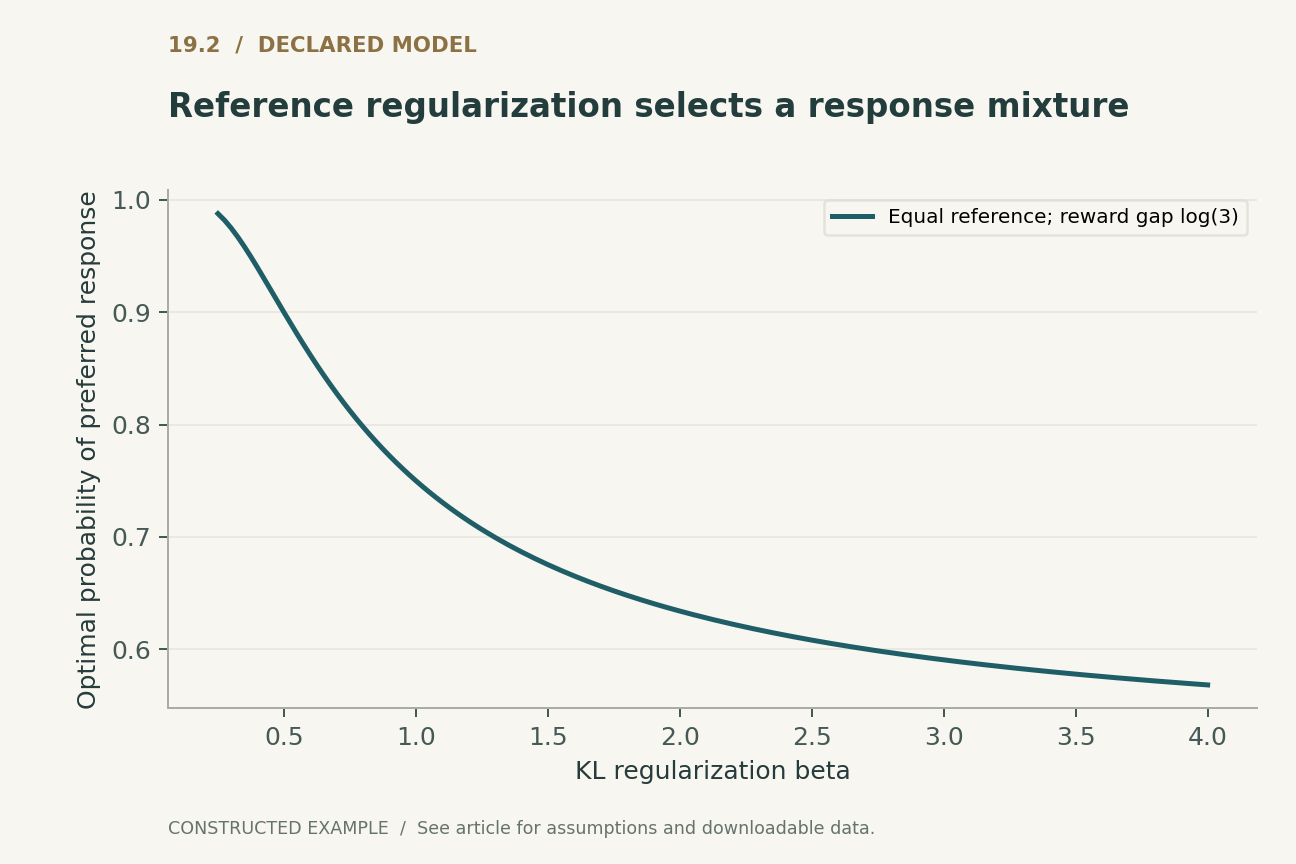
二応答の構成では、参照が各応答に二分の一の確率を割り当て、両者の報酬差を三の対数とする。ベータが一のとき、最適方策は好まれる応答に四分の三の確率を割り当てる。ベータを大きくすると方策は参照に近づき、小さくすると高い報酬に確率が集中する。本稿の方策の図は、この構成を厳密に示している。これは人間の報酬尺度を適合したものではない。比較スコアの差が固定されていても、参照確率を変えると選択される方策は変わる。このことは、最適化目的に観測された順序以上のものが含まれることを示している。
5. 直接最適化はパラメータ化を変える
Rafailovらは、報酬を方策と参照の対数確率比で表すことによって、直接選好最適化を導出する。Bradley–Terry比較では、プロンプトに依存する正規化項が相殺される。これにより、別個に学習する報酬ネットワークを用いず、比較尤度に基づく方策の目的関数が得られる。
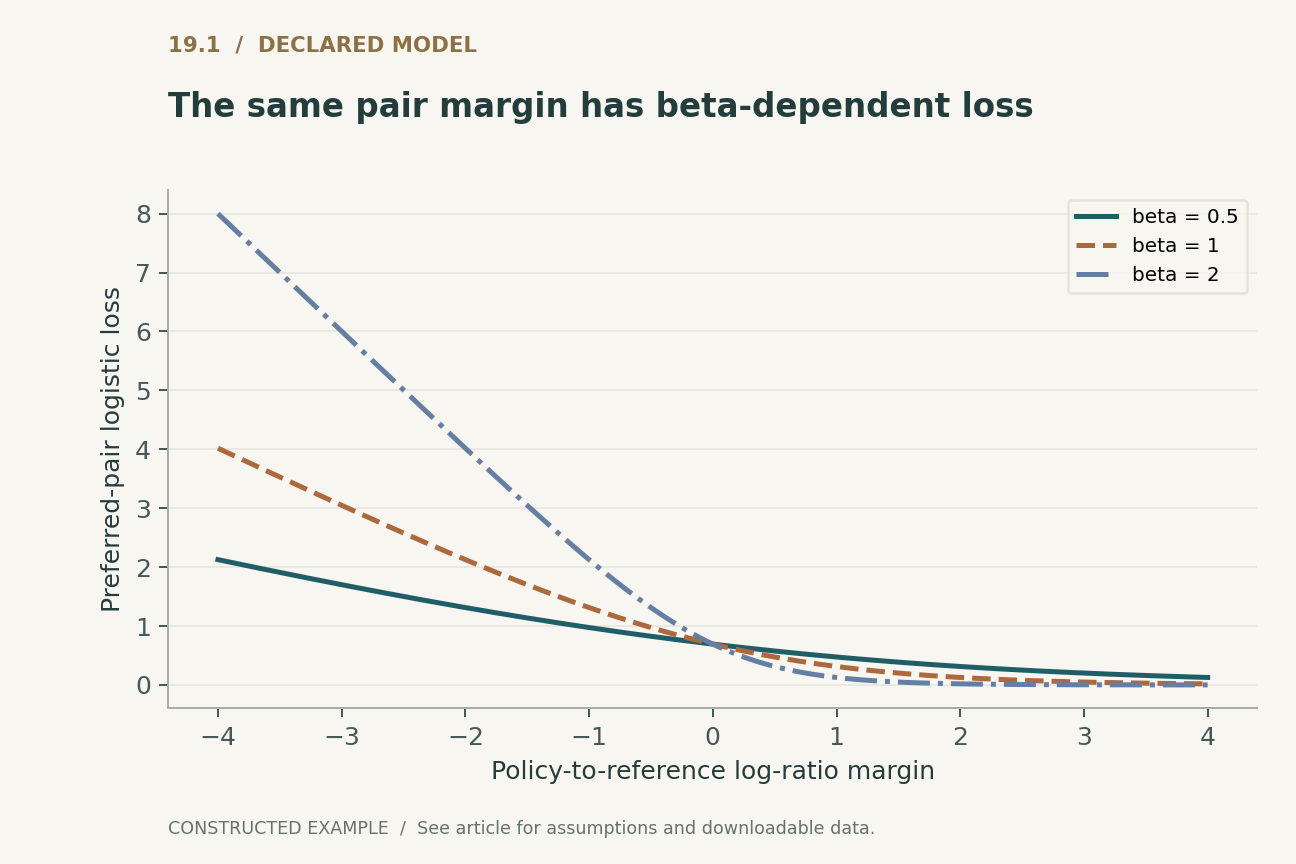
この相殺は代数的なものであり、任意のパラメータ化された言語モデルが大域的最適解に到達することや、有限のフィードバックが仮定した比較法則を満たすことを示すものではない。二応答の場合、損失は対数比マージンの関数として直接調べられる。正のマージンが大きいほど選好対の損失は低下し、ベータがその尺度を制御する。最初の図は、明示したこの関数を複数のベータ値について描いている。マージンがゼロでは、すべての曲線が二の対数に等しい。この共通の交点は実装の確認に有用であるが、比較データに含まれないプロンプトや応答では、同一の対損失と異なる生成挙動が両立しうる。 [3]
6. 報酬の原点は消えるが、台は依然として重要である
各応答の報酬にプロンプト固有の定数を加えても、その比較確率とKL最適方策はいずれも変化しない。指数関数の正規化が、その定数を厳密に吸収する。実行可能な検証では、複数の有限報酬ベクトルとオフセットを用いてこの不変性を確認する。同じ最適方策を選択することが目的であれば、このような非一意性は問題にならない。しかし、報酬の絶対的な大きさを直接測定された量として提示すると、誤解を招く。
台の条件も同様に重要である。参照確率がゼロの応答に方策が正の確率質量を与えることは、有限の順方向KLとは両立しない。方策と参照の比の対数を含む形式的な式には、分母が正である定義域が必要である。言語モデルは数学的にはトークンに非ゼロの確率を割り当てることが多いが、打ち切り、候補のフィルタリング、有限精度によって実質的な排除が生じうる。したがって、実運用の生成手続きについては、その台を独立に記述する必要がある。系列確率に対する訓練目的が、フィルタリングを伴うデコーダを自動的に特徴付けるわけではない。
7. 集約された選好は循環しうる
同じ大きさの評価者集団を三つ構成し、それぞれの決定論的順位を、AがBより上でBがCより上、BがCより上でCがAより上、CがAより上でAがBより上とする。結合した母集団では、三分の二がAをBより好み、三分の二がBをCより好み、三分の二がCをAより好む。各個人の順位は推移的であるが、集約された一対比較確率は循環を形成する。
スカラーのロジスティック・スコアモデルは、三つの確率すべてに厳密に適合することはできない。循環に沿う三つのスコア差の和はゼロでなければならないのに対し、観測された三つの対数オッズの和は二の対数の三倍になる。これはモデルの誤特定を示す有限の例証であり、現実のあらゆる選好データセットにこのような循環が含まれるという主張ではない。適合されたスカラーモデルは妥協せざるをえず、単一の報酬値はその妥協でどの集団が不利益を受けるかを隠してしまう。部分集団の不一致を報告したり、より豊かな条件付きモデルを認めたりすることで、集約された勝率が覆い隠す情報を明らかにできる。最適化の精度によって、整合しない統計表現を修復することはできない。
8. 選好との一致は事実の検証ではない
ある指示の下では、流暢だが裏付けのない説明が、正確だがぎこちない説明より好まれることがある。逆に、引用の確認を求められた評価者は、別の応答を好む可能性がある。これらの可能性は、観測過程と課題特性の区別から生じるものであり、アノテータが非合理的だという仮定から生じるものではない。選好ラベルが測定するのは、引き出された判断である。
したがって、学術支援アシスタントでは、事実的な裏付けについて独自の観測可能な確認項目を設けるべきである。具体的には、出典の存在、主張と出典の対応、方程式の整合性、訂正時の挙動である。これらは評価やアノテーションの指示に含められるが、その達成度は総合的な選好スコアとは別に報告すべきである。同様に、無害性、簡潔さ、課題の完遂が完全に相関する必要はない。複合報酬はそれらの間のトレードオフを符号化する。重みと評価者母集団はガバナンスおよび製品上の選択であり、不完全な観測から一対比較尤度が一意に推定できる量ではない。
9. 主張の範囲を拡大する前に有限の仕組みを検証する
付属コードは、厳密な報酬と明示した参照を用い、二応答の最適解を候補方策確率の密な格子と照合する。解析解が達成する目的関数値が、数値許容誤差の範囲で、どの格子点の値以上でもあることを確認する。また、小規模な有限分布について正規化と報酬の加法的不変性を検証する。これは凹な有限目的関数の数値的整合性検査であり、ニューラルネットワークのパラメータ空間における収束の証拠ではない。
別の列挙処理では、評価者の三つの順位すべてを構成し、その一対比較での選択を数え上げる。得られた循環を、スカラーの対数オッズに必要なゼロ和条件と比較する。描画したDPO損失をゼロおよび選択したマージンで確認し、ベータが一のときの方策曲線を四分の三と照合する。本稿では、人間によるラベル付け、補完文の生成、報酬モデルの訓練、方策のファインチューニングは実施していない。以下に提案する実験プロトコルには、それらの追加観測が必要である。
10. スカラーの標語ではなく、過程を評価する
妥当性を擁護できる選好最適化研究では、比較過程、参照モデル、台、正則化、ホールドアウト評価母集団を固定する。フィードバック収集分布の外にあるプロンプトも含め、ラベルとの一致と実際のデコーディング下での挙動を報告する。また、選好とは独立に重要な課題特性も測定する。総合勝率が有益なのは、その比較集合、および集約される不確実性や不一致と併せて提示される場合に限られる。
そこから得られる解釈は明確である。比較データは、選択した観測モデルの下で一部のスコア差を同定できる。KL正則化は、その差と参照分布の双方を用いて方策を選択する。直接的な方策損失は最適化を簡素化できるが、表現、台、多元的な選好に関するすべての問題を解決するわけではない。こうした境界は選好学習を断念する理由ではなく、より強い主張にどのような証拠が必要かを明らかにする。信頼できるシステムにとって、判断の来歴と適合モデルの限界を保持することは、損失を低減することと同じく重要である。
ローカルで実行済み · 限定された範囲
有限のKL最適解、報酬のオフセット不変性、循環する母集団の選好
有限個の割り当てられた報酬と、決定論的順位を持つ三つの集団。格子との比較は数値的整合性の確認であり、ニューラルネットワークの収束や人間とのアラインメントの測定ではない。
41件のアサーションに合格した。 これらの検証が妥当性を確認するのは提示した例であり、引用したシステムではない。
記録された例証を確認する
{
  "policy_grid_points": 10001,
  "beta_values_checked": [
    0.25,
    0.5,
    1.0,
    2.0,
    4.0
  ],
  "optimal_preferred_probability_beta1": 0.75,
  "cycle_pair_probabilities": [
    0.6666666666666666,
    0.6666666666666666,
    0.6666666666666666
  ],
  "cycle_logodds_sum": 2.0794415416798353,
  "scalar_score_required_sum": 0.0
}
例の実行プログラム · モデルローダー · 訓練モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全体を読む
明示された解析モデル
四つの方程式と明示的な仮定
(1) 仮定したBradley–Terryロジスティック観測モデルであり、閲覧したDPO論文にも明示されている。一対比較確率を表すものであり、人間の判断の普遍法則ではない。
(2) 期待報酬から、正の参照分布に対する順方向KLのベータ倍を引いたものの、有限応答集合における最適解。参照確率質量が等しく、報酬差がlog(3)のとき、beta=1.における好まれる応答の確率は3/4である
(3) RafailovらのDPO目的関数。台の内部にある比較を必要とする。そのモデル上の等価性は、ニューラル最適化の収束やフィードバックの代表性を保証しない。
(4) 固定したプロンプトにおける単一のスカラー・ロジスティック・スコアモデルの必要条件。三つの循環順位を等しい重みで混合した構成では3 log(2)となり、この条件に違反する。
構成した例 · 再現可能なデータ
定量的な議論を確認する
これらの曲線は、明示したモデルから計算される。引用した研究の観測結果ではない。各図には数値データとベクトル版が付属する。


どの証拠がどの問いに答えるのか
| 対象 | 記録するもの | 必要な追加仮定 |
|---|---|---|
| 一対比較判断 | 提示形式と指示の下での選択 | 比較過程の代表性 |
| スカラー報酬 | 選択確率に対する適合された説明 | 観測モデルの適切性と同定可能性 |
| KL最適方策 | 報酬と参照からの乖離のトレードオフ | 台、報酬尺度、最適化条件 |
| ホールドアウトでの勝率 | 比較対象と評価者母集団に対する相対的な一致 | 新しい利用者、課題、独立した特性への汎化 |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証に記録されている。
- 候補生成、評価者母集団、指示、同順位、判断の来歴を記録する。
- 適合、モデル選択、最終的な行動評価に用いるフィードバックを分離する。
- 参照方策、系列確率の規約、デコーダ、正則化尺度を固定する。
- 部分集団の不一致、反復ラベルの一貫性、循環的な選好パターンを測定する。
- 事実に関する検証または課題固有の検証を、選好との一致や総合勝率とは別に報告する。
- 新しいプロンプト母集団と台の外にある出力をストレステストし、不確実性と失敗例を公開する。
一次資料が確立していること
Ralph Allan Bradley, Milton E. Terry · 1952 [1]
貢献。 モデルの歴史的参照文献として用いる、古典的な一対比較の刊行物を特定する。
境界。 出版社の全文にはアクセスできなかった。未読の定理についての主張は行わず、ロジスティックモデルは本稿で独立に規定する。
資料内の参照箇所。 書誌記録:Biometrika 39(3/4), 324–345。
Paul F. Christiano, Jan Leike, Tom B. Brown et al. · 2017 [2]
貢献。 人間による軌跡比較から報酬を学習し、それを用いて行動を最適化することを実証する。
境界。 課題固有の実証は、普遍的な選好を同定するものではない。
資料内の参照箇所。 手法と選好学習ループ。
Rafael Rafailov, Archit Sharma, Eric Mitchell et al. · 2023 [3]
貢献。 方策と参照の比を通じて、KL正則化付き選好目的関数を再パラメータ化する。
境界。 その比較モデルと台に関する仮定を必要とする。有限のニューラルモデル適合には、推定誤差と最適化誤差が加わる。
資料内の参照箇所。 第3–5節および付録A。
本解析の限界
- 例では、訓練された言語モデルではなく、有限の応答集合と割り当てた報酬を用いる。
- Bradley–Terryの原著は書誌的に確認したが、本レビューの実施中、その全文にはアクセスできなかった。
- 三集団の循環は、非整合性を示すために構成した例証であり、人間の不一致の実証的推定ではない。
- 方策のファインチューニングや人間によるアノテーションの実験は実施しておらず、これらは提案段階の評価である。
選定した三つの基礎的な一次資料に焦点を当てた解析的レビューであり、独自の具体的な計算例を含む。2026までの文献を網羅的または系統的に調査したものではない。資料へのアクセスと版に関する注記は、参考文献とともに記録している。
結論を変えうる問い
- モデル誤差と評価者母集団内の不一致を区別するには、どのアノテーション・メタデータが十分なのか。
- 現在の方策が慣れ親しんだ台の外にある比較に対し、フィードバック収集をどのように配分すべきか。
- 条件付きまたは非スカラーの選好モデルが、集約されたスカラー報酬より望ましいのはどのような場合か。
参考文献
- Ralph Allan Bradley, Milton E. Terry. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika (1952). 10.2307/2334029.
- Paul F. Christiano, Jan Leike, Tom B. Brown et al.. Deep Reinforcement Learning from Human Preferences. Advances in Neural Information Processing Systems 30 (2017). Primary source.
- Rafael Rafailov, Archit Sharma, Eric Mitchell et al.. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Advances in Neural Information Processing Systems 36 (2023). 10.52202/075280-2338.
資料[1]へのアクセス。 一次資料である雑誌号のメタデータを確認した。ブラウジングツールからは論文そのものと出版社の全文を利用できず、全文の定理を監査したとは主張しない。
資料[2]へのアクセス。 一次記録と、アクセス可能な全文の選定した節を確認した。補足資料の網羅的な監査は行っていない。
資料[3]へのアクセス。 一次記録と、アクセス可能な全文の選定した節を確認した。補足資料の網羅的な監査は行っていない。
版に関する注記。 著者順は会議の一次資料であるPDFに従う。そのHTMLランディングページでは、ErmonとManningの順序が異なる。
書誌的同一性は、出版社および著者の一次記録と照合した。以下の資料アクセスと版に関する注記が確認範囲を示しており、全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示しており、解析的な構成と提案した評価設計は本稿に帰属する。
表紙はImageGenによる概念的イラストである。技術図は、明示したモデルまたは有限の例から計算し、PythonとCSVを提供している。実運用製品の測定や性能ベンチマークの再現ではない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検査するものであり、引用したシステムの形式検証ではない。