
要旨
分布シフト下の汎化は、何が安定しているか、どのようなターゲット観測が利用可能か、そしてそこから生じる逆問題が識別可能かに依存する。本総説は、明示的な有限の例を用いて、共変量による重み付け、ラベルシフト推定、不変予測を対比する。重要度重みのオーバーラップに伴うペナルティ、混同行列の逆算における条件の悪さに伴うペナルティ、ならびに観測上は識別不能でありながら分類結果が正反対となる二つのターゲット世界を導く。図は、ベンチマークではなく、これらの明示された構成を定量化する。実行可能な検証は、仮定が成立する場合に既知のターゲット事前分布を回復し、成立しない場合には識別の失敗を示す。提案する深層学習の評価プロトコルは、検出、補正、そしてシフトモデル自体に関する不確実性を分離する。
1. 分布シフトは単一の数学的問題ではない
ニューラルモデルは入力と結果の同時分布から学習される一方、運用時には別の分布が与えられる。分布が異なると述べるだけでは、利用可能な観測から何を学べるかは特定されない。結果の条件付き分布が安定したまま入力頻度が変わることは、クラス条件付き入力分布が安定したままクラス頻度が変わることとは異なる。ラベルの意味の変化は、そのいずれとも異なる。したがって、適応手法はあらゆる不一致を修正する汎用的な補正ではなく、あるシフトの族についての主張である。
何が観測されるかを列挙すると有用である。すなわち、ラベル付きソース事例、ラベルのないターゲット入力、環境識別子、そして場合によっては遅れて得られるターゲットラベルのストリームである。それぞれの観測は、候補となる説明の一部を排除できる。しかし、どの観測も未観測の条件付き分布を自動的に識別するわけではない。本分析は、この情報上の境界に焦点を当てる。より大きなネットワークは、より複雑な写像を近似できるが、表現能力はどのターゲット写像が正しいかについて欠けている証拠を補わない。
2. 共変量による重み付けは測度変換である
Sugiyama、Krauledat、Müllerは、入力の周辺分布が異なる一方で結果の条件付き分布が固定される共変量シフトの下で、重要度重み付き交差検証を研究している。その研究は、ターゲットとソースの入力密度比に従って検証損失を重み付けする根拠を与える。
固定された予測器について、この恒等式はターゲット期待値を展開し、ソース密度を掛けて割ることで得られる。これには、ターゲットの台がソースの台に含まれることと、重み付き損失の可積分性が必要である。ターゲット領域に正の確率があるにもかかわらずソース確率がゼロであれば、いかなる有限の重みも欠けているラベル付き事例を作り出せない。オーバーラップがあっても、密度比の推定は別個の統計的課題である。深層表現は次元を削減することで比の推定を容易にしうるが、結果の条件付き分布に関する仮定を維持するために必要な区別を捨てる可能性もある。したがって、表現空間での重み付けの妥当性は、その空間で正当化されなければならない。便利な低次元の識別器があるというだけでは導かれない。 [1]
3. オーバーラップが有用なデータ量を左右する
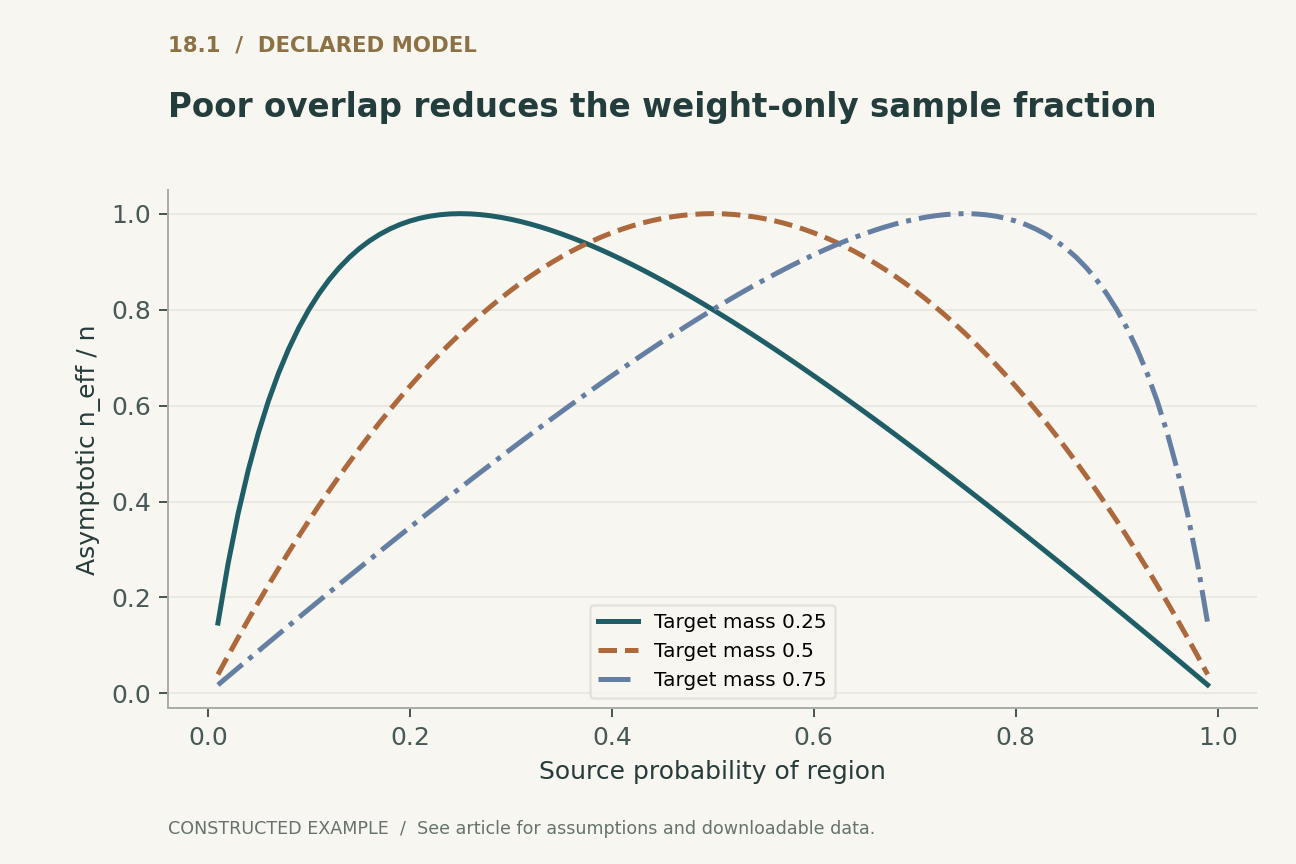
ある希少領域の確率がaであるソース母集団を考え、ターゲットではその領域に二分の一の確率が割り当てられるとする。二つの重要度重みは、二分の一をaで割った値と、二分の一を一からaを引いた値で割った値である。ソースでの期待値は一だが、二次モーメントはaが小さくなるにつれて増大する。独立な抽出では、重みだけに基づく通常の漸近的な有効標本サイズの比率は、その二次モーメントの逆数であり、ここでは四とaと一からaを引いた値の積となる。
aが十分の一のとき、この比率は0.36である。aが百分の一のときは0.0396である。これらは母集団レベルの重みの診断量であり、すべての損失推定量が厳密にその分散を持つことや、有限の観測標本に必要な希少事例が含まれることを保証するものではない。最初の図では、ソースの確率質量を変化させ、複数のターゲット確率質量を用いる。この曲線はオーバーラップの仮定を可視化する。生の標本数が大きくても、ターゲット領域に関係する情報量は少ない場合がある。
4. クリッピングはある失敗形態を別のものに置き換える
大きな重みは不安定性を生むため、実装では重みをクリッピングすることがある。二領域の例で、希少領域のソース確率を十分の一、ターゲット確率を二分の一とし、その領域でのみ損失を一とする。正確なターゲットリスクは二分の一、重み付けしないソースリスクは十分の一である。希少領域の正しい重みは五である。これを二にクリッピングすると、正規化されていない重み付き期待値は五分の一となり、下方バイアスが生じる。
クリッピングした重みを再正規化すると答えはさらに変わるが、元の測度変換の恒等式は回復しない。それでもクリッピングは有限データでの平均二乗推定誤差を改善しうるが、そのためにはバイアスと分散に関する目的を明示し、評価する必要がある。報告には、重みの分位点、オーバーラップの診断、クリッピング閾値、結論の感度を示すべきである。数値的に安定した重み付きスコアを自動的に不偏とみなすことは、計算で最も重大な仮定を見えにくくする。
5. ラベルシフトは逆問題である
Lipton、Wang、Smolaは、クラス条件付き入力分布が安定し、ソースの台と可逆性に関する仮定が成立する下で、ブラックボックスシフト推定を開発している。この手法は、予測器の混同に関する情報を利用して、変化したターゲットのラベル比率を推定する。
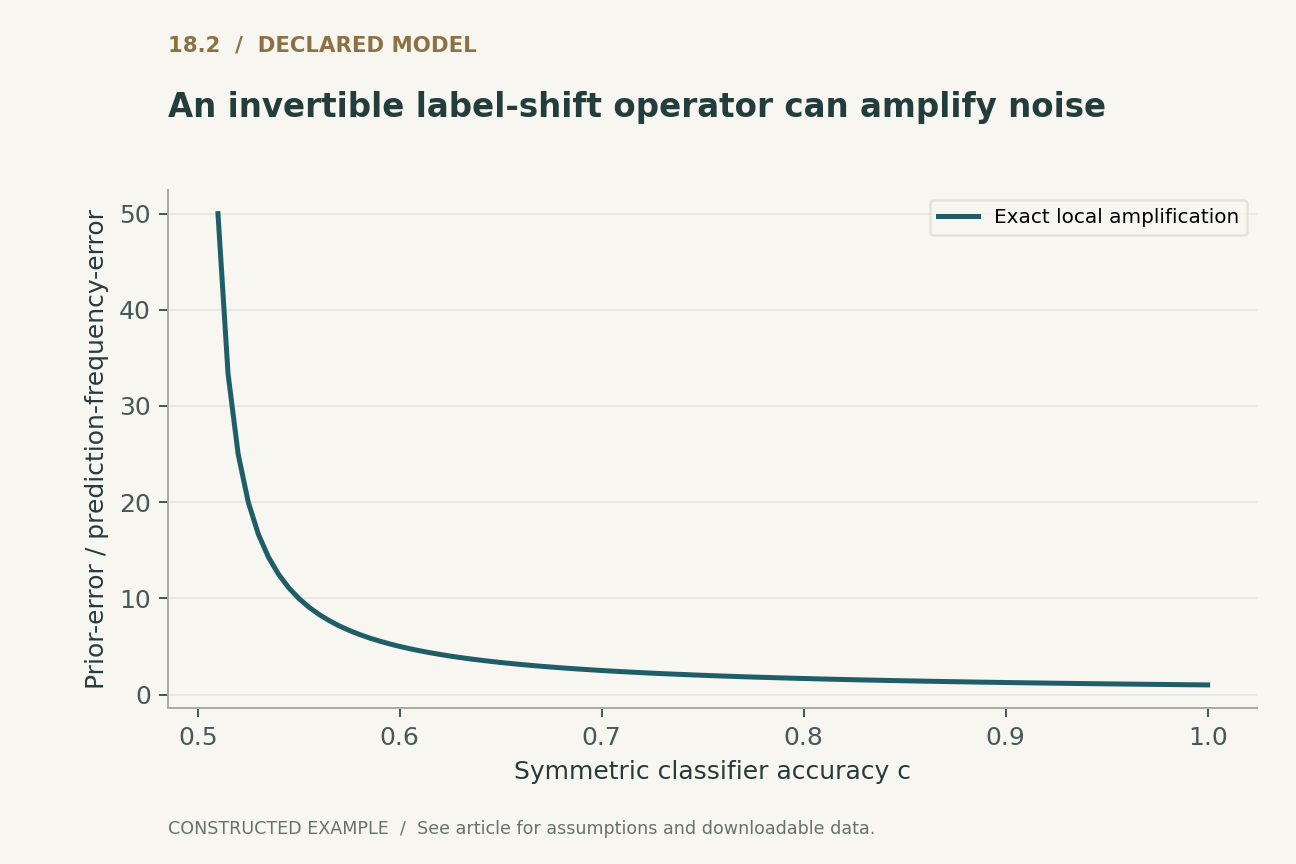
本稿の二値構成では、固定された分類器が、いずれのラベルを条件としても対称な正解率cを持つとする。ターゲットの陽性クラス事前確率をpiとすると、陽性予測頻度は、一からcを引いた値に、二倍のcから一を引いた値とpiの積を加えたものとなる。cが二分の一と異なれば、piについて解くことができる。cが0.8、piが0.3の場合、観測される陽性比率は0.38であり、逆算によって0.3が回復される。この条件付き行列の規約は、事前確率比を直接解く同時混同行列によるパラメータ化とは異なるが、一貫して扱えば両者は一致する。両者を混同すると、すべての行列の次元がもっともらしくても、気づかないまま誤った事前確率を得ることがある。 [2]
6. 可逆であることは良条件であることを意味しない
観測された陽性頻度の誤差に対する、回復された二値事前確率の感度は、一を二倍のcから一を引いた値で割ったものである。cが0.75では増幅率は二、cが0.51では五十となる。二番目の図は、この条件の悪さに伴うペナルティを示す。分類器がランダム予測に近づくにつれて、その出力にはどのクラスが出力を生成したかという情報がほとんど含まれなくなる。
多クラス混同行列でも、列がほぼ線形従属になると同じ問題が生じる。形式的には逆行列が存在していても、標本抽出ノイズによって不合理な負の事前確率推定値が生じうる。制約付き推定は確率単体上にあることを強制できるが、出力にない情報を作り出すことはできない。ソフト予測はハードな判定より多くのクラス情報を含みうるが、その条件付き作用素には独自の条件解析が必要である。ソース予測器が混同するクラスでは、ターゲットラベルの取得がとりわけ有益になりうる。同じ曖昧さを持つラベルなし予測をさらに集めても、利用可能な予算の有効な使い方にはならない可能性がある。
7. 同一の入力が正反対のターゲットリスクを隠しうる
識別不能性を直接示す構成を考える。ターゲット入力を等確率の二値変数とする。世界Aではラベルが入力と等しく、世界Bではラベルが入力の反対となる。ラベルのないターゲット入力分布は同一である。入力をそのまま返す固定分類器は、世界Aでは誤りがゼロ、世界Bでは誤りが一となる。ターゲット入力だけを持つ観測者は、ドリフト検出器がどれほど高度でも、両世界を区別できない。
この例はラベルの条件付き分布の変化を意図的に許しており、共変量シフト補正を正当化する仮定に違反する。その目的は、妥当な適用範囲内にある手法を反証することではない。これは、ターゲット入力の一致がソースでの正解率の持続を示す十分な証拠ではない理由と、入力の違いだけでは一意の補正を識別できない理由を示す。検出器がどの代替世界を区別できるのかを特定せずに成功率を報告すると、観測可能なドリフトと未観測の予測リスクを混同することになる。
8. 不変性には情報をもたらす環境が必要である
Arjovskyらは、不変リスク最小化、すなわち学習環境間で共通の最適予測器を支える表現を学習することを提案している。この定式化は、安定した予測構造を明示的な目的とする。その有用性は、安定した関係と偶然の関係を区別するために必要な変動を、環境とモデル仮定が与えるかどうかに依存する。
本稿独自の有限の反例は単純である。すべての学習環境に、いずれもラベルと等しい二つの特徴量が含まれているとする。どちらの特徴量から予測しても、その環境では最適かつ不変である。ターゲット環境では、第一の特徴量を変えず、第二の特徴量を反転させる。学習データは、どちらが安定しているかを識別していなかった。同じ交絡パターンを持つ学習環境を増やしても、曖昧さは解消されない。これは、より強い環境多様性の条件を持つ不変性定理と矛盾しない。むしろ、その条件を省略できない理由を示す。環境の数は環境が与える情報量と同じではなく、小さなペナルティ値だけで因果性が証明されるわけでもない。 [3]
9. ローカル計算で何を確認するのか
付属の実行可能プログラムは、離散的なソース分布とターゲット分布を列挙し、固定された損失と既知の重みについて測度変換の恒等式を検証する。クリッピングの反例は別個に確認するため、厳密な重み付けと正則化された重み付けの区別を観察できる。続いて、既知の条件付き混同行列からターゲット予測頻度を構成し、対応する線形方程式系を解くことでターゲット事前分布を回復する。
条件の悪さを示す例では、予測頻度への小さな摂動と、回復された事前確率の正確な変化を比較する。識別不能な二つのターゲット世界を明示的に表現すると、入力の周辺分布は同一でありながら分類器のリスクは正反対となる。最後に、学習時に最適な二つの特徴量規則を、明示された反転の前後で評価する。これらの検証は有限の代数的な証例である。画像から密度比を推定するものでも、現実の環境の因果仮定を検証するものでも、深層学習によるドメイン汎化ベンチマークを再現するものでもない。その価値は、そのような実験に着手する前に、推論上の依存関係を確認可能にすることにある。
10. 仮定を評価設計に落とし込む
説得力のある適応研究では、シフトの族、ターゲット情報の予算、手法の選択手順を事前登録すべきである。仮定を満たす場合と、統制された仮定違反の両方を含めるべきである。ラベルシフトで良好に機能する補正を、ベンチマークがラベルシフトしか含まないというだけで、一般に頑健であると位置づけるべきではない。逆に、意図的に適合しないシフトで失敗するからといって、その手法を適用範囲内でも無効と判断すべきではない。
実用的な成果には、予測指標、オーバーラップまたは条件の悪さの診断、シフトモデルに関する不確実性の明示的な説明を含めるべきである。遅れて得られるターゲットラベルは、ラベルのない入力では検証できない仮定を検証できる。その取得は、隠すべき不都合なリークではなく、適応設計の一部として扱うべきである。中心的な結論は建設的である。汎化の成功には、観測データからターゲットリスクへの識別可能な橋渡しが必要となる。その橋渡しは、安定性、オーバーラップ、情報をもたらす環境、新たなラベルを利用しうるが、アルゴリズムはどの証拠が結論を支えているかを明示しなければならない。
ローカルで実行済み · 限定された範囲
測度変換、クリッピングバイアス、事前分布の逆算、識別不能性の証例
既知の有限分布と固定された条件付き作用素を使用し、学習された密度比、ターゲットラベル、ニューラル適応ベンチマークは用いない。
503件のアサーションに合格。 これらの検証は提示された例の妥当性を確認するものであり、引用したシステムを検証するものではない。
記録された証例を確認する
{
  "target_risk": 0.5,
  "source_risk": 0.1,
  "clipped_weighted_risk": 0.2,
  "weight_ESS_fraction": 0.36,
  "target_prior_positive": 0.3,
  "observed_positive_fraction": 0.38,
  "indistinguishable_world_risks": [
    0.0,
    1.0
  ]
}
例の実行プログラム · モデルローダー · 学習モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全文を読む
明示された解析モデル
四つの方程式と明示的な仮定
(1) Q(Y|X)=P(Y|X)、ターゲットの台がソースの台に含まれること、重み付き損失が可積分であることを要する。このリスク恒等式では予測器は固定されている。
(2) ソース領域の確率質量aとターゲットの確率質量tauについて、0<a<1.の下での、重みだけに基づく通常の有効標本サイズ診断量の母集団極限である。普遍的な損失分散の公式ではない。
(3) Cを列確率行列とする条件付き混同の規約。ラベルシフトの下で、Cが可逆であれば、ターゲット予測頻度mu_Qからターゲット事前確率pi_Qを識別できる。
(4) Arjovskyらによる理想化された不変リスク最小化の制約。有限個の環境では、この制約を満たす予測器が複数残ることがある。実用的なペナルティは、この厳密な制約と同一ではない。
構成された例 · 再現可能なデータ
定量的な議論を確認する
これらの曲線は、明示されたモデルから計算される。引用した研究の観測値ではない。すべての図に数値データとベクトル版を付属する。


どの証拠がどの問いに答えるのか
| シフトの仮定 | 識別を可能にしうる情報 | 重大な失敗要因 |
|---|---|---|
| Xを条件とするYの分布が安定 | ラベル付きソースと、オーバーラップのあるターゲット入力密度 | ターゲット条件付き分布の変化、または被覆されない台 |
| Yを条件とするXの分布が安定 | ソースの条件付き作用素とターゲット予測 | 特異または悪条件の混同作用素 |
| 環境をまたいで安定した最適機構 | 関連する交絡関係が変動する環境 | すべての環境が同じ偶然の相関を維持 |
| 制限のないターゲット条件付き分布 | 新たなターゲットラベルまたは追加の構造情報 | ラベルのないターゲット入力だけではリスクは識別されない |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムまたはハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証の箇所に記録されている。
- シフトの族と、利用可能なターゲットラベル、入力、環境識別子を明示する。
- ソース予測器を固定し、適応の当てはめと最終的なターゲット評価を分離する。
- 統制された検証のため、既知の密度比またはクラス事前確率を持ち、仮定を満たすシフトを構成する。
- オーバーラップ、重みの裾、行列の条件の良し悪し、クリッピング、制約付き推定の選択を報告する。
- 条件付き分布の変化と曖昧な環境を加え、手法の実際の適用限界を明らかにする。
- 別途取得したターゲットラベルで評価し、ラベル予算、不確実性、選択規則を開示する。
一次資料が明らかにすること
Masashi Sugiyama, Matthias Krauledat, Klaus-Robert Müller · 2007 [1]
貢献。 共変量シフトに対する重要度重み付き交差検証を開発している。
適用限界。 測度変換の議論には、条件付き分布の安定性と十分な台が必要である。
出典内の該当箇所。 問題の定式化とIWCVの構成。
Zachary C. Lipton, Yu-Xiang Wang, Alexander J. Smola · 2018 [2]
貢献。 ブラックボックス予測と混同情報を用いて、変化したラベル比率を推定する。
適用限界。 台、クラス条件付き分布の安定性、可逆性が識別を制約する。
出典内の該当箇所。 仮定A.1–A.3と一致性に関する結果。
Martin Arjovsky, Léon Bottou, Ishaan Gulrajani et al. · 2019 [3]
貢献。 学習環境間で共通の最適予測器を持つ表現を提案している。
適用限界。 識別は環境の変動と構造的仮定に依存する。
出典内の該当箇所。 第3節の定式化と第4節の汎化分析。
本分析の限界
- 実行した分布はすべて有限の構成であり、運用中のニューラルモデルの測定値ではない。
- 有効標本サイズの曲線は重みのみに関するものであり、すべての推定量の分散を決定するものではない。
- 二値対称混同モデルは、高次元になりうる推定問題を単純化している。
- 不変性の反例は環境情報の不足を示すものであり、不変構造を利用するすべての手法の失敗を示すものではない。
選定した三つの基礎的な一次資料を対象とし、独自の計算例を伴う、焦点を絞った分析的総説である。2026年までの文献を網羅的または体系的に調査したものではない。資料へのアクセスと版に関する注記は参考文献とともに記録されている。
結論を変えうる問い
- 競合するシフトの説明を最も効率よく区別するのは、どのターゲットラベルか。
- オーバーラップと作用素の条件の良し悪しの診断から、適応が補正を差し控えるべき状況を予測できるか。
- 不変予測が単に数値的なペナルティの対象となるだけでなく、識別可能になるようにするには、環境をどのように設計すべきか。
参考文献
- Masashi Sugiyama, Matthias Krauledat, Klaus-Robert Müller. Covariate Shift Adaptation by Importance Weighted Cross Validation. Journal of Machine Learning Research (2007). Primary source.
- Zachary C. Lipton, Yu-Xiang Wang, Alexander J. Smola. Detecting and Correcting for Label Shift with Black Box Predictors. Proceedings of the 35th International Conference on Machine Learning (2018). Primary source.
- Martin Arjovsky, Léon Bottou, Ishaan Gulrajani et al.. Invariant Risk Minimization. arXiv:1907.02893 (2019). Primary source.
資料[1]へのアクセス。 一次記録と、アクセス可能な全文の一部の節を確認した。補足資料の網羅的な監査は行っていない。
資料[2]へのアクセス。 一次記録と、アクセス可能な全文の一部の節を確認した。補足資料の網羅的な監査は行っていない。
資料[3]へのアクセス。 一次記録と、アクセス可能な全文の一部の節を確認した。補足資料の網羅的な監査は行っていない。
版に関する注記。 初期プレプリントは2019年。確認したHTML版は第3版で、2020年三月27日に改訂されている。この記録には学会採択を主張する記述は付されていない。
書誌情報の同一性は、出版社および著者の一次記録と照合した。以下の資料へのアクセスと版に関する注記が確認範囲を示す。これは全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を示す。分析上の構成と提案された評価設計は本記事に帰属する。
表紙はImageGenによる概念的なイラストである。技術的な図は明示されたモデルまたは有限の例から計算され、PythonとCSVが付属する。運用中の製品の測定値でも、再現された性能ベンチマークでもない。
このローカル草稿には、独立した査読または学術誌での採択の記録はない。範囲を限定した実行可能な例は、記載された小規模モデルを確認するものであり、引用したシステムの形式検証ではない。