
الملخص
يغيّر تحسين التفضيلات نموذجًا توليديًا عبر ملاءمة الأحكام المقارنة وتقييد الابتعاد عن سياسة مرجعية. تميّز هذه المقالة بين عملية المقارنة المرصودة، ونموذج مكافأة قياسية كامن، والسياسة التي تختارها دالة هدف تحسين. وتشتق الحل لحالة استجابتين لتعظيم المكافأة المنظّم بتباعد KL، وتحلّل الثبات تحت إزاحة المكافأة، وتبني دورة تفضيلات بين ثلاث مجموعات لا تستطيع أي منفعة واحدة من نوع Bradley–Terry إعادة إنتاجها بدقة. ويُتناول تحسين التفضيلات المباشر بوصفه إعادة صياغة معلمية مفيدة ضمن افتراضاته، لا بوصفه تحديدًا للقيم البشرية. وتتحقق اختبارات منتهية قابلة للتنفيذ من السياسة التحليلية، والثبات تحت الإزاحة، والدورة. وتوضّح الأشكال دوال خسارة وسياسات مصرّحًا بها، لا قياسات للتفضيلات البشرية أو اختبارات معيارية للمواءمة.
1. التمييز بين الأحكام والمكافآت والسياسات
تحتوي مجموعة بيانات التفضيلات على أحداث: يرى شخص أو مقيّم موجّهًا واستجابتين مرشحتين ضمن طريقة عرض معينة، ثم يقدّم حكمًا. ويسند نموذج المكافأة درجات عددية يُقصد بها تفسير تلك الأحداث. وتنتج السياسة استجابات مستقبلية. ترتبط هذه الكيانات الثلاثة بخيارات النمذجة، لكنها ليست الكيان نفسه. ويمكن لسياسة أن تحسّن التوافق مع الأحكام المجموعة دون أن تثبت أن مخرجاتها صحيحة أو آمنة أو مثلى لكل مستخدم.
هذا التمييز مهم لأن اختيار المقارنات وتعليمات الوسم يؤثران كليهما في المشاهدات. فعرض ملخصين موجزين يطرح سؤالًا مختلفًا عن مقارنة ملخص موجز بإجابة طويلة قائمة على التخمين. ويرث النموذج المدرّب على الوسوم الناتجة إطار أخذ العينات هذا. لذلك يتمثل السؤال العلمي المعني في تحديد عملية التفضيل التي يقاربها النموذج وكيفية تعميم هذا التقريب. إن اعتبار انخفاض خسارة التدريب اكتشافًا لمنفعة بشرية موضوعية يتجاوز هذا السؤال بدلًا من الإجابة عنه.
2. نموذج المقارنة الزوجية يضع افتراضًا صريحًا
توفّر ورقة Bradley–Terry الكلاسيكية المرجع التاريخي للمقارنات الزوجية. وقد جرى هنا التحقق من هويتها الببليوغرافية، بينما تعذّر الوصول إلى نصها الكامل لدى الناشر أثناء هذه المراجعة؛ ولا تُنسب أي مبرهنة تاريخية تفصيلية إلى ذلك النص غير المقروء. كما ترد صيغة المقارنة اللوجستية صراحةً في ورقة DPO التي أُتيح الاطلاع عليها.
نفترض في هذه المقالة أن لكل مرشح درجة حقيقية القيمة، وأن احتمال اختيار المرشح الأول هو الدالة اللوجستية لفرق الدرجتين. هذا نموذج إحصائي للأحكام المتكررة، وليس تعريفًا للتفضيل نفسه. وهو يقتضي أن يساوي لوغاريتم أرجحية اختيارٍ على آخر فرقًا في الدرجات. وتُلغى أي إزاحة جمعيّة مشتركة لجميع الدرجات. ويؤدي ضرب الدرجات في عامل إلى تغيير احتمالات الاختيار ما لم يتغير أيضًا مقياس ضوضاء المقارنة. وعليه، لا يمكن تحديد نقطة أصل المقياس من المقارنات، ولا يكون للمقياس العددي معنى إلا بالنسبة إلى نموذج رصد مختار. [1], [3]
3. جمع التغذية الراجعة جزء من منظومة التعلّم
يبرهن Christiano وزملاؤه عمليًا على تعلّم المكافآت من مقارنات بشرية لمقاطع مسارات، واستخدام تلك المكافآت المتعلّمة في التعلّم المعزّز. ويفصل ذلك بين تعلّم الهدف وتحسين السلوك. ولا يجعل هذا العرض كل مجموعة بيانات تفضيلات مستقبلية تمثيلية، ولا يلغي الحاجة إلى تقييم السلوك المتعلّم.
لنتأمل عملية جمع مقارنات تسحب كلا المرشحين من سياسة مرجعية ضيقة النطاق. قد تحصل على وسوم شديدة الاتساق داخل تلك المنطقة، بينما تترك المخرجات الأخرى شبه غير مقيّدة. ويمكن لتحسين مكافأة جرت ملاءمتها أن يغيّر بعد ذلك توزيع المخرجات نحو مناطق ضعيفة الرصد. وقد يقلّل جمع مقارنات جديدة هذه الفجوة، لكنه يُدخل حلقة تغذية راجعة: إذ تؤثر السياسة في الأمثلة التي ستُحكم لاحقًا. ويسجّل النظام القابل للتدقيق مولّد المرشحين، ومجتمع المقيّمين، والتعليمات، وكيفية التعامل مع التعادلات، واحتمالات أخذ العينات. ومن دون هذه السجلات، قد يعكس الاختلاف بين سياستين مدرّبتين اختلاف مجتمعات الواسمين بدلًا من تفوق خوارزمية تحسين. [2]
4. تنظيم KL يختار سياسة نسبةً إلى مرجع
لموجّه ثابت ومجموعة استجابات منتهية، نُعظّم المكافأة المتوقعة مطروحًا منها بيتا مضروبةً في تباعد KL عن توزيع مرجعي ذي دعم موجب. ويؤدي استخدام مضاعف لاغرانج للتطبيع إلى سياسة تتناسب مع الاحتمال المرجعي مضروبًا في قيمة الدالة الأسية عند حاصل قسمة المكافأة على بيتا. وتكون دالة الهدف مقعّرة تمامًا على البسيط الاحتمالي ذي الدعم عندما تكون بيتا موجبة، لذا يكون هذا الحل فريدًا عليه.
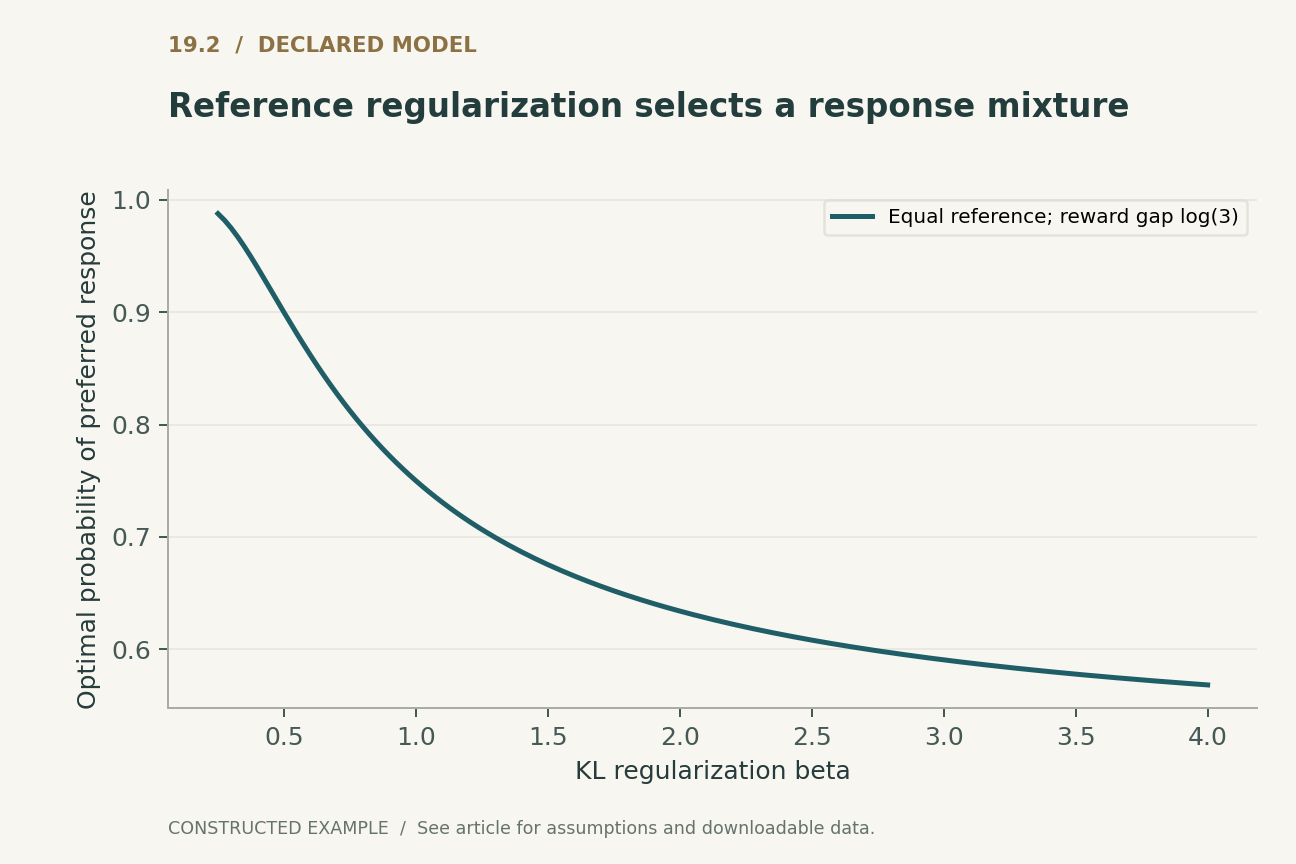
في بناء ذي استجابتين، لنسند في المرجع احتمال النصف لكل استجابة، ولنجعل فرق مكافأتيهما لوغاريتم ثلاثة. عندما تساوي بيتا واحدًا، تسند السياسة المثلى احتمال ثلاثة أرباع إلى الاستجابة المفضّلة. وتدفع زيادة بيتا السياسة نحو المرجع؛ بينما يؤدي خفضها إلى تركيز الاحتمال على المكافأة الأعلى. ويعرض شكل السياسة لدينا هذا البناء بعينه. وهو ليس مقياسًا لمكافأة بشرية جرت ملاءمته. ويغيّر تعديل الاحتمالات المرجعية السياسة المختارة حتى إذا بقي فرق الدرجات المقارن ثابتًا، مما يبيّن أن دالة هدف التحسين تتضمن أكثر من الترتيب المرصود.
5. التحسين المباشر يغيّر الصياغة المعلمية
يشتق Rafailov وزملاؤه تحسين التفضيلات المباشر عبر التعبير عن المكافآت بلوغاريتمات نسب احتمالات السياسة إلى المرجع. وفي مقارنة Bradley–Terry، يُلغى حد التطبيع المعتمد على الموجّه. وينتج عن ذلك هدف للسياسة قائم على الإمكان المقارن دون شبكة مكافأة متعلّمة منفصلة.
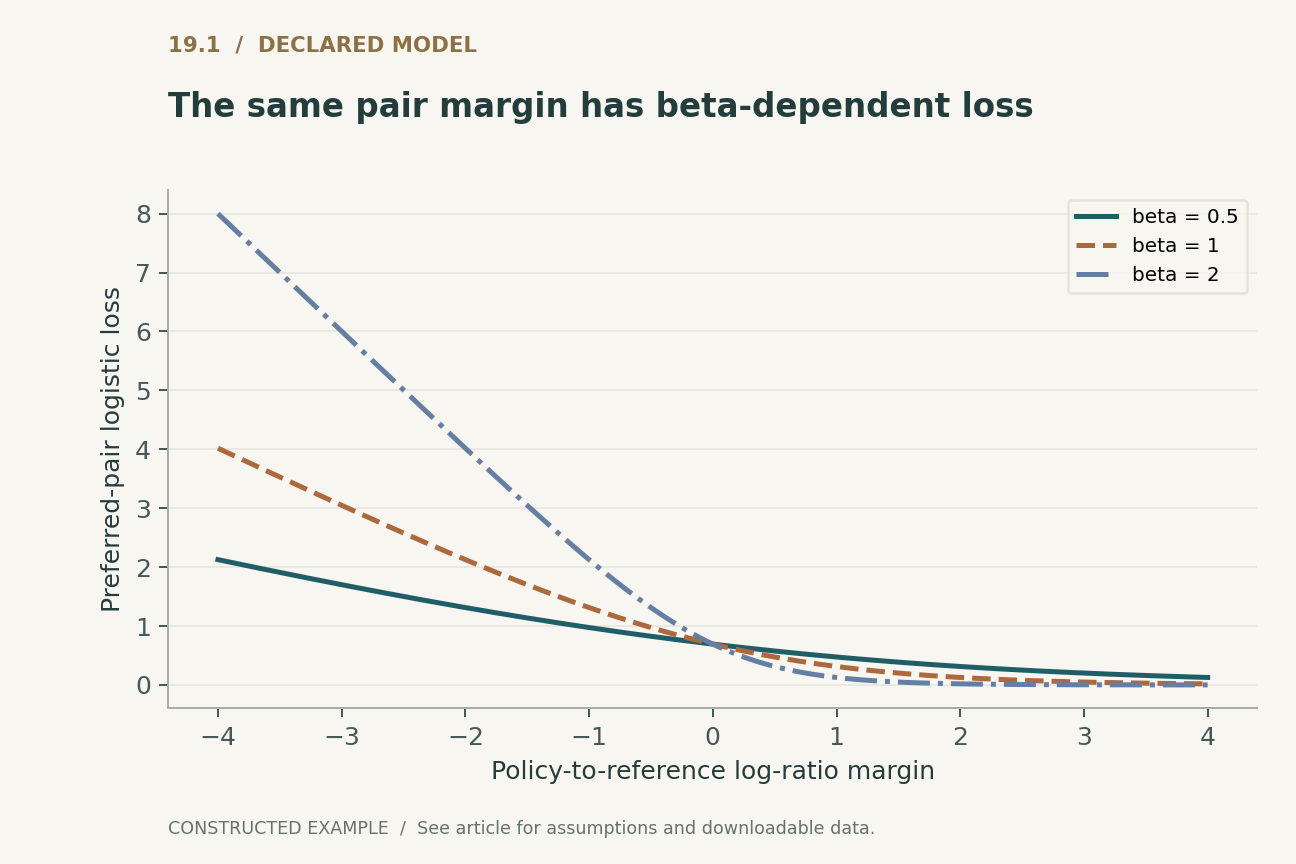
الإلغاء جبري؛ ولا يبيّن أن نموذجًا لغويًا ذا معلمات كيفما كان يبلغ الحل الأمثل العالمي، أو أن التغذية الراجعة المنتهية تحقق قانون المقارنة المفترض. وفي حالة الاستجابتين، يمكن دراسة الخسارة مباشرةً بوصفها دالة لهامش النسبة اللوغاريتمية. ويخفض الهامش الموجب الأكبر خسارة الزوج المفضّل، مع تحكّم بيتا في مقياسها. ويرسم الشكل الأول هذه الدالة المصرّح بها عند عدة قيم لبيتا. وعند الهامش الصفري، يساوي كل منحنى لوغاريتم اثنين. وهذا التقاطع المشترك اختبار مفيد للتنفيذ، لكن خسارة زوجية متطابقة قد تتعايش مع سلوك توليد مختلف في الموجّهات أو الاستجابات الغائبة عن بيانات المقارنة. [3]
6. تزول نقاط أصل المكافأة، لكن الدعم يظل مهمًا
إذا أُضيف ثابت خاص بالموجّه إلى مكافأة كل استجابة، بقيت احتمالات المقارنة والسياسة المثلى وفق KL دون تغيير. إذ يمتص التطبيع الأُسّي الثابت بدقة. ويتحقق الاختبار القابل للتنفيذ من هذا الثبات باستخدام عدة متجهات مكافأة منتهية وإزاحات. ولا يضر عدم التفرد هذا عندما يكون الهدف اختيار السياسة المثلى نفسها؛ لكنه يصبح مضللًا إذا عُرض المقدار المطلق للمكافأة بوصفه كمية مقيسة مباشرةً.
شرط الدعم مهم بالقدر نفسه. فالاحتمال المرجعي الصفري يجعل إسناد كتلة احتمالية موجبة لتلك الاستجابة في السياسة غير متوافق مع تباعد KL أمامي منتهٍ. وتحتاج الصيغ الشكلية التي تتضمن لوغاريتم نسبة السياسة إلى المرجع إلى مجال يكون المقام فيه موجبًا. وغالبًا ما تسند النماذج اللغوية احتمالات غير صفرية للرموز من الناحية الرياضية، لكن القطع وترشيح المرشحين والدقة المحدودة قد تُنشئ استبعادات فعلية. لذلك تستحق إجراءات التوليد المنشورة وصفًا مستقلًا لدعمها. ولا تصف دالة هدف تدريب على احتمالات التسلسلات تلقائيًا مفكّك ترميز يستخدم الترشيح.
7. قد تكون التفضيلات المجمّعة دورية
نبني ثلاث مجموعات مقيّمين متساوية الحجم، ذات ترتيبات حتمية هي A أعلى من B أعلى من C، وB أعلى من C أعلى من A، وC أعلى من A أعلى من B. وعبر المجتمع المدمج، يفضّل ثلثاه A على B، ويفضّل ثلثاه B على C، ويفضّل ثلثاه C على A. وكل ترتيب فردي متعدٍّ؛ لكن احتمالات المقارنات الزوجية المجمّعة تشكّل دورة.
لا يستطيع نموذج درجات لوجستي قياسي ملاءمة الاحتمالات الثلاثة جميعًا بدقة. فلا بد أن يكون مجموع فروق الدرجات الثلاثة حول دورة صفرًا، بينما يبلغ مجموع لوغاريتمات الأرجحية الثلاثة المرصودة ثلاثة أمثال لوغاريتم اثنين. وهذا شاهد منتهٍ على سوء تحديد النموذج، وليس ادعاءً بأن كل مجموعة بيانات تفضيلات واقعية تحتوي على مثل هذه الدورة. ولا بد للنموذج القياسي الملاءَم من التوصل إلى تسوية، ويخفي رقم مكافأة واحد أي مجموعة تخسر في تلك التسوية. ويمكن للإبلاغ عن اختلاف المجموعات الفرعية أو السماح بنموذج شرطي أغنى أن يكشف معلومات يحجبها معدل فوز مجمّع. ولا تستطيع دقة التحسين إصلاح تمثيل إحصائي غير متوافق.
8. التوافق مع التفضيلات ليس تحققًا من الوقائع
قد تُفضَّل، في ظل بعض التعليمات، إجابة تفسيرية سلسة لكنها غير مسندة على أخرى دقيقة لكنها ركيكة. وبالمقابل، قد يفضّل مقيّم يُطلب منه التحقق من الاستشهادات استجابة مختلفة. وتنشأ هذه الاحتمالات من التمييز بين عملية الرصد وخاصية المهمة، لا من افتراض أن الواسمين غير عقلانيين. فوسم التفضيل يقيس الحكم الذي استُثير.
لذلك ينبغي أن يكون للإسناد الوقائعي لدى المساعد الأكاديمي اختبارات قابلة للرصد خاصة به: وجود المصدر، وتوافق الادعاء مع المصدر، واتساق المعادلات، وسلوك التصحيح. ويمكن إدراج هذه الاختبارات في التقييم أو تعليمات الوسم، لكن ينبغي مع ذلك الإبلاغ عن نجاحها منفصلًا عن درجة التفضيل الإجمالية. وبالمثل، ليس من الضروري أن تكون السلامة من الضرر والإيجاز وإنجاز المهمة مترابطة ترابطًا تامًا. فالمكافأة المركّبة ترمّز مفاضلة بينها. والأوزان ومجتمع المقيّمين خيارات تتعلق بالحوكمة والمنتج، وليست كميات يستطيع إمكان زوجي استنتاجها على نحو فريد من مشاهدات غير مكتملة.
9. التحقق من الآلية المنتهية قبل توسيع نطاق الادعاء
تختبر الشيفرة المصاحبة الحل الأمثل ذي الاستجابتين مقابل شبكة كثيفة من احتمالات السياسات المرشحة، باستخدام مكافآت دقيقة والمرجع المصرّح به. وتتحقق من أن الحل التحليلي يحقق قيمة لدالة الهدف لا تقل عن القيمة عند كل نقطة في الشبكة، ضمن سماحية عددية. كما تختبر التطبيع والثبات تحت الإضافة إلى المكافأة لتوزيعات صغيرة منتهية. وهذا اختبار اتساق عددي لدالة هدف منتهية مقعّرة، وليس دليلًا على التقارب في فضاء معلمات عصبي.
ينشئ تعداد منفصل ترتيبات المقيّمين الثلاثة جميعًا ويعدّ اختياراتهم الزوجية. وتُقارَن الدورة الناتجة بشرط المجموع الصفري اللازم للوغاريتمات الأرجحية القياسية. وتُختبر خسارة DPO المرسومة عند الصفر وعند هوامش مختارة، ويُختبر منحنى السياسة عند بيتا مساوية لواحد مقابل ثلاثة أرباع. لم تُجرَ لهذه المقالة أي عمليات وسم بشري أو توليد إكمالات أو تدريب نموذج مكافأة أو ضبط دقيق للسياسة. ويتطلب البروتوكول التجريبي المقترح أدناه تلك المشاهدات الإضافية.
10. تقييم عملية، لا شعار قائم على قيمة قياسية
تثبّت الدراسة القابلة للدفاع علميًا عن تحسين التفضيلات عملية المقارنة، والنموذج المرجعي، والدعم، والتنظيم، ومجتمع التقييم المحجوز. وتبلّغ عن التوافق مع الوسوم وعن السلوك تحت فك الترميز الفعلي، بما في ذلك الموجّهات خارج توزيع جمع التغذية الراجعة. كما تقيس خصائص المهمة المهمة بصورة مستقلة عن التفضيل. ولا يكون معدل الفوز الإجمالي ذا دلالة إلا إلى جانب مجموعة مقارنته وعدم اليقين والخلافات التي يجمعها.
التفسير الناتج دقيق. يمكن للبيانات المقارنة أن تحدّد بعض فروق الدرجات في ظل نموذج رصد مختار. ويختار تنظيم KL سياسة باستخدام تلك الفروق وتوزيع مرجعي معًا. ويمكن لخسارة مباشرة للسياسة أن تبسّط التحسين دون حل كل مشكلات التمثيل أو الدعم أو تعدّد التفضيلات. وليست هذه الحدود أسبابًا للتخلي عن تعلّم التفضيلات؛ بل تحدّد الأدلة التي يحتاج إليها ادعاء أقوى. وفي النظام الموثوق، لا يقل الحفاظ على منشأ الأحكام وحدود النموذج الملاءَم أهميةً عن خفض خسارته.
نُفّذ محليًا · نطاق محدود
الحل الأمثل المنتهي وفق KL، والثبات تحت إزاحة المكافأة، والتفضيلات الدورية للمجتمع
مكافآت مسندة على مجموعة منتهية وثلاث مجموعات ذات ترتيبات حتمية. المقارنة بالشبكة اختبار اتساق عددي، لا تقارب عصبي ولا قياس للمواءمة البشرية.
اجتاز 41 اختبار تأكيد. تتحقق هذه الاختبارات من المثال المقدّم، لا من الأنظمة المستشهد بها.
فحص الشاهد المسجّل
{
  "policy_grid_points": 10001,
  "beta_values_checked": [
    0.25,
    0.5,
    1.0,
    2.0,
    4.0
  ],
  "optimal_preferred_probability_beta1": 0.75,
  "cycle_pair_probabilities": [
    0.6666666666666666,
    0.6666666666666666,
    0.6666666666666666
  ],
  "cycle_logodds_sum": 2.0794415416798353,
  "scalar_score_required_sum": 0.0
}
مشغّل المثال · محمّل النموذج · نماذج التدريب · نماذج التمثيل · نماذج التوليد · نماذج الموثوقيةقراءة نتائج الاختبارات كاملةً
نموذج تحليلي مصرّح به
أربع معادلات، وافتراضات صريحة
(1) نموذج رصد لوجستي مفترض من نوع Bradley–Terry، وهو صريح أيضًا في ورقة DPO التي أُتيح الاطلاع عليها. يمثّل احتمالات زوجية؛ وليس قانونًا كونيًا للحكم البشري.
(2) الحل الأمثل على مجموعة استجابات منتهية للمكافأة المتوقعة مطروحًا منها بيتا مضروبةً في تباعد KL الأمامي إلى مرجع موجب. عند تساوي الكتل المرجعية ووجود فجوة مكافأة log(3)، يكون احتمال الاستجابة المفضّلة 3/4 عند beta=1.
(3) دالة هدف DPO لدى Rafailov وزملائه؛ وتتطلب مقارنات واقعة ضمن الدعم. ولا يثبت تكافؤ النموذج فيها تقارب التحسين العصبي أو تمثيلية التغذية الراجعة.
(4) شرط لازم لنموذج واحد ذي درجات لوجستية قياسية عند موجّه ثابت. ويعطي المزيج المتساوي المنشأ من ثلاثة ترتيبات دورية 3 log(2)، منتهكًا هذا الشرط.
أمثلة منشأة · بيانات قابلة لإعادة الإنتاج
فحص الحجة الكمية
تُحسب هذه المنحنيات من النماذج المصرّح بها. وليست مشاهدات من الدراسات المستشهد بها. ويتضمن كل شكل بياناته العددية ونسخته المتجهية.


أي دليل يجيب عن أي سؤال؟
| الكيان | ما يسجّله | الافتراض الإضافي اللازم |
|---|---|---|
| حكم زوجي | اختيار في ظل طريقة عرض وتعليمات | تمثيلية عملية المقارنة |
| مكافأة قياسية | تفسير ملاءَم لاحتمالات الاختيار | كفاية نموذج الرصد وقابليته للتحديد |
| سياسة مثلى وفق KL | مفاضلة بين المكافأة والابتعاد عن المرجع | الدعم ومقياس المكافأة وشروط التحسين |
| معدل الفوز على بيانات محجوزة | التوافق نسبةً إلى طرف مقارنة ومجتمع مقيّمين | التعميم على مستخدمين ومهام وخصائص مستقلة جديدة |
بروتوكول تحقق مقترح
هذا تصميم تقييم مقترح. لم يُنفّذ أي اختبار معياري لنظام إنتاج أو عتاد. والنماذج المنتهية التي نُفّذت بصورة منفصلة موثّقة في الاختبارات القابلة للتنفيذ.
- تسجيل توليد المرشحين، ومجتمع المقيّمين، والتعليمات، والتعادلات، ومنشأ الأحكام.
- فصل التغذية الراجعة المستخدمة للملاءمة واختيار النموذج والتقييم السلوكي النهائي.
- تثبيت السياسة المرجعية، واصطلاح احتمالات التسلسلات، ومفكّك الترميز، ومقياس التنظيم.
- قياس اختلاف المجموعات الفرعية، واتساق الوسوم المتكررة، وأنماط التفضيلات الدورية.
- الإبلاغ عن التحقق الوقائعي أو الخاص بالمهمة منفصلًا عن التوافق مع التفضيلات ومعدلات الفوز الإجمالية.
- إجراء اختبارات إجهاد على مجتمعات موجّهات جديدة ومخرجات خارج الدعم، مع نشر عدم اليقين وأمثلة الإخفاق.
ما تثبته المصادر الأولية
Ralph Allan Bradley, Milton E. Terry · 1952 [1]
الإسهام. يحدّد المنشور الكلاسيكي للمقارنات الزوجية المستخدم مرجعًا تاريخيًا للنموذج.
الحدود. تعذّر الوصول إلى النص الكامل لدى الناشر؛ ولا يُدّعى الاستناد إلى أي مبرهنة غير مقروءة، ويُحدَّد النموذج اللوجستي هنا بصورة مستقلة.
موضع المصدر. السجل الببليوغرافي: Biometrika 39(3/4)، 324–345.
Paul F. Christiano, Jan Leike, Tom B. Brown et al. · 2017 [2]
الإسهام. يبرهن عمليًا على تعلّم مكافأة من مقارنات بشرية للمسارات وتحسين السلوك باستخدامها.
الحدود. لا تحدّد العروض الخاصة بمهام بعينها تفضيلات كونية.
موضع المصدر. المنهج وحلقة تعلّم التفضيلات.
Rafael Rafailov, Archit Sharma, Eric Mitchell et al. · 2023 [3]
الإسهام. يعيد الصياغة المعلمية لدالة هدف تفضيلات منظّمة بتباعد KL عبر نسب السياسة إلى المرجع.
الحدود. يتطلب افتراضاته الخاصة بنموذج المقارنة والدعم؛ وتضيف الملاءمة العصبية المنتهية خطأَي التقدير والتحسين.
موضع المصدر. الأقسام 3–5 والملحق A.
حدود هذا التحليل
- تستخدم الأمثلة مجموعات استجابات منتهية ومكافآت مسندة بدلًا من نماذج لغوية مدرّبة.
- جرى التحقق ببليوغرافيًا من منشور Bradley–Terry الأصلي؛ وتعذّر الوصول إلى نصه الكامل أثناء هذه المراجعة.
- دورة المجموعات الثلاث شاهد منشأ على عدم التوافق، وليست تقديرًا تجريبيًا للخلاف البشري.
- لم تُجرَ تجربة ضبط دقيق للسياسة أو وسم بشري؛ فهذه تقييمات مقترحة.
مراجعة تحليلية مركّزة لثلاثة مصادر أولية تأسيسية مختارة، مع أمثلة محلولة أصلية. وليست مسحًا شاملًا أو منهجيًا للأدبيات حتى 2026. وتُسجَّل ملاحظات الوصول إلى المصادر وإصداراتها مع قائمة المراجع.
أسئلة من شأنها تغيير الاستنتاج
- ما بيانات الوسم الوصفية الكافية للتمييز بين خطأ النموذج والخلاف داخل مجتمع المقيّمين؟
- كيف ينبغي أن يوزّع جمع التغذية الراجعة المقارنات خارج الدعم المألوف للسياسة الحالية؟
- متى تكون نماذج التفضيلات الشرطية أو غير القياسية أفضل من مكافأة قياسية مجمّعة؟
المراجع
- Ralph Allan Bradley, Milton E. Terry. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika (1952). 10.2307/2334029.
- Paul F. Christiano, Jan Leike, Tom B. Brown et al.. Deep Reinforcement Learning from Human Preferences. Advances in Neural Information Processing Systems 30 (2017). Primary source.
- Rafael Rafailov, Archit Sharma, Eric Mitchell et al.. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Advances in Neural Information Processing Systems 36 (2023). 10.52202/075280-2338.
الوصول إلى المصدر [1]. جرى التحقق من البيانات الوصفية لعدد الدورية الأصلية. ولم تتوفر المقالة مباشرةً ولا النص الكامل لدى الناشر عبر أداة التصفح؛ ولا يُدّعى إجراء تدقيق لمبرهنات النص الكامل.
الوصول إلى المصدر [2]. فُحص السجل الأولي وأقسام مختارة متاحة من النص الكامل؛ ولم يُجرَ تدقيق شامل للمواد التكميلية.
الوصول إلى المصدر [3]. فُحص السجل الأولي وأقسام مختارة متاحة من النص الكامل؛ ولم يُجرَ تدقيق شامل للمواد التكميلية.
ملاحظة الإصدار. يتبع ترتيب المؤلفين ملف PDF الأصلي للمؤتمر؛ وتُرتِّب صفحة الوصول بصيغة HTML الاسمين Ermon وManning ترتيبًا مختلفًا.
جرى التحقق من الهويات الببليوغرافية بمقارنتها بسجلات الناشرين والمؤلفين الأولية. وتصف ملاحظات الوصول إلى المصادر وإصداراتها أدناه النطاق؛ وليس هذا تدقيقًا شاملًا للنصوص الكاملة.
التأليف والمنشأ
كتبها Codex، وهو ذكاء اصطناعي، وأجرى مراجعة تقنية ذاتية لها. وتحدّد المراجع الباحثين الأصليين؛ أما الإنشاءات التحليلية وتصاميم التقييم المقترحة فتُنسب إلى هذه المقالة.
الأغلفة رسوم مفاهيمية بواسطة ImageGen. وتُحسب الأشكال التقنية من نماذج مصرّح بها أو أمثلة منتهية، مع إرفاق Python وCSV. وليست قياسات لمنتجات منشورة أو إعادة إنتاج لاختبارات أداء معيارية.
لا تملك هذه المسودة المحلية سجلًا لتحكيم علمي مستقل أو قبول في دورية. وتختبر الأمثلة القابلة للتنفيذ ذات النطاق المحدود النماذج الصغيرة المذكورة؛ ولا تمثل تحققًا صوريًا من الأنظمة المستشهد بها.