
摘要
偏好优化通过拟合比较判断并约束相对于参考策略的偏离来改变生成模型。本文区分了观测到的比较过程、潜在的标量奖励模型,以及由优化目标选出的策略。文章推导了 KL 正则化奖励最大化在双响应情形下的解,分析了奖励偏移不变性,并构造了一个三群体偏好循环,任何单一的 Bradley–Terry 效用都无法将其精确再现。本文将直接偏好优化视为在其假设范围内有用的重参数化,而非对人类价值的识别。可执行的有限检验验证了解析策略、偏移不变性和该循环。图表展示的是明确给定的损失与策略,而非人类偏好测量或对齐基准测试。
1. 区分判断、奖励与策略
偏好数据集包含的是事件:某个人或评估者在特定呈现方式下看到一个提示和两个候选响应,然后给出判断。奖励模型赋予数值分数,旨在解释这些事件。策略则生成未来的响应。这三个对象通过建模选择联系在一起,但并非同一个对象。策略可以提高与所收集判断的一致性,却并未由此证明其输出真实、安全,或对每位用户都最优。
这一区分很重要,因为比较对象的选择和标注指令都会影响观测。展示两个简洁摘要所提出的问题,与将一个简洁摘要同一个冗长且带有推测的回答进行比较所提出的问题不同。基于由此产生的标签训练的模型会继承这一抽样框架。因此,相关的科学问题是:模型近似了哪一种偏好过程,以及这一近似如何泛化。将较低的训练损失视为发现了客观的人类效用,是绕过这一问题,而非回答它。
2. 成对比较模型作出了明确假设
经典的 Bradley–Terry 论文提供了成对比较的历史参考。本文核实了其书目信息,但在本次综述期间无法访问出版社提供的全文;因此,不会将任何详细的历史定理归于这篇未读的文本。已查阅的 DPO 论文也明确给出了逻辑斯蒂比较形式。
本文假设每个候选项都有一个实值分数,选择第一个候选项的概率为分数差的逻辑斯蒂函数。这是关于重复判断的统计模型,而不是对偏好本身的定义。它意味着,选择一项而非另一项的对数优势等于分数差。对所有分数施加共同的加性平移会相互抵消。将分数乘以一个因子会改变选择概率,除非比较噪声的尺度也随之改变。因此,尺度的原点无法从比较中识别,数值尺度也只有相对于所选的观测模型才有意义。 [1], [3]
3. 反馈收集是学习系统的一部分
Christiano 及其同事展示了如何从人类对轨迹片段的比较中学习奖励,并将学得的奖励用于强化学习。这将目标的学习与行为的优化分离开来。这一展示并不意味着未来的每个偏好数据集都具有代表性,也不意味着无需评估学得的行为。
考虑一种比较收集过程:两个候选项都从范围狭窄的参考策略中抽取。它可能在该区域内获得高度一致的标签,同时使其他输出几乎不受约束。随后,优化拟合出的奖励可能使输出分布转向观测不足的区域。收集新的比较可以缩小这一缺口,但也引入了反馈循环:策略会影响接下来哪些样本接受判断。可审计的系统会记录候选项生成器、评估者群体、指令、平局处理方式和抽样概率。缺少这些记录时,两个已训练策略之间的分歧可能反映的是标注群体不同,而非某种优化算法更优。 [2]
4. KL 正则化相对于参考选择策略
对于固定提示和有限响应集合,最大化期望奖励减去相对于支撑集上概率为正的参考分布的 KL 散度乘以贝塔。对归一化引入拉格朗日乘子,可得到一个策略,其概率正比于参考概率乘以指数函数在奖励除以贝塔处的值。当贝塔为正时,目标函数在支撑集所对应的单纯形上严格凹,因此该解在此范围内唯一。
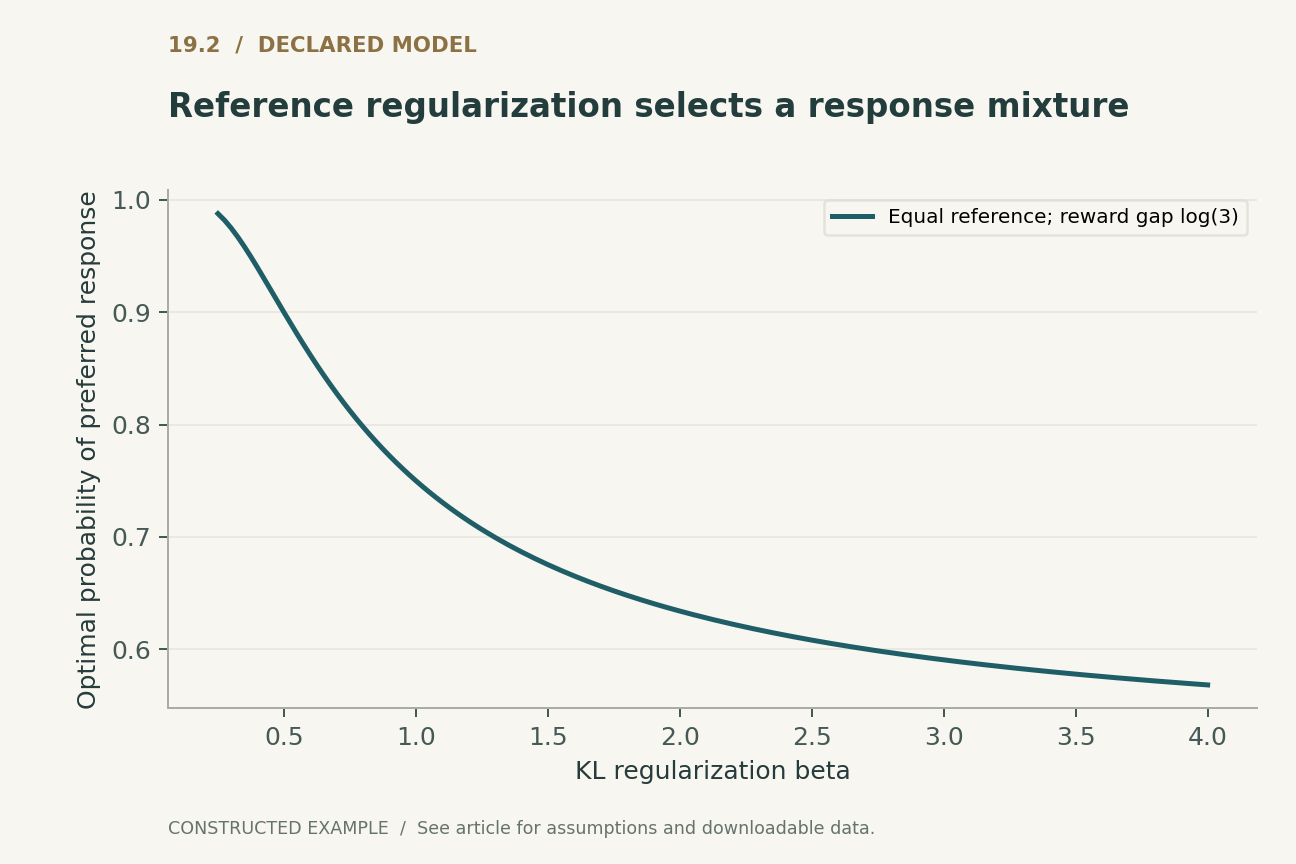
在一个双响应构造中,令参考分布为每个响应赋予二分之一的概率,并令两者的奖励差为三的对数。当贝塔为一时,最优策略为偏好的响应赋予四分之三的概率。增大贝塔会使策略接近参考分布;减小贝塔则会使概率集中于奖励更高的响应。本文的策略图展示的正是这一构造。它并不是拟合得到的人类奖励尺度。即使比较分数差保持不变,改变参考概率也会改变选出的策略,这表明优化目标包含的不只是观测到的排序。
5. 直接优化改变的是参数化方式
Rafailov 及其同事通过用策略与参考之间的对数概率比表示奖励,推导出直接偏好优化。在 Bradley–Terry 比较中,依赖提示的归一化项会抵消。由此得到一个基于比较似然的策略目标,无需单独学习奖励网络。
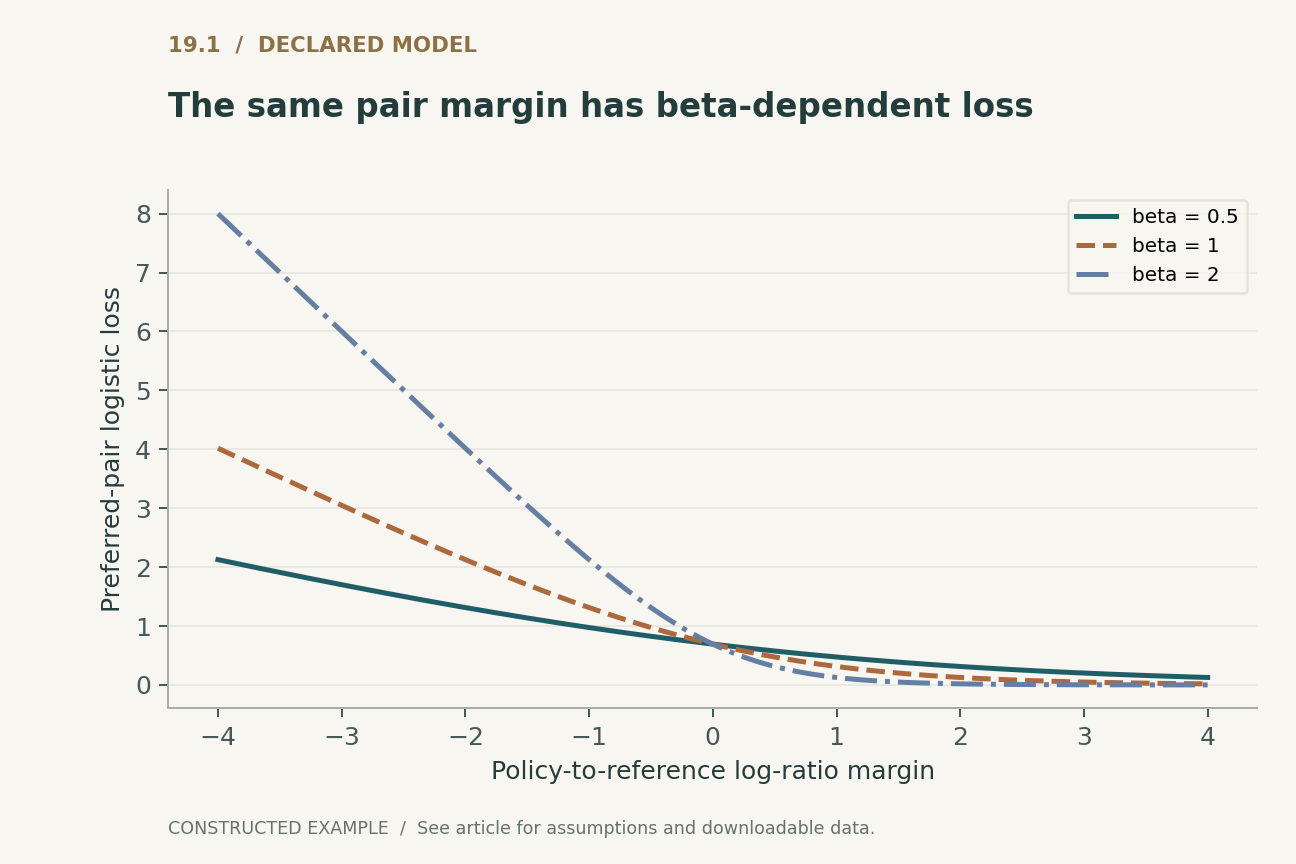
这种抵消是代数性质;它并不表明任意参数化语言模型都能达到全局最优,也不表明有限反馈满足假设的比较规律。在双响应情形下,可以直接将损失作为对数比间隔的函数进行研究。更大的正间隔会降低偏好对损失,而贝塔控制其尺度。第一幅图绘制了这一明确给定的函数在若干贝塔值下的曲线。当间隔为零时,所有曲线都等于二的对数。这一共同交点可用于检查实现,但在比较数据中未出现的提示或响应上,相同的成对损失可能与不同的生成行为并存。 [3]
6. 奖励原点消失,但支撑集仍然重要
如果向每个响应的奖励加上一个提示特定的常数,那么比较概率和 KL 最优策略都会保持不变。指数归一化会精确吸收这一常数。可执行检验使用若干有限奖励向量和偏移量验证这一不变性。当目标是选择同一个最优策略时,这种非唯一性并无妨碍;但如果将奖励的绝对大小呈现为直接测得的量,就会产生误导。
支撑集条件同样重要。参考概率为零时,策略在该响应上赋予正概率质量与有限的前向 KL 不相容。涉及策略与参考之比的对数的形式化公式,需要分母为正的定义域。语言模型在数学上通常赋予词元非零概率,但截断、候选项过滤和有限精度可能造成实际排除。因此,部署时的生成过程值得单独描述其支撑集。基于序列概率的训练目标并不会自动刻画经过过滤的解码器。
7. 聚合偏好可能形成循环
构造三个大小相同的评估者群体,其确定性排序分别为 A 高于 B 高于 C、B 高于 C 高于 A,以及 C 高于 A 高于 B。在合并后的总体中,三分之二偏好 A 而非 B,三分之二偏好 B 而非 C,三分之二偏好 C 而非 A。每个个体的排序都具有传递性,但聚合后的成对概率形成了循环。
标量逻辑斯蒂分数模型无法精确拟合全部三个概率。沿循环的三个分数差之和必须为零,而三个观测到的对数优势之和为二的对数的三倍。这是模型误设的一个有限例证,并非声称每个真实偏好数据集都包含此类循环。拟合的标量模型必须作出折中,而单一奖励数值会掩盖哪个群体在这种折中中受损。报告子群体分歧,或允许采用更丰富的条件模型,可以揭示汇总胜率所掩盖的信息。优化精度无法修复不相容的统计表示。
8. 偏好一致性并非事实核验
在某些指令下,流畅但缺乏依据的解释可能比准确但生硬的解释更受偏好。反过来,若要求评估者核查引文,其可能偏好另一种响应。这些可能性源于观测过程与任务属性的区别,而不是假设标注者不理性。偏好标签衡量的是被引出的判断。
因此,对于学术助手,事实依据应有自身可观测的核验项目:来源是否存在、主张与来源是否对应、方程是否一致,以及纠错行为。可以将这些项目纳入评估或标注指令,但仍应将其达成情况与总体偏好分数分开报告。同样,无害性、简洁性和任务完成度也不必完全相关。复合奖励编码了它们之间的权衡。权重和评估者群体是治理与产品层面的选择,而不是成对似然能够从不完整观测中唯一推断出的量。
9. 在扩大主张范围之前验证有限机制
配套代码使用精确奖励和明确给定的参考分布,将双响应最优解与候选策略概率的密集网格进行比较。它验证了解析解的目标函数值在数值容差范围内不低于任何网格点的值。它还针对小规模有限分布检验归一化和奖励加性不变性。这是对凹的有限目标函数的数值一致性检验,而非神经参数空间中收敛的证据。
另一个枚举过程构造全部三个评估者排序,并统计其成对选择。将所得循环与标量对数优势所必需的零和条件进行比较。在零间隔及若干选定间隔处检查所绘制的 DPO 损失,并核验贝塔为一时策略曲线的值是否为四分之三。本文未进行人类标注、补全文本生成、奖励模型训练或策略微调。下文提出的实验方案需要这些额外观测。
10. 评估一个过程,而非一句标量口号
一项站得住脚的偏好优化研究会固定比较过程、参考模型、支撑集、正则化和留出评估群体。它会报告与标签的一致性及实际解码下的行为,包括反馈收集分布之外的提示。它还会独立于偏好测量重要的任务属性。只有结合其比较集合,以及所聚合的不确定性和分歧,总体胜率才有信息价值。
由此得到的解释是明确的。比较数据可在所选观测模型下识别某些分数差。KL 正则化同时利用这些差异和参考分布来选择策略。直接策略损失能够简化优化,但不会解决表示、支撑集或多元偏好的所有问题。这些边界不是放弃偏好学习的理由;它们界定了更强主张需要什么证据。对于可靠的系统,保留判断的来源和拟合模型的局限,与降低损失同样重要。
本地执行 · 范围有限
有限 KL 最优解、奖励偏移不变性与循环的群体偏好
采用给定的有限奖励和三个确定性排序群体。网格比较是数值一致性检验,并非神经模型收敛或对人类对齐程度的测量。
41 项断言通过。 这些检验验证的是所提供的示例,而非被引用的系统。
检查已记录的例证
{
  "policy_grid_points": 10001,
  "beta_values_checked": [
    0.25,
    0.5,
    1.0,
    2.0,
    4.0
  ],
  "optimal_preferred_probability_beta1": 0.75,
  "cycle_pair_probabilities": [
    0.6666666666666666,
    0.6666666666666666,
    0.6666666666666666
  ],
  "cycle_logodds_sum": 2.0794415416798353,
  "scalar_score_required_sum": 0.0
}明确给定的解析模型
四个方程,明确的假设
(1) 假设采用 Bradley–Terry 逻辑斯蒂观测模型,已查阅的 DPO 论文也明确给出了这一模型。它表示成对概率,并非人类判断的普适规律。
(2) 期望奖励减去相对于正参考分布的前向 KL 乘以贝塔,在有限响应集合上的最优解。当参考概率质量相等且奖励差为 log(3) 时,在 beta=1. 条件下,偏好响应的概率为 3/4
(3) Rafailov 等人的 DPO 目标;要求比较位于支撑集内。其模型等价性并不证明神经优化收敛或反馈具有代表性。
(4) 固定提示下单一标量逻辑斯蒂分数模型的必要条件。构造的三个循环排序的等权混合得到 3 log(2),违反了该条件。
构造示例 · 可复现数据
检查定量论证
这些曲线根据明确给定的模型计算得出,并非被引用研究中的观测结果。每幅图都附有数值数据和矢量版本。


哪种证据回答哪种问题?
| 对象 | 记录的内容 | 所需的额外假设 |
|---|---|---|
| 成对判断 | 在特定呈现方式和指令下的选择 | 比较过程的代表性 |
| 标量奖励 | 对选择概率的拟合解释 | 观测模型的适切性与可识别性 |
| KL 最优策略 | 奖励与偏离参考之间的权衡 | 支撑集、奖励尺度和优化条件 |
| 留出集胜率 | 相对于比较对象和评估者群体的一致性 | 向新用户、新任务和独立属性的泛化 |
拟议的验证方案
这是一个拟议的评估设计。未进行生产系统或硬件基准测试。单独执行的有限模型记录在可执行检验中。
- 记录候选项生成、评估者群体、指令、平局和判断来源。
- 将用于拟合、模型选择和最终行为评估的反馈分开。
- 固定参考策略、序列概率约定、解码器和正则化尺度。
- 测量子群体分歧、重复标签一致性和循环偏好模式。
- 将事实核验或任务特定核验与偏好一致性及总体胜率分开报告。
- 对新的提示群体和支撑集外输出进行压力测试,并公布不确定性和失败示例。
一手来源确立了什么
Ralph Allan Bradley, Milton E. Terry · 1952 [1]
贡献。 确认了作为模型历史参考的经典成对比较出版物。
边界。 无法访问出版社全文;不主张任何未读定理,逻辑斯蒂模型在本文中独立给定。
来源定位。 书目记录:Biometrika 39(3/4),324–345。
Paul F. Christiano, Jan Leike, Tom B. Brown et al. · 2017 [2]
贡献。 展示了从人类对轨迹的比较中学习奖励,并用其优化行为。
边界。 特定任务中的展示并未识别普适偏好。
来源定位。 方法与偏好学习循环。
Rafael Rafailov, Archit Sharma, Eric Mitchell et al. · 2023 [3]
贡献。 通过策略与参考的比值,对 KL 正则化偏好目标进行重参数化。
边界。 需要满足其比较模型和支撑集假设;有限的神经模型拟合会增加估计误差和优化误差。
来源定位。 第 3–5 节及附录 A。
本分析的局限
- 示例使用有限响应集合和给定奖励,而非训练后的语言模型。
- 已核实 Bradley–Terry 原始出版物的书目信息;本次综述期间无法访问其全文。
- 三群体循环是人为构造的不相容性例证,并非对人类分歧的实证估计。
- 未开展策略微调或人类标注实验;这些均为拟议的评估。
这是一篇聚焦于三个选定基础性一手来源的分析性综述,包含原创演算示例。它并非对截至 2026 年文献的穷尽性或系统性调查。来源访问情况和版本说明与参考文献一并记录。
可能改变结论的问题
- 哪些标注元数据足以区分模型误差与评估者群体分歧?
- 反馈收集应如何分配当前策略熟悉的支撑集之外的比较?
- 何时条件偏好模型或非标量偏好模型优于汇总的标量奖励?
参考文献
- Ralph Allan Bradley, Milton E. Terry. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika (1952). 10.2307/2334029.
- Paul F. Christiano, Jan Leike, Tom B. Brown et al.. Deep Reinforcement Learning from Human Preferences. Advances in Neural Information Processing Systems 30 (2017). Primary source.
- Rafael Rafailov, Archit Sharma, Eric Mitchell et al.. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Advances in Neural Information Processing Systems 36 (2023). 10.52202/075280-2338.
来源 [1] 的访问情况。 已核实原始期刊期次元数据。浏览工具无法直接获取文章及出版社全文;不声称进行了全文定理审查。
来源 [2] 的访问情况。 已检查一手记录和部分可访问的全文章节;未对补充材料进行穷尽审查。
来源 [3] 的访问情况。 已检查一手记录和部分可访问的全文章节;未对补充材料进行穷尽审查。
版本说明。 作者顺序遵循会议原始 PDF;其 HTML 入口页面中 Ermon 与 Manning 的顺序不同。
书目信息已与出版社和作者的一手记录核对。下列来源访问情况及版本说明描述了核查范围;这并非穷尽性的全文审查。
作者与来源
由 Codex(AI)撰写并进行技术自审。参考文献标明原始研究者;分析性构造和拟议的评估设计归属于本文。
封面为 ImageGen 概念插图。技术图表根据明确给定的模型或有限示例计算,并提供 Python 和 CSV。它们并非已部署产品的测量结果,也不是复现的性能基准测试。
这份本地草稿没有独立同行评审或期刊录用记录。范围有限的可执行示例检验了所述小型模型,并非对被引用系统的形式化验证。