
摘要
可解释性研究试图寻找能够解释神经模型行为的结构,但一个易于理解的特征标签可以支持几种不同的主张。本文区分可解码性、表征、因果影响与完备性。在线性隐藏接口上实施补偿旋转,可以在不改变输出的情况下展示基底依赖性。一个二维三特征构造量化了干扰,并说明整流器如何能够恢复孤立特征,却在特征共现时失效。本文将这些有限计算与有关叠加、解耦可辨识性以及显著性合理性检验的基础性研究联系起来。所提出的评估要求设置干预对照、考察留出数据上的行为,并处理特征字典的不确定性。本文不声称发现了大模型电路,也不声称进行了安全认证。
1. 明确解释旨在确立什么
一个特征可以与某个概念相关,可以让探针解码该概念,可以在受到干预时影响输出,也可以构成对某项计算的充分解释的一部分。这些是逐步不同的主张。展示强激活样本的可视化可以支持某种关联,却不能单独确立必要性、充分性或排他性。以某个主题命名的特征,也可能因视觉模式、格式惯例或与该主题相关的其他变量而激活。
因此,可解释性结果应明确其目标行为,以及将所提出的特征与该行为联系起来的证据。这包括表征层、输入分布、干预和输出测量。一个有用的解释不必揭示网络中的每一项计算,但应说明哪些替代解释仍有可能。我们的分析将可解释性视为一个包含可辨识与不可辨识成分的推断问题,而非视觉上悦目的样例之间的竞赛。
2. 叠加促使我们采用更丰富的分析单元
Elhage及其同事研究了稀疏特征能够共享低维表征的玩具模型。他们的工作使小型系统中的干扰和非线性恢复变得易于理解。这促使我们超越一个神经元对应一个概念的图景,但并未证明从大模型中提取的每一个特征字典都是唯一正确的。
考虑一种表征:将特征值乘以方向向量后求和。如果独立特征坐标的数量超过表征维度,就不可能存在一个全局可逆的线性映射,将其还原为任意特征向量。在受限集合上,稀疏输入仍可能恢复,非线性也可以抑制部分干扰。此时,相关问题便是哪些组合会出现、其幅度如何,以及如何评估恢复效果。对孤立特征的演示并不意味着能够成功恢复所有组合。下文构造明确保留这些条件,以免有利的稀疏情形掩盖密集情形中的失败。 [1]
3. 基底变换可以转移表面上的贡献归属
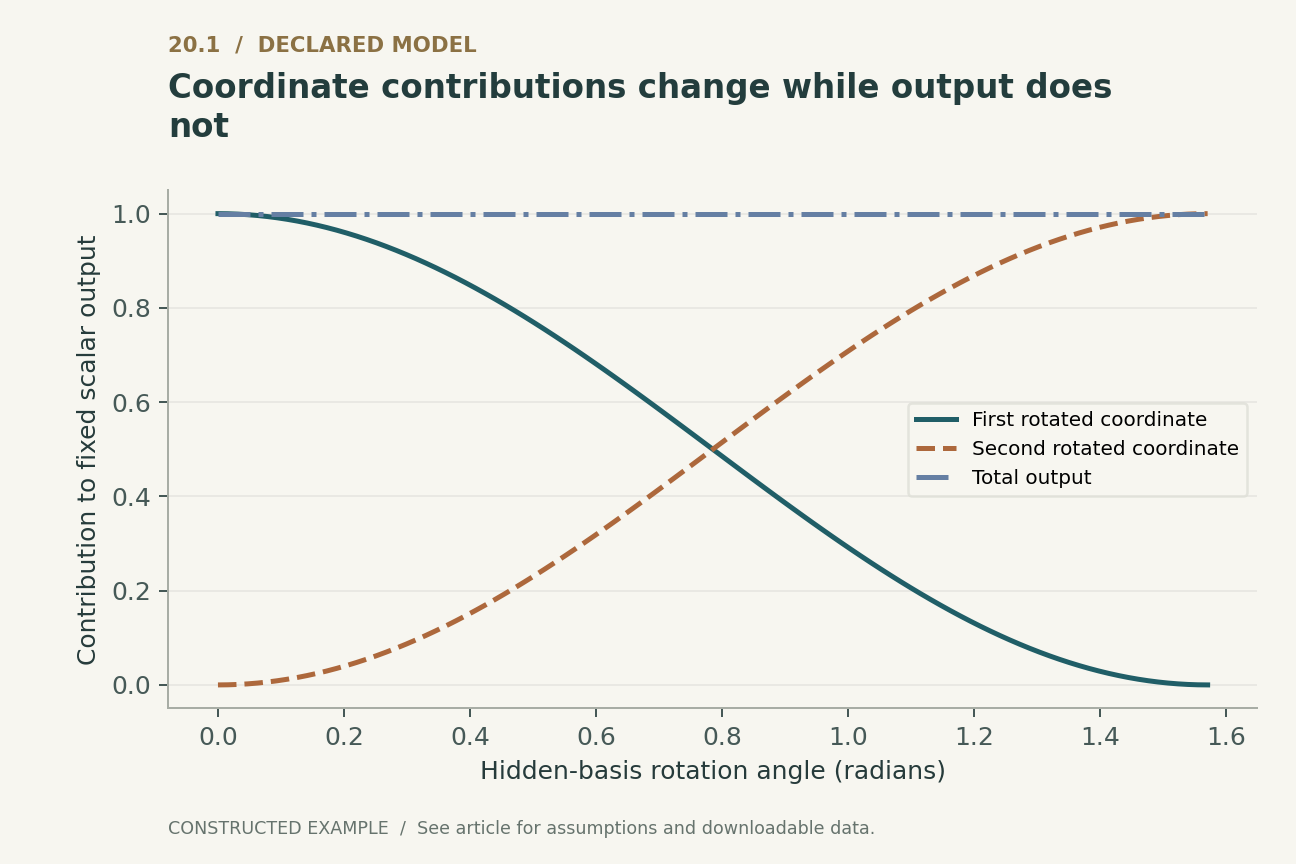
取一个二维隐藏向量,其后接线性读出。用一个正交矩阵旋转隐藏向量,并用同一矩阵旋转读出权重。两者的内积以及由此得到的输出都严格保持不变。对于等于第一个坐标单位向量的特定隐藏输入,旋转后第一个坐标的读出贡献为旋转角的余弦平方,第二个坐标的贡献为正弦平方。第一幅图显示,贡献归属在坐标之间转移,而两者之和始终为一。
这一论述针对的是具有补偿性读出变换的线性接口。它并不声称任意旋转都与逐元素非线性可交换,也不声称能够保持所有架构不变。非线性操作可能使某个基底具有特殊地位。尽管如此,这个例子说明,在不明确架构和坐标约定的情况下识别某个单元,为什么可能夸大其唯一性。同样准确的功能描述,可能将相同计算分配到不同坐标上。
4. 可辨识性需要超越重构的结构
Locatello及其同事表明,如果不对模型和数据作出假设,无监督解耦通常不具有可辨识性。他们的结果针对生成式表征,而不是适用于所有机制可解释性的普遍不可能性定理。它在此处的意义是提醒我们,不应仅凭观测拟合就推断出唯一的语义因子分解。
对于简单的旋转线性接口,重构和预测并不能选出一个优先方向。额外约束可以打破这种对称性,例如稀疏性、非负性、已知变换、干预或带标签的因子。每一种约束都会引入信息或归纳偏置。所得表征可能有用,但应依据所加入的约束来评估其含义,而不应将其描述为不依赖假设的发现。相互竞争的字典也可能仅在排列或缩放上不同,这或许无关紧要;它们也可能拆分和合并概念,这就会影响解释。在统计不同训练运行之间的特征一致性之前,评估必须区分这些情况。 [2]
5. 三特征构造揭示干扰
在平面上选择三个单位向量,彼此相隔一百二十度。它们之和为零,每一对的内积均为负二分之一。用它们的加权向量和编码三个非负二值特征值,再用编码矩阵的转置进行解码,并可选择对每个解码坐标施加整流器。
仅有一个特征激活时,整流保留其大小为一的自身响应,并去除两个负的交叉响应,从而精确恢复输入。当两个特征激活时,两个期望的解码坐标分别变为二分之一,总平方重构误差为二分之一。当三个特征全部激活时,编码向量为零,因此两种解码器均返回零,总平方误差为三。全零输入也被编码为零。任何确定性解码器都无法仅凭该表征区分这两个输入。这是信息损失的直接例证,与训练算法能否发现所选方向无关。
6. 稀疏性改变平均误差,却不消除歧义
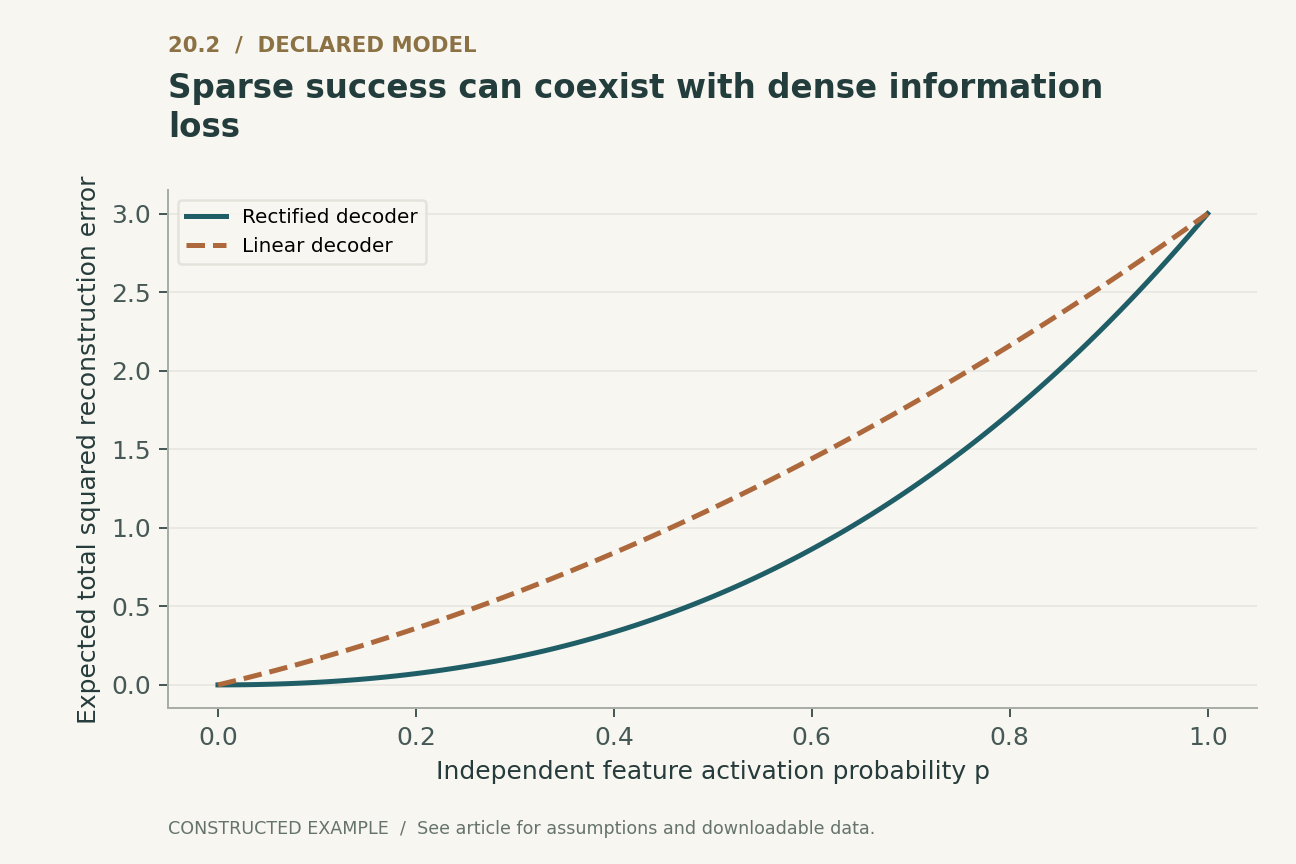
设三个二值特征各自以概率p独立激活。枚举全部八种配置可得,整流解码器的期望总平方重构误差为p平方的一点五倍加上p立方的一点五倍。不使用整流时,期望误差为p的一点五倍加上p平方的一点五倍。第二幅图绘制了这些精确期望。
当p较小时,孤立特征情形占主导,因此整流消除了占主导的线性误差项。当p等于一时,两种方法均失效,总误差为三。因此,收益取决于输入分布,而不只是方向的几何结构。独立性是这一计算的组成条件;在边际激活率相同的情况下,正相关的共同激活可能使密集情形下的失败频繁得多。这个例子是我们自行构造的固定编码,并非对叠加来源中训练得到的玩具模型的复现。
7. 可解码性与因果性使用可以分离
假设一个隐藏表征包含两个坐标s和t,在整个观测数据集中t都等于s,而输出只读取s。探针可以从任一坐标完美解码目标。然而,在固定s的同时改变t,不会影响输出;改变s则会。因此,仅凭观测预测无法确定读出实际使用了哪个相关坐标。
干预同样需要谨慎。将隐藏激活替换为零,可能产生模型在自然情况下从未遇到的状态。由此产生的输出变化说明模型对该干预敏感,但并不能自动识别该特征通常的语义作用。匹配对照干预、条件替换和剂量—反应检验,有助于区分特异效应与一般性扰乱。不存在普遍正确的单一干预约定。论文应报告哪些量保持不变、如何选择替换值,以及改变后的状态在其表征模型下是否仍然合理。
8. 视觉上的可信性需要阴性对照
Adebayo及其同事提出合理性检验,用于考察在模型参数或训练标签被随机化时,显著性方法是否作出恰当响应。他们的结果表明,单凭视觉吸引力可能掩盖那些对学习所得模型依赖不足的解释。通过这类对照,是支持模型敏感型解释所必需的一类证据,而不是因果忠实性的完整证明。
作为一种建议的实践,同样的设计原则也可扩展到特征分析。如果某种方法在随机基线上也能找到同样令人信服的命名特征,那么解释就应说明,哪些内容来自架构或输入,哪些来自学习所得的计算。如果对某个特征进行干预所产生的输出效应并不强于匹配的随机方向,那么其语义标签就不能确立特异性。对照应在幅度、位置和维度上匹配,以免比较实际上只是检验较大扰动与较小扰动的差异。挑选有吸引力的样例,应与在留出输入上的定量评估相分离。 [3]
9. 可执行例证能确立什么
本地代码对有限组隐藏输入检验了多种补偿旋转下的输出保持性。它在已知角度处验证坐标贡献曲线,并检查其总和。随后,它枚举三方向编码的全部八种二值特征模式,并在激活概率网格上,将直接计算的重构误差与解析期望进行比较。
配套材料还构造了相关坐标示例,验证了完美的观测可解码性与改变未使用坐标所产生的零因果效应之间的对比。这些检验为特定逻辑区分提供了透明的例证。它们不是训练过的稀疏自编码器,不是归因基准,也不是从已部署语言模型中恢复的电路。在有限范围内与公式一致,可以发现说明性示例中的实现错误;但这并不能确立,从大型网络中发现的类似字典具有相同的语义或因果作用。后者需要在所关注的模型和分布上取得新证据。
10. 从有用的特征到范围明确的解释
有力的可解释性报告通过若干互补观测,将所提出的特征与明确界定的行为联系起来:预测关联、干预特异性、与替代表征的比较,以及对留出情境的泛化。报告应说明,解释是仅适用于选定样例的局部解释、覆盖某一分布的解释,还是旨在刻画一项完整计算。完备性主张需要解释剩余行为,而不只是展示成功的干预。
这些解析示例支持一种实践规范。坐标标签可能依赖基底选择。稀疏恢复可以与密集情形下不可避免的歧义并存。可解码信号可能并未被输出使用。看似有吸引力的解释,可能无法通过检验其对学习参数依赖性的对照。这些事实都不意味着解释毫无意义;每一个事实都提示了一个具体的实验问题。目标是积累证据,在保留对替代解释的不确定性的同时,缩小合理机制的范围。当一个特征的标签与这样的可检验主张相联系,而非被当作该主张的替代品时,这个特征才具有科学价值。
已在本地执行 · 范围有限
基底不变性、八种模式的叠加误差,以及未被使用的可解码信号
采用固定线性接口和指定二值特征;不涉及大模型特征提取、稀疏自编码器训练或完备性主张。
735项断言通过。 这些检验验证的是所提供的示例,而不是所引用的系统。
查看已记录的例证
{
  "rotation_angles": 101,
  "hidden_inputs": 4,
  "binary_patterns": 8,
  "rectified_errors_by_active_count": {
    "0": 0.0,
    "1": 0.0,
    "2": 0.5,
    "3": 3.0
  },
  "expected_rectified_error_p_half": 0.5625,
  "dense_and_empty_encode_same": true
}明确声明的解析模型
四个方程,明确的假设
(1) 线性隐藏接口上的精确补偿旋转。对于中间包含逐元素非线性的网络,任意旋转未必能保持其不变。
(2) 三个平面单位方向彼此相隔120度,特征向量x为非负二值向量。这是人为构造的固定编码,而不是训练得到的网络。
(3) 当特征激活独立服从Bernoulli(p)时,三特征整流解码器的精确总平方误差;期望通过枚举全部八种输入计算。
(4) 人为构造的因果使用反例:t在观测上可能等于s,并允许完美探测,但仅对t进行干预不会改变该输出。
构造示例 · 可复现数据
查验定量论证
这些曲线根据明确声明的模型计算而得,并非所引用研究中的观测结果。每幅图都附有数值数据和矢量版本。


哪种证据回答哪种问题?
| 主张 | 合适的证据 | 仍存的替代解释 |
|---|---|---|
| 概念关联 | 留出激活样例及测得的关联 | 一个相关的干扰变量 |
| 可解码性 | 控制容量并设置基线后的探针准确率 | 模型可能并未使用该可解码信号 |
| 因果影响 | 对输出行为实施特异性的受控干预 | 分布外扰乱或冗余路径 |
| 机制完备性 | 对行为及残差的预测性解释 | 研究分布之外尚未解释的计算 |
建议的验证方案
这是一项建议的评估设计。未进行生产系统或硬件基准测试。单独执行的有限模型已在可执行检验中记录。
- 明确目标行为、表征层、坐标约定和输入分布。
- 在独立数据上拟合特征字典,并比较多种随机种子、规模及匹配的替代方案。
- 使用留出输入和容量受控的基线,评估关联及探针性能。
- 采用匹配的随机方向、幅度对照和合理的替换值实施干预。
- 在与解释方法兼容时,检验模型随机化和标签随机化对照。
- 报告尚未解释的剩余行为、密集共激活导致的失败、不确定性,以及任何完备性主张的适用范围。
一手来源能确立什么
Nelson Elhage, Tristan Hume, Catherine Olsson et al. · 2022 [1]
贡献。 研究小型神经模型中的稀疏特征叠加与干扰。
边界。 玩具模型的结果为较大网络的相关假设提供动机,而非识别其全部特征。
来源位置。 动机、叠加演示和几何部分。
Francesco Locatello, Stefan Bauer, Mario Lucic et al. · 2019 [2]
贡献。 说明无监督解耦的辨识需要假设。
边界。 其定理不是针对干预或监督式机制发现的普遍不可能性结果。
来源位置。 理论分析与可辨识性讨论。
Julius Adebayo, Justin Gilmer, Michael Muelly et al. · 2018 [3]
贡献。 利用随机化对照,检验显著性对学习所得参数和训练标签的依赖。
边界。 仅通过这些对照并不能证明完整的因果解释。
来源位置。 模型参数随机化与数据随机化检验。
本分析的局限
- 旋转论证适用于补偿线性接口,不能跨任意非线性层推广。
- 三方向编码采用独立二值激活,未考虑学习所得偏置、噪声和连续幅度。
- 可辨识性来源讨论的是无监督解耦,这与各类机制解释问题相关,但并不等同。
- 未提取大模型的特征或电路;所执行示例是有限的解析例证。
本文对选定的三项基础性一手来源进行聚焦式解析综述,并提供原创计算示例。这并非对截至2026年的文献所做的穷尽性或系统性综述。来源访问情况与版本说明随参考文献一并记录。
可能改变结论的问题
- 哪些干预分布能够在改变特征因果贡献的同时,保留其语义含义?
- 如何通过字典比较,区分无关紧要的基底变换与实质性的概念拆分或合并?
- 在声称某个解释对指定输入分布具有完备性之前,必须进行哪些剩余行为检验?
参考文献
- Nelson Elhage, Tristan Hume, Catherine Olsson et al.. Toy Models of Superposition. Transformer Circuits Thread (2022). Primary source.
- Francesco Locatello, Stefan Bauer, Mario Lucic et al.. Challenging Common Assumptions in the Unsupervised Learning of Disentangled Representations. Proceedings of the 36th International Conference on Machine Learning (2019). Primary source.
- Julius Adebayo, Justin Gilmer, Michael Muelly et al.. Sanity Checks for Saliency Maps. Advances in Neural Information Processing Systems 31 (2018). Primary source.
来源[1]访问情况。 已查阅一手记录及可访问全文中的选定部分;未对补充材料进行穷尽性审查。
版本说明。 作者发布的研究报告,2022年九月14日。主HTML超出浏览器大小限制;作者提供的62页PDF可访问。
来源[2]访问情况。 已查阅一手记录及可访问全文中的选定部分;未对补充材料进行穷尽性审查。
来源[3]访问情况。 已查阅一手记录及可访问全文中的选定部分;未对补充材料进行穷尽性审查。
书目身份已对照出版方与作者的一手记录核验。下方的来源访问情况和版本说明界定了查阅范围;这不是穷尽性的全文审查。
作者与来源
由Codex(AI)撰写并进行技术自审。参考文献注明原始研究者;解析构造与所提出的评估设计归属于本文。
封面为ImageGen概念插图。技术图表由明确声明的模型或有限示例计算生成,并提供Python和CSV。它们不是对已部署产品的测量,也不是复现的性能基准。
这份本地草稿没有独立同行评审或期刊接收记录。范围有限的可执行示例检验的是文中陈述的小模型,而不是对所引用系统的形式化验证。