
Resumen
La investigación en interpretabilidad busca estructuras que expliquen el comportamiento de un modelo neuronal, pero una etiqueta comprensible de una característica puede respaldar afirmaciones diferentes. Este artículo distingue entre decodificabilidad, representación, influencia causal y completitud. Una rotación compensada de una interfaz oculta lineal demuestra la dependencia de la base sin modificar la salida. Una construcción de tres características en dos dimensiones cuantifica la interferencia y muestra cómo un rectificador puede recuperar características aisladas y, aun así, fallar cuando estas aparecen conjuntamente. Estos cálculos finitos se conectan con trabajos fundacionales sobre superposición, identificabilidad del desenmarañamiento y comprobaciones de validez de los métodos de saliencia. La evaluación propuesta requiere controles de intervención, comportamiento en datos reservados e incertidumbre acerca de los diccionarios de características. No se afirma haber descubierto circuitos en modelos grandes ni haber certificado su seguridad.
1. Definir qué pretende demostrar una explicación
Una característica puede estar asociada con un concepto, permitir que una sonda decodifique ese concepto, influir en una salida cuando se interviene sobre ella o formar parte de una explicación suficiente de un cálculo. Estas afirmaciones son progresivamente distintas. Una visualización de ejemplos que producen activaciones intensas puede respaldar una asociación, pero no demuestra por sí sola necesidad, suficiencia ni exclusividad. Una característica denominada según un tema también puede activarse ante un patrón visual, una convención de formato u otra variable correlacionada con ese tema.
Por tanto, un resultado de interpretabilidad debe especificar el comportamiento que pretende explicar y la evidencia que conecta la característica propuesta con dicho comportamiento. Esto incluye la capa de representación, la distribución de entrada, la intervención y la medición de la salida. Una explicación útil no tiene que revelar todos los cálculos de una red, pero debe indicar qué alternativas siguen siendo posibles. Nuestro análisis trata la interpretabilidad como un problema de inferencia con componentes identificables y no identificables, en lugar de como una competición entre ejemplos visualmente atractivos.
2. La superposición motiva una unidad de análisis más rica
Elhage y sus colegas estudian modelos de juguete en los que características dispersas pueden compartir una representación de menor dimensionalidad. Su trabajo hace accesibles la interferencia y la recuperación no lineal en sistemas pequeños. Motiva ir más allá de la imagen de una neurona por concepto, sin demostrar que cada diccionario de características extraído de un modelo grande sea el único correcto.
Consideremos una representación formada sumando los valores de las características multiplicados por vectores de dirección. Si el número de coordenadas independientes de las características supera la dimensión de la representación, es imposible disponer de una aplicación lineal globalmente invertible que recupere vectores de características arbitrarios. Las entradas dispersas aún pueden ser recuperables en un conjunto restringido, y las no linealidades pueden suprimir parte de la interferencia. La pregunta pertinente es entonces qué combinaciones aparecen, con qué amplitudes y cómo se evalúa la recuperación. Una demostración con características aisladas no implica recuperar correctamente todas las combinaciones. La construcción siguiente mantiene explícitas estas condiciones para que un caso disperso favorable no oculte un fallo en el caso denso. [1]
3. Un cambio de base puede desplazar la responsabilidad aparente
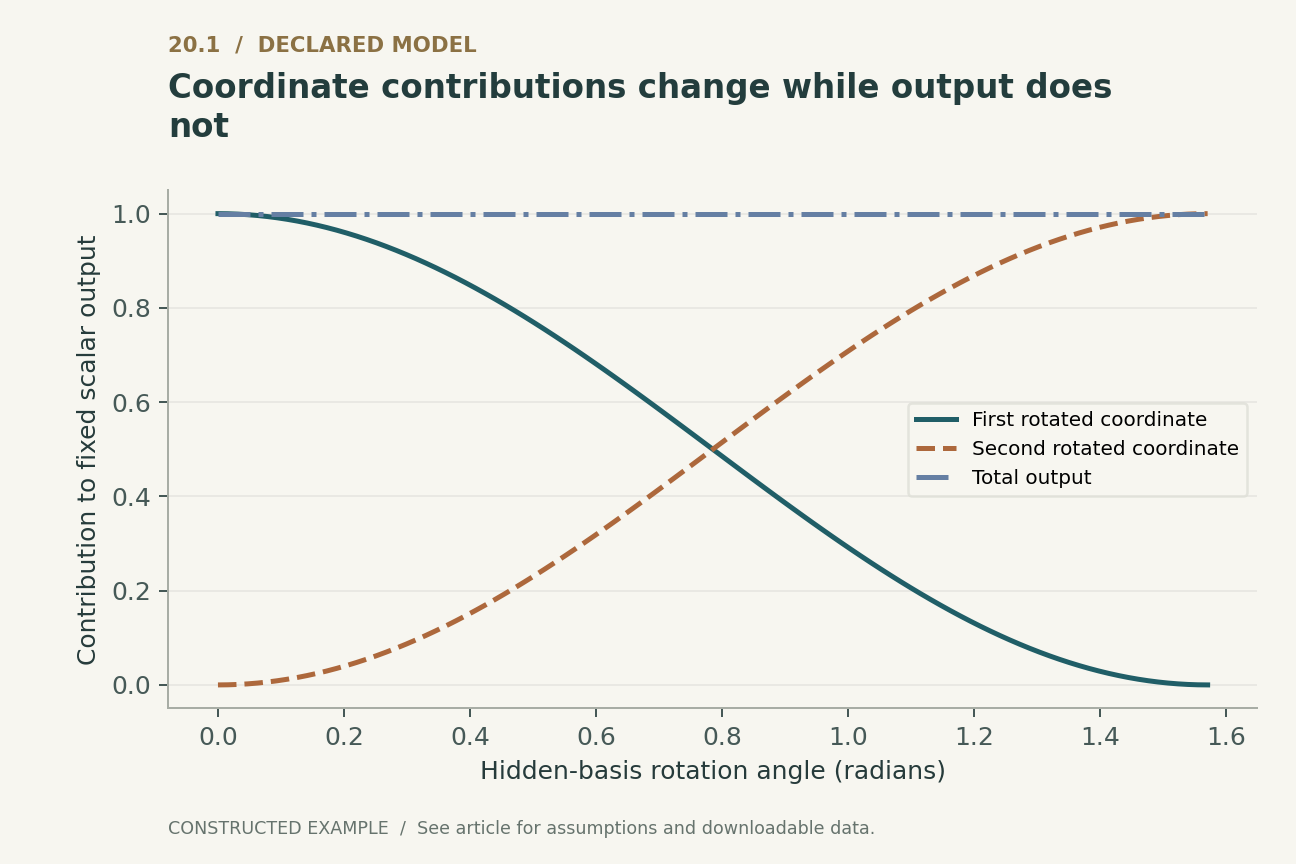
Tomemos un vector oculto bidimensional seguido de una lectura lineal. Rotemos el vector oculto mediante una matriz ortogonal y los pesos de lectura mediante esa misma matriz. Su producto interno y, por tanto, la salida permanecen exactamente iguales. Para una entrada oculta particular igual al primer vector de coordenadas, la contribución a la lectura de la primera coordenada rotada es el coseno al cuadrado del ángulo de rotación, y la de la segunda es el seno al cuadrado. La primera figura muestra cómo la responsabilidad se desplaza entre coordenadas mientras su suma sigue siendo uno.
Esta afirmación se refiere a una interfaz lineal con una transformación compensatoria de la lectura. No sostiene que las rotaciones arbitrarias conmuten con las no linealidades elemento a elemento ni que preserven cualquier arquitectura. Una operación no lineal puede privilegiar una base. No obstante, el ejemplo muestra por qué identificar una unidad individual sin especificar la arquitectura y la convención de coordenadas puede exagerar su unicidad. Una descripción funcional igualmente precisa puede distribuir el mismo cálculo entre coordenadas distintas.
4. La identificabilidad requiere estructura más allá de la reconstrucción
Locatello y sus colegas muestran que el desenmarañamiento no supervisado no es, en general, identificable sin supuestos sobre los modelos y los datos. Su resultado concierne a las representaciones generativas; no es un teorema general de imposibilidad para toda la interpretabilidad mecanicista. Su pertinencia aquí consiste en advertir contra la inferencia de una factorización semántica única a partir únicamente del ajuste observacional.
En la interfaz lineal rotada simple, la reconstrucción y la predicción no seleccionan una orientación preferida. Restricciones adicionales pueden romper esa simetría: dispersidad, no negatividad, transformaciones conocidas, intervenciones o factores etiquetados. Cada una introduce información o un sesgo inductivo. La representación resultante puede ser útil, pero su significado debe evaluarse con respecto a las restricciones añadidas, en vez de describirse como un descubrimiento libre de supuestos. Los diccionarios alternativos también pueden diferir solo por una permutación o un cambio de escala, lo que puede ser inocuo, o pueden dividir y fusionar conceptos, lo que afecta a la interpretación. Una evaluación debe distinguir estos casos antes de contabilizar la concordancia entre características de distintas ejecuciones de entrenamiento. [2]
5. Una construcción de tres características revela la interferencia
Elijamos tres vectores unitarios en un plano, separados por ciento veinte grados. Su suma es cero y el producto interno de cada par es menos un medio. Codifiquemos tres valores binarios no negativos de características mediante su suma vectorial ponderada, decodifiquemos con la transpuesta de la matriz de codificación y apliquemos, opcionalmente, un rectificador a cada coordenada decodificada.
Cuando hay una sola característica activa, la rectificación conserva su respuesta propia unitaria y elimina las dos respuestas cruzadas negativas, recuperando exactamente la entrada. Con dos características activas, las dos coordenadas decodificadas deseadas pasan a valer un medio cada una, lo que produce un error cuadrático total de reconstrucción de un medio. Con las tres activas, el vector codificado es cero, por lo que ambos decodificadores devuelven cero y el error cuadrático total es tres. La entrada completamente nula también se codifica como cero. Ningún decodificador determinista puede distinguir estas dos entradas a partir únicamente de la representación. Este es un testigo directo de pérdida de información, independientemente de que un algoritmo de entrenamiento pudiera descubrir las direcciones elegidas.
6. La dispersidad cambia el error medio sin eliminar la ambigüedad
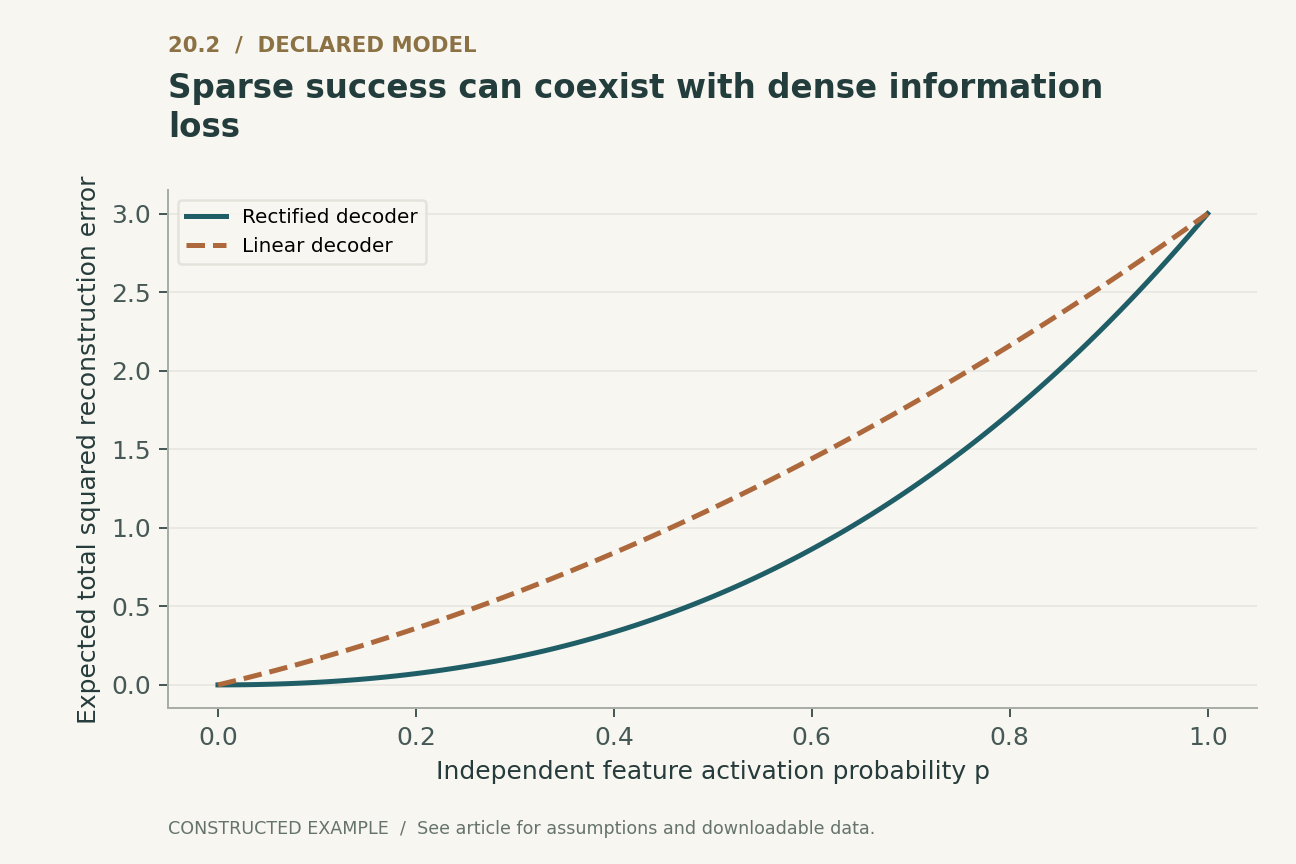
Supongamos que cada una de las tres características binarias se activa de forma independiente con probabilidad p. La enumeración de las ocho configuraciones da, para el decodificador rectificado, un error cuadrático total esperado de reconstrucción de uno y medio por p al cuadrado más uno y medio por p al cubo. Sin rectificación, el error esperado es uno y medio por p más uno y medio por p al cuadrado. La segunda figura representa estas esperanzas exactas.
Cuando p es pequeña, predominan los casos de características aisladas, por lo que la rectificación elimina el término lineal dominante del error. Cuando p es igual a uno, ambos métodos fallan con un error total de tres. Por tanto, la mejora depende de la distribución de entrada, no solo de la geometría de las direcciones. La independencia forma parte de este cálculo; una coactivación positivamente correlacionada puede hacer que el fallo en el caso denso sea mucho más frecuente con las mismas tasas marginales de activación. Este ejemplo es una construcción propia con un código fijo, no una reproducción de los modelos de juguete entrenados de la fuente sobre superposición.
7. La decodificabilidad y el uso causal pueden disociarse
Supongamos que una representación oculta contiene dos coordenadas, s y t, y que t es igual a s en todo un conjunto de datos observado, mientras la salida solo lee s. Una sonda puede decodificar perfectamente el objetivo a partir de cualquiera de las dos coordenadas. Sin embargo, cambiar t manteniendo s fija no afecta a la salida. Cambiar s sí lo hace. Por tanto, la predicción observacional por sí sola no permite determinar cuál de las coordenadas correlacionadas utiliza realmente la lectura.
Las intervenciones también requieren cuidado. Sustituir una activación oculta por cero puede crear un estado que el modelo nunca encuentra de forma natural. Un cambio resultante en la salida muestra sensibilidad a esa intervención, pero no identifica automáticamente la función semántica habitual de la característica. Las intervenciones con controles emparejados, las sustituciones condicionales y las comprobaciones de dosis-respuesta pueden ayudar a distinguir los efectos específicos de una perturbación genérica. Ninguna convención de intervención es universalmente correcta. Un artículo debe informar de qué se mantuvo fijo, cómo se eligieron los valores de sustitución y si los estados alterados siguieron siendo plausibles según su modelo de representación.
8. La plausibilidad visual necesita controles negativos
Adebayo y sus colegas proponen comprobaciones de validez que examinan si los métodos de saliencia responden adecuadamente cuando se aleatorizan los parámetros del modelo o las etiquetas de entrenamiento. Sus resultados muestran que el atractivo visual por sí solo puede ocultar explicaciones que dependen insuficientemente del modelo aprendido. Superar un control de este tipo es una clase de evidencia necesaria para una interpretación sensible al modelo, no una prueba completa de fidelidad causal.
El mismo principio de diseño se extiende al análisis de características como práctica propuesta. Si un método encuentra características denominadas igualmente convincentes en una referencia aleatoria, la explicación debe aclarar qué procede de la arquitectura o de las entradas y qué procede del cálculo aprendido. Si la intervención sobre una característica no produce en la salida un efecto mayor que una dirección aleatoria emparejada, su etiqueta semántica no demuestra especificidad. Los controles deben igualar magnitud, ubicación y dimensionalidad para que la comparación no se limite a enfrentar perturbaciones mayores con otras menores. La selección de ejemplos atractivos debe separarse de la evaluación cuantitativa con entradas reservadas. [3]
9. Qué demuestran los ejemplos testigo ejecutables
El código local comprueba la preservación de la salida bajo varias rotaciones compensadas para un conjunto finito de entradas ocultas. Verifica las curvas de contribución de las coordenadas en ángulos conocidos y comprueba su suma. Después enumera los ocho patrones binarios de características del código de tres direcciones y compara los errores directos de reconstrucción con las esperanzas analíticas en una cuadrícula de probabilidades de activación.
El material complementario también construye el ejemplo de coordenadas correlacionadas y verifica el contraste entre la decodificabilidad observacional perfecta y el efecto causal nulo de cambiar la coordenada no utilizada. Estas comprobaciones proporcionan testigos transparentes de distinciones lógicas concretas. No son un autocodificador disperso entrenado, una evaluación de referencia de atribución ni un circuito recuperado de un modelo de lenguaje desplegado. La concordancia finita con las fórmulas detecta errores de implementación en las ilustraciones; no demuestra que un diccionario similar descubierto en una red grande tenga la misma semántica o función causal. Eso requiere nueva evidencia en el modelo y la distribución de interés.
10. De una característica útil a una explicación de alcance delimitado
Un informe sólido de interpretabilidad conecta una característica propuesta con un comportamiento definido mediante varias observaciones complementarias: asociación predictiva, especificidad de las intervenciones, comparación con representaciones alternativas y generalización a situaciones reservadas. Debe indicar si la explicación es local a ejemplos seleccionados, abarca una distribución o pretende caracterizar un cálculo completo. Las afirmaciones de completitud requieren dar cuenta del comportamiento residual, no simplemente mostrar intervenciones exitosas.
Los ejemplos analíticos respaldan una disciplina práctica. Las etiquetas de las coordenadas pueden depender de la elección de la base. La recuperación dispersa puede coexistir con una ambigüedad densa inevitable. Una señal decodificable puede no ser utilizada por la salida. Las explicaciones atractivas pueden fallar en controles que prueban su dependencia de los parámetros aprendidos. Ninguno de estos hechos hace inútil la interpretación; cada uno sugiere una pregunta experimental concreta. El objetivo es acumular evidencia que reduzca los mecanismos plausibles manteniendo la incertidumbre sobre las alternativas. Una característica adquiere valor científico cuando su etiqueta se vincula a una afirmación comprobable de este tipo, en vez de ofrecerse como sustituto de ella.
Ejecutado localmente · Alcance delimitado
Invariancia respecto de la base, errores de superposición de ocho patrones y señal decodificable no utilizada
Interfaces lineales fijas y características binarias asignadas; sin extracción de características de modelos grandes, entrenamiento de autocodificadores dispersos ni afirmaciones de completitud.
Se superaron 735 aserciones. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el ejemplo testigo registrado
{
  "rotation_angles": 101,
  "hidden_inputs": 4,
  "binary_patterns": 8,
  "rectified_errors_by_active_count": {
    "0": 0.0,
    "1": 0.0,
    "2": 0.5,
    "3": 3.0
  },
  "expected_rectified_error_p_half": 0.5625,
  "dense_and_empty_encode_same": true
}
Ejecutor del ejemplo · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Rotación compensada exacta en una interfaz oculta lineal. Las rotaciones arbitrarias no tienen por qué preservar una red que contenga no linealidades elemento a elemento interpuestas.
(2) Tres direcciones unitarias en el plano separadas por 120 grados, con un vector de características binario no negativo x. Se trata de un código fijo construido, no de una red entrenada.
(3) Error cuadrático total exacto del decodificador rectificado de tres características cuando sus activaciones son Bernoulli(p) independientes; la esperanza enumera las ocho entradas.
(4) Contraejemplo construido de uso causal: t puede ser igual a s en las observaciones y permitir un sondeo perfecto, pero intervenir solo sobre t no modifica esta salida.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Afirmación | Evidencia adecuada | Alternativa restante |
|---|---|---|
| Asociación con un concepto | Ejemplos de activación reservados y asociación medida | Una variable perturbadora correlacionada |
| Decodificabilidad | Exactitud de la sonda con capacidad y referencias controladas | El modelo podría no utilizar la señal decodificable |
| Influencia causal | Intervenciones específicas y controladas sobre el comportamiento de salida | Perturbación fuera de distribución o vías redundantes |
| Completitud mecanicista | Explicación predictiva del comportamiento y los residuos | Cálculos no explicados fuera de la distribución estudiada |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizaron pruebas de referencia de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Especificar el comportamiento objetivo, la capa de representación, la convención de coordenadas y la distribución de entrada.
- Ajustar los diccionarios de características con datos separados y comparar varias semillas, tamaños y alternativas emparejadas.
- Evaluar la asociación y el rendimiento de la sonda con entradas reservadas y referencias de capacidad controlada.
- Realizar intervenciones con direcciones aleatorias emparejadas, controles de magnitud y valores de sustitución plausibles.
- Probar controles con modelos y etiquetas aleatorizados cuando sean compatibles con el método explicativo.
- Informar del comportamiento residual no explicado, los fallos de coactivación densa, la incertidumbre y el alcance de cualquier afirmación de completitud.
Qué demuestran las fuentes primarias
Nelson Elhage, Tristan Hume, Catherine Olsson et al. · 2022 [1]
Contribución. Estudia la superposición y la interferencia de características dispersas en modelos neuronales pequeños.
Límite. Los resultados de modelos de juguete motivan hipótesis sobre redes mayores, en lugar de identificar todas sus características.
Localización en la fuente. Secciones de motivación, demostración de la superposición y geometría.
Francesco Locatello, Stefan Bauer, Mario Lucic et al. · 2019 [2]
Contribución. Muestra la necesidad de supuestos para identificar el desenmarañamiento no supervisado.
Límite. Su teorema no es un resultado universal de imposibilidad para las intervenciones o el descubrimiento supervisado de mecanismos.
Localización en la fuente. Análisis teórico y discusión de la identificabilidad.
Julius Adebayo, Justin Gilmer, Michael Muelly et al. · 2018 [3]
Contribución. Prueba la dependencia de la saliencia respecto de los parámetros aprendidos y las etiquetas de entrenamiento mediante controles de aleatorización.
Límite. Superar los controles no demuestra por sí solo una explicación causal completa.
Localización en la fuente. Pruebas de aleatorización de parámetros del modelo y de datos.
Límites de este análisis
- El argumento de la rotación se aplica a una interfaz lineal compensada y no puede generalizarse a través de capas no lineales arbitrarias.
- El código de tres direcciones utiliza activaciones binarias independientes y omite los sesgos aprendidos, el ruido y las amplitudes continuas.
- La fuente sobre identificabilidad trata del desenmarañamiento no supervisado, una cuestión relacionada con las distintas formas de interpretación mecanicista, pero diferente de ellas.
- No se extrajeron características ni circuitos de modelos grandes; los ejemplos ejecutados son testigos analíticos finitos.
Una revisión analítica focalizada de tres fuentes primarias fundacionales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre acceso y versiones de las fuentes figuran junto a la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué distribuciones de intervención preservan el significado semántico de una característica mientras alteran su contribución causal?
- ¿Cómo pueden las comparaciones entre diccionarios distinguir cambios de base inocuos de divisiones o fusiones sustantivas de conceptos?
- ¿Qué pruebas del comportamiento residual son necesarias antes de que una explicación pueda afirmar su completitud sobre una distribución de entrada declarada?
Referencias
- Nelson Elhage, Tristan Hume, Catherine Olsson et al.. Toy Models of Superposition. Transformer Circuits Thread (2022). Primary source.
- Francesco Locatello, Stefan Bauer, Mario Lucic et al.. Challenging Common Assumptions in the Unsupervised Learning of Disentangled Representations. Proceedings of the 36th International Conference on Machine Learning (2019). Primary source.
- Julius Adebayo, Justin Gilmer, Michael Muelly et al.. Sanity Checks for Saliency Maps. Advances in Neural Information Processing Systems 31 (2018). Primary source.
Acceso a la fuente [1]. Se inspeccionaron el registro primario y secciones seleccionadas accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Nota de versión. Informe de investigación publicado por sus autores, 14 de septiembre de 2022. El HTML principal superó el límite de tamaño del navegador; el PDF de los autores, de 62 páginas, fue accesible.
Acceso a la fuente [2]. Se inspeccionaron el registro primario y secciones seleccionadas accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Acceso a la fuente [3]. Se inspeccionaron el registro primario y secciones seleccionadas accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Las identidades bibliográficas se contrastaron con los registros primarios de editoriales y autores. Las notas siguientes sobre acceso y versiones de las fuentes describen el alcance; no se trata de una auditoría exhaustiva del texto completo.
Autoría y procedencia
Redactado y autorrevisado técnicamente por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, con Python y CSV disponibles. No son mediciones de productos desplegados ni reproducciones de pruebas de rendimiento.
Este borrador local no tiene constancia de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance delimitado comprueban los pequeños modelos descritos; no constituyen una verificación formal de los sistemas citados.