
要旨
解釈可能性研究はニューラルモデルの振る舞いを説明する構造を探究するが、理解しやすい特徴ラベルが支える主張には複数の異なるものがある。本稿は復号可能性、表現、因果的影響、完全性を区別する。線形な隠れインターフェースにおける補償付き回転は、出力を変えずに基底依存性を示す。三つの特徴を二次元に配置した構成は干渉を定量化し、整流器が単独の特徴を復元できても、特徴が共起すると失敗しうることを示す。これらの有限計算を、重ね合わせ、もつれを解いた表現の識別可能性、顕著性手法の健全性確認に関する基礎的研究と結びつける。提案する評価には、介入の対照、ホールドアウトデータでの振る舞い、特徴辞書に関する不確実性の扱いが必要である。大規模モデルの回路発見や安全性認証を主張するものではない。
1. 説明が何を立証することを意図するのかを定義する
特徴は、ある概念と関連したり、プローブによるその概念の復号を可能にしたり、介入を受けたときに出力へ影響したり、ある計算に対する十分な説明の一部を構成したりしうる。これらは段階ごとに異なる主張である。強い活性化を引き起こす例の可視化は関連を裏づけうるが、それだけで必要性、十分性、排他性を立証することはできない。ある話題にちなんで名づけられた特徴が、視覚的パターン、書式上の慣例、あるいはその話題と相関する別の変数によっても活性化する可能性がある。
したがって、解釈可能性に関する結果は、対象とする振る舞いと、提案した特徴をその振る舞いへ結びつける証拠を明示すべきである。これには、表現層、入力分布、介入、出力の測定が含まれる。有用な説明がネットワーク内のすべての計算を明らかにする必要はないが、どの代替説明が依然として可能なのかは述べるべきである。本分析では、解釈可能性を視覚的に魅力的な例の競争としてではなく、識別可能な要素と識別不可能な要素を含む推論問題として扱う。
2. 重ね合わせはより豊かな分析単位を動機づける
Elhageらは、スパースな特徴がより低次元の表現を共有できる玩具モデルを研究している。その研究は、小規模な系における干渉と非線形な復元を理解しやすくするものである。これは、一つのニューロンが一つの概念に対応するという見方を超える動機を与えるが、大規模モデルから抽出されるあらゆる特徴辞書が一意に正しいと証明するものではない。
特徴値に方向ベクトルを掛けて足し合わせた表現を考える。独立な特徴座標の数が表現の次元を上回る場合、任意の特徴ベクトルへ戻す大域的に可逆な線形写像は存在しえない。それでも、制限された集合上ではスパースな入力を復元できる可能性があり、非線形性によって一部の干渉を抑制できる。その際に問うべきなのは、どの組み合わせがどの振幅で現れ、復元をどのように評価するかである。単独の特徴に対する実証は、すべての組み合わせの復元成功を意味しない。以下の構成では、好都合なスパースな場合が密な場合の失敗を覆い隠さないよう、これらの条件を明示する。 [1]
3. 基底の変更は見かけ上の寄与の所在を移しうる
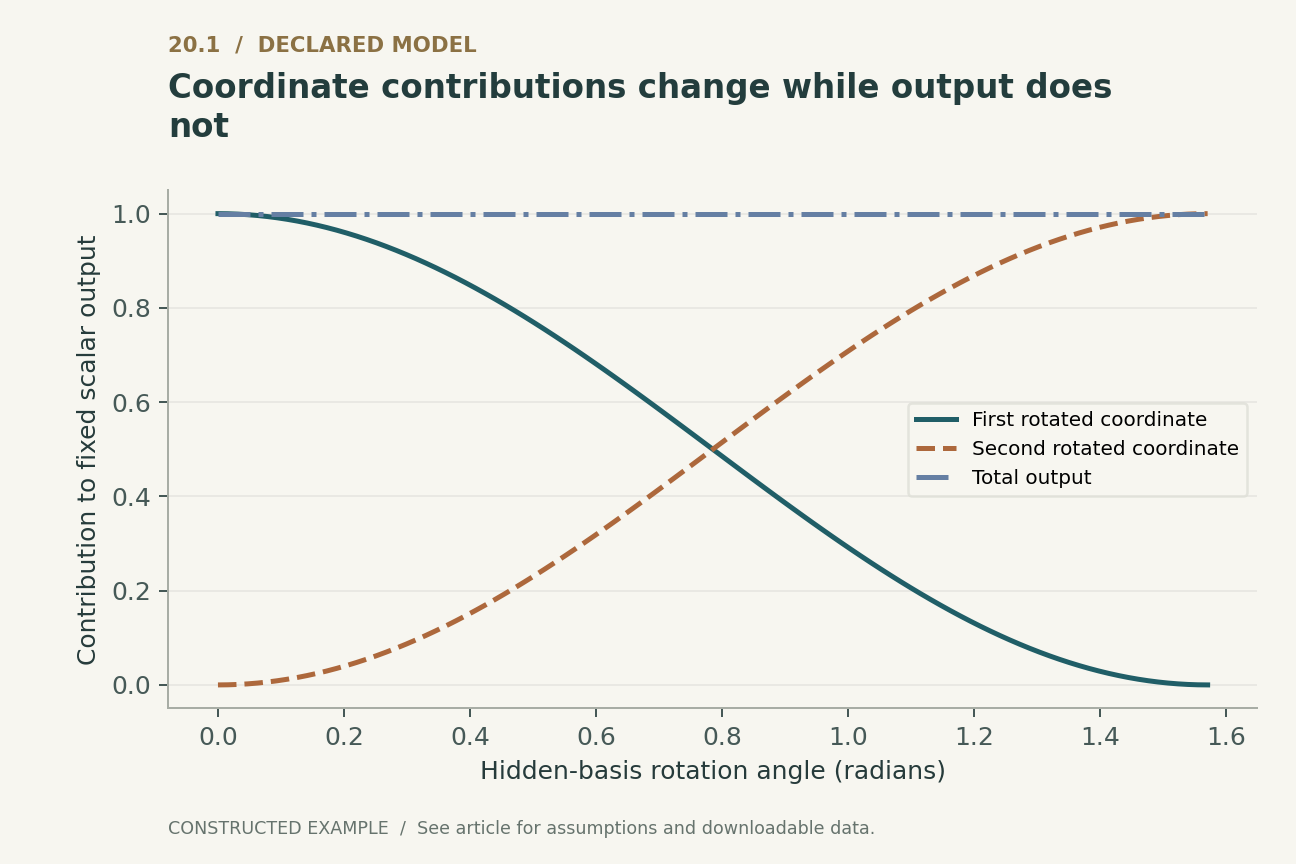
二次元の隠れベクトルの後に線形読み出しが続く場合を考える。隠れベクトルを直交行列で回転させ、読み出し重みも同じ行列で回転させる。両者の内積、したがって出力は厳密に不変である。第一座標の単位ベクトルに等しい特定の隠れ入力について、回転後の第一座標の読み出しへの寄与は回転角の余弦の二乗、第二座標の寄与は正弦の二乗となる。最初の図は、和が一に保たれる一方で、寄与の所在が座標間で移ることを示す。
これは、読み出しに補償変換を伴う線形インターフェースについての主張である。任意の回転が要素ごとの非線形演算と可換であることや、あらゆるアーキテクチャを保存することを主張するものではない。非線形演算は特定の基底を優先させうる。それでも、この例は、アーキテクチャと座標の規約を指定せずに個々のユニットを同定すると、一意性を過大に主張しかねない理由を示す。同等に正確な機能的記述でも、同じ計算を異なる座標へ分配する可能性がある。
4. 識別可能性には再構成を超えた構造が必要である
Locatelloらは、モデルとデータに関する仮定がなければ、教師なしのディスエンタングルメントは一般に識別可能ではないことを示している。この結果は生成的表現に関するものであり、あらゆる機構的解釈可能性に対する包括的な不可能性定理ではない。ここでの意義は、観測への適合だけから一意な意味的因子分解を推論することへの警告にある。
単純な回転付き線形インターフェースでは、再構成と予測は優先される向きを選ばない。スパース性、非負性、既知の変換、介入、ラベル付き因子などの追加制約は、この対称性を破りうる。それぞれが情報または帰納バイアスを導入する。得られた表現は有用かもしれないが、その意味は、仮定を伴わない発見と表現するのではなく、追加した制約に照らして評価すべきである。また、競合する辞書の違いは、無害でありうる置換や尺度変更だけの場合もあれば、解釈に影響する概念の分割や統合の場合もある。訓練の実行間で特徴の一致を数える前に、評価ではこれらを区別しなければならない。 [2]
5. 三つの特徴からなる構成が干渉を明らかにする
平面上で百二十度ずつ離れた三つの単位ベクトルを選ぶ。その和はゼロであり、各組の内積は負の二分の一である。非負の二値特徴値三つを、それらのベクトルの重み付き和によって符号化し、符号化行列の転置で復号し、必要に応じて復号した各座標に整流器を適用する。
一つの特徴だけが活性化している場合、整流はその単位大の自己応答を保ち、二つの負の交差応答を除去するため、入力を厳密に復元する。二つの特徴が活性化すると、復号された二つの所望の座標はそれぞれ二分の一となり、再構成の総二乗誤差は二分の一となる。三つすべてが活性化すると、符号化ベクトルはゼロになるため、どちらの復号器もゼロを返し、総二乗誤差は三となる。全要素がゼロの入力もゼロに符号化される。表現だけからこの二つの入力を区別できる決定論的復号器は存在しない。これは、訓練アルゴリズムが選択した方向を発見できるかどうかとは独立した、情報損失の直接的な例証である。
6. スパース性は曖昧さを除かずに平均誤差を変える
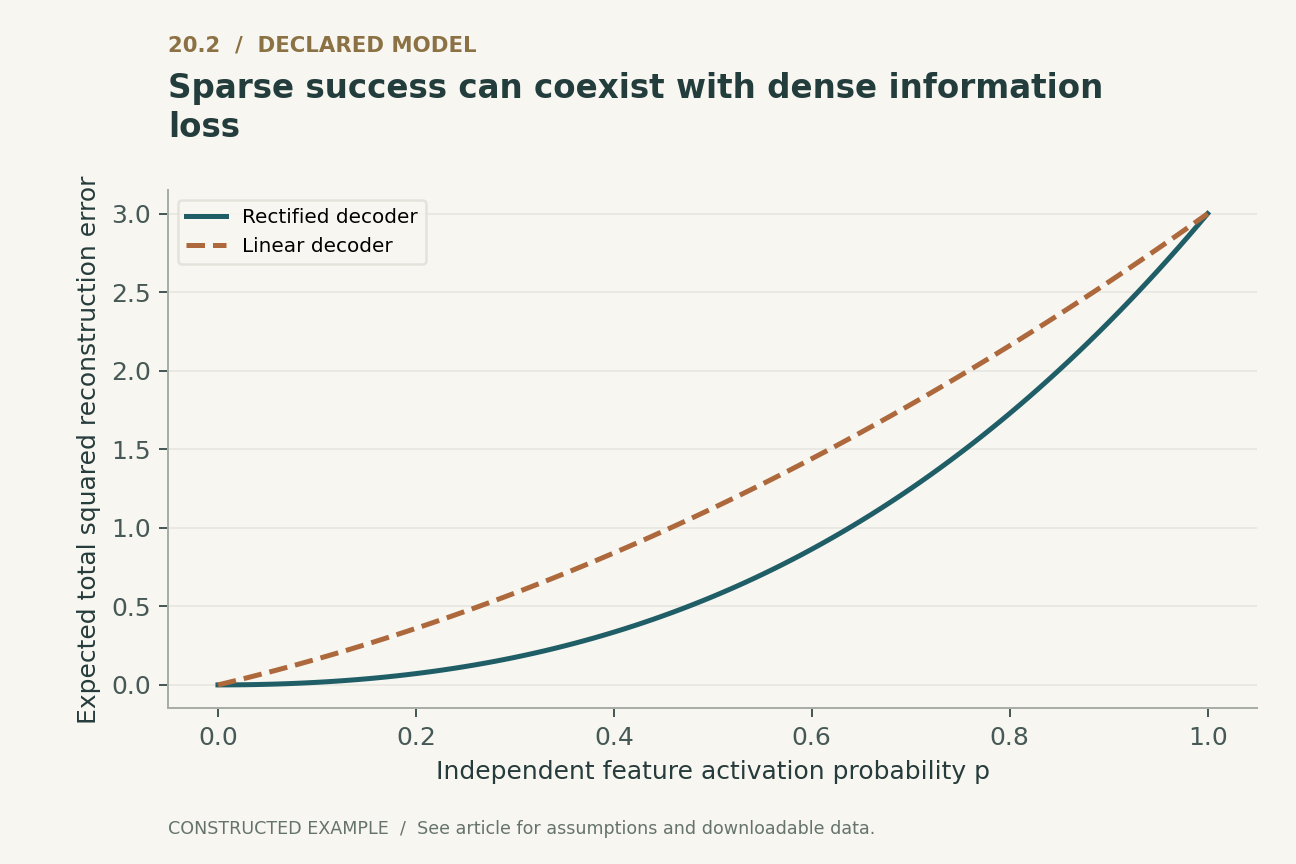
三つの二値特徴がそれぞれ確率pで独立に活性化するとする。八つの構成すべてを列挙すると、整流付き復号器の期待総二乗再構成誤差は、pの二乗の一・五倍とpの三乗の一・五倍の和となる。整流を行わない場合、期待誤差はpの一・五倍とpの二乗の一・五倍の和となる。二番目の図はこれらの厳密な期待値を描いている。
pが小さいときには単独の特徴の場合が支配的となるため、整流によって主要な線形誤差項が除かれる。pが一に等しい場合、どちらの方法も総誤差三で失敗する。したがって、その改善は方向の幾何だけでなく入力分布にも依存する。この計算には独立性の仮定が含まれている。正の相関をもつ共活性化では、周辺活性化率が同じでも、密な場合の失敗がはるかに頻繁になりうる。この例は本稿独自の固定符号の構成であり、重ね合わせの出典にある訓練済み玩具モデルの再現ではない。
7. 復号可能性と因果的利用は乖離しうる
隠れ表現にsとtという二つの座標があり、観測されたデータセット全体でtがsに等しく、出力はsだけを読み出すとする。プローブはどちらの座標からでも対象を完全に復号できる。しかし、sを固定してtを変えても出力には影響しない。sを変えると影響する。したがって、観測に基づく予測だけでは、相関するどちらの座標を読み出しが実際に利用するかを決定できない。
介入にも注意が必要である。隠れ活性化をゼロに置き換えると、モデルが自然には一度も遭遇しない状態を作り出す可能性がある。その結果としての出力変化は、その介入への感度を示すが、特徴の通常の意味的役割を自動的に同定するわけではない。条件を対応させた対照介入、条件付き置換、用量反応の確認は、特異的な効果と一般的な攪乱を区別する助けになりうる。普遍的に正しい介入規約は存在しない。論文では、何を固定したか、置換値をどう選んだか、変化後の状態がその表現モデルの下で依然としてもっともらしかったかを報告すべきである。
8. 視覚的なもっともらしさには陰性対照が必要である
Adebayoらは、モデルのパラメータや訓練ラベルをランダム化したときに顕著性手法が適切に応答するかを調べる健全性確認を提案している。その結果は、視覚的魅力だけでは、学習済みモデルへの依存が不十分な説明が見過ごされうることを示す。このような対照を通過することは、モデルに感応した解釈に必要な種類の証拠であり、因果的忠実性の完全な証明ではない。
同じ設計原則は、推奨される実践として特徴分析にも拡張できる。ある手法がランダムなベースラインでも同程度に説得的な名前付き特徴を見いだすなら、説明では、何がアーキテクチャや入力に由来し、何が学習された計算に由来するのかを明確にすべきである。特徴への介入が出力に及ぼす効果が、条件を対応させたランダム方向への介入より強くないなら、その意味ラベルは特異性を立証しない。対照は大きさ、位置、次元数を対応させ、単に大きな摂動と小さな摂動を比較することにならないようにすべきである。魅力的な例の選択は、ホールドアウト入力による定量評価から分離すべきである。 [3]
9. 実行可能な例証が立証すること
ローカルコードは、有限個の隠れ入力について、複数の補償付き回転の下で出力が保存されることを確認する。既知の角度で座標寄与曲線を検証し、その和を確認する。次いで、三方向の符号について二値特徴パターン八つをすべて列挙し、活性化確率の格子上で、直接計算した再構成誤差と解析的期待値を比較する。
付属資料では相関座標の例も構成し、観測上の完全な復号可能性と、使われていない座標を変えたときの因果効果がゼロであることの対比を確認する。これらの検証は、特定の論理的区別を明瞭に示す例証である。訓練済みスパースオートエンコーダでも、帰属のベンチマークでも、配備済み言語モデルから復元した回路でもない。有限範囲で数式と一致することは例示における実装ミスを検出するが、大規模ネットワークで発見された類似の辞書が同じ意味や因果的役割をもつと立証するものではない。それには、対象とするモデルと分布における新たな証拠が必要である。
10. 有用な特徴から適用範囲を限定した説明へ
強固な解釈可能性報告は、予測的関連、介入の特異性、代替表現との比較、ホールドアウト状況への汎化という相補的な観測を通じて、提案する特徴を定義済みの振る舞いに結びつける。説明が選ばれた例に局所的なものか、ある分布を対象とするのか、完全な計算の特徴づけを目指すのかを述べるべきである。完全性の主張には、成功した介入を示すだけでなく、残余の振る舞いを説明することが必要である。
これらの解析例は、実践上の規律を支える。座標ラベルは基底の選択に依存しうる。スパースな場合の復元と、密な場合の不可避な曖昧さは両立しうる。復号可能な信号が出力に使われていないこともある。魅力的な説明が、学習済みパラメータへの依存を検査する対照に失敗することもある。これらの事実はいずれも解釈を無意味にするものではなく、それぞれが具体的な実験上の問いを示唆する。目的は、代替説明に関する不確実性を保ちながら、もっともらしい機構を絞り込む証拠を蓄積することである。特徴が科学的価値をもつのは、そのラベルが検証可能な主張の代用として提示されるときではなく、そのような主張に結びつけられるときである。
ローカルで実行済み · 限定された範囲
基底不変性、八パターンの重ね合わせ誤差、利用されない復号可能信号
固定された線形インターフェースと割り当てられた二値特徴を使用する。大規模モデルからの特徴抽出、スパースオートエンコーダの訓練、完全性の主張は行わない。
735件のアサーションが通過した。 これらの確認は、提供した例を検証するものであり、引用したシステムを検証するものではない。
記録された例証を確認する
{
  "rotation_angles": 101,
  "hidden_inputs": 4,
  "binary_patterns": 8,
  "rectified_errors_by_active_count": {
    "0": 0.0,
    "1": 0.0,
    "2": 0.5,
    "3": 3.0
  },
  "expected_rectified_error_p_half": 0.5625,
  "dense_and_empty_encode_same": true
}
例の実行プログラム · モデルローダー · 訓練モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全体を読む
明示された解析モデル
四つの方程式と明示的な仮定
(1) 線形な隠れインターフェースにおける厳密な補償付き回転。任意の回転が、途中に要素ごとの非線形演算を含むネットワークを保存するとは限らない。
(2) 120度ずつ離れた平面上の三つの単位方向と、非負の二値特徴ベクトルxを用いる。これは構成した固定符号であり、訓練済みネットワークではない。
(3) 特徴の活性化が独立なBernoulli(p)に従うときの、三特徴の整流付き復号器の厳密な総二乗誤差。期待値は八つの入力すべてを列挙して求める。
(4) 構成した因果的利用の反例。観測上はtがsに等しく完全なプロービングを可能にしても、tだけへの介入ではこの出力は変わらない。
構成例 · 再現可能なデータ
定量的な論拠を確認する
これらの曲線は明示したモデルから計算したものである。引用した研究の観測結果ではない。すべての図に数値データとベクトル版を付属する。


どの証拠がどの問いに答えるのか
| 主張 | 適切な証拠 | 残る代替説明 |
|---|---|---|
| 概念との関連 | ホールドアウトの活性化例と関連の測定 | 相関する攪乱変数 |
| 復号可能性 | 容量とベースラインを統制したプローブの精度 | モデルが復号可能な信号を使っていない可能性 |
| 因果的影響 | 出力の振る舞いに対する特異的かつ統制された介入 | 分布外の攪乱または冗長な経路 |
| 機構的完全性 | 振る舞いと残差の予測的説明 | 研究対象の分布外にある未説明の計算 |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証の項に記録している。
- 対象とする振る舞い、表現層、座標の規約、入力分布を指定する。
- 別のデータで特徴辞書を適合させ、複数のシード、サイズ、条件を対応させた代替案を比較する。
- ホールドアウト入力と容量を統制したベースラインを用いて、関連とプローブ性能を評価する。
- 条件を対応させたランダム方向、大きさの対照、もっともらしい置換値を用いて介入を行う。
- 説明手法と両立する場合には、モデルのランダム化およびラベルのランダム化による対照を検査する。
- 未説明の残余の振る舞い、密な共活性化による失敗、不確実性、完全性に関するあらゆる主張の範囲を報告する。
一次資料が立証すること
Nelson Elhage, Tristan Hume, Catherine Olsson et al. · 2022 [1]
貢献。 小規模なニューラルモデルにおけるスパース特徴の重ね合わせと干渉を研究している。
適用限界。 玩具モデルの結果は、より大きなネットワークについての仮説を動機づけるものであり、その全特徴を同定するものではない。
出典内の該当箇所。 動機、重ね合わせの実証、幾何に関する節。
Francesco Locatello, Stefan Bauer, Mario Lucic et al. · 2019 [2]
貢献。 教師なしディスエンタングルメントの識別に仮定が必要であることを示す。
適用限界。 その定理は、介入や教師ありの機構発見に関する普遍的な不可能性結果ではない。
出典内の該当箇所。 理論解析と識別可能性の議論。
Julius Adebayo, Justin Gilmer, Michael Muelly et al. · 2018 [3]
貢献。 ランダム化対照を用いて、顕著性が学習済みパラメータと訓練ラベルに依存するかを検査する。
適用限界。 対照を通過するだけで完全な因果的説明が証明されるわけではない。
出典内の該当箇所。 モデルパラメータとデータのランダム化検査。
本分析の限界
- 回転の議論は補償付き線形インターフェースに適用されるものであり、任意の非線形層をまたいで一般化することはできない。
- 三方向の符号は独立な二値活性化を用い、学習されたバイアス、ノイズ、連続的な振幅を扱わない。
- 識別可能性の出典は教師なしディスエンタングルメントを扱っており、これは機構的解釈の各形態と関連するものの、同一の問いではない。
- 大規模モデルの特徴や回路は抽出していない。実行した例は有限の解析的例証である。
選定した三つの基礎的一次資料に焦点を絞った解析的レビューであり、独自の計算例を含む。2026年までの文献を網羅的または体系的に調査したものではない。出典へのアクセス状況と版に関する注記は参考文献とともに記録している。
結論を変えうる問い
- 特徴の因果的寄与を変えながら、その意味内容を保つ介入分布はどのようなものか。
- 辞書の比較によって、無害な基底変更と、実質的な概念の分割や統合をどう区別できるか。
- 明示された入力分布にわたる完全性を説明が主張するには、残余の振る舞いに対するどのような検査が必要か。
参考文献
- Nelson Elhage, Tristan Hume, Catherine Olsson et al.. Toy Models of Superposition. Transformer Circuits Thread (2022). Primary source.
- Francesco Locatello, Stefan Bauer, Mario Lucic et al.. Challenging Common Assumptions in the Unsupervised Learning of Disentangled Representations. Proceedings of the 36th International Conference on Machine Learning (2019). Primary source.
- Julius Adebayo, Justin Gilmer, Michael Muelly et al.. Sanity Checks for Saliency Maps. Advances in Neural Information Processing Systems 31 (2018). Primary source.
出典[1]へのアクセス。 一次記録と、アクセス可能な全文の選定部分を確認した。補足資料の網羅的監査は行っていない。
版に関する注記。 著者公開の研究報告、2022年九月14日。主要HTMLはブラウザのサイズ制限を超えていたが、著者による62ページのPDFにはアクセスできた。
出典[2]へのアクセス。 一次記録と、アクセス可能な全文の選定部分を確認した。補足資料の網羅的監査は行っていない。
出典[3]へのアクセス。 一次記録と、アクセス可能な全文の選定部分を確認した。補足資料の網羅的監査は行っていない。
書誌的同一性は出版社と著者の一次記録に照らして確認した。以下の出典へのアクセス状況と版に関する注記が確認範囲を示す。これは全文の網羅的監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示し、解析的構成と提案した評価設計は本稿に帰属する。
表紙はImageGenによる概念的イラストである。技術図は明示したモデルまたは有限の例から計算し、PythonとCSVを提供している。配備済み製品の測定値や、性能ベンチマークの再現ではない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、記述した小規模モデルを確認するものであり、引用したシステムの形式検証ではない。