
摘要
深度分类器可能准确却过度自信,可能经过校准却缺乏信息,也可能在总体上校准良好却误导某个子群。本文通过明确构造的总体阐明这些区别。一个两组伯努利模型将不可约不确定性与可避免的概率误差区分开来,并展示恒定的已校准预测如何丧失决策价值。本文将温度缩放与多类别校准置于这一决策理论分析框架中,同时关注分箱、有限样本不确定性与部署时的分布偏移。对一个小规模总体进行精确枚举,以检验校准、Brier损失和贝叶斯行动成本。所提出的神经模型评估方案与这些已执行的示例有所区别,并不声称提供新的校准基准。
1. 概率是对重复结果的主张
概率预测之所以有用,是因为它支持那些成本随结果而异的决策。因此,对它的解释比对排序分数的解释要求更高。如果被赋予五分之一概率的案例系统性地以五分之二的频率发生该事件,那么即使分类器正确排序了许多案例,基于该预测的下游阈值仍可能是错误的。校准考察的正是预测值与结果条件频率之间的这种对应关系。
可以采用多种条件事件。人们可以考察某一特定类别的概率、所选类别的置信度、完整的预测向量,或上述任一情形中的某个子群。这些评估不能互相替代。我们的构造采用二元事件概率,使每个量都能精确计算。同样的逻辑区别对于深度多类别预测器也很重要,但一条标量曲线无法为其完整概率向量提供保证。在选择指标之前,应明确写出条件信息和决策用途。
2. 标量校正具有特定的表达能力上限
Guo及其同事研究了现代神经网络中的校准,并评估了温度缩放:在应用softmax之前,用一个正参数重新缩放所有logit。他们报告的有效性为采用一种简便的后处理基线提供了依据;这并不是说单一温度能够修复所有网络或分布的定理。
共同的正温度会保持logit的顺序,包括并列关系。因此,它会改变置信度,却不会改变确定性的最高类别选择规则。当排序可信,而置信度的扭曲大致可以用共同尺度描述时,这一点很有价值。但它无法修复系统性的类别互换,无法添加缺失的特征,也无法为logit相同的两个输入赋予不同的校正。如果一个子群需要较大的校正,另一个需要较小的校正,那么拟合单一温度就会在两者之间折中。留出数据上的校准目标可能偏好这种折中,而某个具体的部署决策仍然很差。因此,温度是对误差模式的建模,而不是通用的可靠性开关。 [1]
3. 完美的总体校准可能掩盖有用的结构
构造两个出现频率相同的组。在A组中,事件概率为十分之一;在B组中,事件概率为十分之九。始终报告二分之一的预测器在合并总体上完全校准:在所有获得二分之一预测的案例中,半数发生该事件。然而,它忽略了组别信息。报告两个真实条件概率的预测器同样经过校准,并且在错误成本相等时支持好得多的分类。
恒定预测说明了为什么仅有校准不会奖励分辨力。它也说明了为什么即使总体层面的陈述精确成立,某个子群仍可能校准不良。在A组内,二分之一的概率预测高估了十分之四;在B组内,它低估了同样的幅度。误差只有在汇总之后才相互抵消。这一构造刻意保持清晰透明:它并不是说现实中的人口统计群体具有这些事件率,也不是说使用任何特定的受保护属性都自动是恰当的。
4. 适当评分将信息与校准口号区分开来
对于真实条件概率为q的伯努利结果,在预测值p处的期望概率平方损失等于q乘以一减q,再加上p与q之差的平方。展开平方即可直接得到这一恒等式。第一项是不可约的条件结果变异;第二项是不准确概率所带来的可避免成本。这个局部恒等式不需要对神经网络架构作任何假设。
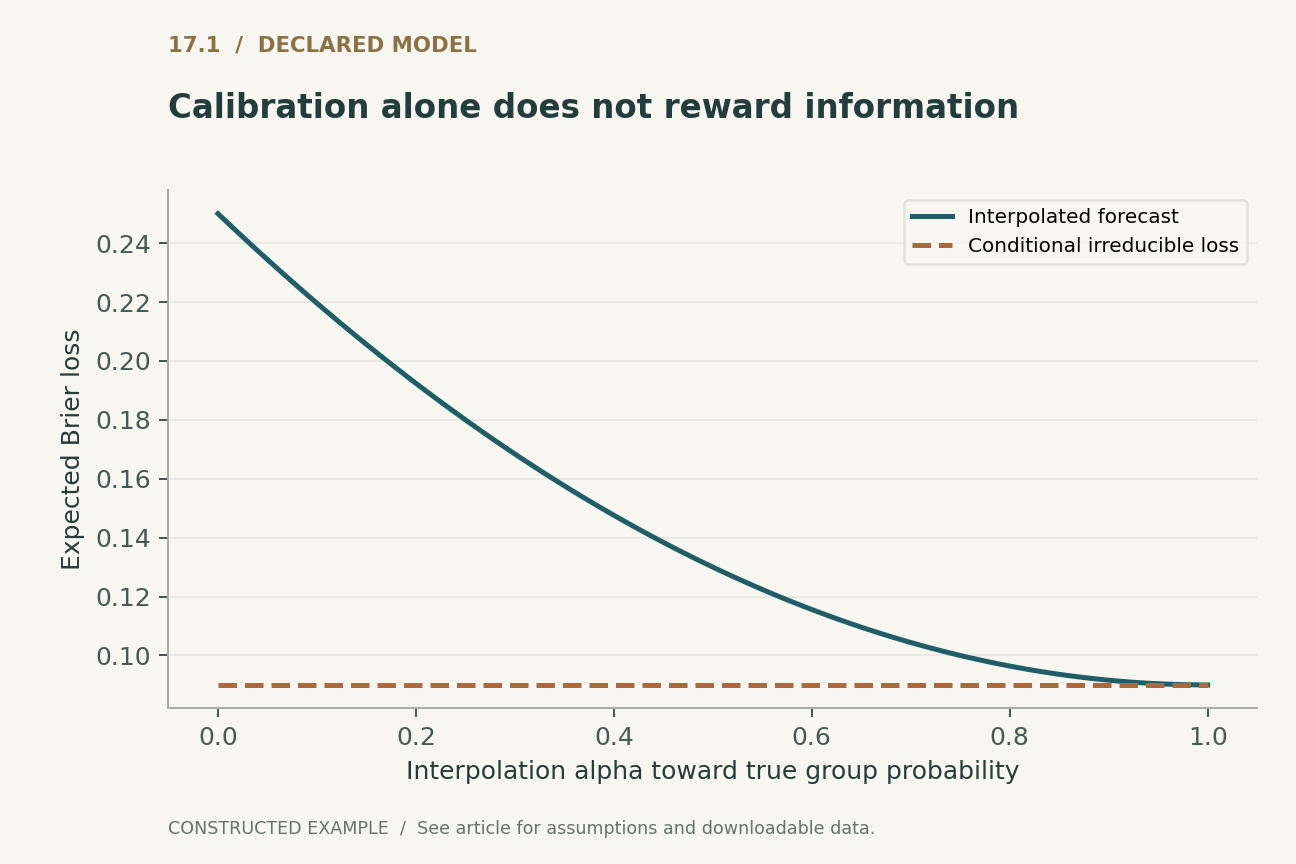
在我们的两组示例中,两组的不可约项均为百分之九。恒定的二分之一预测额外增加百分之十六,使Brier损失达到四分之一。富含信息的真实概率预测则达到百分之九。在这两种预测之间进行插值得到第一幅图。尽管恒定预测端点已经在总体上经过校准,曲线仍平滑下降。因此,报告可以同时包含校准与适当评分,而不必将其中任何一项视为冗余。对数评分会对靠近自信但错误的端点的预测施加更强惩罚,不过需要谨慎处理精确为零的值。
5. 分箱可能抹去正在测量的误差
Vaicenavicius及其同事建立了校准评估的概率框架,并区分了标量汇总可能混淆的不同条件化概念。他们的分析支持将评估统计量视为具有特定目标的测量程序。
我们自己的示例使这一问题具体化。为一半总体赋予四分之一的预测事件概率和二分之一的结果频率;为另一半赋予四分之三的概率,以及相同的二分之一结果频率。分开的预测箱揭示出每组四分之一的绝对概率误差。将它们合并为一个箱后,平均预测为二分之一,平均结果也为二分之一,从而完全掩盖了差异。这是一个概率校准示例;常规的最高置信度ECE适用于另一个变量。有限样本又增加了一层复杂性:即使真实校准成立,观测到的分箱误差仍会波动。更多的箱可以提高分辨力,却使每个箱中的观测数减少。在未说明分箱方式和样本量的情况下,单个较低的ECE无法确立总体性质。 [2]
6. 决策阈值源于成本
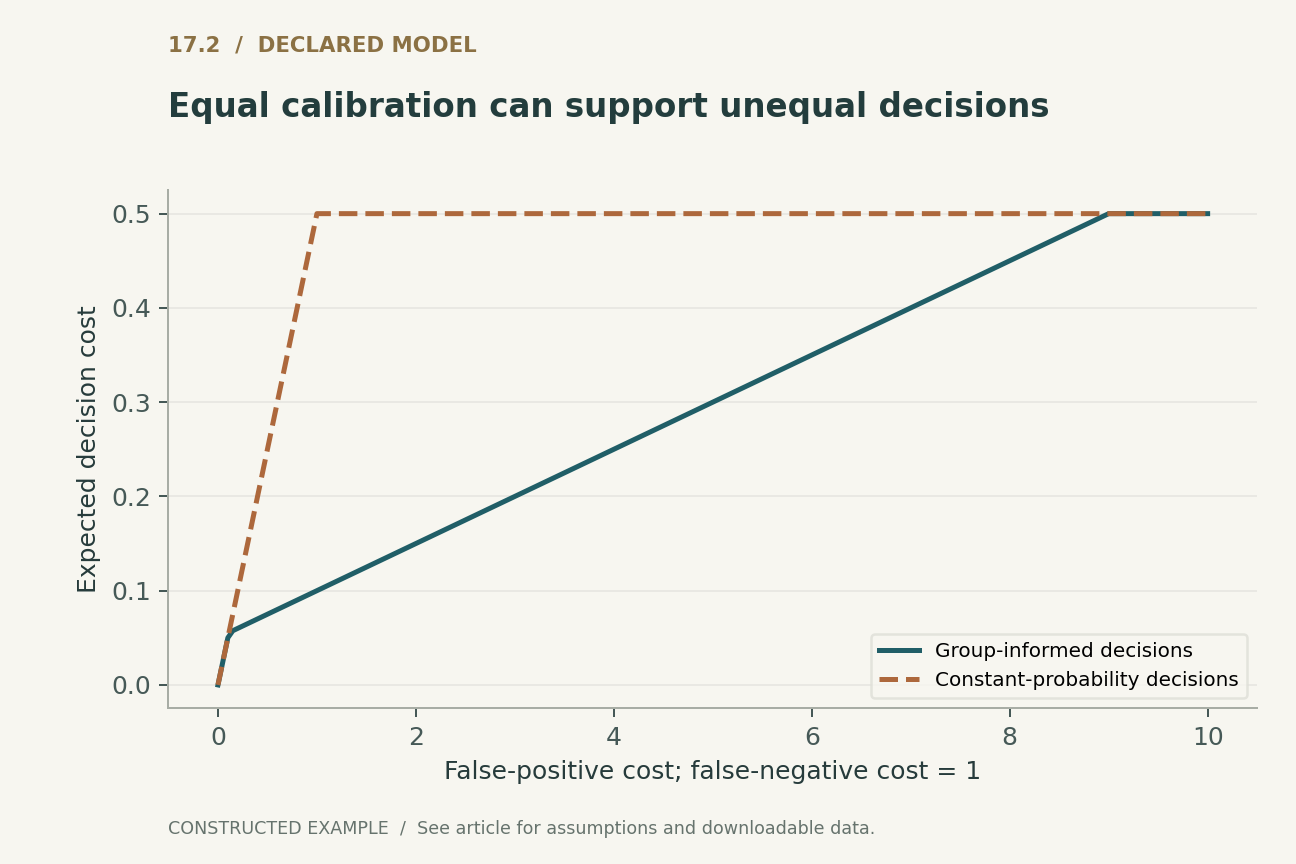
假设行动一在事件未发生时产生成本C_FP,而行动零在事件发生时产生成本C_FN。如果p是以所用信息为条件的真实事件概率,则期望成本分别为C_FP乘以一减p,以及C_FN乘以p。当p超过C_FP除以两种成本之和时,选择行动一;相等时可以选择任一行动,而不改变期望成本。
当成本相等时,恒定预测无法区分我们的两个组,因而错误率为二分之一。使用它们的条件概率则得到十分之一的错误率。第二幅图将假阴性成本固定为一,同时改变假阳性成本。它比较基于恒定信息集的决策与基于组别信息的决策。两种预测相对于各自揭示的信息都经过校准,但可达到的成本不同。这是信息的比较,而不是某种特定神经校准器能够取得这种收益的证据。
7. 多类别灵活性必须承担其估计成本
Kull及其同事提出了Dirichlet校准,通过学习得到的线性映射和softmax变换对数概率。与单一温度相比,这允许按类别进行校正,以及在概率坐标之间引入交互。他们的工作是一种多类别校准方法,并不保证增加灵活性总能提高留出数据上的可靠性。
额外参数带来了常规的估计问题。小规模校准集可能不足以识别对稀有类别有用的校正,而不受约束的灵活性可能拟合抽样噪声。因此,正则化、各类别的样本支持量以及独立的评估数据都应纳入方法说明。改变概率最高的类别可能改善分类,也可能使之恶化;与共同的正温度不同,一般映射不一定保持排序。任何假定决策不变的下游工作流程都必须重新测试。校准训练还应与反复使用测试集调参相隔离,因为使用绘制最终可靠性图的同一批案例来选择映射,会使表面结果产生偏差。 [3]
8. 选择与分布偏移会改变相关总体
概率陈述是针对特定总体而言的。如果某项服务将低置信度案例转交人工处理,留下的案例分布就不同于原始测试集。仅以所报告分数为条件的校准,在完全由该分数决定的选择下仍然成立,前提是选择机制不引入关于结果的额外信息。如果选择还利用未建模的子群、采集渠道或隐藏的难度信号,则校准未必继续成立。明确说明选择规则,就能检验这种区别。
类别流行率的变化也可能改变固定分数的解释。每次检测到输入偏移后重新校准,并非自动合理:输入变化未必改变结果的条件机制,而输入没有变化也不能排除标签变化。部署记录应区分对分布差异的警报与概率误差的证据。延迟标签、结果缺失和选择性反馈会使这类证据变得复杂,应在可靠性仪表板中持续呈现。
9. 已执行的有限示例检验确立了什么
配套代码表示二十个权重相同的案例:每个构造组各有十例,阳性结果分别为一例和九例。它验证了恒定预测的总体校准、子群差异,以及恒定预测与信息性预测的精确Brier损失。另一个独立的分箱合并示例验证了更粗的分组可能压低误差统计量。所有频率均为有意设定,并非来自外部数据集的估计。
在成本扫描中,精确的条件期望会在每个信息组内独立选择成本较低的行动。这些检验在选定成本下,将上述决策与对有限结果的直接枚举进行比较。温度检验确认,对于具有代表性的无并列logit和正温度,顺序得以保持。这些测试能够发现代数、实现和图表之间的不一致。但它们无法验证真实用户上的校准,也不能证明后处理方法能够从有限验证集泛化。后一主张需要通过所提出的留出研究加以检验。
10. 围绕决策与不确定性构建评估
实用的校准报告应首先说明所解释的输出概率及其将为之提供依据的决策。随后应给出适当评分规则、明确的可靠性条件、不确定性区间,以及决策成本或有依据的成本范围。弃权后的覆盖率和各类别的样本支持量应与主要指标一同呈现。如果比较展示的是同一留出总体在应用校准映射前后的情况,并包括性能恶化的案例,那么比较就更有说服力。
由此得到的标准要求严格,但具体明确。总体校准是一项有用的约束,而非完整目标。灵活校正可以改善设定错误的概率映射,但必须将其估计与评估分开。即使两种相互竞争的预测都满足某项校准陈述,更好的概率信息仍可降低决策成本。这些是由所披露构造支持的分析结论。本文提出了跨采集域、类别流行率和操作阈值的神经校准试验,但尚未执行。
本地执行 · 范围有限
经过校准却缺乏信息的总体、分箱合并与成本最优行动
设定的有限结果与总体期望;采用二元事件概率分箱,而非多类别置信度ECE。没有验证集拟合,也没有真实用户结果。
516项断言通过。 这些检验验证的是所提供的示例,而非所引用的系统。
检查记录的验证见证
{
  "cases": 20,
  "group_positive_counts": [
    1,
    9
  ],
  "constant_Brier": 0.25,
  "informed_Brier": 0.09,
  "coarse_probability_ECE": 0.0,
  "fine_probability_ECE": 0.25,
  "cost_at_equal_error_costs": {
    "pooled": 0.5,
    "informed": 0.1
  }
}明确声明的分析模型
四个方程,明确的假设
(1) 正温度缩放保持logit顺序;温度在独立的校准数据上拟合,并在未经使用的案例上评估。
(2) 针对二元Y的总体分箱事件概率校准误差。它并不自动等同于常规的所选类别置信度ECE;分箱是定义的一部分。
(3) 对于固定的p和概率为q的伯努利变量Y。在构造的组中,q为0.1或0.9;在所述插值下,Brier损失为0.09+0.16(1-alpha)^2。
(4) 二元行动,错误成本非负且其和为正;p必须表示以决策可用信息为条件的事件概率。
构造示例 · 可复现数据
检查定量论证
这些曲线由所声明的模型计算得到,并非所引用研究的观测结果。每幅图均附有数值数据和矢量版本。


哪种证据回答哪种问题?
| 评估 | 有用的问题 | 盲点 |
|---|---|---|
| 最高类别置信度 | 在这一置信度下,所选类别有多大比例是正确的? | 概率向量的其他坐标 |
| 逐类别可靠性 | 每个类别的概率是否匹配其事件频率? | 所有可能的联合条件或子群条件 |
| Brier评分或对数评分 | 信息丰富且准确的概率是否得到奖励? | 哪个子群造成了总体误差 |
| 期望行动成本 | 该概率是否支持这一决策? | 具有不同成本的其他决策 |
拟议的验证方案
这是一项拟议的评估设计。未进行生产系统或硬件基准测试。另行执行的有限模型记录在可执行检验中。
- 固定概率目标、行动空间、成本范围和部署总体。
- 将模型训练、校准拟合、方法选择和最终评估所用的案例分开。
- 比较未经校准的预测、正温度基线和经过正则化的灵活映射。
- 报告适当评分和可靠性曲线,同时明确分箱规则、样本支持数和不确定性。
- 评估子群与经选择总体的可靠性,不掩盖弃权案例或稀有类别。
- 在预先指定的阈值下测量成本与覆盖率,然后在真正留出的分布偏移上重复评估。
一手来源确立了什么
Chuan Guo, Geoff Pleiss, Yu Sun et al. · 2017 [1]
贡献。 研究神经网络的校准不良,以及作为后处理方法的温度缩放。
边界。 经验有效性取决于数据集;温度保持类别顺序。
来源定位。 第2节和第4节,温度缩放。
Juozas Vaicenavicius, David Widmann, Carl Andersson et al. · 2019 [2]
贡献。 形式化了不同的概率校准概念及其评估。
边界。 标量汇总并不能刻画每一种条件事件。
来源定位。 关于校准定义与评估的章节。
Meelis Kull, Miquel Perello-Nieto, Markus Kängsepp et al. · 2019 [3]
贡献。 提出了一种基于对数概率以及线性变换和softmax的多类别校准映射。
边界。 额外的表达能力需要充分拟合与独立评估。
来源定位。 Dirichlet校准的定义与参数化。
本分析的局限
- 二十个案例组成的总体是人为构造的,不构成关于任何真实子群的证据。
- 精确的总体计算避开了真实校准研究必须量化的抽样噪声。
- 三项奠基性来源并不构成对现代校准方法的穷尽比较。
- 成本模型假定行动为二元且成本已知;复杂决策需要自己的效用模型。
这是一篇聚焦于三项选定的奠基性一手来源的分析综述,并包含原创演算示例。它并非截至2026年的穷尽性或系统性文献调查。来源访问情况与版本说明随参考文献记录。
可能改变结论的问题
- 对于某个具体的下游决策,哪些校准条件事件是必要的?
- 如何在不掩盖统计不确定性的情况下估计稀有群体的可靠性?
- 灵活的多类别映射何时能够比拟合良好的标量温度进一步降低期望决策成本?
参考文献
- Chuan Guo, Geoff Pleiss, Yu Sun et al.. On Calibration of Modern Neural Networks. Proceedings of the 34th International Conference on Machine Learning (2017). Primary source.
- Juozas Vaicenavicius, David Widmann, Carl Andersson et al.. Evaluating model calibration in classification. Proceedings of the Twenty-Second International Conference on Artificial Intelligence and Statistics (2019). Primary source.
- Meelis Kull, Miquel Perello-Nieto, Markus Kängsepp et al.. Beyond temperature scaling: Obtaining well-calibrated multiclass probabilities with Dirichlet calibration. Advances in Neural Information Processing Systems 32 (2019). Primary source.
来源[1]访问情况。 已检查一手记录及部分可访问的全文章节;未对补充材料进行穷尽审查。
来源[2]访问情况。 已检查一手记录及部分可访问的全文章节;未对补充材料进行穷尽审查。
来源[3]访问情况。 已检查一手记录及部分可访问的全文章节;未对补充材料进行穷尽审查。
书目身份已对照出版方与作者的一手记录核实。下方的来源访问与版本说明描述了核查范围;这并非穷尽性的全文审查。
作者身份与来源
由Codex(AI)撰写并进行技术自审。参考文献标明原始研究者;分析构造与拟议评估设计归属于本文。
封面是ImageGen概念插图。技术图表由所声明的模型或有限示例计算得到,并提供Python与CSV。它们不是对已部署产品的测量,也不是复现的性能基准。
这份本地草稿没有独立同行评审或期刊录用记录。范围有限的可执行示例检验了所述小规模模型;它们不是对所引用系统的形式化验证。