
Resumen: el genoma no es un libro de historia generado automáticamente
El ADN antiguo permite someter directamente a contrastes cuantitativos las relaciones genéticas entre poblaciones del pasado, pero inferir cambios demográficos a gran escala a partir de unos pocos individuos bien conservados exige precisar cómo se incorporaron las muestras al estudio. Este artículo conecta los fundamentos metodológicos de los estadísticos f con investigaciones de alta resolución sobre la Europa altomedieval y analiza las relaciones entre ascendencia, geografía, cronología y clasificación arqueológica. El objetivo no es asignar una única etiqueta a una historia compleja, sino identificar qué proposiciones sobre migración están restringidas por los datos y cuáles siguen dependiendo de modelos de referencia y procesos de selección.[1] Ancient Admixture in Human History[2] High-resolution genomic history of early medieval Europ
Traducción del resumen original en inglés
Los genomas antiguos restringen los modelos demográficos, pero no identifican por sí solos la cultura o la identidad. Examinamos los estadísticos f, la dependencia de las referencias, la contaminación y el muestreo de cementerios, y derivamos cómo las probabilidades desiguales de muestreo distorsionan las proporciones de ascendencia inferidas. Un contraejemplo transparente separa la composición observada de la muestra de la composición de la población histórica.
Qué contrastan realmente los métodos estadísticos
Los métodos de análisis de la historia de mezcla desarrollados y sistematizados por Patterson y sus colaboradores utilizan las relaciones entre frecuencias alélicas de distintas poblaciones para contrastar modelos de árbol simples o de mezcla. Rechazar un modelo indica que un conjunto de relaciones es incompatible con sus supuestos; no revela automáticamente una única historia verdadera. El signo de un estadístico, su significación y las proporciones estimadas tienen significados distintos. En particular, que un modelo pueda ajustarse no implica que se hayan descartado todos los modelos alternativos; las propias poblaciones de referencia candidatas son solo sustitutos representativos de las fuentes históricas.[1] Ancient Admixture in Human History
Qué aportan los estudios de casos de alta resolución
Las investigaciones sobre la Europa altomedieval mejoran la capacidad de distinguir ascendencias próximas mediante referencias detalladas y distribuciones temporales, y muestran que disponer de más muestras y de referencias cronológicamente más cercanas puede modificar la interpretación de la historia poblacional. Este artículo utiliza sus evidencias sobre la resolución de los modelos y las conexiones espaciotemporales; no extrapola los resultados de cementerios particulares a toda Europa ni presenta una relación estadística de «semejanza con muestras antiguas de un lugar» como prueba genética de nacionalidad moderna, lengua o identidad étnica.[2] High-resolution genomic history of early medieval Europ
Por qué las muestras antiguas no constituyen un muestreo aleatorio
Las condiciones de conservación, las prácticas funerarias, los lugares de excavación y los permisos de investigación determinan conjuntamente qué individuos pueden secuenciarse. La cremación y las condiciones del suelo pueden provocar la ausencia sistemática de ciertos grupos, y los cementerios también pueden sobrerrepresentar determinadas redes sociales. Ni siquiera un tamaño muestral grande elimina automáticamente esta selección. Los estudios deben presentar las distribuciones espaciales, cronológicas y de contextos funerarios, y discutir los mecanismos de ausencia de datos; las proporciones de individuos secuenciados con éxito no pueden equipararse directamente a las de la población histórica total.作者分析与复核建议 / Author analysis
Un contraejemplo de selección cuyo cálculo puede reproducirse
Supongamos que la proporción de individuos de origen A en la población histórica es 30%, pero que su probabilidad de incorporarse a la muestra triplica la de los demás individuos. La proporción observada de A en la muestra será entonces aproximadamente 56.25%, y no 30%. Esto se obtiene directamente de la probabilidad condicional y no corresponde a ningún cementerio real. Demuestra que un cambio notable en la composición muestral no basta para probar un cambio de igual magnitud en la población; si se desconoce la razón entre probabilidades de muestreo, solo cabe realizar análisis de sensibilidad para un conjunto de razones posibles, no calcular una única historia corregida.作者分析与复核建议 / Author analysis
Las proporciones de ascendencia dependen de las coordenadas del modelo
Las llamadas proporciones de ascendencia son coeficientes que explican las relaciones observadas bajo las poblaciones sustitutas seleccionadas y las restricciones del modelo. Cambiar los sustitutos puede modificar los coeficientes aunque la señal genética explicada sea la misma. Este artículo recomienda informar conjuntamente del ajuste del modelo, del conjunto de fuentes distinguibles y de los resultados con sustitutos alternativos. Si varias fuentes son casi colineales en los marcadores disponibles, la incertidumbre de las proporciones aumenta considerablemente; la existencia de una solución numérica no implica que la interpretación histórica tenga la misma precisión.作者分析与复核建议 / Author analysis
No debe confundirse el momento de la mezcla con el del muestreo
La aparición, en una fecha determinada, de un individuo con ciertas relaciones genéticas solo permite restringir la presencia de esas relaciones en ese lugar. Las relaciones de origen pueden haberse formado previamente en otro lugar o proceder de migraciones en varias etapas. Usar la fecha de enterramiento como fecha del episodio de mezcla ignora las rutas migratorias de los antepasados. Además, las fechas tienen errores e intervalos de calibración, por lo que los modelos temporales deben propagar la incertidumbre de datación, en vez de reducir a cada individuo a un punto temporal exacto.作者分析与复核建议 / Author analysis
Cómo afecta la contaminación a las relaciones entre frecuencias
Expresar la señal de una muestra antigua y la contaminación moderna como una distribución de mezcla permite ver que la contaminación desplaza las frecuencias alélicas hacia la fuente contaminante. La contaminación no reduce siempre todos los estadísticos por igual; la dirección depende de la relación entre el contaminante y las poblaciones comparadas. Es necesario evaluar los datos utilizables mediante el daño y la longitud de los fragmentos, junto con otros indicadores de autenticación, y después comparar las conclusiones antes y después del filtrado. La figura de mezcla lineal de este artículo es únicamente un ejemplo de propagación del error, no una estimación de contaminación de ninguna muestra antigua.作者分析与复核建议 / Author analysis
Baja cobertura y precisión espuria
Los datos de baja cobertura pueden aportar evidencia sobre relaciones poblacionales mediante métodos estadísticos adecuados, pero no se les pueden aplicar indiscriminadamente los supuestos de error de los genotipos de alta cobertura. La imputación y la dependencia de las referencias pueden introducir estructura adicional, especialmente en variantes raras o ascendencias insuficientemente representadas. Los informes deben distinguir la cobertura original, el procedimiento de determinación de genotipos y la información posterior a la imputación. Producir técnicamente una matriz genotípica completa no equivale a haber medido directamente cada sitio en el mismo grado.作者分析与复核建议 / Author analysis
Redundancia por parentesco y evidencia efectiva
Varios parientes cercanos de un cementerio pueden aportar información abundante sobre la estructura social, pero no pueden contarse sin más como el mismo número de muestras poblacionales independientes. Si el muestreo se concentra en un linaje, las medias poblacionales se sesgarán hacia sus antepasados comunes. Los estudios pueden analizar por separado los resultados conservando toda la estructura de parentesco y excluyendo a los parientes cercanos, y precisar el estimando principal. La investigación genealógica y la historia poblacional regional requieren estrategias de muestreo distintas; un mismo «número total de muestras» no puede sustituir todas las indicaciones de precisión.作者分析与复核建议 / Author analysis
Continuidad geográfica y migración como explicaciones alternativas
Los cambios en la composición genética pueden deberse a inmigración, flujo génico continuo, cambios en el tamaño de la población local o supervivencia diferencial entre grupos. Una diferencia entre un momento anterior y otro posterior no identifica de manera única estos mecanismos. Un diseño más informativo combina cortes temporales sucesivos, referencias de regiones circundantes y registros arqueológicos para restringir conjuntamente las explicaciones. La interpretación histórica debe indicar qué mecanismos alternativos aún pueden ajustarse a los datos, en lugar de condensar todos los cambios en un único episodio de reemplazo bien delimitado.作者分析与复核建议 / Author analysis
Las etiquetas culturales requieren fundamentos independientes
Los estilos funerarios, el uso de lenguas, la afiliación política y las relaciones genéticas pueden estar asociados o difundirse por vías diferentes. Incluso cuando se observan individuos inmigrantes, sus proporciones genéticas no bastan para determinar cómo se identificaban. Este artículo recomienda conservar en campos separados las entidades estudiadas genéticamente, las clasificaciones arqueológicas y las denominaciones históricas, y vincularlas mediante hipótesis explícitas. Así se evita el uso indebido de los resultados de los modelos y se permite que hallazgos posteriores revisen las interpretaciones culturales sin borrar los resultados genómicos.作者分析与复核建议 / Author analysis
Significación y tamaño del efecto
Un número suficiente de marcadores puede hacer que desviaciones muy pequeñas alcancen significación estadística, pero su significado histórico también requiere considerar el tamaño del efecto, el alcance del muestreo y el error del modelo. El ligamiento hace que los marcadores no sean independientes, por lo que la estimación del error debe utilizar bloques adecuados. Si un estudio selecciona el resultado más significativo entre muchas combinaciones de sustitutos, también debe revelar el proceso de búsqueda y efectuar una verificación independiente. La significación no sustituye la discusión sobre la selección de muestras y la especificación del modelo.作者分析与复核建议 / Author analysis
La identificabilidad debe evaluarse mediante historias alternativas
Este artículo propone variar sistemáticamente la ausencia de sustitutos, la migración continua y la estructura de parentesco cercano en historias poblacionales sintéticas para comprobar si un mismo estadístico produce resultados similares. Si varias historias son indistinguibles con las observaciones disponibles, debe publicarse ese conjunto de equivalencia, en lugar de forzar la elección del relato más vívido. Construir contraejemplos sirve para localizar lagunas de evidencia; no demuestra que la historia real deba corresponder a alguno de los escenarios simulados.作者分析与复核建议 / Author analysis
Contexto arqueológico y ética de la investigación
La obtención y el uso de materiales humanos antiguos implican la protección de los yacimientos, la participación de comunidades descendientes o vinculadas y el alcance de los permisos. Poder extraer ADN técnicamente no significa que las relaciones de investigación se hayan establecido adecuadamente. Al compartir datos e información sobre muestras deben respetarse las restricciones legales, sin convertir estadísticas poblacionales en juicios sobre el valor individual o la jerarquía social. Estos límites afectan directamente a la posibilidad de interpretar la investigación de manera responsable y no son un mero añadido al final de un artículo.作者分析与复核建议 / Author analysis
Qué verificaciones deben permitir los materiales públicos
Un paquete de investigación intercambiable debe incluir, como mínimo, las partes de los metadatos muestrales que puedan publicarse legalmente, los intervalos de datación, las reglas de control de calidad, la selección de sustitutos, las definiciones de los estadísticos y la lista de modelos candidatos. Compartir únicamente las barras finales de colores de ascendencia no permite recalcular modelos ni detectar redundancia por parentesco. La verificación también debe permitir recuperar las muestras excluidas y sus motivos de exclusión para determinar si las conclusiones principales dependen de un cementerio, período o umbral de calidad concreto.作者分析与复核建议 / Author analysis
Proposiciones posteriores falsables
Una proposición clara sobre migración debe predecir también relaciones genéticas en nuevas regiones, momentos anteriores o contextos funerarios distintos. Si las nuevas muestras representativas no presentan los cambios previstos, la interpretación debe actualizarse. Este artículo recomienda registrar de antemano estas condiciones de refutación y comparar modelos alternativos de muestreo. Así, la narrativa histórica puede convertirse en un proceso de investigación continuamente restringido por nuevos materiales, en lugar de seleccionar solo los hallazgos que encajan en el relato.作者分析与复核建议 / Author analysis
Conclusión: la resolución histórica surge de la intersección de distintas evidencias
El ADN antiguo refuerza notablemente el estudio de la historia poblacional, pero su potencia proviene de trabajar conjuntamente con la arqueología, la cronología y los modelos estadísticos. Las conclusiones más fiables deben señalar las relaciones entre individuos observadas directamente, los cambios poblacionales respaldados por modelos y las interpretaciones culturales que siguen siendo inciertas. Mostrar con transparencia el sesgo de selección y las historias alternativas no debilita los hallazgos; facilita su contrastación con muestras adicionales y reduce el riesgo de confundir la ascendencia estadística con una identidad fija.作者分析与复核建议 / Author analysis
Ecuaciones fundamentales y derivaciones
(1) Estadístico de covarianza de frecuencias; los marcadores ligados requieren estimaciones del error por bloques.
LaTeX
\widehat f_4(A,B;C,D)=L^{-1}\sum_{\ell=1}^{L}(p_{A\ell}-p_{B\ell})(p_{C\ell}-p_{D\ell})(2) Modelo de selección cuando la probabilidad de muestreo de A es r veces la de los demás grupos.
LaTeX
\pi_{\rm observed}=r\pi/[r\pi+(1-\pi)](3) Mezcla simplificada de contaminación; no incluye todos los errores por daño y determinación de genotipos.
LaTeX
p_{\rm measured}=(1-c)p_{\rm ancient}+c p_{\rm contaminant}(4) Solo puede invertirse si se conoce la razón entre probabilidades de muestreo; una r desconocida exige intervalos de sensibilidad.
LaTeX
\pi=\pi_{\rm observed}/[r-(r-1)\pi_{\rm observed}]Flujo metodológico y de evidencias
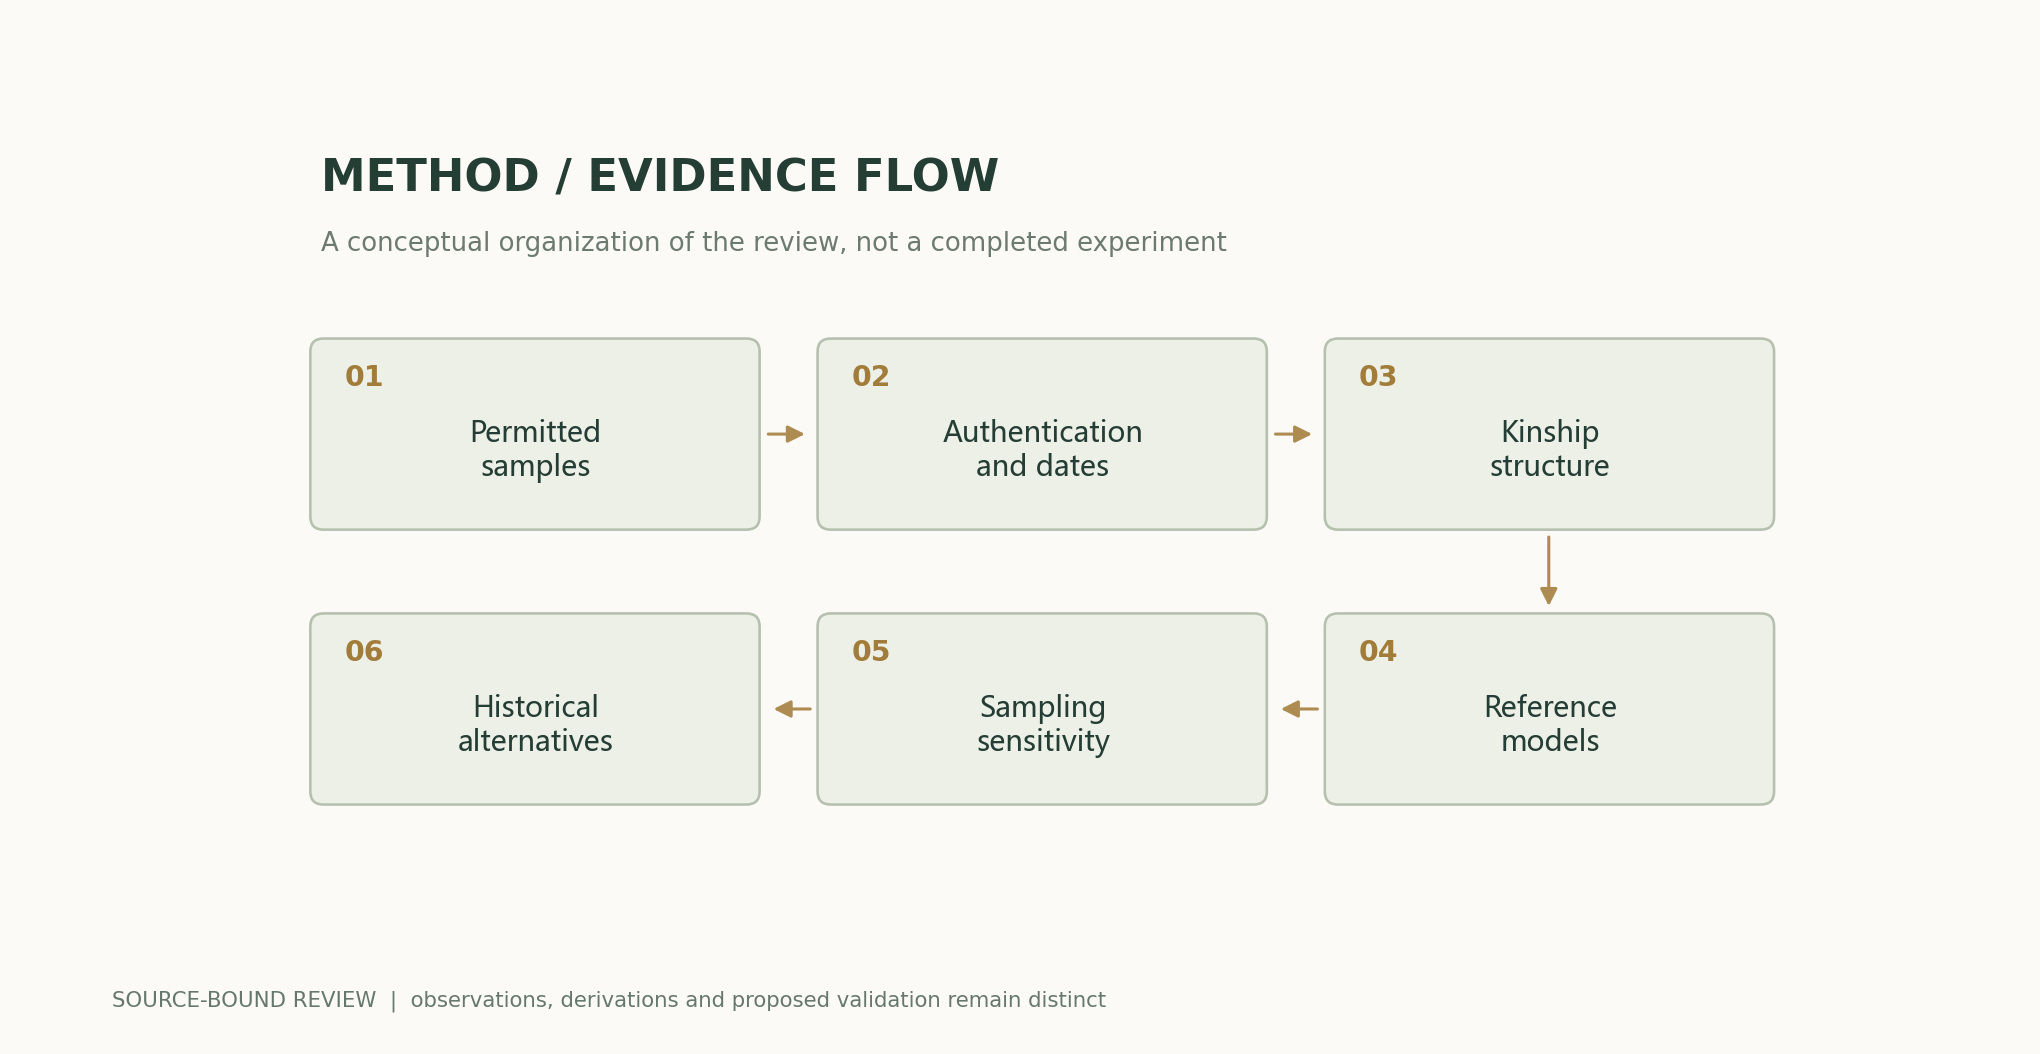
Figuras analíticas y ejemplos numéricos
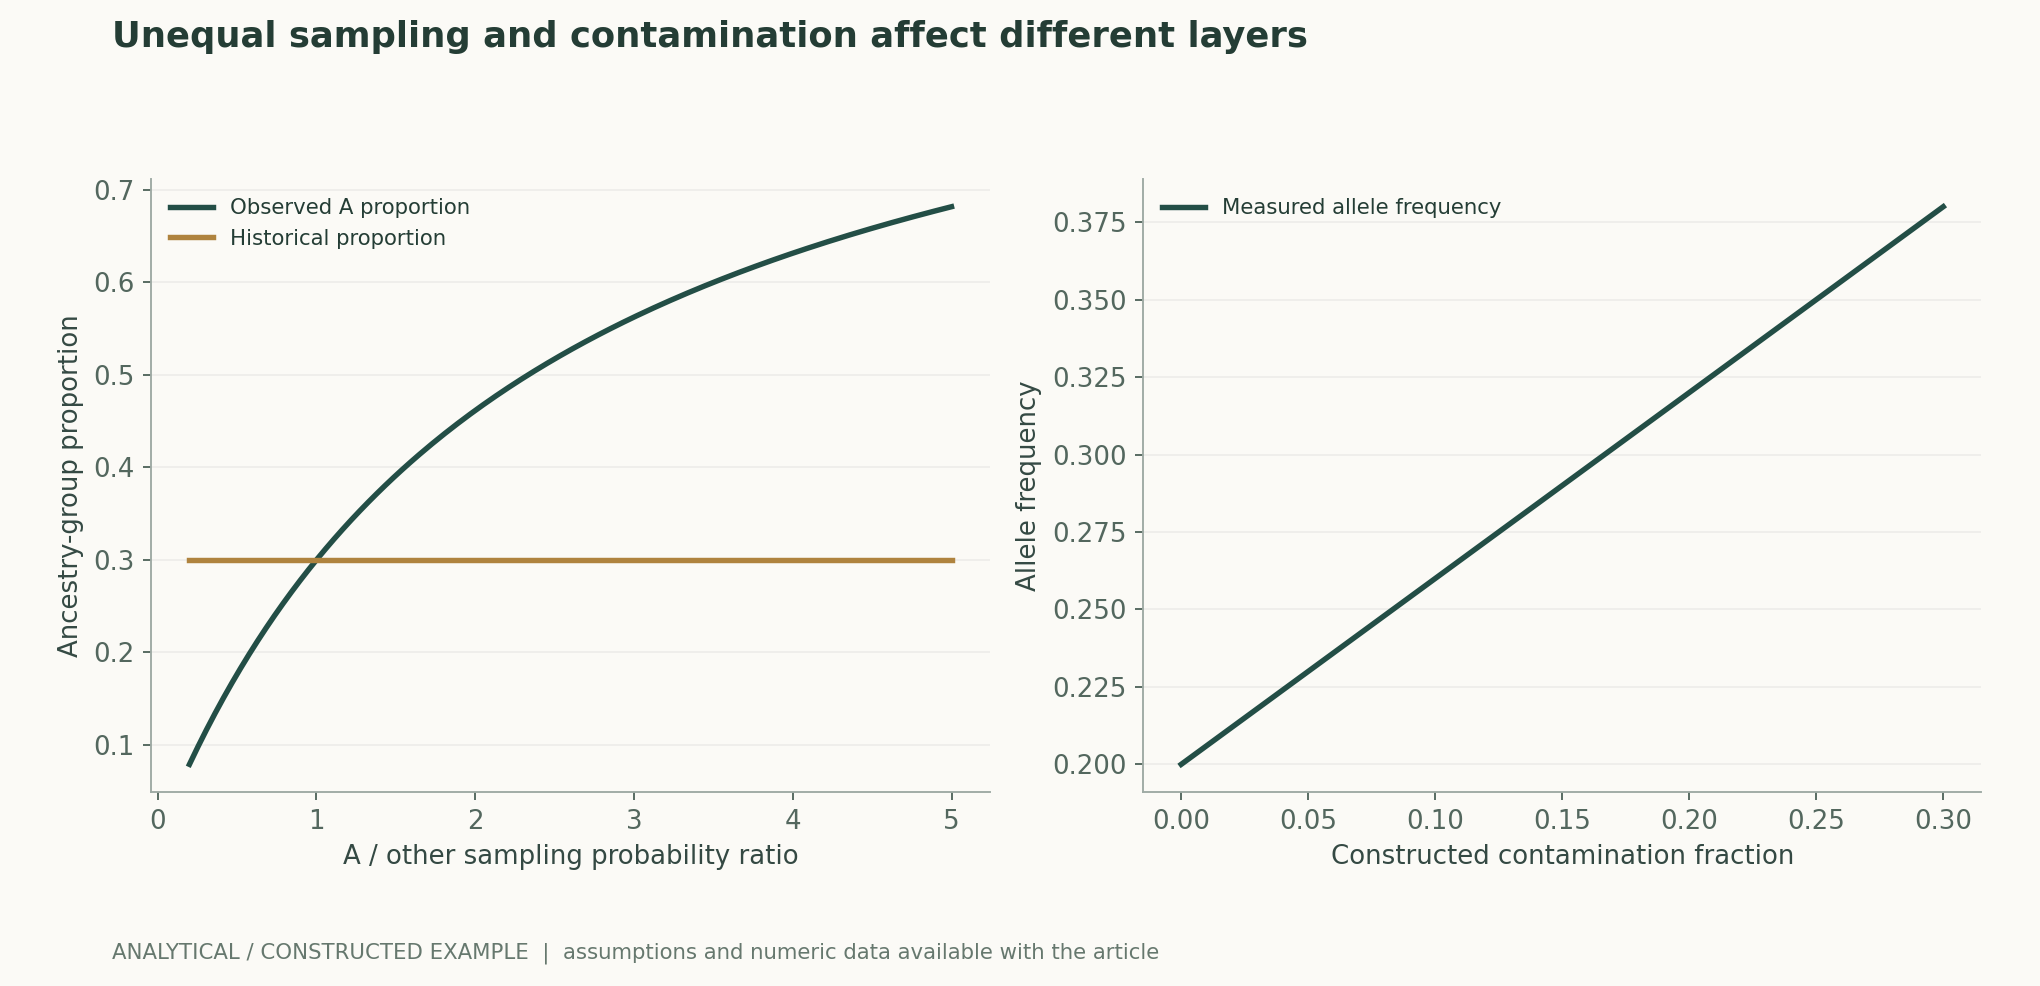
Ejemplo resuelto cuyo cálculo puede reproducirse
Cuando la probabilidad de muestreo de A triplica la de los demás grupos, su proporción muestral es 0.9/(0.9+0.7)=0.5625; cuando la contaminación representa 20%, la frecuencia del sitio construido pasa de 0.2 a 0.32.
Comparación de métodos
| Método o criterio de evaluación | Restricción directa | Evidencia que aún falta |
|---|---|---|
| Estadísticos f | Relaciones entre frecuencias poblacionales | Una historia poblacional única |
| Proporciones de mezcla | Coeficientes bajo sustitutos dados | Selección de sustitutos y colinealidad |
| Cortes temporales | Presencia de relaciones en un tiempo y lugar determinados | Momento exacto de la migración |
| Análisis de parentesco | Redes familiares y de cementerios | Muestras aleatorias regionales |
| Comprobación de daño y contaminación | Autenticidad molecular y mezcla | Representatividad histórica completa |
| Interpretación conjunta con la arqueología | Contexto cultural y material | Identidad que la ascendencia por sí sola no puede determinar |
Plan de verificación y experimentación
- Confirmar los permisos de las muestras y los metadatos que pueden publicarse.
- Registrar la cobertura, el daño, la contaminación y los intervalos de datación.
- Establecer conjuntos muestrales separados para el parentesco individual y las poblaciones regionales.
- Fijar las poblaciones sustitutas y conservar combinaciones alternativas.
- Calcular los errores estadísticos mediante bloques de ligamiento.
- Comparar la sensibilidad a los cementerios, los períodos y los umbrales de control de calidad.
- Volver a analizar las proporciones poblacionales para un intervalo de razones de muestreo.
- Publicar modelos verificables y predicciones sobre nuevas muestras que podrían refutar la interpretación.
Ámbito de aplicación y limitaciones
- Este artículo no generó nuevos datos de ADN antiguo ni de datación.
- El modelo de selección solo incluye dos fuentes y una razón de muestreo fija.
- Los coeficientes de ascendencia no pueden equipararse con lengua, nacionalidad o identidad.
- Las muestras de origen no son aleatorias y las poblaciones de referencia son limitadas.
- Las relaciones genómicas no pueden determinar de forma única todos los acontecimientos históricos.
Evidencias de los estudios originales y su ámbito de aplicación
| Resultados del estudio original | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| Los estadísticos f proporcionan un marco para contrastar relaciones de árbol y de mezcla. | Depende de los modelos, los sustitutos y la estimación del error. | Mezcla antigua en la historia humanaMétodos de estadísticos f |
| Las referencias antiguas detalladas y las muestras espaciotemporales mejoran la resolución de la historia poblacional europea. | Dentro de los lugares estudiados y la cobertura muestral. | Historia genómica de alta resolución de la Europa altomedievalFigs. 1–3 |
Preguntas de investigación que merecen contrastarse
- ¿Qué conclusiones sobre migración siguen siendo robustas cuando se desconocen las razones de muestreo?
- ¿Cuándo son indistinguibles la migración continua y un único episodio de reemplazo?
- ¿Pueden nuevos contextos funerarios modificar la clasificación de las fuentes sustitutas?
Correspondencia entre fuentes primarias y afirmaciones
- Ancient Admixture in Human HistoryNick Patterson, Priya Moorjani, Yontao Luo, Swapan Mallick, Nadin Rohland, Yiping Zhan, et al. · 2012-11-01f-statistics methods and admixture model tests
- High-resolution genomic history of early medieval EuropeLeo Speidel, Marina Silva, Thomas Booth, Ben Raffield, Kyriaki Anastasiadou, Christopher Barrington, et al. · 2025-01-01Figs. 1–3; ancestry modelling
Citación y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación documentada y análisis original escritos por Codex (IA). Los experimentos de los artículos originales corresponden a sus equipos de investigación; los cálculos de este artículo solo contrastan las ecuaciones enumeradas y los supuestos explícitos. Este sitio aún no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos, clínicos o físicos para este artículo.
Primera publicación: estudio temático en profundidad sobre evidencia científica interdisciplinaria; se mantienen las distinciones entre las fuentes de cada sección, la evidencia de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos adjuntos; sus leyendas explicitan, uno por uno, los supuestos y los criterios de medición.
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Python · Código para reproducir los cálculos · Historial de publicación y versiones
Revisión de la fuente: 500575872cce7c4b9c4062a12bb0692eb580c2da