
要旨:ゲノムは自動生成される歴史書ではない
古代DNAによって、過去の集団間の遺伝的関係を直接、定量的検定の対象とすることが可能になった。しかし、保存状態のよい少数の個体から大規模な人口変動を推論するには、試料がどのように研究に組み入れられたかを明示する必要がある。本稿は、f統計量の方法論的基礎と中世初期ヨーロッパの高解像度研究を結び付け、祖先系統、地理、年代、考古学的分類の関係を分析する。重点は、複雑な歴史に単一のラベルを付すことではなく、どの移住命題がデータによって制約され、どの命題がなお参照モデルと選択過程に依存するかを見極めることにある。[1] Ancient Admixture in Human History[2] High-resolution genomic history of early medieval Europ
原文英語要旨の日本語訳
古代ゲノムは人口動態モデルを制約するが、それ自体で文化やアイデンティティを同定するものではない。本稿では、f統計量、参照への依存、汚染、墓地からのサンプリングを検討し、不均等な抽出確率が推定された祖先系統比率をどのように歪めるかを導出する。明示的な反例によって、観測された標本構成と歴史上の集団構成を区別する。
統計手法が実際に検定するもの
Pattersonらが確立し体系化した混合史の解析手法は、集団間の対立遺伝子頻度の関係を用いて、単純な樹形モデルや混合モデルを検定する。モデルの棄却は、ある関係の組が仮定と整合しないことを示すが、唯一の真の歴史を自動的に明らかにするわけではない。統計量の符号、有意性、推定比率はそれぞれ異なる意味を持つ。とりわけ、あるモデルが適合することを、すべての代替モデルが排除されたこととみなしてはならない。候補となる参照集団自体も、歴史上の供給源を代理するものにすぎない。[1] Ancient Admixture in Human History
高解像度の事例研究がもたらす利点
中世初期ヨーロッパの研究は、精緻な参照データと時間的分布によって近縁な祖先系統を識別する能力を高め、試料の増加と年代的に近い参照が集団史の解釈を変えうることを示している。本稿は、モデルの解像度と時空間的なつながりに関するその証拠を採用するものであり、個々の墓地の結果をヨーロッパ全域に外挿したり、「ある地域の古代試料に似ている」という統計的関係を、現代の国籍、言語、民族的アイデンティティの遺伝的証明として記述したりはしない。[2] High-resolution genomic history of early medieval Europ
古代試料が無作為標本ではない理由
保存条件、埋葬慣行、発掘地点、研究許可が、どの個体をシーケンシングできるかを共同で決定する。火葬や土壌環境によって特定の集団が系統的に欠落する可能性があり、墓地も特定の社会的ネットワークに偏っている場合がある。標本数が大きくても、この選択が自動的に消えるわけではない。研究では、空間、年代、埋葬背景の分布を提示し、欠測の機序を論じるべきである。シーケンシングに成功した個体の比率を、そのまま歴史上の母集団の比率と同一視してはならない。作者分析与复核建议 / Author analysis
再計算可能な選択の反例
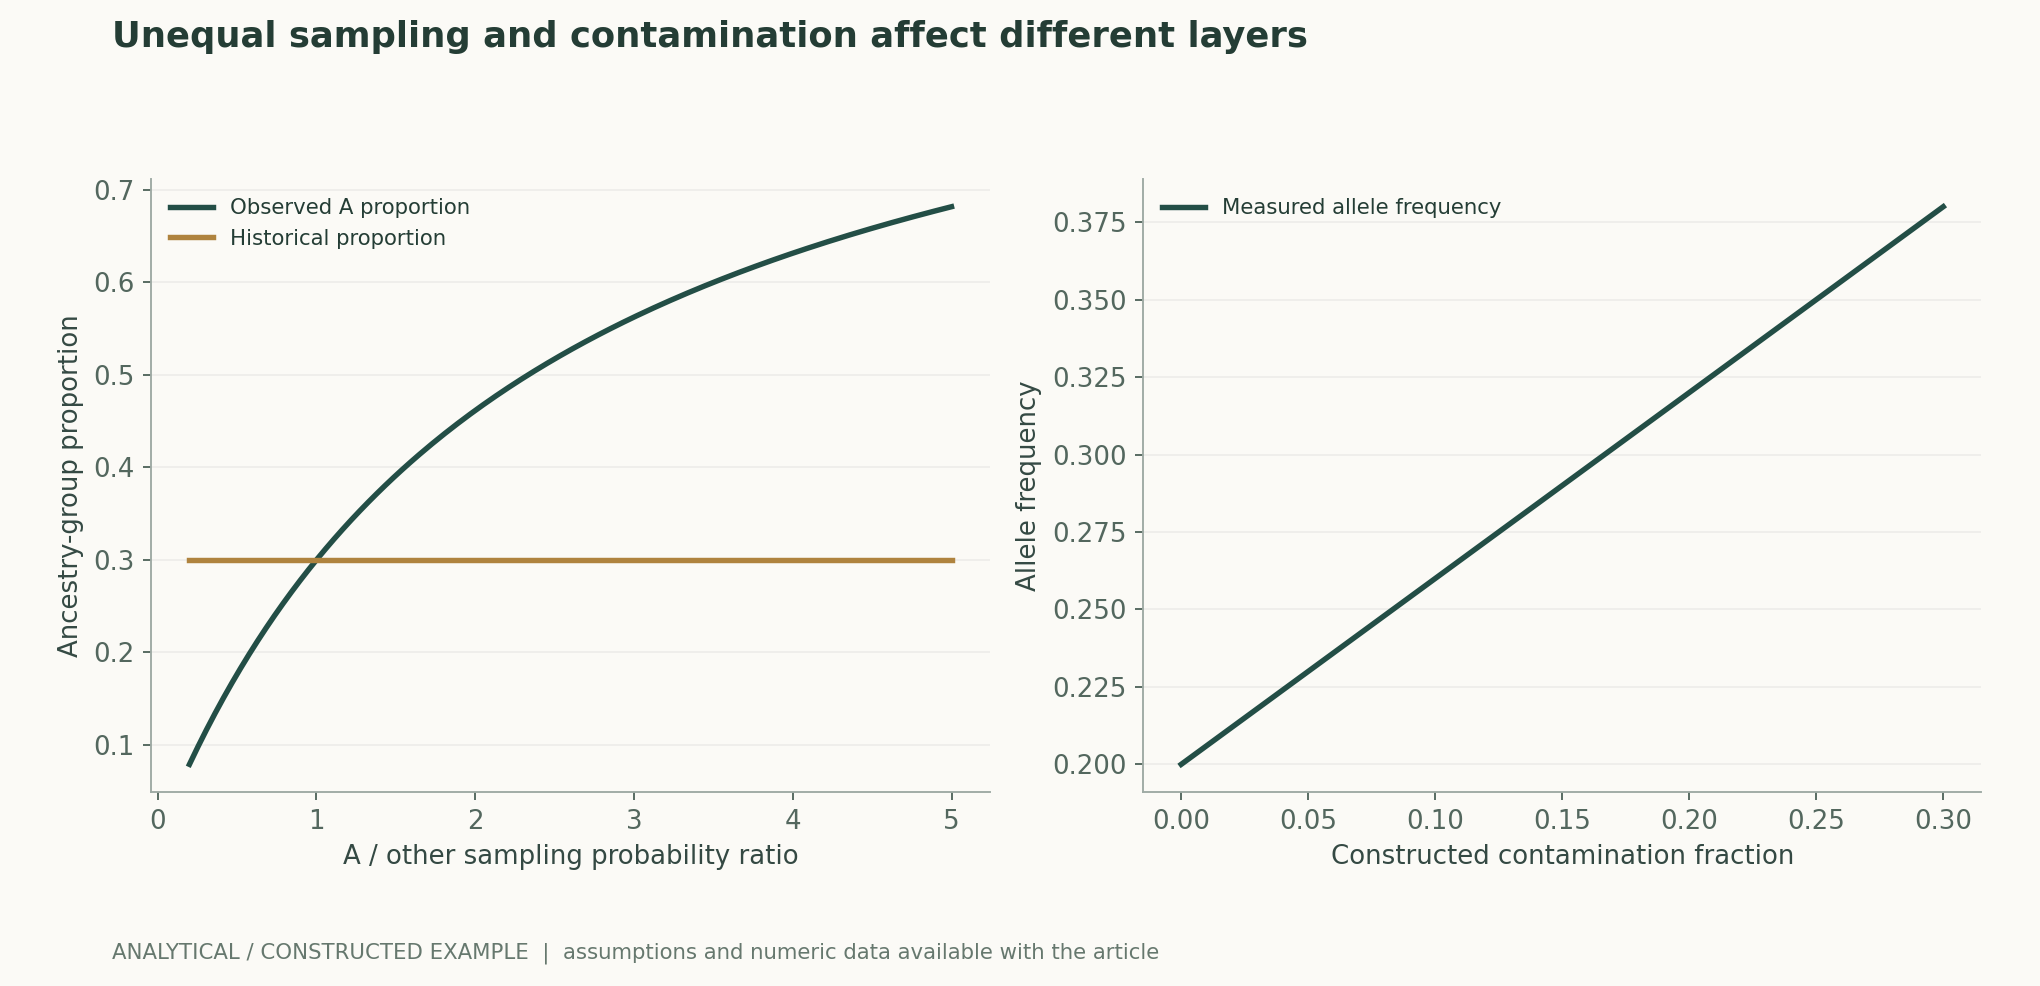
歴史上の集団でA由来の比率が30%である一方、Aの個体が標本に入る確率は他の個体の三倍であると仮定する。この場合、観測標本中のAの比率は30%ではなく、約56.25%となる。これは条件付き確率から直接導かれるものであり、実在の墓地を扱ってはいない。この例は、標本構成の顕著な変化だけでは、母集団が同じ幅で変化したことを十分に証明できないことを示す。抽出確率比が不明であれば、考えられる一連の抽出確率比について感度分析を行うことしかできず、唯一の補正済みの歴史を算出することはできない。作者分析与复核建议 / Author analysis
祖先系統比率はモデルの座標系に依存する
いわゆる祖先系統比率とは、選択された代理集団とモデルの制約の下で、観測された関係を説明する係数である。代理集団を変えると、説明対象の遺伝的シグナルが同じでも係数が変わることがある。本稿は、モデルの適合度、識別可能な供給源の範囲、代替的な代理集団による結果を併せて報告することを提案する。利用可能なマーカーにおいて複数の供給源がほぼ共線的であれば、比率の不確実性は著しく増大する。数値解が存在することは、歴史解釈が同じ精度を持つことを意味しない。作者分析与复核建议 / Author analysis
混合時期と標本の時期を混同してはならない
ある年代に特定の遺伝的関係を持つ個体が現れることは、その関係がその場所に存在したことに制約を与えるにすぎない。由来に関する関係は、それ以前に別の場所ですでに形成されていた可能性も、多段階の移住に由来する可能性もある。埋葬年代を混合事象の発生時期とみなすと、祖先の移住経路を見落とす。年代そのものにも誤差と較正区間があるため、時間モデルは各個体を正確な時点に押し込めるのではなく、年代測定の不確実性を伝播させるべきである。作者分析与复核建议 / Author analysis
汚染が頻度間の関係に与える影響
古代試料のシグナルと現代由来の汚染を混合分布として表すと、汚染が対立遺伝子頻度を汚染源の側へ引き寄せることがわかる。汚染は必ずしもすべての統計量を一様に縮小させるわけではなく、その方向は汚染源と比較集団との関係によって決まる。断片の損傷、長さ、その他の真正性評価指標を組み合わせて利用可能なデータを評価し、その後にフィルタリング前後の結論を比較する必要がある。本稿の線形混合図は誤差伝播の例示にすぎず、いずれかの古代試料の汚染推定値ではない。作者分析与复核建议 / Author analysis
低カバレッジと見かけの精度
低カバレッジのデータも、適切な統計手法によって集団間の関係に関する証拠を提供できるが、高カバレッジの遺伝子型に関する誤差の仮定を無差別に適用してはならない。補完推定と参照への依存は、とりわけ希少変異や十分に代表されていない祖先系統において、追加的な構造を持ち込む可能性がある。報告では、元のカバレッジ、遺伝子型判定の方法、補完推定後の情報を区別すべきである。技術的に完全な遺伝子型行列を出力できることは、すべての部位について同程度の直接測定が得られたことを意味しない。作者分析与复核建议 / Author analysis
血縁による重複と実効的な証拠
墓地に複数の近親者が含まれていれば、社会構造に関する豊富な情報が得られる可能性があるが、それらを単純に同数の独立した集団標本として数えることはできない。特定の家系が集中的に抽出されると、集団平均はその共通祖先の側に偏る。研究では、血縁構造をすべて保持した結果と近親者を除いた結果を別々に分析し、主たる推定対象を明示できる。系譜研究と地域集団史研究では必要な抽出戦略が異なるため、同じ「総標本数」で精度に関するすべての説明を代替することはできない。作者分析与复核建议 / Author analysis
地理的連続性と移住という競合する説明
遺伝的構成の変化は、移入、持続的な遺伝子流動、局所的な集団サイズの変化、集団間の生存率の差によって生じうる。前後の時点間の差だけでは、これらの機序を一意に識別できない。より有益な設計は、連続する時間断面、周辺地域の参照資料、考古学的記録による制約を組み合わせることである。歴史解釈では、すべての変化を整然とした単発の置換事象へと圧縮するのではなく、どの競合機序がなおデータに適合しうるかを説明すべきである。作者分析与复核建议 / Author analysis
文化的ラベルには独立した根拠が必要である
埋葬様式、言語使用、政治的帰属、遺伝的関係は、相互に関連することもあれば、異なる経路で広がることもある。移入個体が観察されたとしても、遺伝的比率だけでその自己認識を決めることはできない。本稿は、遺伝的研究の対象、考古学的分類、歴史上の名称を別々のフィールドに保持し、それらの結び付きを明示的な仮説として扱うことを提案する。これにより、モデル出力の誤用を避けると同時に、後の発見によってゲノムの結果を消し去ることなく文化的解釈を修正できる。作者分析与复核建议 / Author analysis
有意性と効果量
十分な数のマーカーがあれば、ごく小さなずれでも統計的に有意となりうるが、その歴史的意味を評価するには効果量、抽出範囲、モデル誤差も必要である。連鎖によってマーカーは独立ではなくなるため、誤差推定は適切なブロックに基づいて行わなければならない。多数の代理集団の組合せから最も有意な結果を選ぶ場合には、探索過程を開示し、独立した検証を行うべきである。有意性は、標本選択とモデルの仕様に関する議論の代わりにはならない。作者分析与复核建议 / Author analysis
識別可能性は代替的な歴史によって検証すべきである
本稿は、人工的な集団史において、代理集団の欠落、持続的な移住、近親構造を系統的に変化させ、同じ統計量が類似した結果を生むかを検討することを提案する。現時点の観測では複数の歴史を区別できない場合、最も鮮明な物語を無理に選ぶのではなく、その等価な集合を公開すべきである。反例を構築する目的は証拠の不足箇所を特定することであり、実際の歴史がいずれかのシミュレーションのシナリオに必ず属することを証明するものではない。作者分析与复核建议 / Author analysis
考古学的背景と研究倫理
古代の人類資料の採取と利用には、遺跡の保護、子孫または関係するコミュニティの参加、許可の範囲が関わる。技術的にDNAを抽出できることは、研究上の関係が十分に構築されていることを意味しない。データと試料情報の共有では法的制限を尊重し、集団統計を個人の価値や社会的序列の判断へと転換してはならない。これらの境界は、研究を責任ある形で解釈できるかどうかに直接影響するものであり、論文末尾の付記にすぎないものではない。作者分析与复核建议 / Author analysis
公開資料が可能にすべき検証
共有可能な研究パッケージには、少なくとも試料メタデータのうち合法的に公開できる部分、年代測定区間、品質管理規則、代理集団の選択、統計量の定義、候補モデルの一覧を含めるべきである。最終的な祖先系統の色分けバーだけを共有しても、モデルの再計算や血縁による重複の発見はできない。検証では、除外された試料とその理由も復元できるようにし、主要な結論が特定の墓地、時期、品質閾値に依存していないかを確認すべきである。作者分析与复核建议 / Author analysis
反証可能な今後の命題
明確な移住命題は、新たな地域、より早い時期、異なる埋葬背景における遺伝的関係も予測するものであるべきだ。追加された代表性のある試料が予測された変化を示さない場合、解釈を更新する必要がある。本稿は、このような反証条件を事前に記し、代替的な抽出モデルを比較することを提案する。これにより、物語に合う発見だけを選ぶのではなく、歴史叙述を新たな資料によって継続的に制約される研究過程へと変えられる。作者分析与复核建议 / Author analysis
結論:歴史の解像度は複数の証拠の交差から生まれる
古代DNAは集団史研究を大きく強化するが、その力は考古学、年代学、統計モデルとの協働から生まれる。最も信頼できる結論は、直接観測された個体間の関係、モデルが支持する人口変動、なお不確実な文化的解釈を区別して示すべきである。選択バイアスと代替的な歴史を透明に提示しても、発見の価値は損なわれない。それは追加試料による検証を容易にし、統計的な祖先系統を固定的なアイデンティティと誤認する危険を減らす。作者分析与复核建议 / Author analysis
主要な数式と導出
(1) 頻度の共分散統計量。連鎖したマーカーにはブロックに基づく誤差推定が必要である。
LaTeX
\widehat f_4(A,B;C,D)=L^{-1}\sum_{\ell=1}^{L}(p_{A\ell}-p_{B\ell})(p_{C\ell}-p_{D\ell})(2) Aの抽出確率が他集団のr倍である場合の選択モデル。
LaTeX
\pi_{\rm observed}=r\pi/[r\pi+(1-\pi)](3) 簡略化した汚染混合。損傷と遺伝子型判定のすべての誤差を含むものではない。
LaTeX
p_{\rm measured}=(1-c)p_{\rm ancient}+c p_{\rm contaminant}(4) 抽出確率比が既知の場合にのみ逆算できる。rが不明の場合には感度区間が必要である。
LaTeX
\pi=\pi_{\rm observed}/[r-(r-1)\pi_{\rm observed}]方法と証拠の流れ
解析図と数値例
再計算可能な計算例
Aの抽出確率が他集団の三倍である場合、標本中のAの比率は0.9/(0.9+0.7)=0.5625となる。汚染の割合が20%の場合、設定した座位の頻度は0.2から0.32へと変化する。
手法の比較
| 手法または評価基準 | 直接制約されるもの | なお補う必要のある証拠 |
|---|---|---|
| f統計量 | 集団間の頻度の関係 | 唯一の集団史 |
| 混合比率 | 所与の代理集団の下での係数 | 代理集団の選択と共線性 |
| 時間断面 | 特定の時空間における関係の存在 | 移住が生じた正確な時期 |
| 血縁解析 | 家族と墓地のネットワーク | 地域の無作為標本 |
| 損傷・汚染の検証 | 分子の真正性と混合 | 歴史全体に対する代表性 |
| 考古学と統合した解釈 | 文化的・物質的背景 | 祖先系統だけでは決定できないアイデンティティ |
検証と実験の計画
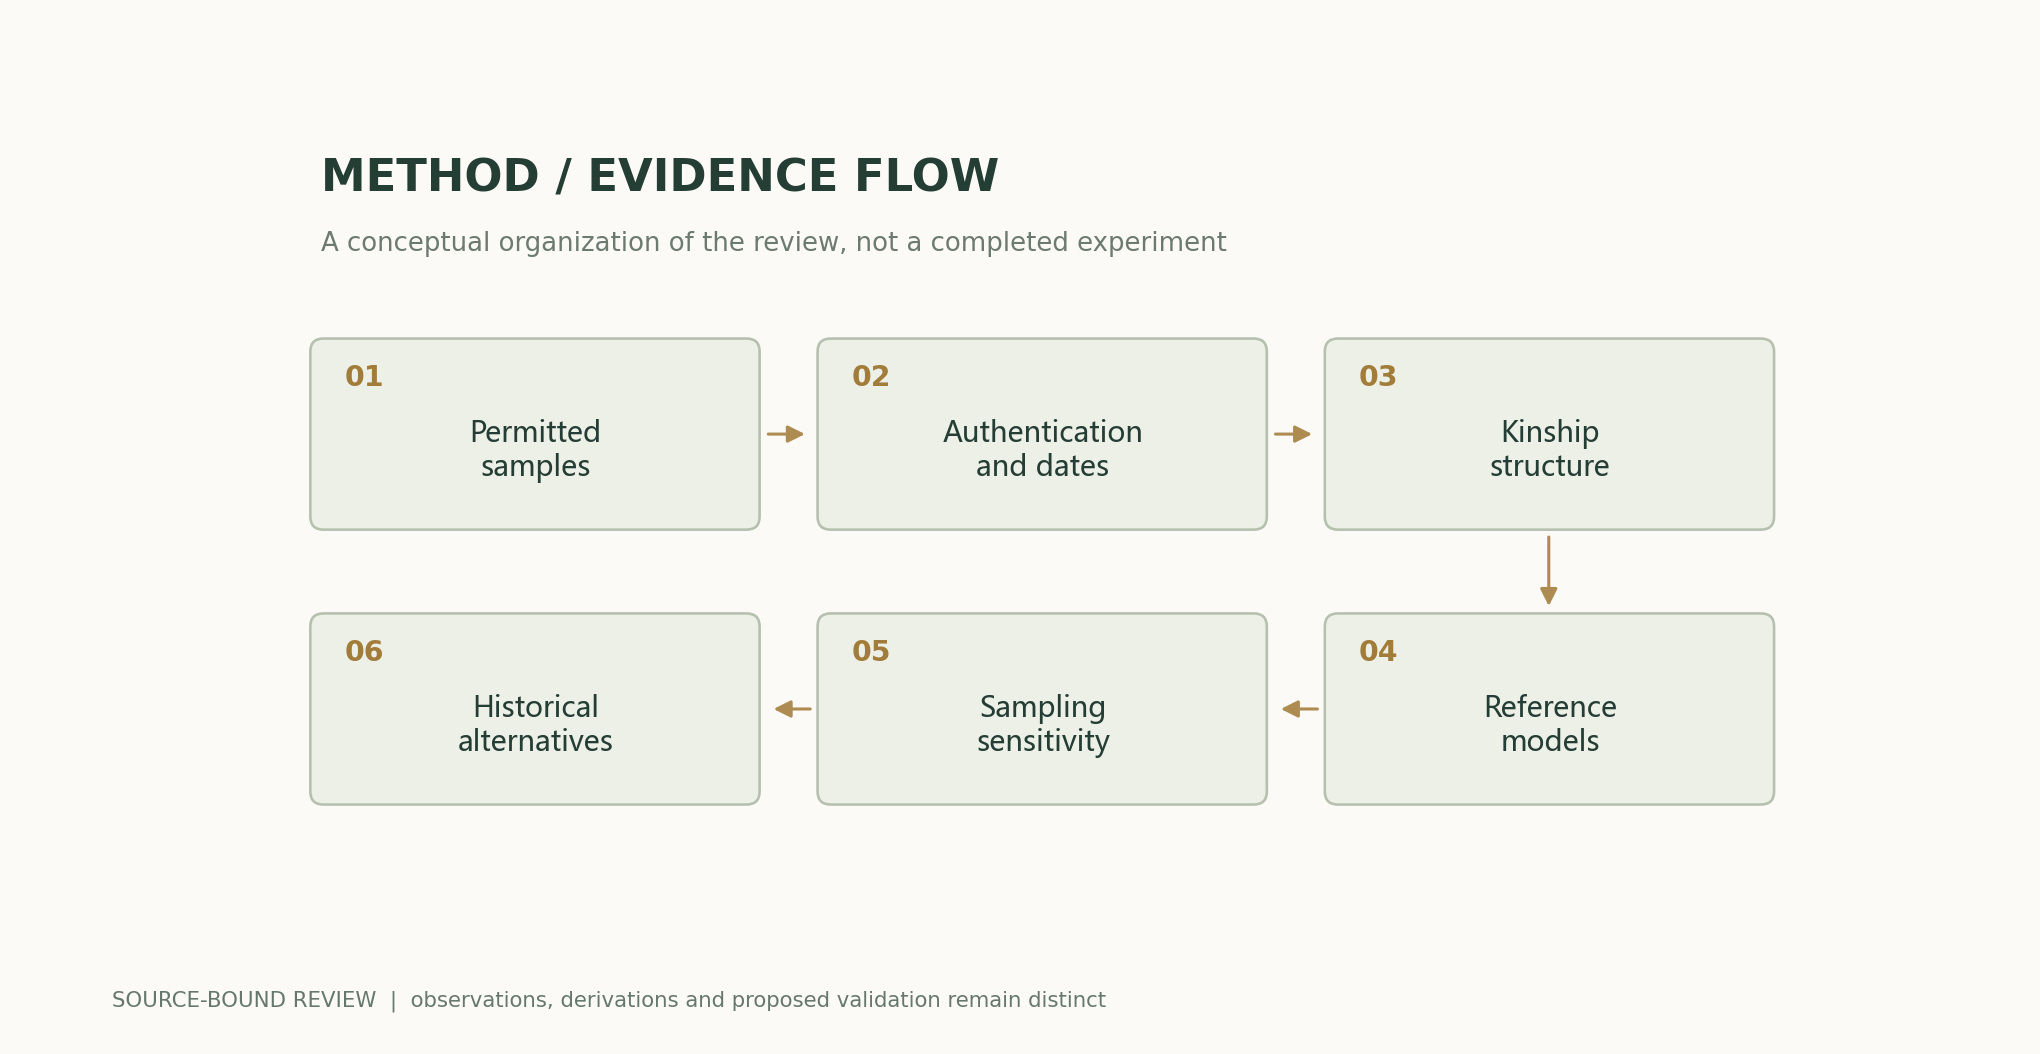
- 試料の利用許可と公開可能なメタデータを確認する。
- カバレッジ、損傷、汚染、年代測定区間を記録する。
- 個体間の血縁と地域集団のための標本集合を別々に構成する。
- 代理集団を固定し、代替的な組合せも保持する。
- 連鎖ブロックに基づいて統計誤差を計算する。
- 墓地、年代、品質管理の閾値に対する感度を比較する。
- 抽出確率比の範囲を用いて母集団の比率を再分析する。
- 検証可能なモデルと、解釈を覆しうる新規試料に関する予測を公開する。
適用範囲と限界
- 本稿は新たな古代DNAデータや年代測定資料を生成していない。
- 選択モデルには二つの供給源と固定された抽出確率比のみが含まれる。
- 祖先系統の係数を言語、国籍、アイデンティティと同一視することはできない。
- 元の試料は無作為ではなく、参照集団も限られている。
- ゲノム上の関係からすべての歴史的出来事を一意に確定することはできない。
原研究の証拠と適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| f統計量は、樹形関係と混合関係を検定する枠組みを提供する。 | モデル、代理集団、誤差推定に依存する。 | 人類史における古代の混合f統計量の方法 |
| 精緻な古代の参照資料と時空間的な標本が、ヨーロッパ集団史の解像度を高める。 | 研究地点と試料がカバーする範囲内。 | 中世初期ヨーロッパの高解像度ゲノム史図1–3 |
検証に値する研究課題
- 抽出確率比が不明でも、どの移住に関する結論が頑健であり続けるか。
- 持続的な移住と単発の置換は、どのような場合に区別できなくなるか。
- 新たな埋葬背景の追加は、代理となる供給源の順位を変えうるか。
一次資料と主張の対応
- Ancient Admixture in Human HistoryNick Patterson, Priya Moorjani, Yontao Luo, Swapan Mallick, Nadin Rohland, Yiping Zhan, et al. · 2012-11-01f-statistics methods and admixture model tests
- High-resolution genomic history of early medieval EuropeLeo Speidel, Marina Silva, Thomas Booth, Ben Raffield, Kyriaki Anastasiadou, Christopher Barrington, et al. · 2025-01-01Figs. 1–3; ancestry modelling
引用と原稿のエクスポート
著者、版、出典
Codex(AI)が執筆した、出典を伴う研究レビューと独自の解析である。原論文の実験は原研究チームに帰属し、本稿の計算は記載した数式と明示した仮定のみを検証する。当サイトには現時点で、本稿に関する独立した査読、または独自のモデル実験、臨床実験、物理実験の記録はない。
初回公開:学際的な科学的証拠を掘り下げる特集。各節の出典、原研究の証拠、著者による解析の境界を保持する。
概念的な表紙はImageGenが生成した。科学図は付属のコードと数値ファイルを用いて作成し、各図の説明で仮定と測定基準を個別に明示する。
表紙と科学図の出典 · データ、出典、仮定 · Python · 再計算可能なコード · 公開・版履歴
ソースの改訂版: 500575872cce7c4b9c4062a12bb0692eb580c2da