
摘要:基因组不是自动生成的历史书
古DNA使过去人群的遗传关系可以直接进入定量检验,但从少数保存良好的个体推断大规模人口变化,需要明确样本如何进入研究。本文连接f统计量的方法基础与中世纪早期欧洲的高分辨率研究,分析祖源、地理、年代和考古分类之间的关系。重点不是给复杂历史贴上单一标签,而是辨认哪些迁徙命题被数据约束,哪些仍依赖参考模型与选择过程。[1] Ancient Admixture in Human History[2] High-resolution genomic history of early medieval Europ
English abstract
Ancient genomes constrain demographic models but do not identify culture or identity by themselves. We examine f-statistics, reference dependence, contamination and cemetery sampling, and derive how unequal sampling probabilities distort inferred ancestry proportions. A transparent counterexample separates observed sample composition from historical population composition.
统计方法实际检验什么
Patterson等建立和系统化的混合历史分析方法,利用群体间等位基因频率关系检验简单树或混合模型。模型拒绝说明某组关系与假设不相容,不自动告诉我们唯一真实历史。统计量的符号、显著性和估计比例具有不同含义。尤其不能把一个模型可以拟合,看作所有替代模型已被排除;候选参考群体本身也只是历史来源的代理。[1] Ancient Admixture in Human History
高分辨率案例带来的增益
中世纪早期欧洲研究通过精细参考与时间分布提高相近祖源的区分能力,显示更多样本和更贴近年代的参照可以改变人口史解释。本文采用其关于模型分辨率和时空联系的证据,不将个别墓地的结果外推整个欧洲,也不把“类似某地古样本”的统计关系写成现代国籍、语言或族群身份的基因证明。[2] High-resolution genomic history of early medieval Europ
古样本为何不是随机抽样
保存条件、埋葬习俗、发掘地点和研究许可共同决定哪些个体可被测序。火葬与土壤环境可能使某些群体系统性缺席,墓地也可能偏向特定社会网络。即使样本量很大,这种选择不会自动消失。研究应提供空间、年代和墓葬背景分布,并讨论缺失机制;不能把成功测序者的比例直接等同于历史总体的比例。作者分析与复核建议 / Author analysis
一个可复算的选择反例
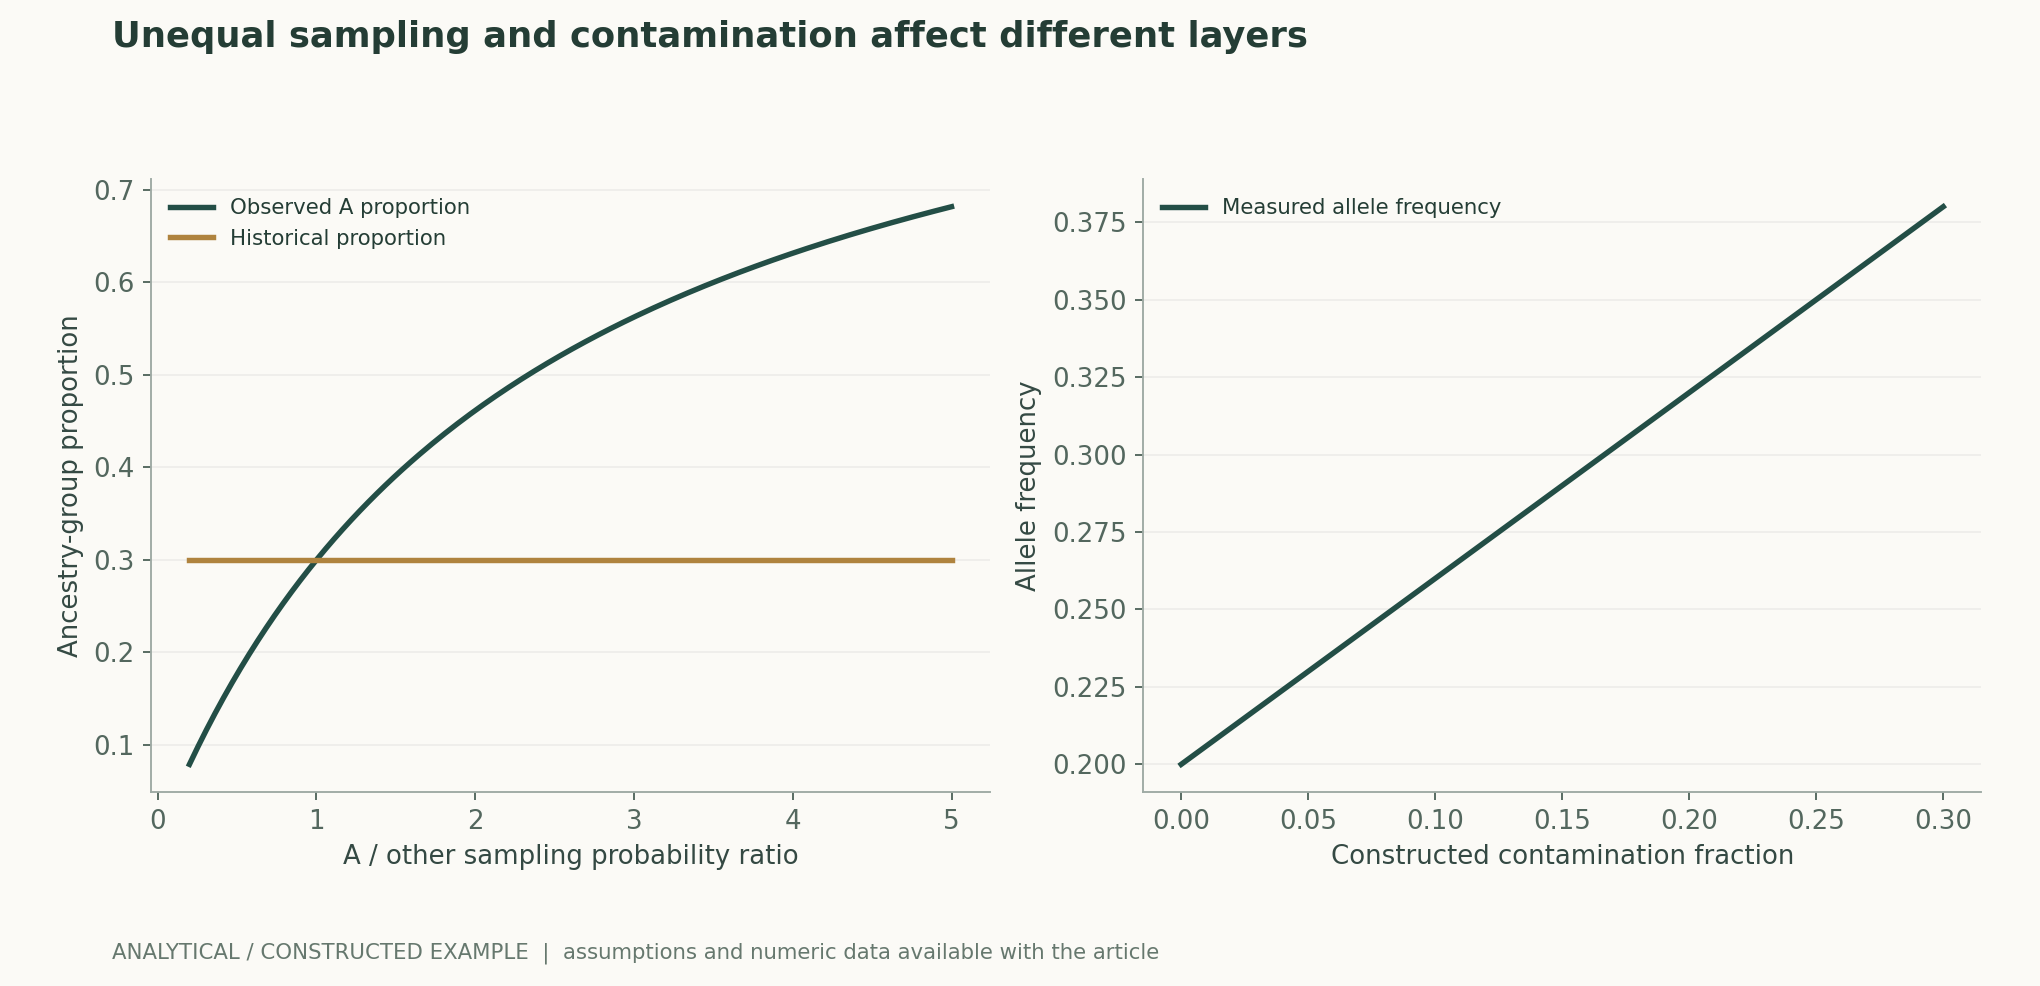
假设历史群体中A来源比例为30%,但A个体进入样本的机会是其他个体的三倍。则观测样本中A比例约为56.25%,而非30%。这由条件概率直接得出,不涉及真实墓地。它说明样本构成明显改变并不充分证明总体同等幅度改变;若抽样比未知,只能对一系列可能抽样比做敏感性分析,而不能计算一个唯一的校正历史。作者分析与复核建议 / Author analysis
祖源比例依赖模型坐标
所谓祖源比例是在选择的代理群体与模型约束下解释观测关系的系数。换一组代理,系数可能改变,即使被解释的遗传信号相同。本文建议同时报告模型拟合、可区分的来源范围和替代代理结果。若几个来源在可用标记上接近共线,比例的不确定性会显著增加;一个数值解存在,并不意味着历史解释具有同样精度。作者分析与复核建议 / Author analysis
混合时间与采样时间不能混同
某个年代出现具有特定遗传关系的个体,只能给该关系在这个地点的存在提供约束。来源关系可能在更早地点已经形成,也可能来自多阶段迁移。以墓葬年代作为混合事件发生时间,会忽略祖先的迁徙路径。日期本身还有误差和校正区间,因此时间模型应传播测年不确定性,而不是把每个个体压成一条精确时间线。作者分析与复核建议 / Author analysis
污染如何影响频率关系
将古样本信号与现代污染写成混合分布,可以看到污染会把等位频率拉向污染来源。污染并非总是把所有统计量同等缩小,方向取决于污染与比较群体的关系。需要结合片段损伤、长度和其他认证指标评估可用数据,再比较过滤前后结论。本文的线性混合图只是误差传播示例,不是任何古样本的污染估计。作者分析与复核建议 / Author analysis
低覆盖与伪精度
低覆盖数据可以通过适当统计方法贡献群体关系证据,但不能随意套用高覆盖基因型的误差假设。插补与参考依赖会引入额外结构,尤其在罕见变异或未充分代表的祖源中。报告应区分原始覆盖、调用方式和插补后信息。技术上输出完整基因型矩阵,并不等于每个位点都获得相同程度的直接测量。作者分析与复核建议 / Author analysis
亲缘重复与有效证据
一个墓地中多个近亲可能带来丰富社会结构信息,却不能简单算作同等数量独立人口样本。若某一家系被集中取样,群体均值会偏向其共同祖先。研究可以分别分析保留全部亲缘结构和去除近亲后的结果,并明确主要估计对象。谱系研究与区域人口史研究所需的抽样策略不同,不能用同一个“总样本数”替代所有精度说明。作者分析与复核建议 / Author analysis
地理连续性与迁徙的竞争解释
遗传组成变化可能来自迁入、持续基因交流、局部人口规模变化或不同群体的差异存活。一个前后时间点的差异不能唯一辨认这些机制。更有信息的设计是连续时间切片、周边地区参照及考古记录联合约束。历史解释应该说明哪些竞争机制仍能拟合,而不是把所有变化都压缩成一次整齐的替代事件。作者分析与复核建议 / Author analysis
文化标签必须有独立依据
墓葬风格、语言使用、政治归属和遗传关系可以相互关联,也可以沿不同路径传播。即使观察到迁入个体,也不能只凭遗传比例决定其自我认同。本文建议将遗传对象、考古分类与历史名称保存在不同字段,连接关系使用明确假说。这样既避免模型输出被误用,也允许后续发现修正文化解释而不抹去基因组结果。作者分析与复核建议 / Author analysis
显著性与效应大小
足够多标记可能让很小的偏离达到统计显著,但历史意义还需要效应大小、抽样范围和模型误差。连锁导致标记不独立,误差估计必须按适当区块处理。若研究在大量代理组合中选择最显著结果,还应披露搜索过程并进行独立复核。显著性不能代替对样本选择和模型规格的讨论。作者分析与复核建议 / Author analysis
可识别性应通过替代历史测试
本文提出在合成人口史上系统改变代理缺失、持续迁移与近亲结构,检查同一统计量是否产生相似结果。若多个历史在现有观测下不可区分,应发布这一等价集合,而不是强行选一个最生动的故事。构造反例的目标是定位证据缺口;它不能证明真实历史一定属于任何一个模拟场景。作者分析与复核建议 / Author analysis
考古背景与研究伦理
古人类材料的采集和使用涉及遗址保护、后裔或相关社群的参与以及许可范围。技术上能提取DNA不代表研究关系已经充分建立。共享数据与样本信息时应保留合法限制,且不将群体统计转化为个体价值或社会等级判断。这些边界直接影响研究能否被负责任地解释,而不只是论文末尾的附加声明。作者分析与复核建议 / Author analysis
公开材料应支持什么复核
可交换研究包至少包含样本元数据的合法公开部分、测年区间、质控规则、代理选择、统计量定义和候选模型清单。只共享最终祖源颜色条,无法重算模型或发现亲缘重复。复核还应能恢复被排除样本及原因,以确认主要结论是否依赖某个墓地、时间段或质量阈值。作者分析与复核建议 / Author analysis
可证伪的后续命题
一个明确的迁徙命题应同时预测新地区、较早时间或不同墓葬背景中的遗传关系。如果新增代表性样本并不呈现所预测的变化,解释需要更新。本文建议预先写下这种反证条件,并比较替代采样模型。这样可以把历史叙事转化为持续受新材料约束的研究过程,而不是只挑符合故事的发现。作者分析与复核建议 / Author analysis
结论:历史分辨率来自多种证据相交
古DNA显著增强人口史研究,但其力量来自与考古、年代和统计模型共同工作。最可信的结论应指出被直接观察的个体关系、模型支持的人口变化,以及仍不确定的文化解释。透明展示选择偏差与替代历史,不会削弱发现;它使研究更容易被新增样本检验,并减少把统计祖源误当固定身份的风险。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 频率协变统计;连锁标记需要区块误差估计。
LaTeX
\widehat f_4(A,B;C,D)=L^{-1}\sum_{\ell=1}^{L}(p_{A\ell}-p_{B\ell})(p_{C\ell}-p_{D\ell})(2) A被取样机会为其他群体r倍时的选择模型。
LaTeX
\pi_{\rm observed}=r\pi/[r\pi+(1-\pi)](3) 简化污染混合;不包含所有损伤和调用误差。
LaTeX
p_{\rm measured}=(1-c)p_{\rm ancient}+c p_{\rm contaminant}(4) 已知取样比时才可反演;未知r需要敏感性区间。
LaTeX
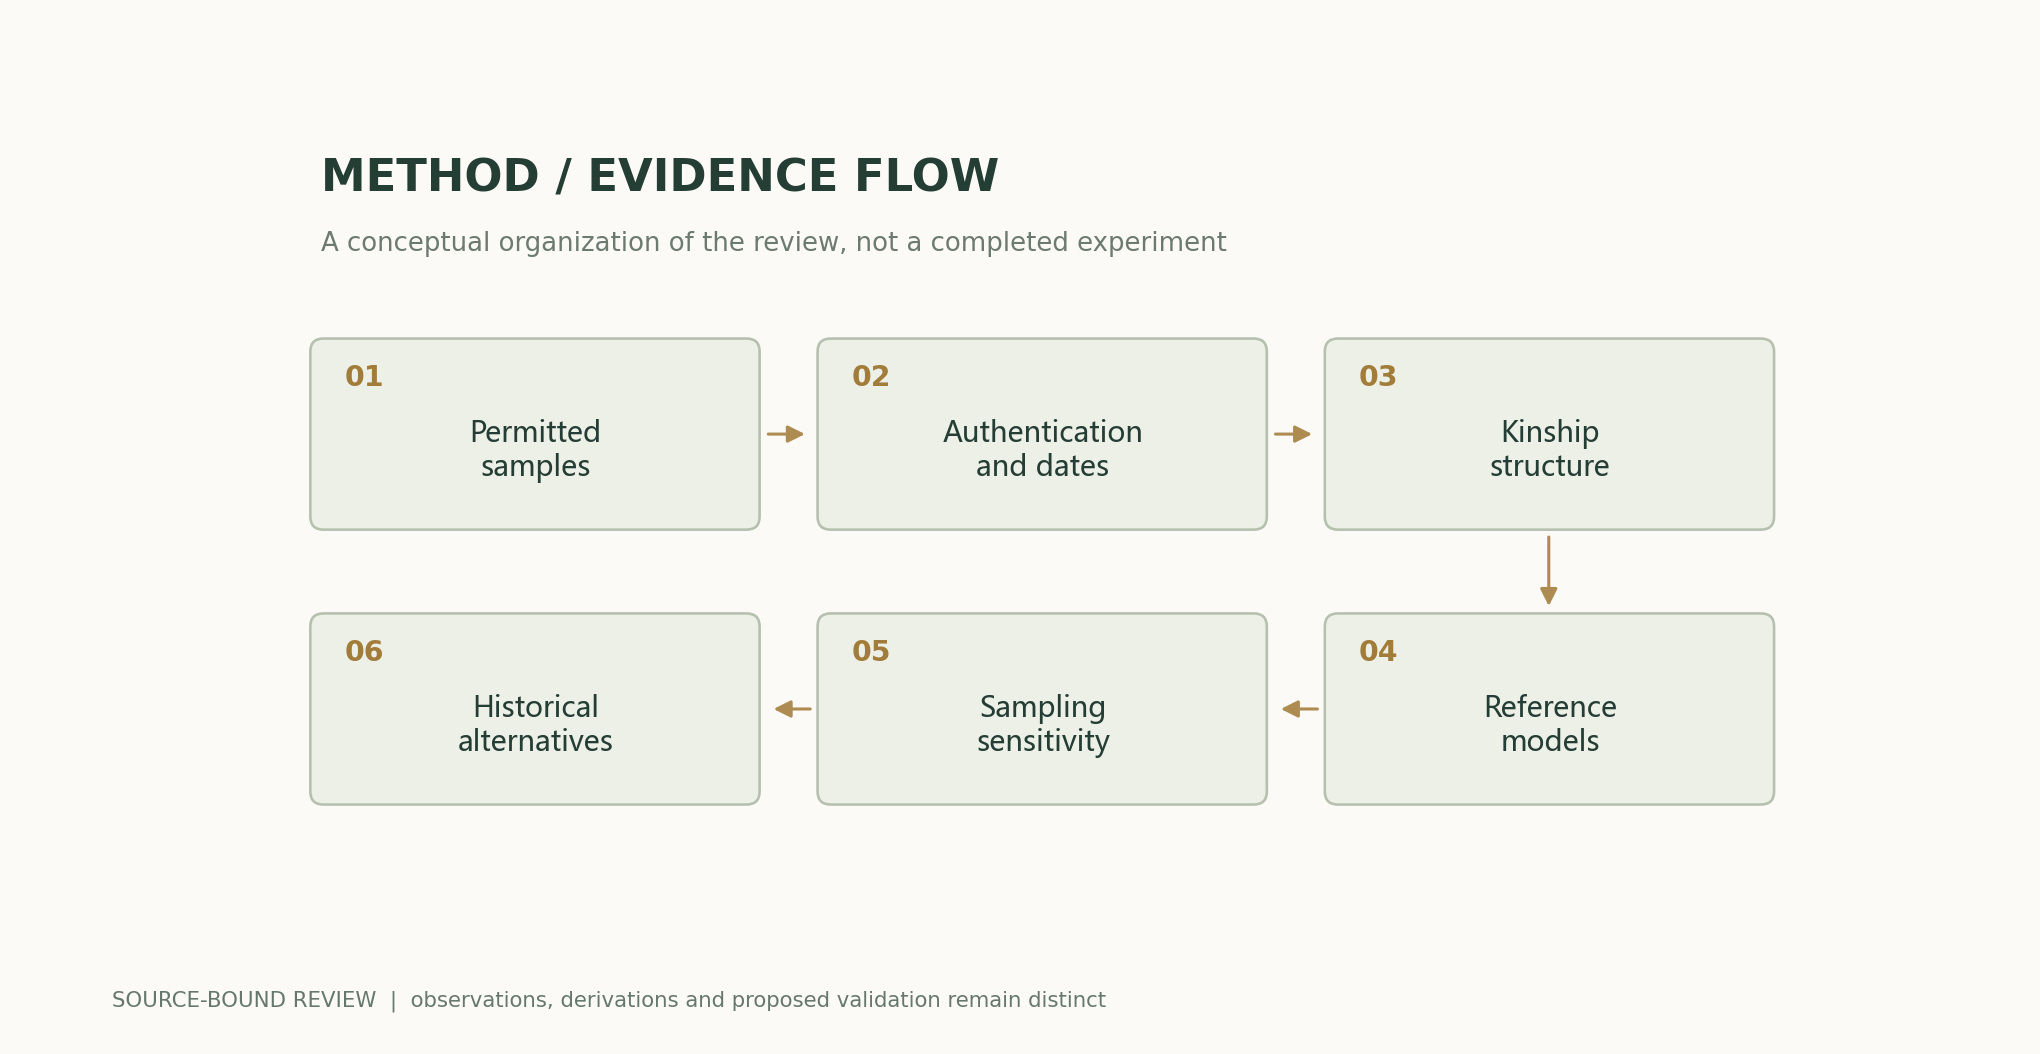
\pi=\pi_{\rm observed}/[r-(r-1)\pi_{\rm observed}]方法与证据流程
解析图与数值示例
可复算例题
A取样机会为其他群体三倍时,样本A比例0.9/(0.9+0.7)=0.5625;污染占20%时构造位点频率由0.2变0.32。
方法比较
| 方法或口径 | 直接约束 | 仍需补足的证据 |
|---|---|---|
| f统计量 | 群体频率关系 | 唯一人口史 |
| 混合比例 | 给定代理下的系数 | 代理选择与共线性 |
| 时间切片 | 某时空存在关系 | 迁移发生的精确时间 |
| 亲缘分析 | 家庭和墓地网络 | 区域随机样本 |
| 损伤/污染校验 | 分子真实性与混合 | 完整历史代表性 |
| 考古联合解释 | 文化与物质背景 | 不能由祖源单独决定的身份 |
复核与实验方案
- 确认样本许可及可公开元数据。
- 记录覆盖、损伤、污染和测年区间。
- 分别建立个体亲缘与区域人口样本。
- 固定代理群体并保留替代组合。
- 按连锁区块计算统计误差。
- 比较墓地、年代和质控阈值敏感性。
- 用取样比范围重新分析总体比例。
- 公开可复核模型及可能推翻解释的新样本预测。
适用范围与局限
- 本文没有生成新古DNA或测年资料。
- 选择模型只含两个来源和固定取样比。
- 祖源系数不能等同语言、国籍或身份。
- 源样本不随机且参考群体有限。
- 基因组关系不能唯一确定全部历史事件。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| f统计提供树和混合关系的检验框架。 | 依赖模型、代理与误差估计。 | Ancient Admixture in Human Historyf-statistics methods |
| 精细古参考与时空样本提高欧洲人口史分辨率。 | 研究地点和样本覆盖内。 | High-resolution genomic history of early medieval EuropeFigs. 1–3 |
值得检验的研究问题
- 未知取样比下哪些迁徙结论仍稳健?
- 连续迁移与单次替代何时不可区分?
- 新增墓葬背景能否改变代理来源排序?
一手来源与主张对应
- Ancient Admixture in Human HistoryNick Patterson, Priya Moorjani, Yontao Luo, Swapan Mallick, Nadin Rohland, Yiping Zhan, et al. · 2012-11-01f-statistics methods and admixture model tests
- High-resolution genomic history of early medieval EuropeLeo Speidel, Marina Silva, Thomas Booth, Ben Raffield, Kyriaki Anastasiadou, Christopher Barrington, et al. · 2025-01-01Figs. 1–3; ancestry modelling
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:跨学科科学证据深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: 500575872cce7c4b9c4062a12bb0692eb580c2da