
Resumen
Los modelos de difusión descomponen un problema complejo de generación en múltiples problemas de eliminación de ruido en condiciones ruidosas, pero la pérdida de entrenamiento, la trayectoria de muestreo y la calidad visual final no son la misma magnitud. Este artículo parte de la distribución marginal en forma cerrada del proceso directo gaussiano, analiza la relación entre la parametrización del ruido y la relación señal-ruido y, a continuación, examina cómo el muestreo de pocos pasos, el guiado condicional y la compresión en el espacio latente introducen aproximaciones distintas. Los gráficos analíticos explicitan el programa de ruido, el número de pasos y el método de cálculo para ilustrar los mecanismos; en este artículo no se ha entrenado ninguna red de difusión ni se afirma haber obtenido nuevos resultados de calidad de generación de imágenes.[1] Denoising Diffusion Probabilistic Models[2] Score-Based Generative Modeling through Stochastic Diff[3] High-Resolution Image Synthesis with Latent Diffusion M
Traducción del resumen original en inglés
Los modelos de difusión se examinan como procesos aprendidos de eliminación de ruido con un programa de ruido elegido explícitamente. Distinguimos los objetivos de entrenamiento, la discretización, el guiado y la compresión latente. Las curvas analíticas de relación señal-ruido utilizan un programa declarado y no contienen resultados de evaluaciones comparativas de imágenes generadas. La evaluación propuesta controla el decodificador, el presupuesto de muestreo y el condicionamiento antes de atribuir las diferencias a un muestreador.
1. El proceso directo define primero el problema de aprendizaje
En la difusión discreta clásica, el proceso directo añade progresivamente ruido gaussiano según varianzas preestablecidas. Las transformaciones gaussianas de múltiples pasos pueden combinarse en una distribución en forma cerrada condicionada a la imagen original, por lo que durante el entrenamiento no es necesario ejecutar realmente todos los pasos de perturbación de manera consecutiva. El programa de ruido define cuánta información original puede conservarse en distintos instantes y determina la dificultad que encontrará el muestreo durante el entrenamiento. Un mismo índice temporal no implica un mismo nivel de ruido entre programas diferentes; al comparar modelos, debe conservarse el coeficiente acumulado de señal o el logaritmo de la relación señal-ruido, en lugar de indicar únicamente el número de paso. El programa directo se especifica manualmente; el proceso inverso es el que se aprende de los datos.[1] Denoising Diffusion Probabilistic Models
2. La predicción de ruido y el error de imagen tienen ponderaciones diferentes
Si la red predice el ruido, puede recuperarse una estimación de la imagen original a partir de la entrada ruidosa y del ruido predicho. La sustitución en la distribución en forma cerrada muestra que el error de estimación de la imagen original equivale al error de predicción del ruido multiplicado por un coeficiente dependiente del tiempo. Por tanto, un promedio simple del error cuadrático medio del ruido no equivale al error cuadrático medio de la imagen original con ponderaciones iguales en todos los instantes. El objetivo de entrenamiento también puede derivarse de una forma ponderada de una cota variacional. Al leer artículos, conviene distinguir el objetivo derivado, la pérdida simplificada utilizada efectivamente y la distribución de muestreo de los instantes; informar únicamente de una disminución de una pérdida de entrenamiento no demuestra una mejora general de los detalles visuales ni de la fidelidad al condicionamiento.[1] Denoising Diffusion Probabilistic Models
3. El eliminador de ruido aprendido no determina de forma única la trayectoria de muestreo
DDIM muestra que, en una construcción compatible con las distribuciones marginales del entrenamiento, pueden utilizarse trayectorias de muestreo distintas de la cadena inversa de Markov original y obtenerse actualizaciones deterministas bajo ciertas configuraciones. Reducir el número de pasos modifica la aproximación discreta, y el error depende no solo de la red, sino también de la disposición de los instantes, la regla de actualización y la aleatoriedad. Fijar la semilla aleatoria solo restringe las entradas aleatorias dentro de una misma implementación; no convierte automáticamente distintos muestreadores en experimentos equivalentes. Una comparación justa debe mantener fijos el condicionamiento, la red, el decodificador y el presupuesto, e informar del número real de evaluaciones de la red y del tiempo total empleado, en lugar de indicar únicamente un número nominal de pasos.[2] Score-Based Generative Modeling through Stochastic Diff[1] Denoising Diffusion Probabilistic Models
4. El guiado y la compresión requieren explicaciones independientes
El guiado condicional suele modificar la dirección de generación combinando predicciones bajo condiciones diferentes; un guiado más intenso puede mejorar la correspondencia con las condiciones y, al mismo tiempo, modificar la diversidad o provocar problemas como la saturación. La difusión latente utiliza primero un codificador para transformar las imágenes en representaciones de menor dimensionalidad y después aprende la difusión en el espacio latente; su ahorro computacional procede de cambios conjuntos en la representación y en la red. La compresión puede perder texto pequeño, geometría fina o estructuras infrecuentes. Si el decodificador ya es incapaz de reconstruir fielmente una clase de entradas, no pueden atribuirse todos los defectos de salida al muestreo de eliminación de ruido, ni compararse la calidad en el espacio de imágenes basándose únicamente en la pérdida en el espacio latente.[3] High-Resolution Image Synthesis with Latent Diffusion M
5. Las métricas de calidad deben corresponder a las cuestiones de uso
Las métricas de distancia entre distribuciones, la similitud por muestra, la correspondencia con el texto y las preferencias humanas abordan cuestiones diferentes. Deben fijarse el preprocesamiento y el codificador de evaluación, explicitarse el tamaño de la muestra y las repeticiones aleatorias, y enunciarse las reglas de filtrado y selección manual de imágenes antes de presentar los resultados. Mostrar solo unas pocas imágenes seleccionadas oculta los casos de fallo de la distribución generativa. Para tareas de texto, conteo o relaciones espaciales, deben establecerse pruebas específicas y verificables; también deben examinarse los vecinos más próximos en los datos de entrenamiento y su procedencia para distinguir la capacidad generativa de la reproducción por memorización. Las curvas de relación señal-ruido de este artículo analizan un programa y no pueden sustituir ninguna de estas evaluaciones de calidad de imagen.[1] Denoising Diffusion Probabilistic Models[3] High-Resolution Image Synthesis with Latent Diffusion M
6. Límites entre las conclusiones mecanísticas y las empíricas
Las ecuaciones del proceso directo permiten calcular exactamente la relación señal-ruido de un programa y demostrar la relación algebraica entre el error del ruido y el de la imagen original; de estos resultados no puede deducirse que un muestreador determinado sea necesariamente mejor con imágenes reales. El error de aproximación de la red varía con los datos, la parametrización y los recursos de entrenamiento, y el decodificador introduce errores adicionales. Una investigación completa debe verificar primero la implementación mediante las ecuaciones y después contrastar las hipótesis empíricas con un modelo fijo y muestras independientes. La verificación de las ecuaciones, la de la estabilidad numérica y la de la calidad de generación deben registrarse por separado para evitar que el éxito de una forma de verificación se utilice como conclusión de otra naturaleza.[1] Denoising Diffusion Probabilistic Models[2] Score-Based Generative Modeling through Stochastic Diff[3] High-Resolution Image Synthesis with Latent Diffusion M
Ecuaciones fundamentales y derivaciones
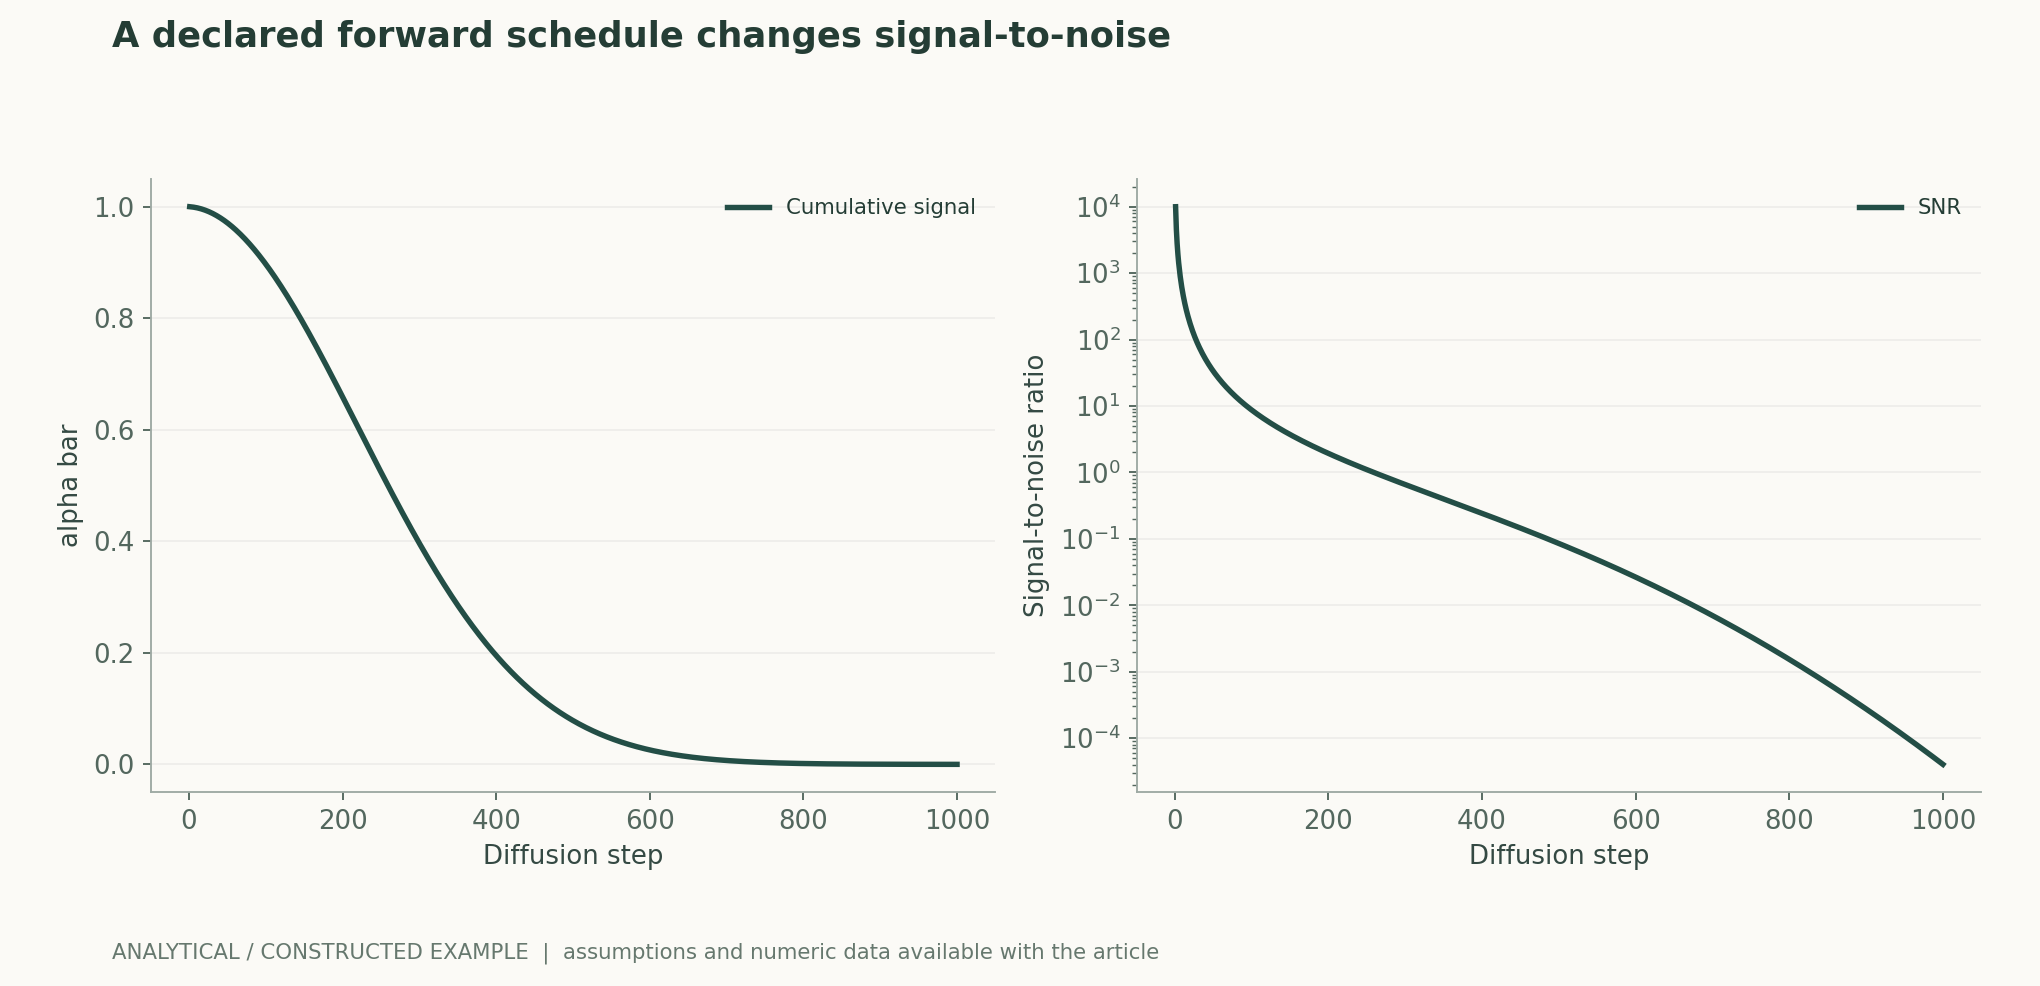
(1) Distribución marginal en forma cerrada de la perturbación gaussiana lineal; el gráfico utiliza 1000 pasos, con β aumentando linealmente de 0.0001 a 0.02. Se trata de un programa elegido, no de una conclusión de optimalidad.
LaTeX
q(x_t\mid x_0)=\mathcal N(\sqrt{\bar\alpha_t}x_0,(1-\bar\alpha_t)I),\quad\bar\alpha_t=\prod_{s=1}^{t}(1-\beta_s)(2) Se cumple para la misma muestra ruidosa y el mismo ruido verdadero, y revela las ponderaciones de pérdida dependientes del tiempo; el MSE del ruido no puede tratarse directamente como un error de imagen original con igual ponderación entre instantes.
LaTeX
\hat x_0=\frac{x_t-\sqrt{1-\bar\alpha_t}\,\epsilon_\theta(x_t,t)}{\sqrt{\bar\alpha_t}},\quad\|\hat x_0-x_0\|^2=\frac{1-\bar\alpha_t}{\bar\alpha_t}\|\epsilon_\theta-\epsilon\|^2(3) Aquí se supone una varianza unitaria de la señal original; representa la proporción teórica del proceso directo, no la calidad de reconstrucción de imágenes ni la preferencia humana.
LaTeX
\operatorname{SNR}_t=\bar\alpha_t/(1-\bar\alpha_t)Flujo metodológico y de evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto cuyo cálculo puede reproducirse
Con el programa declarado, en el paso 500 el coeficiente acumulado de señal es 0.07859 y la SNR es aproximadamente 0.08529. Estos valores dependen exclusivamente de β y no incorporan el error de eliminación de ruido, el decodificador ni la calidad de imagen.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Programa de ruido | Conservar β o el logaritmo de la SNR y la distribución de muestreo temporal | Un mismo número de pasos no garantiza la misma dificultad debida al ruido |
| Muestreo de pocos pasos | Fijar la red, el condicionamiento y el número de evaluaciones | Los cambios de velocidad no pueden explicarse solo mediante el número nominal de pasos |
| Generación en el espacio latente | Medir por separado el error de reconstrucción del codificador/decodificador | La pérdida por compresión y el error de difusión pueden mezclarse |
| Evaluación de calidad | Presentar por separado la distribución, la diversidad y la fidelidad al condicionamiento | Los ejemplos seleccionados no representan la distribución generativa |
Plan de verificación y experimentación
- Fijar las versiones del modelo, el codificador, el decodificador, el condicionamiento y el preprocesamiento, y guardar el hash de cada elemento.
- Publicar β, α acumulado, los instantes de muestreo y la parametrización de la red; verificar primero las distribuciones marginales.
- Comparar los muestreadores con el mismo conjunto de condiciones y entradas aleatorias fijadas previamente, sin permitir la selección posterior a los resultados.
- Registrar el número real de evaluaciones de la red, el dispositivo, el tamaño del lote, la precisión numérica y el tiempo de ejecución de principio a fin.
- Evaluar por separado la reconstrucción, el cumplimiento de las condiciones, la diversidad, la tasa de fallos y los vecinos más próximos del entrenamiento, y conservar los índices de todas las muestras.
- Repetir con semillas independientes e informar de la incertidumbre, dejando explícito que los gráficos analíticos de este artículo no permiten establecer clasificaciones de calidad.
Ámbito de aplicación y limitaciones
- No se entrenaron redes ni se midió empíricamente la calidad de generación.
- El programa ilustrado es solo una elección declarada.
- La SNR analítica no predice la fidelidad semántica.
- Los errores de compresión, guiado y muestreo deben examinarse por separado.
Fuentes primarias y afirmaciones correspondientes
- Denoising Diffusion Probabilistic Models, , · 2020-06-19Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Score-Based Generative Modeling through Stochastic Differential Equations, , , , , · 2020-11-26Abstract; 原文方法、理论和实验章节见作者原始论文链接
- High-Resolution Image Synthesis with Latent Diffusion Models, , , , · 2021-12-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas basándose en las fuentes primarias enumeradas. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag no cambia. El texto, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual está separada de los diagramas científicos; las figuras científicas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Historial de autoría, versiones y correcciones · /guides/diffusion-foundations/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770