
要旨
拡散モデルは複雑な生成問題を、ノイズを含む条件下での複数のノイズ除去問題に分解する。しかし、学習損失、サンプリング経路、最終的な視覚品質は同じ量ではない。本稿では、ガウス順方向過程の閉形式の周辺分布を出発点として、ノイズによるパラメータ化と信号対雑音比の関係を分析し、続いて少ステップサンプリング、条件付きガイダンス、潜在空間圧縮がそれぞれ異なる近似をどのように導入するかを論じる。解析図はノイズスケジュール、ステップ数、計算方法を明示し、機構の説明に用いる。本稿では拡散ネットワークを学習しておらず、画像生成品質について新たな結果を得たとも主張しない。[1] Denoising Diffusion Probabilistic Models[2] Score-Based Generative Modeling through Stochastic Diff[3] High-Resolution Image Synthesis with Latent Diffusion M
原文の英語要旨の日本語訳
拡散モデルを、明示的に選択されたノイズスケジュールを持つ、学習されたノイズ除去過程として検討する。学習目的、離散化、ガイダンス、潜在空間圧縮を区別する。信号対雑音比の解析曲線は明示されたスケジュールを用いており、生成画像のベンチマーク結果を含まない。提案する評価では、差異をサンプラーに帰属させる前に、デコーダ、サンプリング予算、条件付けを統制する。
1. 順方向過程がまず学習問題を規定する
古典的な離散拡散では、順方向過程は事前に設定した分散に従ってガウスノイズを段階的に加える。複数ステップのガウス変換は、元画像を条件とする閉形式の分布にまとめられるため、学習時にすべての摂動ステップを実際に連続実行する必要はない。ここでノイズスケジュールは、各時点で元の情報をどれだけ保持できるかを定め、学習時のサンプリングが直面する難しさも決定する。同じ時間インデックスであっても、異なるスケジュールでノイズ水準が同じとは限らない。モデル比較では、単に「何ステップ目」と記すだけでなく、累積信号係数または対数信号対雑音比を保存すべきである。順方向スケジュールは人為的に設定され、データから学習されるのは逆方向過程である。[1] Denoising Diffusion Probabilistic Models
2. ノイズ予測と画像誤差では重みが異なる
ネットワークがノイズを予測する場合、ノイズを含む入力と予測ノイズから元画像の推定値を逆算できる。閉形式の分布に代入すると、元画像の推定誤差は、ノイズ予測誤差に時間依存の係数を掛けたものに等しいことが分かる。したがって、ノイズの平均二乗誤差を単純に平均したものは、すべての時点に等しい重みを与えた元画像の平均二乗誤差とは等価ではない。学習目的は、変分的な界の重み付き形式に由来する場合もある。論文を読む際には、導出された目的、実際に用いられた簡略化損失、時点のサンプリング分布を区別すべきである。ある学習損失の低下を報告するだけでは、視覚的細部や条件への忠実度が全面的に改善したことを証明できない。[1] Denoising Diffusion Probabilistic Models
3. 学習済みノイズ除去器はサンプリング軌道を一意に決定しない
DDIMは、学習時の周辺分布と整合する構成において、元のマルコフ逆方向連鎖とは異なるサンプリング経路を採用でき、特定の設定では決定論的な更新が得られることを示す。ステップ数の削減は離散近似を変化させ、誤差はネットワークだけでなく、時点の配置、更新規則、確率性にも依存する。乱数シードの固定で制約できるのは同一実装内のランダム入力だけであり、異なるサンプラーが自動的に同等の実験になるわけではない。公平な比較では、条件、ネットワーク、デコーダ、予算を固定し、名目上のステップ数だけでなく、実際のネットワーク評価回数と総所要時間を報告すべきである。[2] Score-Based Generative Modeling through Stochastic Diff[1] Denoising Diffusion Probabilistic Models
4. ガイダンスと圧縮にはそれぞれ独立した説明が必要である
条件付きガイダンスは、異なる条件下の予測を組み合わせることで生成の方向を変えることが多い。強いガイダンスは条件との一致を高める可能性がある一方で、多様性を変化させたり、飽和などの問題を生じさせたりする可能性がある。潜在拡散では、まずエンコーダによって画像を低次元表現に写像し、その後、潜在空間で拡散を学習する。その計算量の削減は、表現とネットワークの両方の変化に由来する。圧縮によって、小さな文字、精細な幾何形状、まれな構造が失われる可能性がある。デコーダがすでにある種類の入力を忠実に再構成できないのであれば、出力の欠陥をすべてノイズ除去サンプリングに帰属させることはできず、潜在空間の損失だけで画像空間の品質を比較することもできない。[3] High-Resolution Image Synthesis with Latent Diffusion M
5. 品質指標は利用上の問いに対応する必要がある
分布間距離の指標、サンプルごとの類似度、テキストとの一致、人間の選好は、それぞれ異なる問いを扱う。前処理と評価用エンコーダを固定し、サンプル数とランダムな反復を公開するとともに、フィルタリングおよび人手による画像選別の規則を結果に先立って記載すべきである。少数の厳選画像のみを提示すると、生成分布に含まれる失敗例が隠される。文字、計数、空間関係を扱うタスクには、検証可能な専用テストを設定すべきである。また、生成能力と記憶に基づく再現を区別するため、学習データの最近傍と出所も調べる必要がある。本稿の信号対雑音比曲線はスケジュールの分析であり、これらの画像品質評価のいずれにも代わるものではない。[1] Denoising Diffusion Probabilistic Models[3] High-Resolution Image Synthesis with Latent Diffusion M
6. 機構に関する結論と経験的結論の境界
順方向の数式から、あるスケジュールの信号対雑音比を正確に計算し、ノイズ誤差と元画像誤差の代数的関係を証明できる。しかし、これらの結果から、あるサンプラーが実世界の画像で必ず優れるとは導けない。ネットワークの近似誤差はデータ、パラメータ化、学習資源に応じて変化し、デコーダも追加の誤差を導入する。十分な研究では、まず数式に照らして実装を確認し、その後、固定したモデルと独立したサンプルで経験的仮説を検証すべきである。数式の検証、数値安定性の検証、生成品質の検証はそれぞれ別に記録し、ある種類の検証の成功を別の種類の結論に流用することを避ける必要がある。[1] Denoising Diffusion Probabilistic Models[2] Score-Based Generative Modeling through Stochastic Diff[3] High-Resolution Image Synthesis with Latent Diffusion M
主要な数式と導出
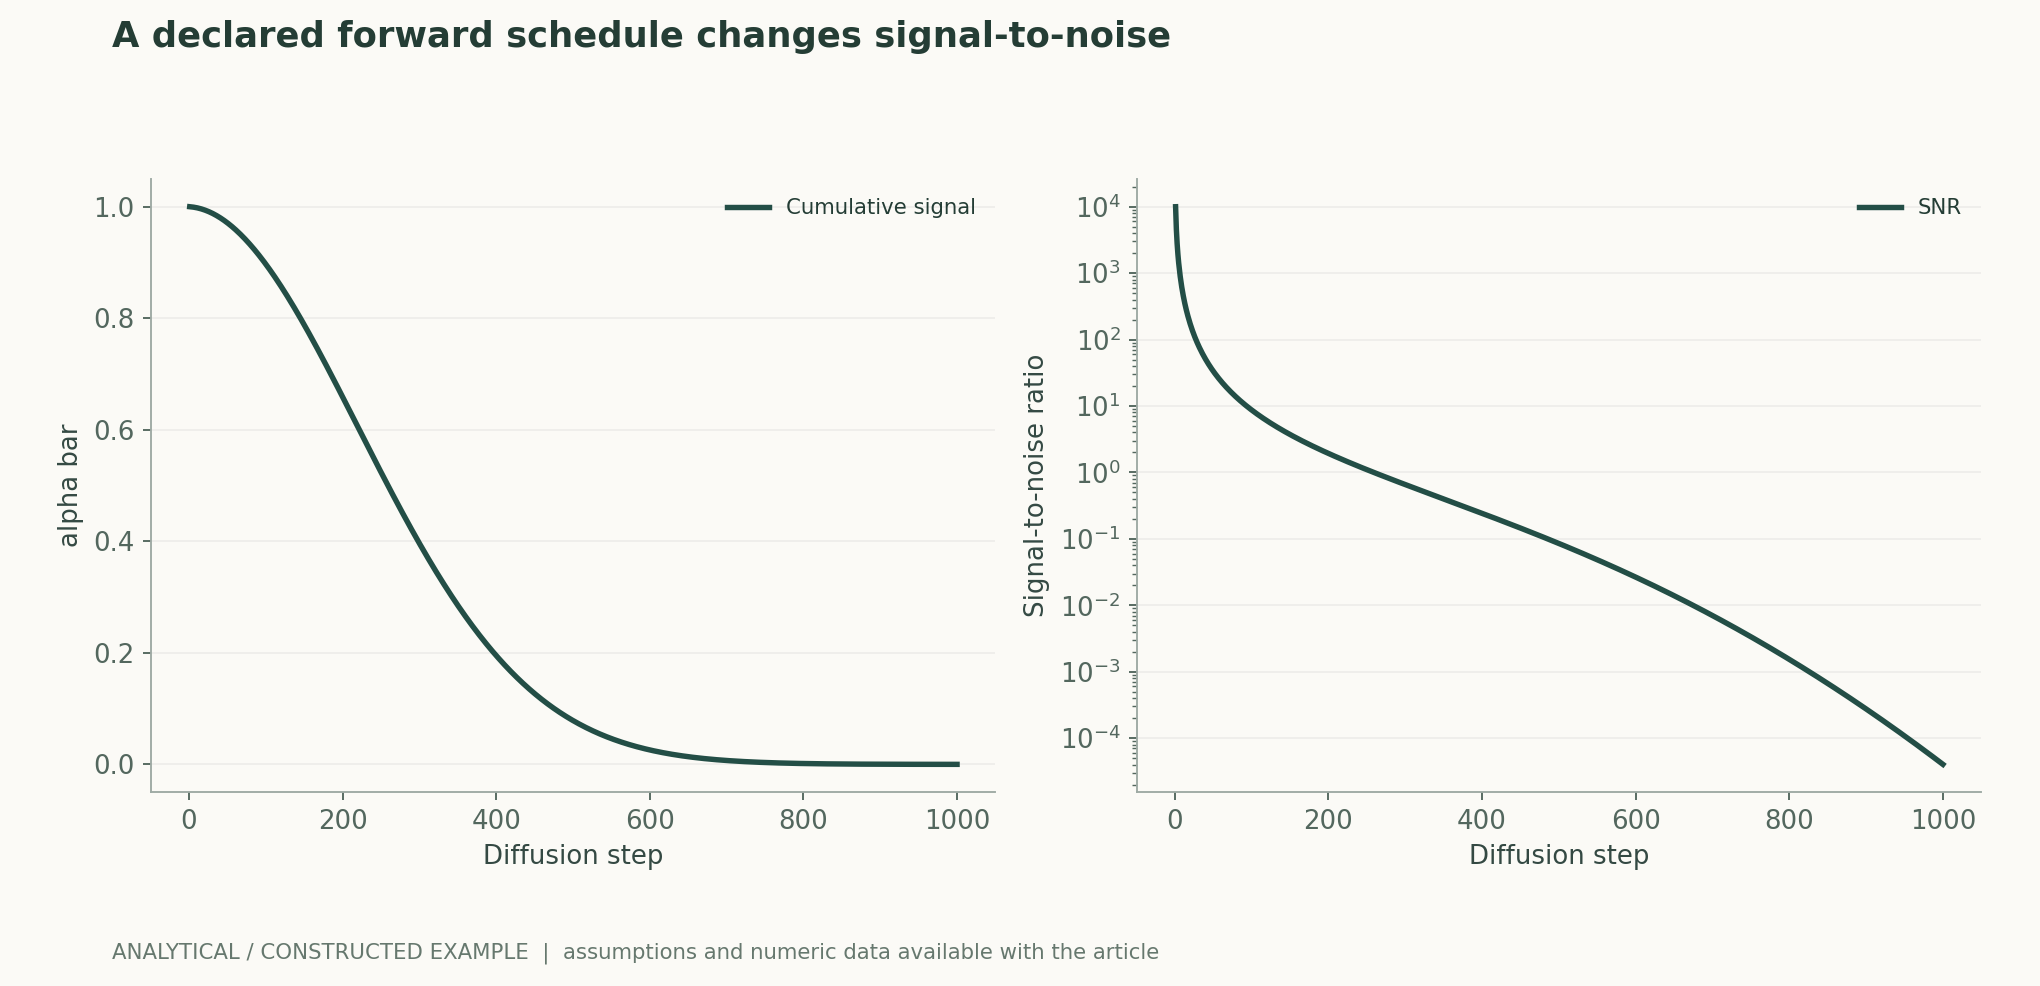
(1) 線形ガウス摂動の閉形式の周辺分布。図では1000ステップを用い、βを0.0001から0.02まで線形に増加させる。これは選択されたスケジュールであり、最適性に関する結論ではない。
LaTeX
q(x_t\mid x_0)=\mathcal N(\sqrt{\bar\alpha_t}x_0,(1-\bar\alpha_t)I),\quad\bar\alpha_t=\prod_{s=1}^{t}(1-\beta_s)(2) 同一のノイズ付きサンプルと真のノイズのもとで成立し、時間依存の損失重みを明らかにする。時点をまたいで、ノイズのMSEを等重みの元画像誤差と直接みなすことはできない。
LaTeX
\hat x_0=\frac{x_t-\sqrt{1-\bar\alpha_t}\,\epsilon_\theta(x_t,t)}{\sqrt{\bar\alpha_t}},\quad\|\hat x_0-x_0\|^2=\frac{1-\bar\alpha_t}{\bar\alpha_t}\|\epsilon_\theta-\epsilon\|^2(3) ここでは元信号の分散を単位分散と仮定する。これは順方向過程の理論的な比率を表し、画像再構成品質や人間の選好を表すものではない。
LaTeX
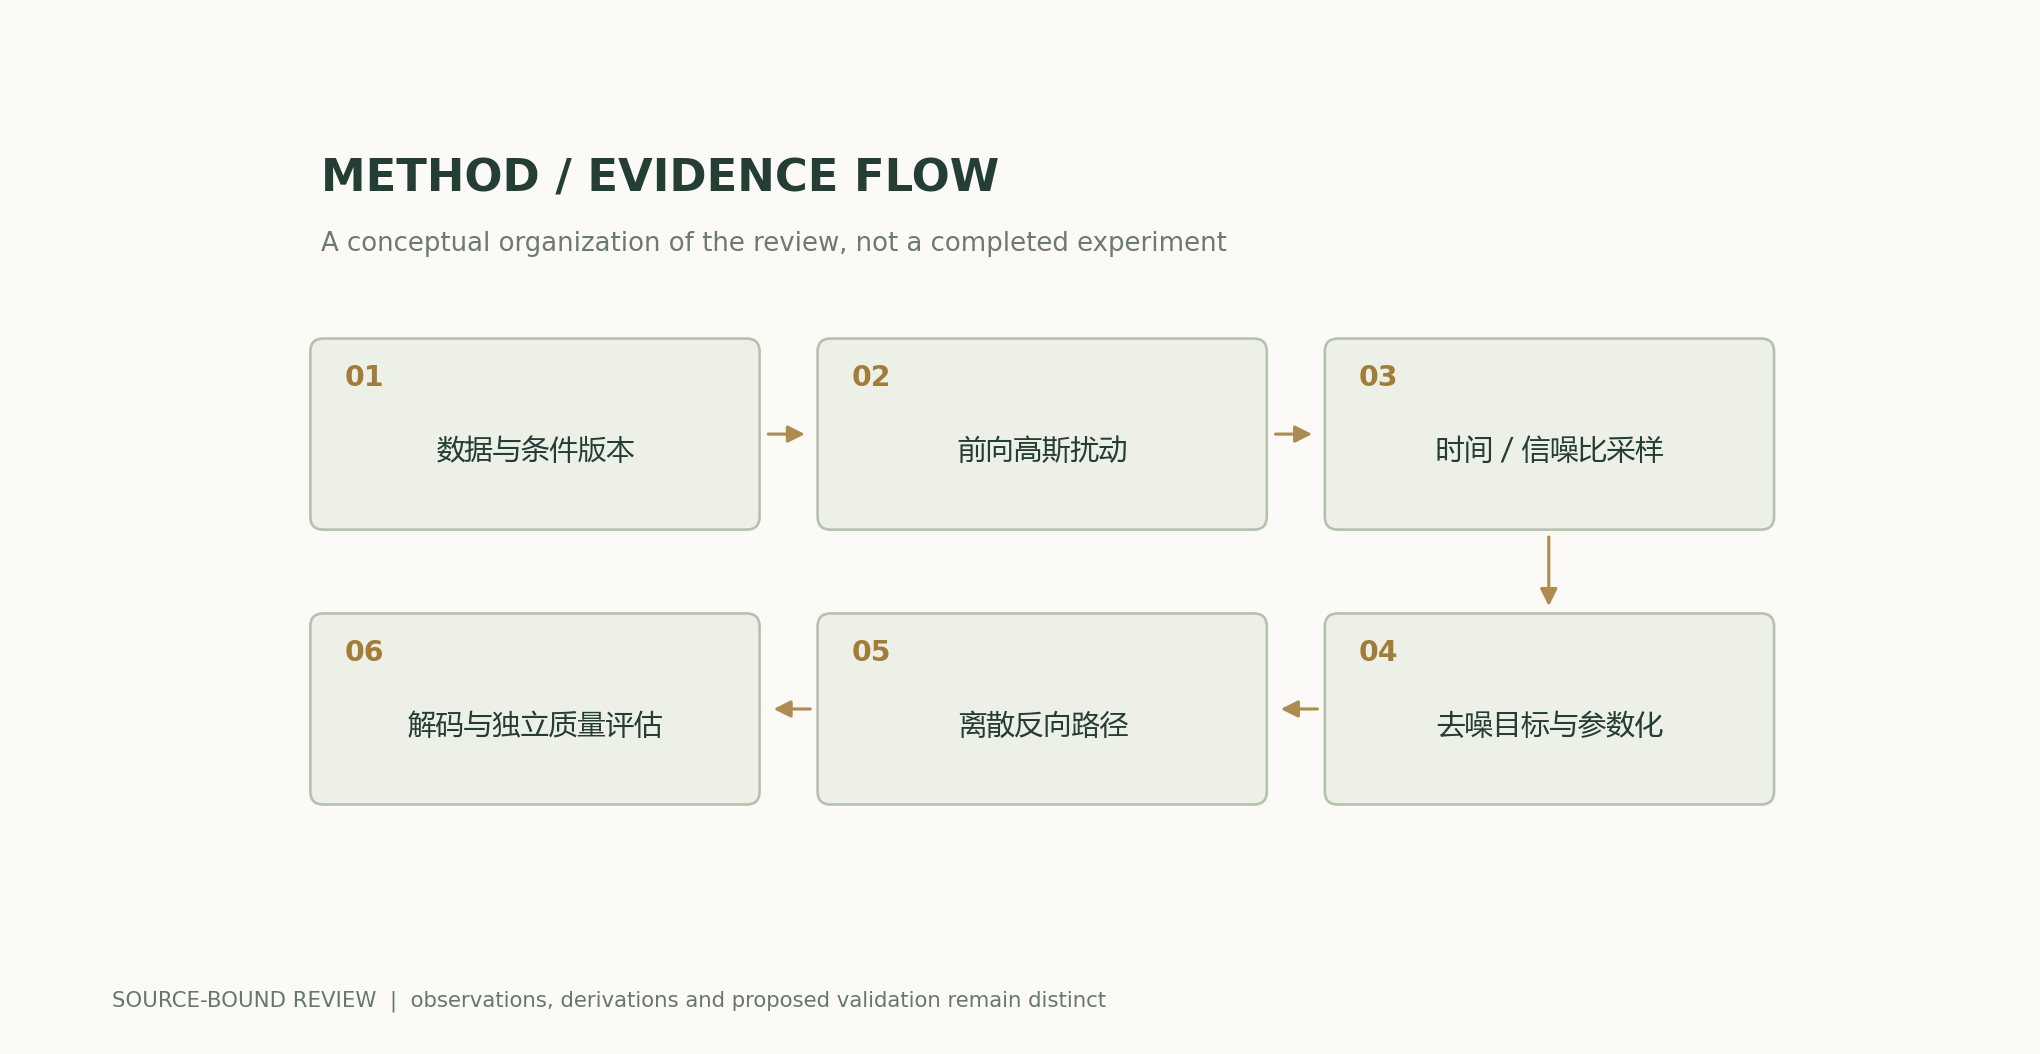
\operatorname{SNR}_t=\bar\alpha_t/(1-\bar\alpha_t)方法と証拠の流れ
解析図と数値例
再計算可能な例題
明示されたスケジュールでは、第500ステップの累積信号係数は0.07859、SNRは約0.08529である。これらの値はβのみで決まり、ノイズ除去誤差、デコーダ、画像品質は含まれない。
手法の比較
| 手法または判断 | 統制変数と測定 | 成立しない条件と解釈 |
|---|---|---|
| ノイズスケジュール | βまたは対数SNRと時間サンプリング分布を保存する | 同じステップ数でも、ノイズに起因する難しさが同じとは限らない |
| 少ステップサンプリング | ネットワーク、条件、評価回数を固定する | 速度の変化は名目上のステップ数だけでは説明できない |
| 潜在空間での生成 | エンコーダ/デコーダの再構成誤差を個別に測定する | 圧縮による損失と拡散誤差が混在しうる |
| 品質評価 | 分布、多様性、条件への忠実度を分けて提示する | 厳選された事例は生成分布を代表しない |
検証と実験の計画
- モデル、エンコーダ、デコーダ、条件、前処理のバージョンを固定し、それぞれのハッシュを保存する。
- β、累積α、サンプリング時点、ネットワークのパラメータ化を公開し、まず周辺分布を確認する。
- 事前に固定した同一の条件群とランダム入力を用いてサンプラーを比較し、結果を見た後の選別を禁止する。
- 実際のネットワーク評価回数、デバイス、バッチサイズ、数値精度、エンドツーエンドの所要時間を記録する。
- 再構成、条件への追従、多様性、失敗率、学習データの最近傍を分けて評価し、全サンプルのインデックスを保存する。
- 独立したシードで反復して不確実性を報告し、本稿の解析図は品質の順位付けを裏付けられないことを明示する。
適用範囲と限界
- ネットワークの学習や生成品質の実測は行っていない。
- 図示したスケジュールは、明示された選択の一例にすぎない。
- 解析的SNRは意味的忠実度を予測しない。
- 圧縮、ガイダンス、サンプリングの誤差はそれぞれ検証する必要がある。
一次資料と主張の対応
- Denoising Diffusion Probabilistic Models, , · 2020-06-19Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Score-Based Generative Modeling through Stochastic Differential Equations, , , , , · 2020-11-26Abstract; 原文方法、理论和实验章节见作者原始论文链接
- High-Resolution Image Synthesis with Latent Diffusion Models, , , , · 2021-12-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、記載された一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿に関する独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前バージョンの内容を維持している。
概念的な表紙と科学的な図解は区別されている。科学図は公開された数式と明示的な仮定から計算され、原論文の結果にはすべて出典が明記されている。
著者・バージョン・訂正履歴 · /guides/diffusion-foundations/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開・バージョン履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770