
摘要
扩散模型将复杂的生成问题拆成多个带噪条件下的去噪问题,但训练损失、采样路径与最终视觉质量并不是同一个量。本文从高斯前向过程的闭式边缘分布出发,分析噪声参数化和信噪比之间的关系,再讨论少步采样、条件引导和潜空间压缩如何引入不同的近似。解析图公开噪声日程、步数与计算方法,用于说明机制;本文没有训练扩散网络,也没有声称获得新的图像生成质量结果。[1] Denoising Diffusion Probabilistic Models[2] Score-Based Generative Modeling through Stochastic Diff[3] High-Resolution Image Synthesis with Latent Diffusion M
English abstract
Diffusion models are examined as learned denoising processes with an explicitly chosen noise schedule. We separate training objectives, discretization, guidance and latent compression. Analytical signal-to-noise curves use a declared schedule and contain no generated-image benchmark results. The proposed evaluation controls the decoder, sampling budget and conditioning before attributing differences to a sampler.
1. 前向过程首先规定了学习问题
在经典离散扩散中,前向过程按预设方差逐步叠加高斯噪声。多步高斯变换可合并为给定原图的闭式分布,因此训练时不必真的连续运行所有扰动步骤。这里的噪声日程定义了不同时间点可保留多少原始信息,也决定训练采样会遇到怎样的难度。相同时间索引不代表不同日程具有相同噪声水平;比较模型时应保存累计信号系数或对数信噪比,而不只写“第几步”。前向日程是人为设定,反向过程才由数据学习。[1] Denoising Diffusion Probabilistic Models
2. 噪声预测与图像误差的权重不同
若网络预测噪声,可以用带噪输入与预测噪声反推出原图估计。代入闭式分布可见,原图估计误差等于噪声预测误差乘以一个随时间变化的系数。因此简单平均的噪声均方误差,并不等价于对所有时间点等权的原图均方误差。训练目标还可能来自变分界的加权形式。读论文时应区分推导目标、实际采用的简化损失和时间点采样分布;仅报告一个训练损失下降,不能证明视觉细节或条件忠实度全面改善。[1] Denoising Diffusion Probabilistic Models
3. 学到的去噪器不唯一决定采样轨迹
DDIM说明,在与训练边缘分布相容的构造中,可以采用不同于原始马尔可夫反向链的采样路径,并在特定设置下得到确定性更新。步数减少会改变离散近似,误差不仅取决于网络,还取决于时间点安排、更新规则与随机性。固定随机种子只能约束同一实现下的随机输入,不能让不同采样器天然成为相同实验。公平比较应固定条件、网络、解码器及预算,并报告实际网络求值次数和总耗时,而非只列一个名义步数。[2] Score-Based Generative Modeling through Stochastic Diff[1] Denoising Diffusion Probabilistic Models
4. 引导与压缩需要分别承担解释责任
条件引导常通过组合不同条件下的预测改变生成方向;较强引导可能提高条件匹配,同时改变多样性或带来饱和等问题。潜扩散则先用编码器把图像映射到较低维表示,再在潜空间学习扩散;它节省的计算来自表示和网络共同变化。压缩可能丢失小文字、精细几何或罕见结构。若解码器已经无法忠实重建某类输入,不能把输出缺陷全部归因于去噪采样,也不能仅凭潜空间损失比较图像空间质量。[3] High-Resolution Image Synthesis with Latent Diffusion M
5. 质量指标需要与使用问题相匹配
分布距离指标、逐样本相似度、文本匹配与人工偏好关注不同问题。应冻结预处理和评估编码器,公开样本量与随机重复,并把过滤和人工挑图规则写在结果之前。若只展示少量精选图,会把生成分布中的失败样例隐藏起来。对于文字、计数或空间关系任务,应设定可复核的专门测试;对训练数据近邻和来源也应检查,以区分生成能力与记忆性复现。本文的信噪比曲线是日程分析,不能代替任何这些图像质量评估。[1] Denoising Diffusion Probabilistic Models[3] High-Resolution Image Synthesis with Latent Diffusion M
6. 机制结论与经验结论的边界
由前向公式可以准确算出某个日程的信噪比,并证明噪声误差与原图误差之间的代数关系;由这些结果不能推出某个采样器在现实图像上必然更好。网络近似误差会随数据、参数化和训练资源变化,解码器也会引入额外误差。完整研究应先用公式核对实现,再在固定模型和独立样本上检验经验假设。公式验证、数值稳定性验证和生成质量验证应分别登记,避免把一种验证的成功挪用成另一种结论。[1] Denoising Diffusion Probabilistic Models[2] Score-Based Generative Modeling through Stochastic Diff[3] High-Resolution Image Synthesis with Latent Diffusion M
核心公式与推导
(1) 线性高斯扰动的闭式边缘分布;图示使用1000步、β从0.0001线性增至0.02。它是选定日程,不是最优性结论。
LaTeX
q(x_t\mid x_0)=\mathcal N(\sqrt{\bar\alpha_t}x_0,(1-\bar\alpha_t)I),\quad\bar\alpha_t=\prod_{s=1}^{t}(1-\beta_s)(2) 在同一带噪样本与真实噪声下成立,揭示了时间相关的损失权重;不能跨时间点直接把噪声MSE当作等权原图误差。
LaTeX
\hat x_0=\frac{x_t-\sqrt{1-\bar\alpha_t}\,\epsilon_\theta(x_t,t)}{\sqrt{\bar\alpha_t}},\quad\|\hat x_0-x_0\|^2=\frac{1-\bar\alpha_t}{\bar\alpha_t}\|\epsilon_\theta-\epsilon\|^2(3) 这里假设原始信号单位方差,表示前向过程的理论比例,不是图像重建质量或人类偏好。
LaTeX
\operatorname{SNR}_t=\bar\alpha_t/(1-\bar\alpha_t)方法与证据流程
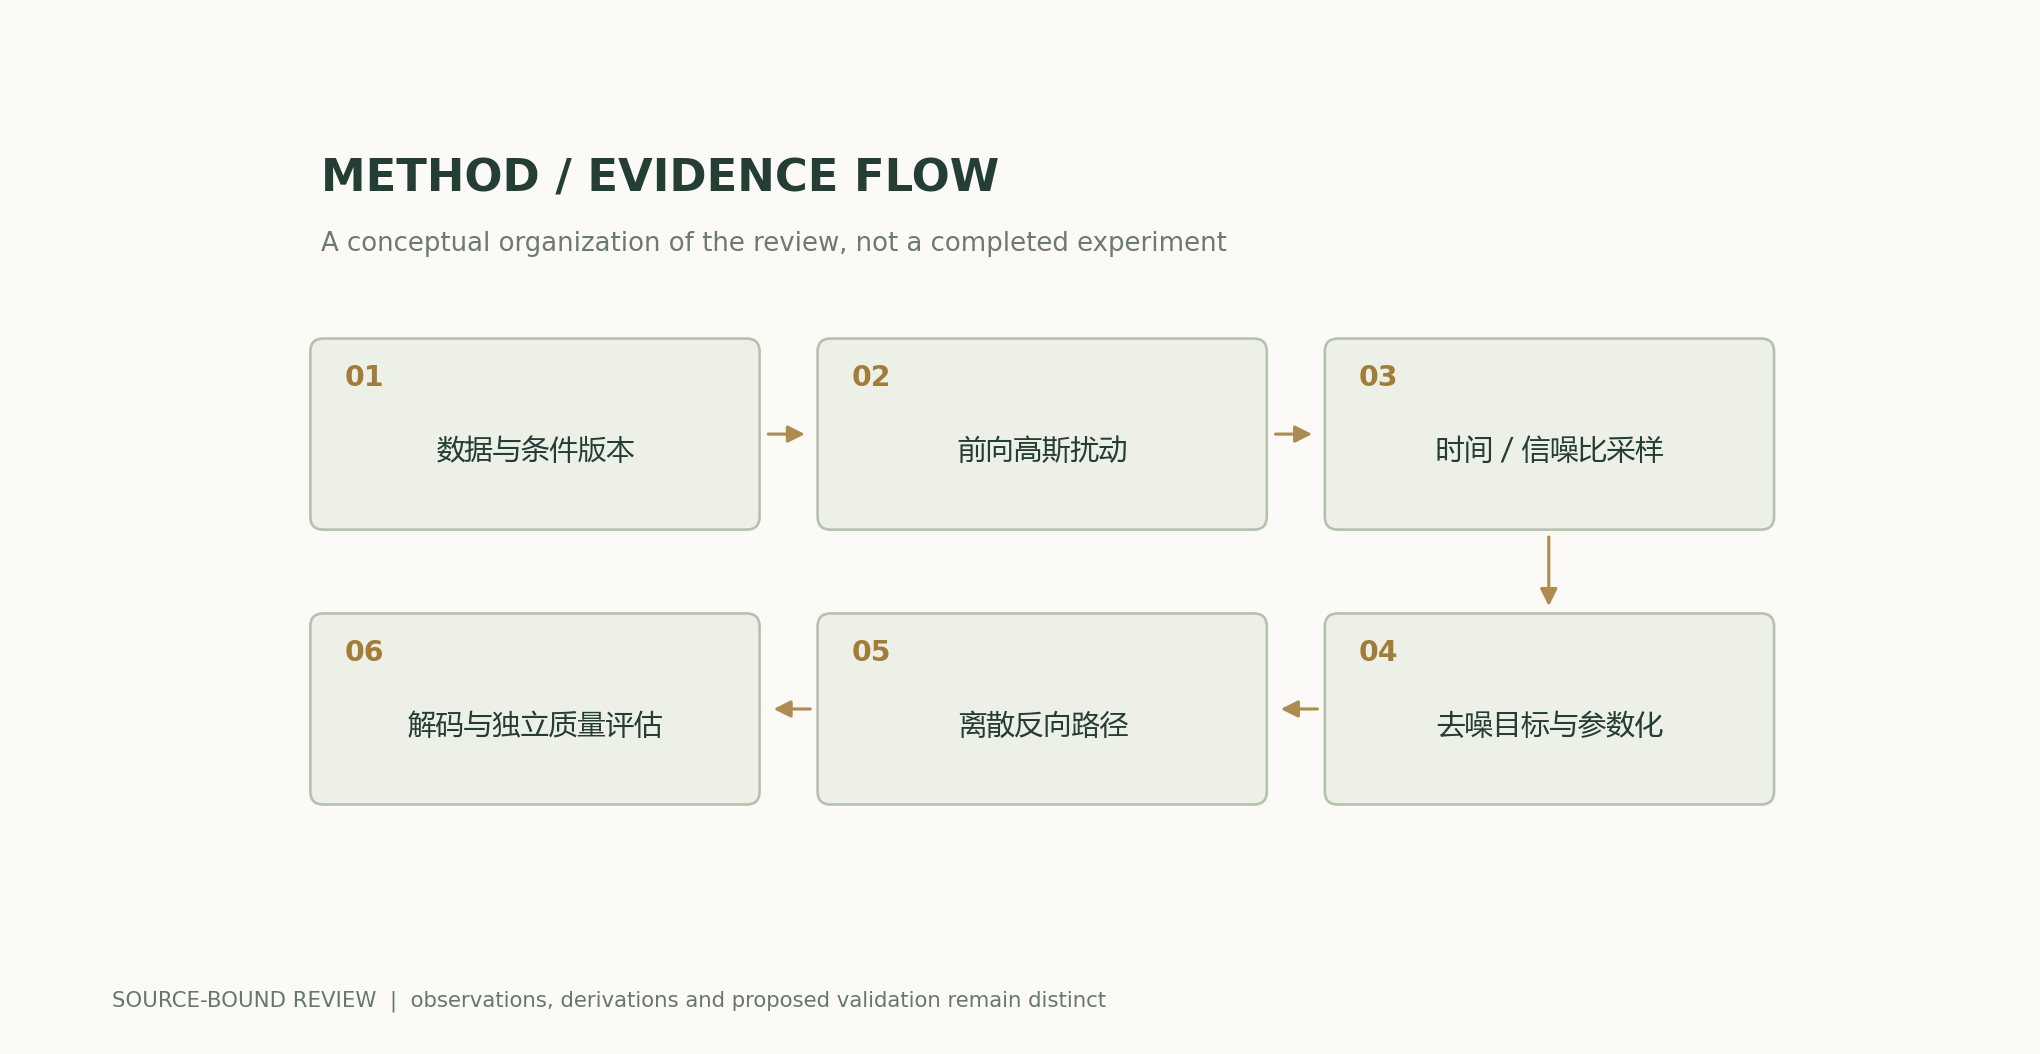
解析图与数值示例
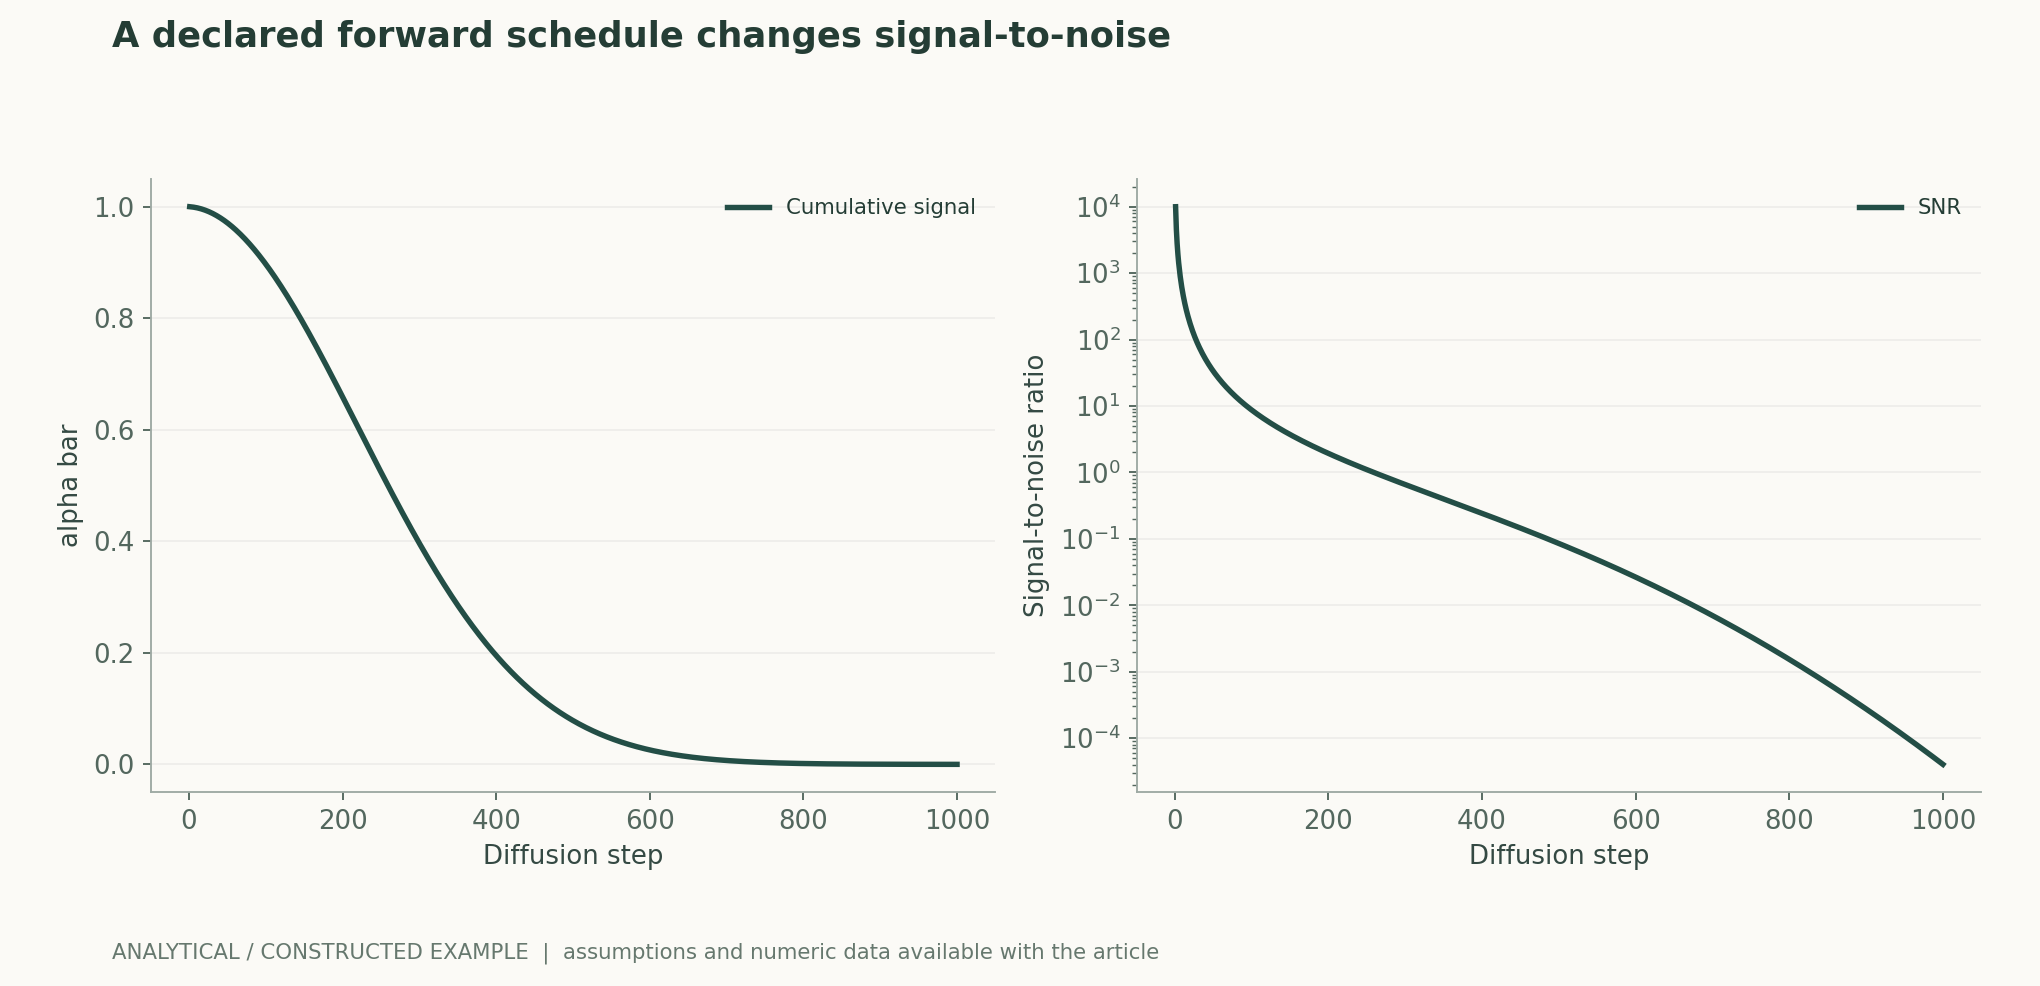
可复算例题
在声明日程下,第500步累计信号系数为0.07859、SNR约0.08529。这些数只由β决定,不包含去噪误差、解码器或图像质量。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 噪声日程 | 保存β或对数SNR与时间采样分布 | 相同步数不保证相同噪声难度 |
| 少步采样 | 固定网络、条件与求值次数 | 速度变化不能只按名义步数解释 |
| 潜空间生成 | 单测编码器/解码器重建误差 | 压缩损失与扩散误差会混合 |
| 质量评价 | 分列分布、多样性和条件忠实度 | 精选样例不代表生成分布 |
复核与实验方案
- 冻结模型、编码器、解码器、条件和预处理版本,保存每项哈希。
- 公开β、累计α、采样时间点及网络参数化,先核对边缘分布。
- 用同一批预先固定的条件和随机输入比较采样器,禁止结果后挑选。
- 记录实际网络求值次数、设备、批量、精度和端到端耗时。
- 分开评估重建、条件遵循、多样性、失败率与训练近邻,保存全部样例索引。
- 以独立种子重复并报告不确定性,明确本文解析图不能支持质量排序。
适用范围与局限
- 没有训练网络或生成质量实测。
- 图示日程只是一个声明的选择。
- 解析SNR不预测语义忠实度。
- 压缩、引导与采样误差需分别检验。
一手来源与主张对应
- Denoising Diffusion Probabilistic Models, , · 2020-06-19Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Score-Based Generative Modeling through Stochastic Differential Equations, , , , , · 2020-11-26Abstract; 原文方法、理论和实验章节见作者原始论文链接
- High-Resolution Image Synthesis with Latent Diffusion Models, , , , · 2021-12-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
阅读器性能修订:新近 HEAD 返回 200 且 ETag 相同时也复用已读页面。正文、公式、来源和科学图的数据保持上一版本内容。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/diffusion-foundations/v1/
Source revision: 6251a250b27bb8b449f59b392f81abd355383770