
الملخص
يغيّر التكييف منخفض الرتبة، من خلال تقييد صيغة تحديث الأوزان، المعلمات الحرة وحالات التحسين اللازمة للتدريب، لكنه لا يعني التخلص في الوقت نفسه من التنشيطات أو الأوزان الأساسية أو جميع تكاليف الاستدلال. تستكمل هذه المراجعة اشتقاقات رتبة التحديث وتدرجات التهيئة وتكافؤ الدمج، وتناقش التأثيرات المتبادلة بين سعة المهمة واختيار الوحدات والتكميم، وتقترح خطة لدراسات الاستئصال مع تثبيت البيانات وميزانية التدريب. تستند رسوم أعداد المعلمات إلى العد التحليلي؛ ولا تمثل عمليات التحقق بالجبر الخطي تجارب على قدرات نماذج اللغة أو أداء الأجهزة.[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs[3] FlashAttention: Fast and Memory-Efficient Exact Attenti
ترجمة الملخص الإنجليزي الأصلي
يُحلَّل التكييف منخفض الرتبة بوصفه تحديثًا مقيّدًا للأوزان. تشتق المراجعة أعداد المعلمات وحدود الرتبة والتدرجات المعتمدة على التهيئة، وتبيّن الافتراضات اللازمة لدمج مُكيِّف في طبقة خطية. ويُعالَج التكميم وذاكرة التنشيطات كلٌّ على حدة. تعرض الرسوم التحليلية حسابات المعلمات والجبر الخطي العددي، ولا تعرض دقة المهام اللاحقة أو تسريع الأجهزة.
1. ما يغيّره LoRA هو تمثيل التحديث
يجمّد LoRA الأوزان الأصلية W، ويمثّل الزيادة القابلة للتدريب بحاصل ضرب مصفوفتين منخفضتي الرتبة BA. بالنسبة إلى مصفوفة ذات أبعاد ، يحتوي التحديث الكامل على قيمة قابلة للتدريب، بينما يحتوي الجزء منخفض الرتبة على قيمة. لا يشمل هذا العدد الطبقات الأخرى أو الانحيازات أو الحالات الإضافية لإطار العمل، ولا يمكن الاستناد إليه لإثبات أن أي رتبة منخفضة تحقق جودة الضبط الدقيق الكامل.[1] LoRA: Low-Rank Adaptation of Large Language Models
2. مثال يمكن إعادة حسابه بصورة مستقلة
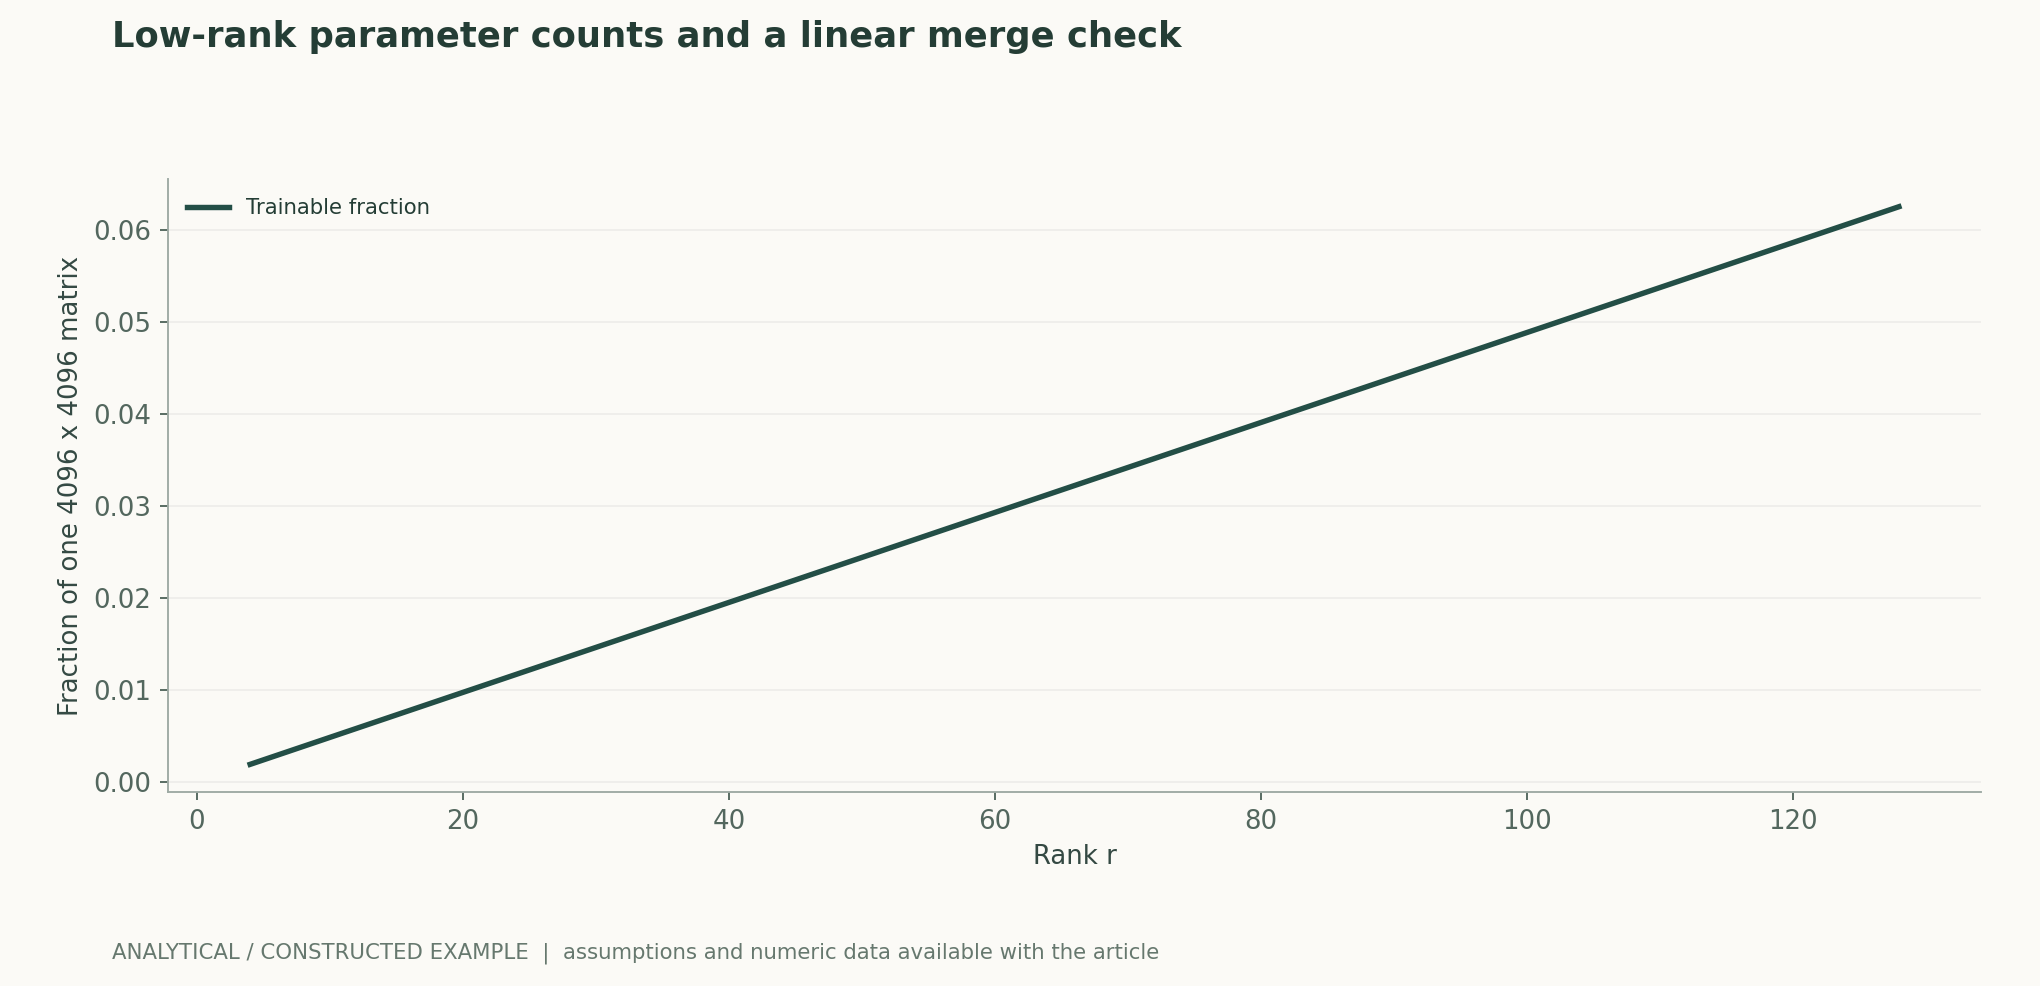
لتكن ، فتحتوي المصفوفة الأصلية على 16,777,216 قيمة. وباختيار ، تحتوي المصفوفتان منخفضتا الرتبة معًا على 65,536 قيمة قابلة للتدريب، بما يعادل من المصفوفة الكاملة ; و16، يكون العدد 32,768 و131,072، على الترتيب. يعرض الشكل 2 هذه الكميات باستخدام الصيغة نفسها. وهذا عدٌّ لمعلمات مصفوفة واحدة، ولا يجوز وصفه بأنه خفضٌ لذاكرة تدريب النموذج بأكمله بعامل 256.[1] LoRA: Low-Rank Adaptation of Large Language Models
3. التكميم يقلّص بندًا آخر من التكلفة
يحفظ QLoRA الأوزان المجمدة المدرَّبة مسبقًا بتمثيل من 4 بت، ويمرّر التدرجات إلى المُكيِّفات منخفضة الرتبة؛ وتناقش الورقة أيضًا NF4 والتكميم المزدوج والمُحسِّنات ذات الترحيل الصفحي. تعتمد وفوراته على أسلوب التمثيل والبيانات الوصفية للتكميم ودقة الحساب وإدارة المُحسِّن، ولا يصح اختزالها في أن «عملية التدريب بأكملها تستخدم 4 بت». يجب تسجيل عرض البت للأوزان المجمدة ونوع البيانات المستخدم في حساب العمليات وحالات المُكيِّف كلٌّ على حدة.[2] QLoRA: Efficient Finetuning of Quantized LLMs
4. حساب التخزين الخام للأوزان لا يساوي ذروة استهلاك ذاكرة المسرّع
بافتراض وجود 70 من مئات الملايين من الأوزان بالضبط، يبلغ التخزين الخام بدقة 16 بت مقدار 14 GB، وبدقة 4 بت مقدار 3.5 GB،بايت. لا يشمل ذلك ثوابت التكميم أو التنشيطات أو الذاكرة المخبئية أو التدرجات أو المُكيِّفات أو المُحسِّنات أو المخازن المؤقتة، ولا يمكن الاستناد إليه لضمان إمكان التدريب أو التشغيل على بطاقة رسوميات معينة. يعرض الشكل 2 في هذه النسخة نسبة المعلمات منخفضة الرتبة فقط؛ وللحساب المستقل المتعلق بعرض بت الأوزان، تُراجع مراجعة الاستدلال منخفض البت في هذه المجموعة، إذ لا يتعلق الأمر بآلية الذاكرة نفسها.作者分析与复核建议 / Author analysis
5. يحسّن FlashAttention بندًا مختلفًا
يقلّل FlashAttention عمليات القراءة والكتابة في ذاكرة المسرّع وحفظ النتائج الوسيطة في حساب الانتباه، باستخدام أساليب منها التقسيم إلى كتل مع مراعاة عمليات الإدخال والإخراج. وهو ليس بديلًا لـ LoRA: فأحدهما يغيّر الزيادة القابلة للتدريب، والآخر يغيّر تنفيذ الانتباه الدقيق. وقد يؤثر الجمع بين الطرق الثلاث في بنود مختلفة من التكلفة؛ لكن التوافق وتحقيق الجودة والسرعة المتوقعتين يظلان بحاجة إلى قياس على التنفيذ والمدخلات المحددين.[3] FlashAttention: Fast and Memory-Efficient Exact Attenti[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs
6. لا تكفي خسارة التدريب وحدها لمقارنة الجودة
قد تؤثر الرتبة المنخفضة والتكميم واختيار البيانات في أداء المهمة بطرق مختلفة. توصي هذه المراجعة بتثبيت نقطة التحقق الأساسية ومواد التدريب، ومقارنة الضبط الدقيق الكامل بالخطط ذات الرتب ومستويات الدقة المختلفة، وتسجيل مقاييس المهمة وتوزيعات المخرجات وأنواع الإخفاق. وإذا دُرّب المُكيِّف على فئة معينة من الموجّهات فقط، فينبغي الاحتفاظ باختبارات خارج المجال. ولا يبرر انخفاض خسارة التدريب استنتاج أن الصحة الواقعية أو القدرات العامة لم تتدهور.作者分析与复核建议 / Author analysis
7. الدمج والتبديل والنشر تحتاج أيضًا إلى التحقق
يمكن دمج زيادة LoRA في الأوزان في التنفيذ المناسب، لكن الدمج في الأوزان المكمّمة وإعادة التكميم والتبديل بين عدة مُكيِّفات لكل منها تفاصيله التنفيذية. ينبغي حفظ إصدارات النموذج الأساسي والمُكيِّف وإعدادات التكميم وعملية الدمج، والتحقق من مطابقة مخرجات النشر لمخرجات النسخة التي خضعت للتقييم. ويجب أن تستند الاستنتاجات المتعلقة بزمن الاستجابة إلى قياس مسار النشر الفعلي، لا إلى الاستدلال من عدد المعلمات وحده.[1] LoRA: Low-Rank Adaptation of Large Language Models
ثمة فرق أيضًا بين التحديثات المتناثرة والحجم الفعلي للملفات
يمكن إحصاء القيم القابلة للتدريب في المُكيِّف بدقة، لكن الملف المحفوظ يتضمن أيضًا أسماء الموترات والبيانات الوصفية ومعلومات الدقة. ولا تجوز المقارنة المباشرة بين عدد البايتات الناتج عن ضغط ملف مُكيِّف ونقطة تحقق كاملة أخرى غير مضغوطة، ثم الادعاء بأن ذلك يمثل عامل التوفير نفسه في المعلمات. وبالمثل، تشمل ذروة استهلاك ذاكرة المسرّع أنواعًا متعددة من الكائنات الموجودة في الوقت نفسه؛ وحتى إن صغر حجم الأوزان المجمدة، فقد تصبح التنشيطات البند الرئيسي الجديد.作者分析与复核建议 / Author analysis
8. رتبة التحديث قيد بنيوي وليست ضمانًا للدقة
لتكن أبعاد المصفوفة الأساسية W هي m×n، وليُكتب التحديث على الصورة BA، حيث أبعاد B هي m×r وأبعاد A هي r×n؛ عندئذ لا تتجاوز رتبة التحديث r، ويكون عدد المعلمات القابلة للتدريب r(m+n). ويمكن حساب التوفير مقارنة بمعلمات المصفوفة الكاملة mn مباشرةً؛ لكن اختيار الطبقات والإسقاطات التي يُوزَّع عليها التحديث يغيّر أيضًا القدرة التعبيرية عند تثبيت ميزانية المعلمات. وإذا تعذّر تمثيل التغييرات اللازمة لمهمة معينة بصورة كافية في الفضاء الجزئي المختار، فقد لا تعالج زيادة خطوات التدريب المشكلة. ينبغي فصل استكشاف الرتب عن اختيار الطبقات، وعدم تفسير انخفاض نسبة المعلمات مباشرةً على أنه انخفاض مماثل في كلفة التدريب أو تكييف بلا فقد.[1] LoRA: Low-Rank Adaptation of Large Language Models
9. تحدد التهيئة المعلمات التي تتلقى تدرجًا في الخطوة الأولى
لجعل النموذج الابتدائي مساويًا للنموذج الأساسي، تهيّئ التطبيقات الشائعة أحد العاملين منخفضي الرتبة بالصفر والآخر بقيم غير صفرية. إذا كان B=0، فإن التدرج بالنسبة إلى A يكون صفرًا في الخطوة الأولى، بينما قد يظل التدرج بالنسبة إلى B غير صفري؛ وبعد ذلك قد يتغير كلاهما. ومن ثم فإن «قابلية العاملين كليهما للتدريب» لا تعني تلقيهما إشارة التعلّم نفسها في كل لحظة. وينبغي أيضًا حفظ معامل التحجيم والمُحسِّن واضمحلال الأوزان والإسقاط العشوائي (dropout) عند التحقق من التنفيذ؛ فقد تغيّر هذه الخيارات المقدار الفعلي للتحديث عند الرتب المختلفة.[1] LoRA: Low-Rank Adaptation of Large Language Models
10. يجب التصريح بافتراضات تكافؤ الدمج
في طبقة خطية، مع معاملات ثابتة وتعطيل الإسقاط العشوائي عند الاستدلال واتساق التمثيل العددي، تتساوى Wx+sBAx و(W+sBA)x في الجبر على الأعداد الحقيقية. أما في الدقة المحدودة، فتُدخل عمليات الجمع وضرب المصفوفات وإعادة التكميم أخطاء؛ وإذا حُفظ النموذج الأساسي بتمثيل منخفض البت، فقد لا تحافظ إعادة التكميم بعد الدمج على الحساب الأصلي. ينبغي أن يقارن التحقق من الدمج هنا أخطاء المخرجات الفعلية، ثم يقيس زمن الاستجابة والموارد كلًا على حدة. ولا يجوز إعلان أن مسار نشر مكمّم معين خالٍ تمامًا من الفقد لمجرد إمكان الدمج جبريًا.[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs
11. كفاءة المعلمات واختناقات الذاكرة محوران مختلفان
يمكن لتجميد الأوزان الأساسية أن يقلّل التدرجات وحالات المُحسِّن المرتبطة بها، لكن الانتشار الأمامي والعكسي يظلان بحاجة إلى كثير من التنشيطات؛ كما تزيد التسلسلات الأطول التكاليف المرتبطة بالانتباه. يناقش QLoRA الجمع بين تكميم الأوزان الأساسية والتدريب التكييفي، بينما يناقش FlashAttention عمليات الإدخال والإخراج وتنظيم التنشيطات، ولا ينبغي التعامل معهما بوصفهما آليتين من النوع نفسه في رسم واحد لأعداد المعلمات. يجب تسجيل الأوزان والمعلمات القابلة للتدريب والمُحسِّن والتنشيطات وذروة استهلاك ذاكرة المسرّع على نحو منفصل، ومقارنة التكلفة الكلية عند مستوى متساوٍ من جودة المهمة.[2] QLoRA: Efficient Finetuning of Quantized LLMs[3] FlashAttention: Fast and Memory-Efficient Exact Attenti[4] Distilling the Knowledge in a Neural Network
الصيغ الأساسية والاشتقاقات
(1) بالمقارنة مع mn للمصفوفة الكاملة، فهذا هو العدد الدقيق للمعلمات القابلة للتدريب؛ ولا يشمل الانحيازات الأخرى القابلة للتدريب أو الوحدات الإضافية أو المُحسِّن أو التنشيطات.
LaTeX
\Delta W=sBA,\quad \operatorname{rank}(\Delta W)\le r,\quad P_{\mathrm{train}}=r(m+n)(2) تمثل G تدرج الخسارة بالنسبة إلى تحديث الأوزان المركّب. عندما يكون B=0، يكون التدرج الابتدائي لـ A صفرًا، ما يوضح أن التهيئة والتحجيم يؤثران في السلوك المبكر للتحسين.
LaTeX
\nabla_A\mathcal L=sB^\top G,\qquad\nabla_B\mathcal L=sGA^\top(3) تصح العلاقة في الجبر على الأعداد الحقيقية؛ أما التنفيذ الفعلي فيتطلب أيضًا مراعاة حالة الإسقاط العشوائي وترتيب عمليات الفاصلة العائمة والتكميم. لا يتحقق الشكل إلا من هذا التحويل الخطي ضمن الشروط المذكورة.
LaTeX
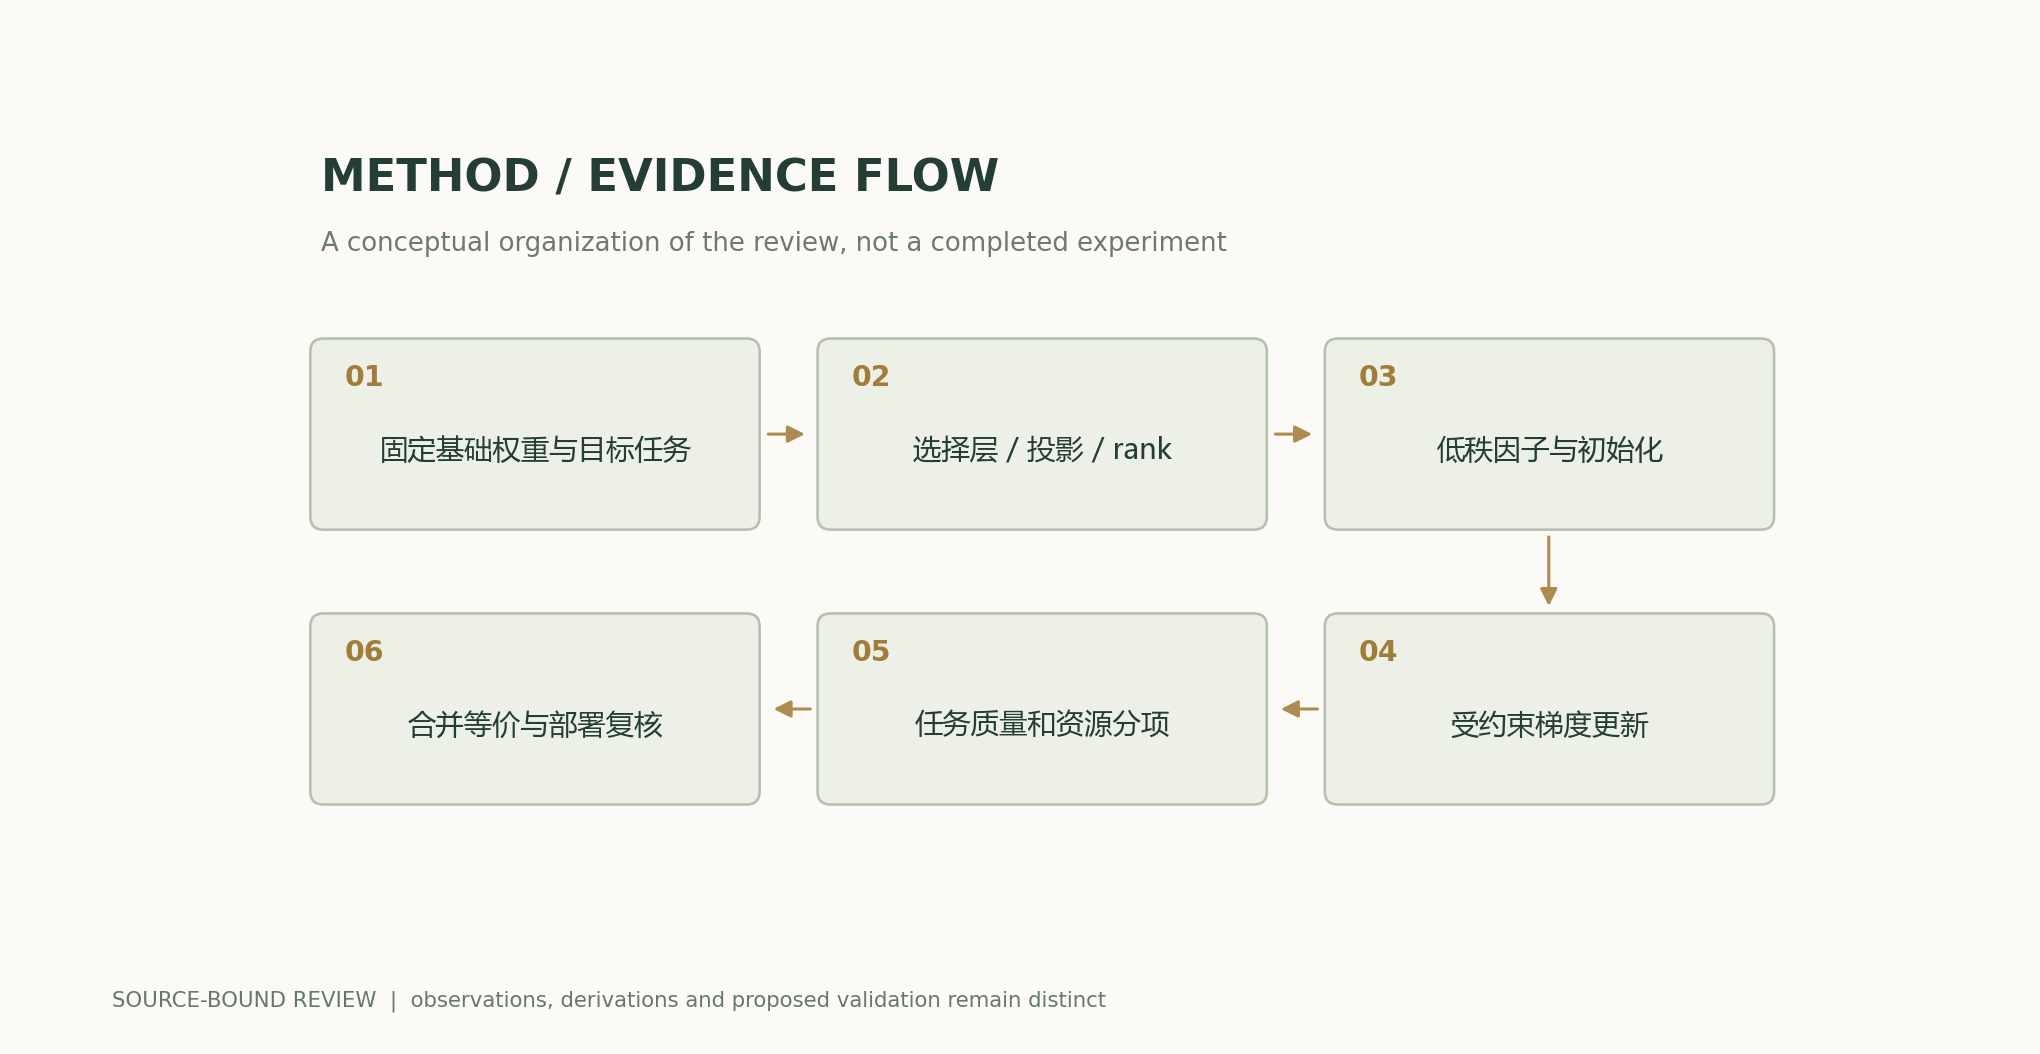
Wx+sBAx=(W+sBA)xمسار المنهج والأدلة
رسوم تحليلية وأمثلة عددية
مثال محلول يمكن إعادة حسابه
في مصفوفة أبعادها 4096×4096، تحتوي العوامل منخفضة الرتبة عند r=16 على 131072 معلمة، أي نحو 0.78125%. ويبلغ أقصى فرق مطلق في تحقق مستقل بالفاصلة العائمة باستخدام مصفوفات صغيرة 3.55e-15؛ وهذا يتحقق من التنفيذ الخطي، ولا يثبت خلو الدمج المكمّم من الفقد أو القدرات في المهام اللاحقة.
مقارنة الطرق
| الطريقة أو الحكم | المتغيرات المضبوطة والقياس | شروط الإخفاق وتفسيرها |
|---|---|---|
| نسبة المعلمات القابلة للتدريب | تثبيت أبعاد المصفوفة والرتبة واختيار الوحدات | لا تتنبأ مباشرةً بإجمالي ذاكرة المسرّع أو زمن التدريب |
| زيادة الرتبة | تثبيت البيانات والميزانية والتحجيم، ومقارنة جودة المهمة | زيادة السعة لا تضمن تحسن التعميم خارج البيانات |
| دمج المُكيِّف | تعطيل الإسقاط العشوائي وتثبيت الدقة وقياس الخطأ | بعد إعادة التكميم، لا يعود تحقق الحساب العددي نفسه مضمونًا تلقائيًا |
| الجمع بين التكميم والرتبة المنخفضة | عرض تكاليف الأوزان الأساسية والتدريب والتنشيطات كلٌّ على حدة | لا يمكن مقارنة آليات التحسين المختلفة بعدد المعلمات وحده |
خطة التحقق والتجارب
- تثبيت النموذج الأساسي والمُجزِّئ الرمزي وإصدار البيانات وتقسيم التدريب، وتوضيح الوحدات التي يجري تكييفها والمعلمات التي يجري تجميدها.
- تسجيل الرتبة والتحجيم والتهيئة والإسقاط العشوائي والمُحسِّن وميزانية التدريب، وإجراء دراسات الاستئصال بخطط متكافئة في الميزانية.
- تغيير الرتبة وتوزيع الوحدات بصورة منفصلة، مع الإبقاء على خط أساس غير مكيَّف وعلى مقارنة واحدة على الأقل تستخدم جميع المعلمات أو طريقة تكييف أخرى.
- إحصاء الذاكرة المرتبطة بأوزان التدريب والتدرجات والمُحسِّن والتنشيطات، والإبلاغ عن الذروة الفعلية بدلًا من الاكتفاء بحساب المعلمات منخفضة الرتبة.
- مقارنة المخرجات قبل الدمج وبعده في وضع استدلال تُعطَّل فيه العشوائية، والإبلاغ عن الخطأ المطلق والنسبي، واختبار مسار إعادة التكميم على حدة.
- اختبار النقل والنسيان على مهام مستقلة وعلى القدرات الأساسية، وحفظ أمثلة الإخفاق، وعدم استنتاج جودة التكييف كلها من خسارة التدريب.
نطاق التطبيق والقيود
- لا تساوي رتبة التحديث مباشرةً البُعد الجوهري الذي تتطلبه المهمة.
- عدّ المعلمات ليس قياسًا لأداء الأجهزة.
- قد يغيّر التكميم والإسقاط العشوائي مسار الدمج.
- لا تتضمن هذه المراجعة تدريبًا جديدًا للنماذج أو استنتاجًا بتحقق تكييف بلا فقد.
مطابقة المصادر الأولية بالادعاءات
- LoRA: Low-Rank Adaptation of Large Language ModelsHu et al. · 2021-06-17v2; low-rank update formulation
- QLoRA: Efficient Finetuning of Quantized LLMsDettmers et al. · 2023-05-23v1; NF4, double quantization, paged optimizers and limitations
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
الاستشهاد وتصدير المقال
BibTeXRISCSL JSONTXTالمقال JSON
المؤلف والإصدار والمصادر
مراجعة بحثية بمساعدة الذكاء الاصطناعي؛ كتبها Codex (ذكاء اصطناعي) بالاستناد إلى المراجع الأولية المدرجة، وأجرى اشتقاقاتها التحليلية. لا يتضمن هذا الموقع سجلًا لتحكيم مستقل لهذه المقالة أو لتجارب أصلية على النماذج.
مراجعة لتحسين أداء القارئ: يُعاد أيضًا استخدام الصفحة المقروءة عندما يعيد طلب HEAD حديث الحالة 200 وتكون قيمة ETag مطابقة. ويحتفظ المتن والصيغ والمصادر وبيانات الرسوم العلمية بمحتوى الإصدار السابق.
الغلاف المفاهيمي منفصل عن الرسوم العلمية؛ تُحسب الرسوم العلمية باستخدام صيغ متاحة علنًا وافتراضات معلنة، وتُنسب جميع نتائج الأوراق الأصلية إلى مصادرها.
المؤلف والإصدارات وسجل التصحيحات · /guides/efficient-adaptation-lora/v5/
مصادر الغلاف والرسوم العلمية · البيانات والمصادر والافتراضات · سجل النشر والإصدارات
مراجعة المصدر: 6251a250b27bb8b449f59b392f81abd355383770