
摘要
低秩适配通过限制权重更新形式,改变训练所需的自由参数及优化状态,但不等于同时消除激活、基础权重或全部推理成本。本文补充更新秩、初始化梯度与合并等价的推导,讨论任务容量、模块选择和量化之间的相互影响,并提出固定数据与训练预算的消融方案。参数数量图来自解析计数;线性代数核对不是语言模型能力或设备性能实验。[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs[3] FlashAttention: Fast and Memory-Efficient Exact Attenti
English abstract
Low-rank adaptation is analyzed as a constrained weight update. The review derives parameter counts, rank limits and initialization-dependent gradients, and states the assumptions needed for merging an adapter into a linear layer. Quantization and activation memory are treated separately. The analytical figures report parameter accounting and numerical linear algebra, not downstream task accuracy or hardware speedups.
1. LoRA 改变的是更新的表示
LoRA 冻结原权重 W,通过低秩矩阵乘积 BA 表示可训练增量。对于 的矩阵,完整更新有 个可训练数,而低秩部分有 个。这个计数不包含其他层、偏置或框架额外状态,也不能据此证明任意低秩都能达到完整微调的质量。[1] LoRA: Low-Rank Adaptation of Large Language Models
2. 一个可独立复算的例子
令 ,则原矩阵有 16,777,216 个数。取 ,两个低秩矩阵共有 65,536 个可训练数,是完整矩阵的 ; 与 16 时分别为 32,768 与 131,072。图 2 用同一公式展示这些量。它是单矩阵参数计数,不能写成整个模型训练显存缩小了 256 倍。[1] LoRA: Low-Rank Adaptation of Large Language Models
3. 量化压缩另一项成本
QLoRA 把冻结预训练权重以 4 位形式保存,并将梯度传播到低秩适配器;论文还讨论 NF4、双重量化与分页优化器。其节省依赖表示方式、量化元数据、计算精度与优化器管理,不能概括为“整个训练过程都用 4 位”。冻结权重位宽、算子计算类型和适配器状态需要分别记录。[2] QLoRA: Efficient Finetuning of Quantized LLMs
4. 原始权重账本不等于峰值显存
假设恰有70亿个权重,16位原始存储为14 GB,4位为3.5 GB,字节。这不含量化常数、激活、缓存、梯度、适配器、优化器与临时缓冲,不能据此保证某张显卡能训练或运行。本版图2仅展示低秩参数占比;权重位宽的独立计数另见本集低比特推理综述,二者不是同一内存机制。作者分析与复核建议 / Author analysis
5. FlashAttention 优化不同的项
FlashAttention 通过 IO 感知的分块等方式减少注意力计算中的显存读写与中间保存。它不是 LoRA 的替代品:一个改变可训练增量,一个改变精确注意力的执行。把三种方法组合使用,可能作用于不同成本项;是否兼容、是否达到预期质量与速度,仍需在具体实现与输入上测量。[3] FlashAttention: Fast and Memory-Efficient Exact Attenti[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs
6. 质量对照不能只看训练损失
低秩、量化和数据选择可能以不同方式影响任务表现。本文建议固定基础检查点和训练材料,比较完整微调与不同秩、精度的方案,记录任务指标、输出分布与失败类型。若适配器只在某类提示上训练,应保留域外测试。不能因为训练损失下降,就认定事实性或通用能力没有退化。作者分析与复核建议 / Author analysis
7. 合并、切换与部署也要验收
LoRA 增量在适当实现中可以与权重合并,但量化权重上的合并、重新量化或多适配器切换具有各自执行细节。应保存基础模型、适配器、量化配置与合并过程的版本,核对部署输出是否与被评测产物一致。对延迟的结论,应由实际部署路径测量,而不是仅从参数数目推断。[1] LoRA: Low-Rank Adaptation of Large Language Models
稀疏更新与实际文件体积也有区别
适配器中的可训练数目可以精确计数,但保存文件还含有张量名称、元数据与精度信息。将一个适配器文件压缩后得到的字节数,不能直接与另一个未压缩完整检查点比较后宣称相同的参数节省倍数。同理,峰值显存包含同时存在的多种对象;即使冻结权重变小,激活也可能成为新的主要项。作者分析与复核建议 / Author analysis
8. 更新秩是结构约束,不是精度保证
令基础矩阵W的形状为m×n,更新写成BA,其中B为m×r、A为r×n,则更新秩最多为r,可训练参数为r(m+n)。相对全矩阵mn的节省可直接计算;但相同参数预算下,把更新分配到哪些层和投影也会改变表达能力。若某任务所需变化无法在所选子空间中充分表示,增加训练步数也未必解决。应把rank扫描与层选择分开,不把低参数比例直接解释成相同比例的训练开销或无损适配。[1] LoRA: Low-Rank Adaptation of Large Language Models
9. 初始化决定第一步哪些参数获得梯度
为使初始模型等于基础模型,常见实现把一个低秩因子初始化为零、另一个初始化为非零。若B=0,对A的梯度在第一步为零,而对B的梯度仍可非零;随后两者都可能变化。因此“两个因子都可训练”不意味着每一时刻都得到同样的学习信号。实现复核还应保存缩放系数、优化器、权重衰减和dropout;这些选择可能改变不同rank下的有效更新尺度。[1] LoRA: Low-Rank Adaptation of Large Language Models
10. 合并等价需要写出前提
在线性层、固定系数、推理时关闭dropout且数值表示一致时,Wx+sBAx与(W+sBA)x在实数代数中相等。有限精度下求和、矩阵乘法和重新量化会引入误差;若基础模型以低比特保存,合并后再量化不一定保持原计算。这里的合并核对应该比较实际输出误差,再分别测时延和资源。不能只因为代数上可合并,就宣布某个量化部署路径完全无损。[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs
11. 参数效率与内存瓶颈是不同轴
冻结基础权重可以减少相应梯度和优化器状态,但前向、反向传播仍需许多激活;较长序列也会增加注意力相关开销。QLoRA讨论量化基础权重和适配训练的组合,FlashAttention讨论IO与激活组织,它们不应在一张参数数量图上被当作同类机制。应分别记录权重、可训练参数、优化器、激活与峰值显存,并在相同任务质量下比较总成本。[2] QLoRA: Efficient Finetuning of Quantized LLMs[3] FlashAttention: Fast and Memory-Efficient Exact Attenti[4] Distilling the Knowledge in a Neural Network
核心公式与推导
(1) 与全矩阵mn相比,这是可训练参数的精确计数;不包含其他可训练偏置、额外模块、优化器和激活。
LaTeX
\Delta W=sBA,\quad \operatorname{rank}(\Delta W)\le r,\quad P_{\mathrm{train}}=r(m+n)(2) G是对合成权重更新的损失梯度。B=0时A初始梯度为零,说明初始化和缩放会影响优化早期行为。
LaTeX
\nabla_A\mathcal L=sB^\top G,\qquad\nabla_B\mathcal L=sGA^\top(3) 实数代数下成立;实际实现还需考虑dropout状态、浮点次序及量化。图中仅核对这一限定的线性映射。
LaTeX
Wx+sBAx=(W+sBA)x方法与证据流程
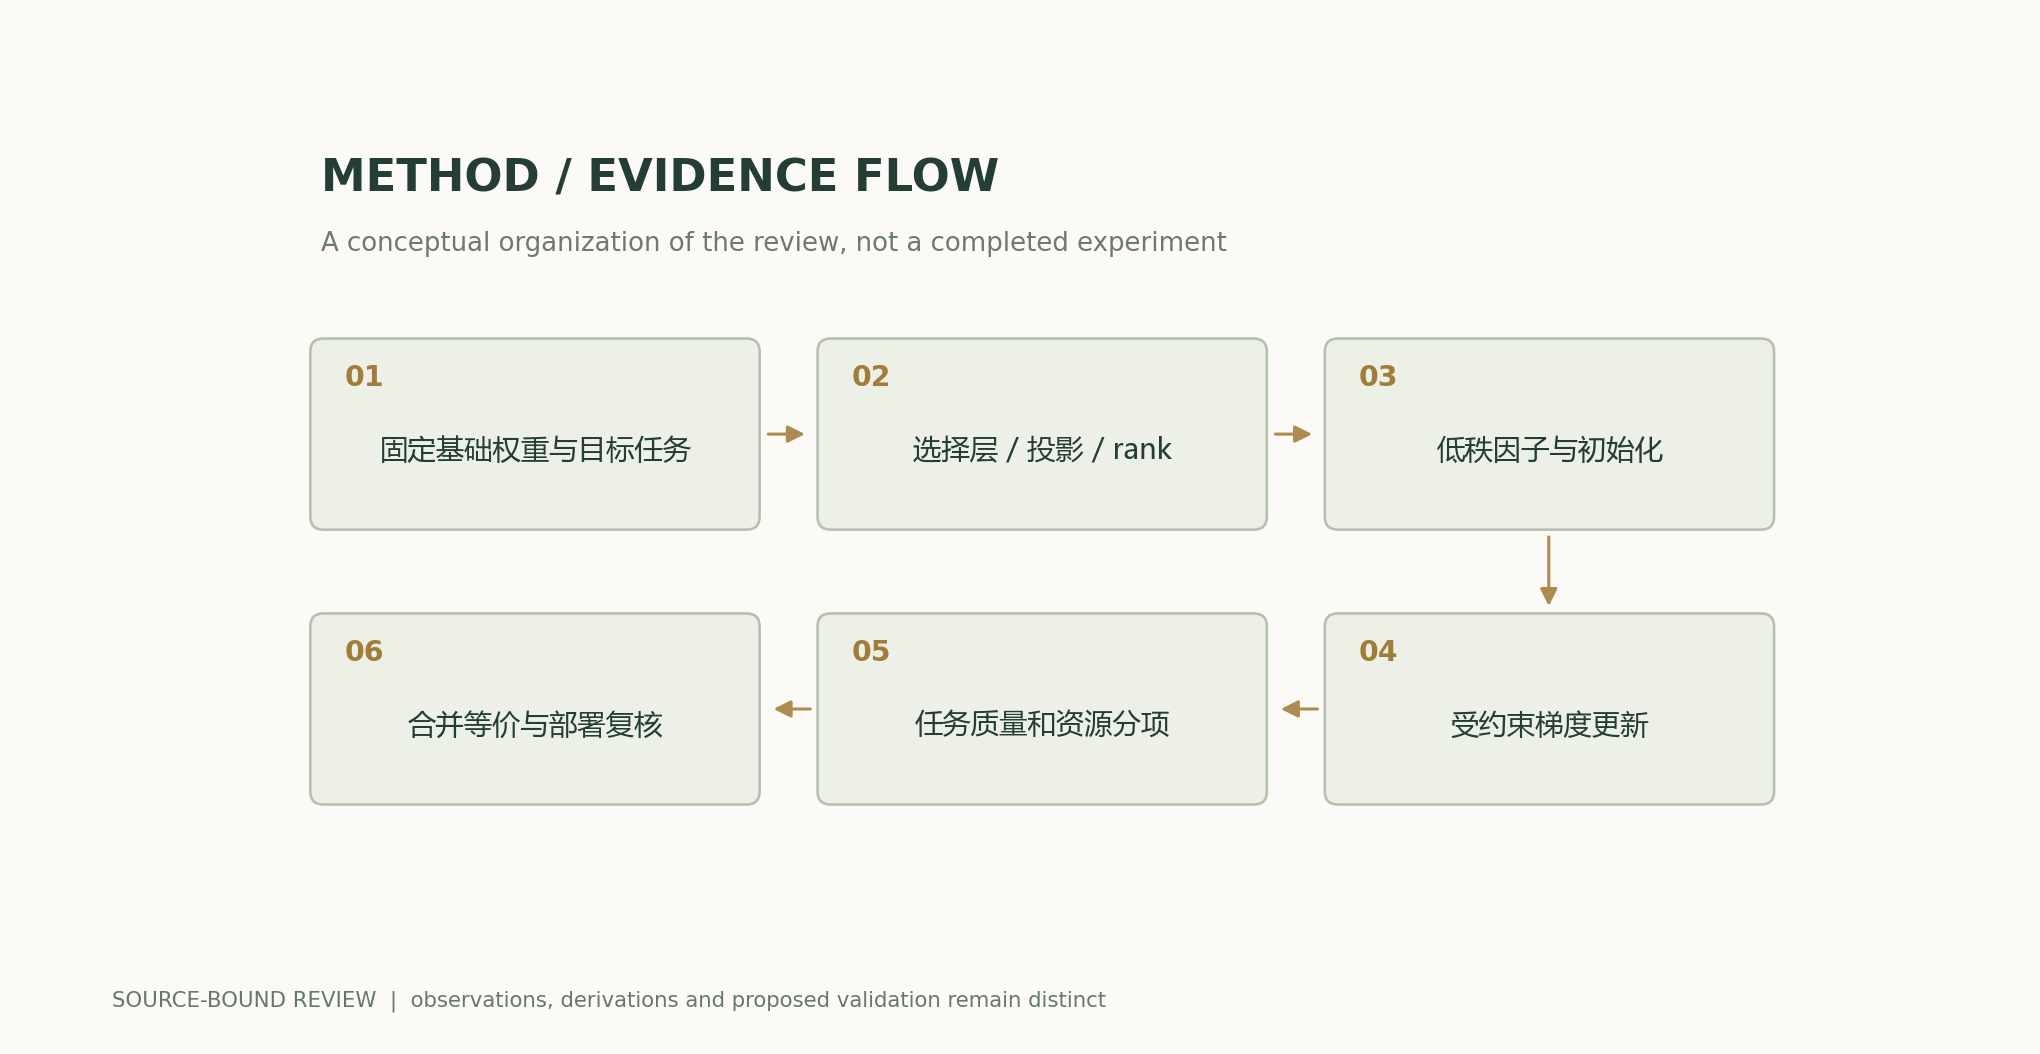
解析图与数值示例
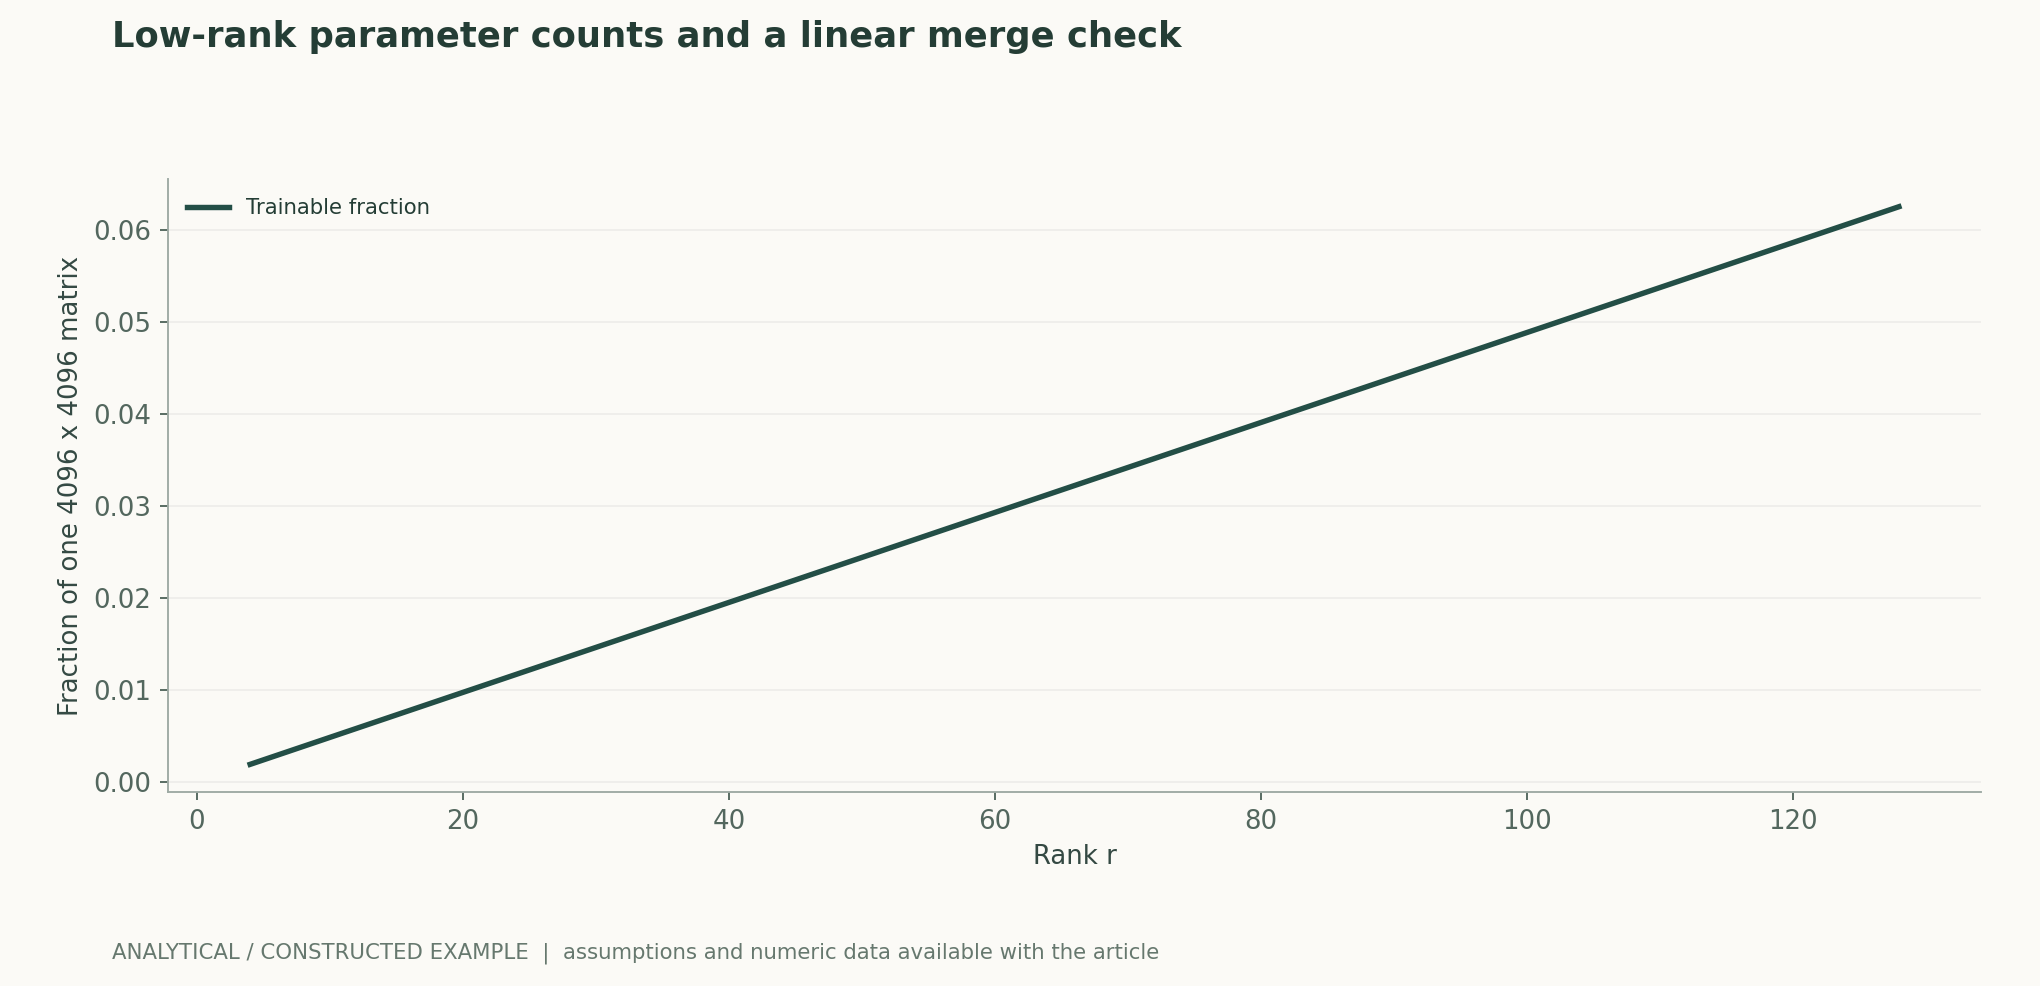
可复算例题
4096×4096矩阵在r=16时低秩因子有131072参数,约占0.78125%。独立小矩阵浮点核对的最大绝对差为3.55e-15;这验证线性实现,不证明量化合并无损或下游能力。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 可训练参数比例 | 固定矩阵形状、rank和模块选择 | 不能直接预测总显存或训练时间 |
| rank提升 | 固定数据、预算和缩放,比较任务质量 | 容量增加不保证数据外泛化提高 |
| 适配器合并 | 关闭dropout,固定精度并测误差 | 重新量化后不再自动满足同一数值计算 |
| 量化加低秩 | 分列基础权重和训练/激活成本 | 不同优化机制不能只用参数数目比较 |
复核与实验方案
- 固定基础模型、分词器、数据版本和训练划分,明确哪些模块被适配、哪些参数冻结。
- 记录rank、缩放、初始化、dropout、优化器及训练预算,以匹配预算的方案进行消融。
- 分别改变rank与模块分配,保留未适配基线及至少一种全参数或其他适配对照。
- 统计训练权重、梯度、优化器和激活相关内存,报告实际峰值而不只算低秩参数。
- 在关闭随机性的推理模式下比较合并前后输出,报告绝对/相对误差并单测重新量化路径。
- 在独立任务和基础能力上检验迁移与遗忘,保存失败样例,不由训练损失推断全部适配质量。
适用范围与局限
- 更新秩不直接等于任务所需内在维度。
- 参数计数不是设备性能测量。
- 量化与dropout可能改变合并路径。
- 没有新增模型训练或无损适配结论。
一手来源与主张对应
- LoRA: Low-Rank Adaptation of Large Language ModelsHu et al. · 2021-06-17v2; low-rank update formulation
- QLoRA: Efficient Finetuning of Quantized LLMsDettmers et al. · 2023-05-23v1; NF4, double quantization, paged optimizers and limitations
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
阅读器性能修订:新近 HEAD 返回 200 且 ETag 相同时也复用已读页面。正文、公式、来源和科学图的数据保持上一版本内容。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/efficient-adaptation-lora/v5/
Source revision: 6251a250b27bb8b449f59b392f81abd355383770