
要旨
低ランク適応は、重み更新の形式を制限することで、学習に必要な自由パラメータと最適化状態を変えるが、活性値、ベースモデルの重み、あるいは推論コストのすべてを同時に除去することを意味しない。本稿では、更新ランク、初期化時の勾配、マージの等価性の導出を補い、タスクに対する容量、モジュール選択、量子化の相互作用を論じ、データと学習予算を固定したアブレーション計画を提案する。パラメータ数の図は解析的な計数に基づく。線形代数による検証は、言語モデルの能力やデバイス性能の実験ではない。[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs[3] FlashAttention: Fast and Memory-Efficient Exact Attenti
原文の英語要旨の翻訳
低ランク適応を、制約付きの重み更新として解析する。本レビューでは、パラメータ数、ランクの限界、初期化に依存する勾配を導出し、アダプタを線形層にマージするために必要な仮定を明示する。量子化と活性値メモリは別々に扱う。解析図が示すのはパラメータの計数と数値線形代数であり、下流タスクの精度やハードウェアの高速化ではない。
1. LoRAが変えるのは更新の表現である
LoRAは元の重みWを凍結し、低ランク行列積BAによって学習可能な増分を表現する。行列の形状が の場合、完全な更新に含まれる学習可能な数値の個数は であるのに対し、低ランク部分では となる。この計数には、ほかの層、バイアス、フレームワークの追加状態は含まれず、任意の低ランクで完全ファインチューニングと同等の品質に達することを証明するものでもない。[1] LoRA: Low-Rank Adaptation of Large Language Models
2. 独立に再計算できる例
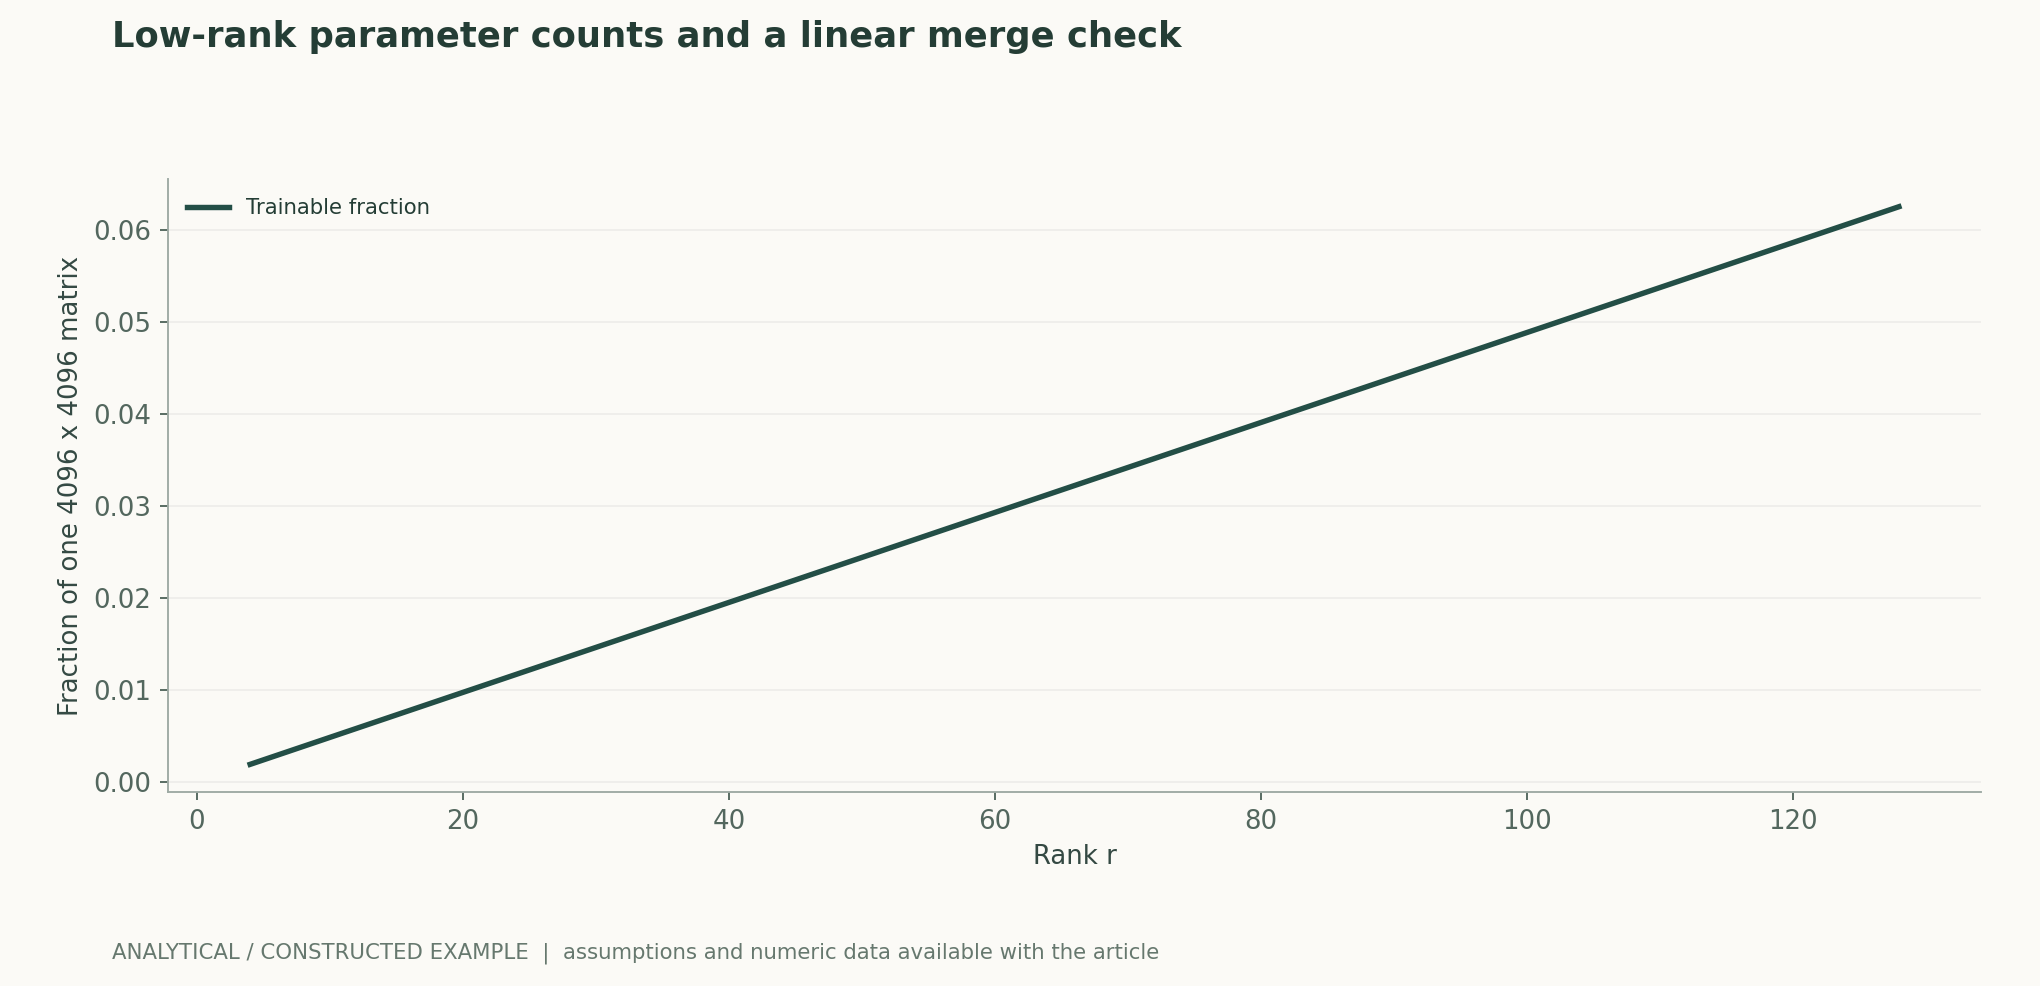
ここで とすると、元の行列には16,777,216個の数値がある。また、 とすると、両低ランク行列に含まれる学習可能な数値は合計65,536個であり、行列全体に対する割合は ; および16の場合は、それぞれ32,768個および131,072個となる。図2は、同じ式を用いてこれらの量を示す。これは単一行列のパラメータ数であり、モデル全体の学習時メモリ使用量が256分の一に減少したと記述することはできない。[1] LoRA: Low-Rank Adaptation of Large Language Models
3. 量子化は別のコスト項を削減する
QLoRAは、凍結した事前学習済み重みを4ビット形式で保存し、低ランクアダプタへ勾配を伝播する。同論文は、NF4、二重量子化、ページング型オプティマイザについても論じている。その削減効果は、表現形式、量子化メタデータ、計算精度、オプティマイザの管理に依存し、「学習過程全体で4ビットを使う」と要約することはできない。凍結重みのビット幅、演算子の計算データ型、アダプタの状態は、それぞれ別に記録する必要がある。[2] QLoRA: Efficient Finetuning of Quantized LLMs
4. 重みの生データ容量の計算はピークメモリ使用量とは異なる
重みがちょうど70億個あると仮定すると、16ビットでの生データの保存容量は14 GB、4ビットでは3.5 GBであり、バイトとなる。これには、量子化定数、活性値、キャッシュ、勾配、アダプタ、オプティマイザ、一時バッファは含まれず、特定のグラフィックスカードで学習または実行できることを保証する根拠にはならない。本版の図2は、低ランクパラメータの割合のみを示す。重みのビット幅についての独立した計数は、本シリーズの低ビット推論レビューを参照されたい。両者は同一のメモリ機構ではない。作者分析与复核建议 / Author analysis
5. FlashAttentionは異なる項を最適化する
FlashAttentionは、入出力を考慮したタイル分割などにより、アテンション計算におけるアクセラレータメモリの読み書きと中間結果の保存を減らす。LoRAの代替ではなく、一方は学習可能な増分を変え、他方は厳密なアテンションの実行方法を変える。これら三つの手法を組み合わせると、異なるコスト項に作用し得る。ただし、互換性があるか、期待した品質と速度に達するかは、具体的な実装と入力に基づいて測定する必要がある。[3] FlashAttention: Fast and Memory-Efficient Exact Attenti[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs
6. 品質の比較は学習損失だけではできない
低ランク、量子化、データ選択は、それぞれ異なる形でタスク性能に影響し得る。本稿では、ベースのチェックポイントと学習資料を固定し、完全ファインチューニングとランクや精度の異なる構成を比較し、タスク指標、出力分布、失敗の種類を記録することを推奨する。アダプタを特定の種類のプロンプトだけで学習させる場合は、ドメイン外のテストを残すべきである。学習損失が低下したというだけで、事実性や汎用能力が劣化していないと判断することはできない。作者分析与复核建议 / Author analysis
7. マージ、切り替え、デプロイにも検証が必要である
適切な実装ではLoRAの増分を重みにマージできるが、量子化重みへのマージ、再量子化、複数アダプタの切り替えには、それぞれ固有の実行上の詳細がある。ベースモデル、アダプタ、量子化設定、マージ手順のバージョンを保存し、デプロイ時の出力が評価対象の成果物と一致するかを検証する必要がある。レイテンシについての結論は、パラメータ数だけから推論するのではなく、実際のデプロイ経路の測定に基づくべきである。[1] LoRA: Low-Rank Adaptation of Large Language Models
疎な更新と実際のファイルサイズにも違いがある
アダプタ内の学習可能な数値の個数は正確に数えられるが、保存ファイルにはテンソル名、メタデータ、精度情報も含まれる。アダプタファイルを圧縮して得たバイト数を、別の未圧縮の完全なチェックポイントと直接比較し、同じ倍率のパラメータ削減を達成したと主張することはできない。同様に、アクセラレータのピークメモリ使用量には、同時に存在する複数種類のオブジェクトが含まれる。凍結重みが小さくなっても、活性値が新たな主要項になる可能性がある。作者分析与复核建议 / Author analysis
8. 更新ランクは構造的制約であり、精度の保証ではない
ベース行列Wの形状をm×nとし、更新をBAと表す。Bがm×r、Aがr×nであれば、更新ランクは高々rであり、学習可能パラメータ数はr(m+n)となる。行列全体のmnに対する削減量は直接計算できる。ただし、同じパラメータ予算でも、更新をどの層や射影に配分するかによって表現能力は変わる。あるタスクで必要となる変化が選択した部分空間で十分に表現できなければ、学習ステップ数を増やしても解決するとは限らない。ランクの探索と層の選択は分けて行い、低いパラメータ比率を、同じ割合の学習コスト削減や無損失の適応と直接解釈してはならない。[1] LoRA: Low-Rank Adaptation of Large Language Models
9. 初期化によって最初のステップで勾配を受け取るパラメータが決まる
初期モデルをベースモデルと等しくするため、一般的な実装では低ランク因子の片方をゼロ、もう片方を非ゼロに初期化する。B=0の場合、最初のステップにおけるAに対する勾配はゼロになる一方、Bに対する勾配は非ゼロになり得る。その後は両方が変化し得る。したがって、「両方の因子が学習可能」であることは、すべての時点で同じ学習信号を受け取ることを意味しない。実装の検証では、スケーリング係数、オプティマイザ、重み減衰、ドロップアウトも保存する必要がある。これらの選択は、異なるランクでの実効的な更新の大きさを変え得る。[1] LoRA: Low-Rank Adaptation of Large Language Models
10. マージの等価性には前提の明示が必要である
線形層で係数が固定され、推論時にドロップアウトが無効であり、数値表現が一致している場合、Wx+sBAxと(W+sBA)xは実数の代数では等しい。有限精度では、加算、行列積、再量子化によって誤差が生じる。ベースモデルが低ビットで保存されている場合、マージ後の再量子化によって元の計算が保持されるとは限らない。ここでのマージ検証では、実際の出力誤差を比較したうえで、レイテンシとリソースを別々に測定すべきである。代数的にマージできるというだけで、特定の量子化デプロイ経路が完全に無損失であると宣言することはできない。[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs
11. パラメータ効率とメモリのボトルネックは異なる軸である
ベースの重みを凍結すれば、対応する勾配とオプティマイザ状態を減らせるが、順伝播と逆伝播には依然として多くの活性値が必要である。系列が長くなると、アテンション関連のコストも増大する。QLoRAはベース重みの量子化と適応学習の組み合わせを扱い、FlashAttentionは入出力と活性値の構成を扱うため、これらを一枚のパラメータ数の図で同種の機構として扱うべきではない。重み、学習可能パラメータ、オプティマイザ、活性値、アクセラレータのピークメモリ使用量をそれぞれ記録し、同じタスク品質のもとで総コストを比較すべきである。[2] QLoRA: Efficient Finetuning of Quantized LLMs[3] FlashAttention: Fast and Memory-Efficient Exact Attenti[4] Distilling the Knowledge in a Neural Network
主要な数式と導出
(1) 行列全体のmnと比較した、学習可能パラメータの正確な個数である。ほかの学習可能なバイアス、追加モジュール、オプティマイザ、活性値は含まれない。
LaTeX
\Delta W=sBA,\quad \operatorname{rank}(\Delta W)\le r,\quad P_{\mathrm{train}}=r(m+n)(2) Gは、合成された重み更新に対する損失勾配である。B=0のとき、Aの初期勾配はゼロとなり、初期化とスケーリングが最適化初期の挙動に影響することを示している。
LaTeX
\nabla_A\mathcal L=sB^\top G,\qquad\nabla_B\mathcal L=sGA^\top(3) 実数の代数では成立する。実際の実装では、ドロップアウトの状態、浮動小数点演算の順序、量子化も考慮する必要がある。図では、この条件付きの線形写像のみを検証している。
LaTeX
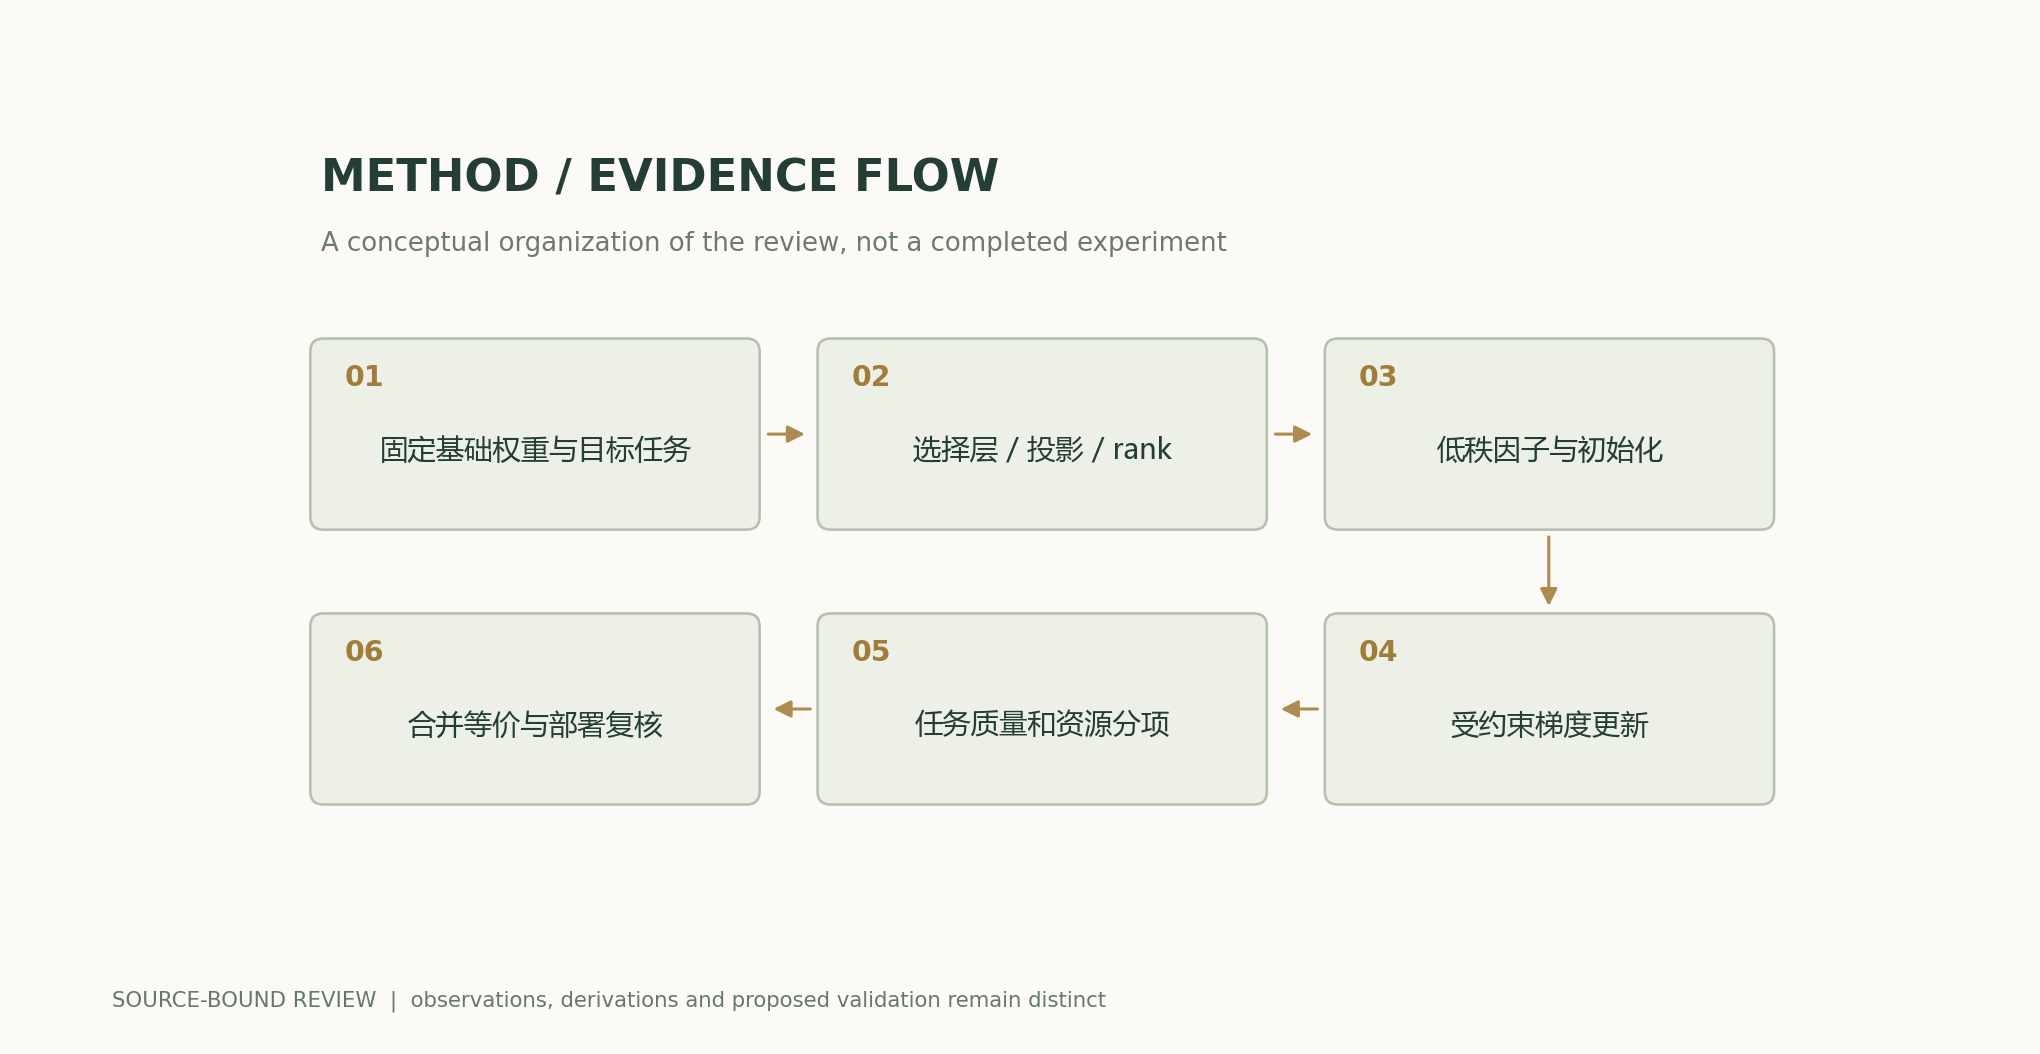
Wx+sBAx=(W+sBA)x方法とエビデンスの流れ
解析図と数値例
再計算可能な計算例
4096×4096行列では、r=16の場合、低ランク因子は131072個のパラメータを持ち、その割合は約0.78125%である。小行列を用いた独立の浮動小数点検証における最大絶対差は3.55e-15である。これは線形実装を検証するものであり、量子化マージが無損失であることや下流タスクの能力を証明するものではない。
手法の比較
| 手法または判断 | 統制変数と測定 | 成立しない条件と解釈 |
|---|---|---|
| 学習可能パラメータの割合 | 行列の形状、ランク、モジュール選択を固定する | アクセラレータの総メモリ使用量や学習時間は直接予測できない |
| ランクの増加 | データ、予算、スケーリングを固定し、タスク品質を比較する | 容量の増加はデータ外への汎化の向上を保証しない |
| アダプタのマージ | ドロップアウトを無効にし、精度を固定して誤差を測定する | 再量子化後に同じ数値計算が保持されるとは自動的にいえない |
| 量子化と低ランクの併用 | ベース重みと学習・活性値のコストを分けて記載する | 異なる最適化機構はパラメータ数だけでは比較できない |
検証と実験の計画
- ベースモデル、トークナイザ、データのバージョン、学習用の分割を固定し、どのモジュールを適応させ、どのパラメータを凍結するかを明示する。
- ランク、スケーリング、初期化、ドロップアウト、オプティマイザ、学習予算を記録し、予算を揃えた構成でアブレーションを行う。
- ランクとモジュールへの配分を別々に変更し、未適応のベースラインと、少なくとも一種類の全パラメータ学習または別の適応手法による比較対象を残す。
- 学習時の重み、勾配、オプティマイザ、活性値に関わるメモリを集計し、低ランクパラメータの計数だけでなく、実際のピーク値を報告する。
- 確率的動作を無効にした推論モードでマージ前後の出力を比較し、絶対誤差と相対誤差を報告するとともに、再量子化経路を個別に測定する。
- 独立したタスクと基礎的能力において転移と忘却を検証し、失敗例を保存する。学習損失から適応品質の全体を推論しない。
適用範囲と限界
- 更新ランクは、タスクが必要とする内在次元と直接等しいわけではない。
- パラメータの計数はデバイス性能の測定ではない。
- 量子化とドロップアウトはマージ経路を変える可能性がある。
- 新たなモデル学習も、適応が無損失であるとの結論も提示していない。
一次資料と主張の対応
- LoRA: Low-Rank Adaptation of Large Language ModelsHu et al. · 2021-06-17v2; low-rank update formulation
- QLoRA: Efficient Finetuning of Quantized LLMsDettmers et al. · 2023-05-23v1; NF4, double quantization, paged optimizers and limitations
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、記載した一次文献に基づいて執筆し、解析的な導出を行った。本サイトには、本稿に対する独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一である場合も、既読ページを再利用する。本文、数式、出典、科学図のデータは前版の内容を維持している。
概念的な表紙と科学図は区別している。科学図は公開された数式と明示的な仮定から計算され、原論文の結果にはすべて帰属を明記している。
著者、バージョン、訂正履歴 · /guides/efficient-adaptation-lora/v5/
表紙と科学図の出典 · データ、出典、仮定 · 公開とバージョンの履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770