
Resumen
Al restringir la forma de las actualizaciones de los pesos, la adaptación de bajo rango modifica los parámetros libres y los estados de optimización necesarios para el entrenamiento, pero no elimina simultáneamente las activaciones, los pesos base ni todos los costes de inferencia. Esta revisión incorpora derivaciones del rango de actualización, los gradientes en la inicialización y la equivalencia de fusión, analiza las interacciones entre la capacidad para la tarea, la selección de módulos y la cuantización, y propone un plan de ablación con datos y presupuesto de entrenamiento fijos. Las figuras sobre el número de parámetros proceden de un recuento analítico; las comprobaciones de álgebra lineal no son experimentos sobre las capacidades de los modelos de lenguaje ni sobre el rendimiento de los dispositivos.[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs[3] FlashAttention: Fast and Memory-Efficient Exact Attenti
Traducción del resumen original en inglés
La adaptación de bajo rango se analiza como una actualización restringida de los pesos. La revisión deriva los recuentos de parámetros, los límites de rango y los gradientes dependientes de la inicialización, y explicita los supuestos necesarios para fusionar un adaptador con una capa lineal. La cuantización y la memoria de activaciones se tratan por separado. Las figuras analíticas presentan el cómputo de parámetros y el álgebra lineal numérica, no la exactitud en tareas posteriores ni las aceleraciones del hardware.
1. LoRA cambia la representación de la actualización
LoRA congela los pesos originales W y representa el incremento entrenable mediante el producto matricial de bajo rango BA. Para una matriz de dimensiones , la actualización completa tiene valores entrenables, mientras que la parte de bajo rango tiene . Este recuento no incluye otras capas, sesgos ni estados adicionales del entorno de trabajo, y no permite demostrar que cualquier rango bajo pueda alcanzar la calidad del ajuste fino completo.[1] LoRA: Low-Rank Adaptation of Large Language Models
2. Un ejemplo que puede recalcularse de forma independiente
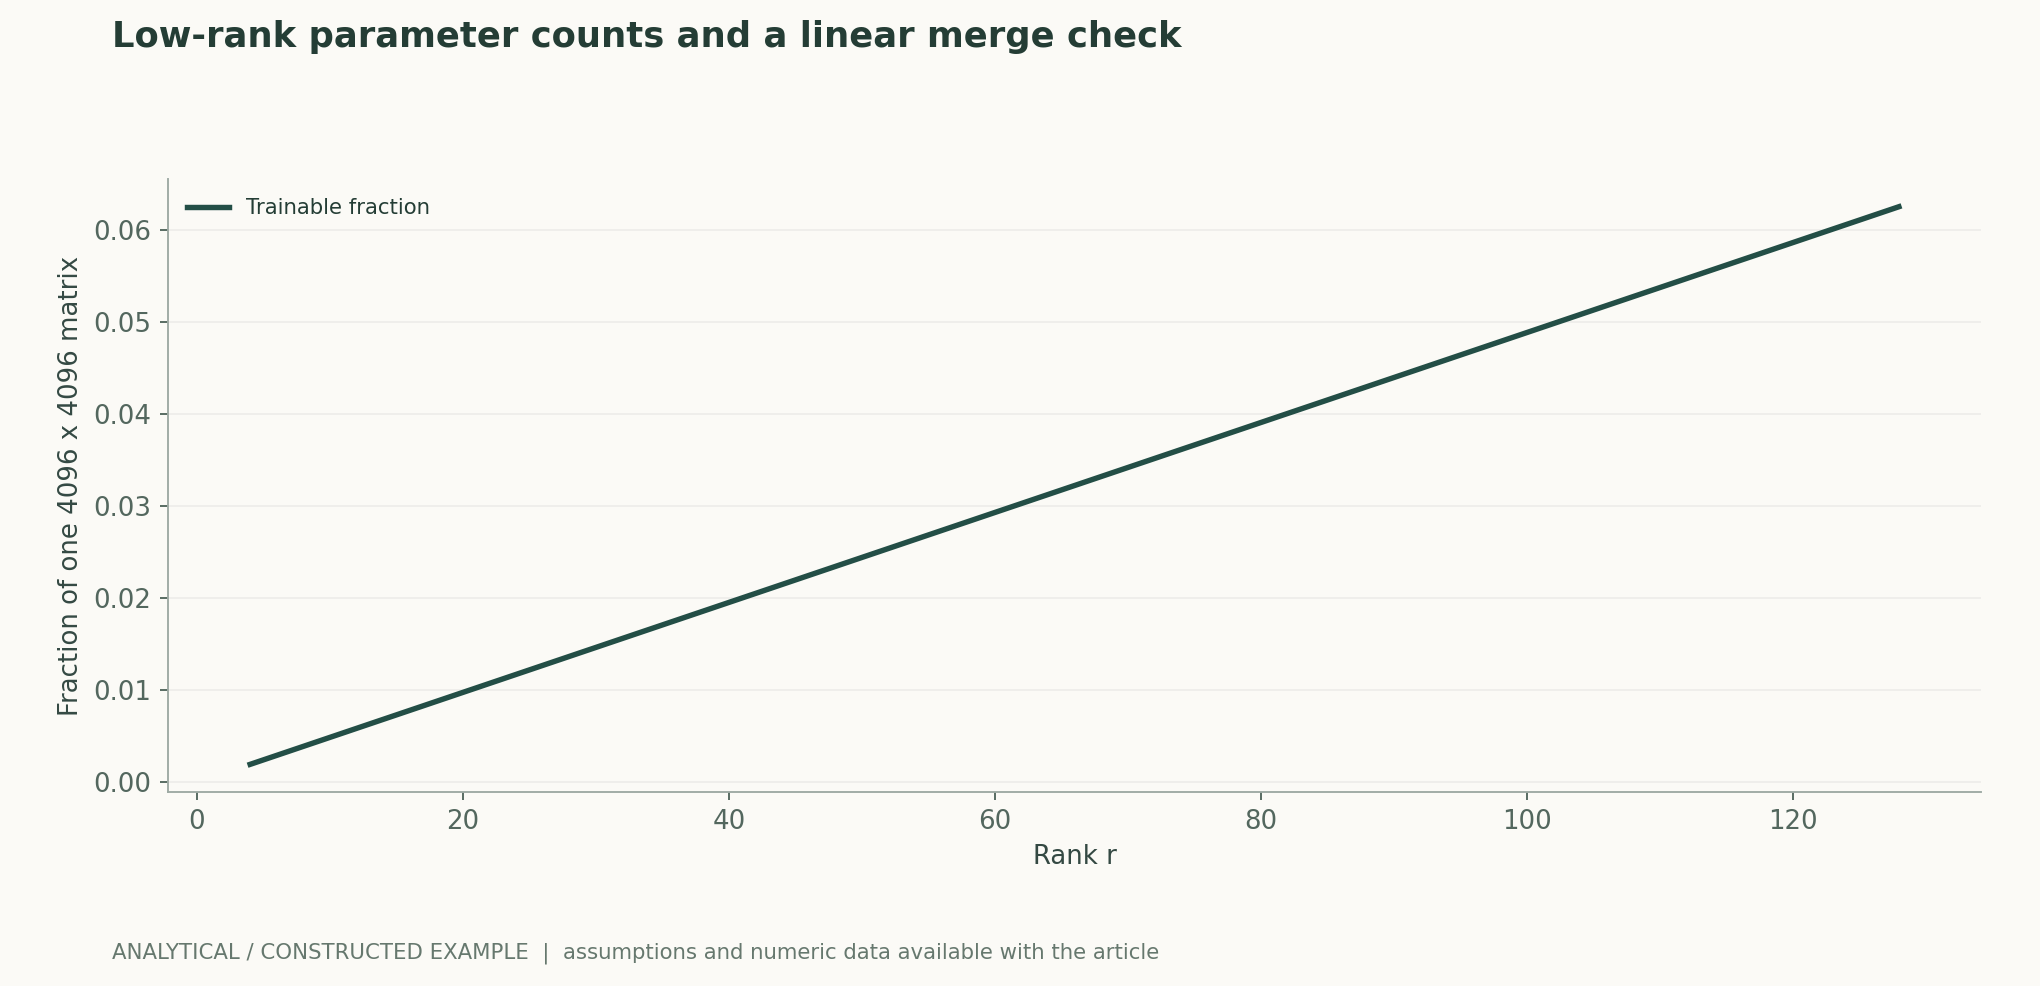
Sea ; entonces la matriz original contiene 16,777,216 valores. Tomando , las dos matrices de bajo rango contienen en total 65,536 valores entrenables, lo que representa la siguiente fracción de la matriz completa: ; y 16, los recuentos son 32,768 y 131,072, respectivamente. La figura 2 muestra estas cantidades mediante la misma fórmula. Se trata del recuento de parámetros de una sola matriz y no puede describirse como una reducción de la memoria de entrenamiento de todo el modelo por un factor de 256.[1] LoRA: Low-Rank Adaptation of Large Language Models
3. La cuantización reduce otro componente del coste
QLoRA almacena los pesos preentrenados congelados en formato de 4 bits y propaga los gradientes hacia los adaptadores de bajo rango; el artículo también aborda NF4, la doble cuantización y los optimizadores paginados. El ahorro depende de la representación, los metadatos de cuantización, la precisión de cálculo y la gestión del optimizador, y no puede resumirse como «todo el proceso de entrenamiento utiliza 4 bits». Deben registrarse por separado el ancho en bits de los pesos congelados, los tipos de cálculo de los operadores y los estados del adaptador.[2] QLoRA: Efficient Finetuning of Quantized LLMs
4. El cómputo del almacenamiento bruto de los pesos no equivale al pico de memoria del acelerador
Suponiendo que hay exactamente 70 cientos de millones de pesos, el almacenamiento bruto a 16 bits es de 14 GB, y a 4 bits es de 3.5 GB,bytes. Esto no incluye las constantes de cuantización, las activaciones, las cachés, los gradientes, los adaptadores, los optimizadores ni los búferes temporales, y no permite garantizar que una tarjeta gráfica concreta pueda entrenar o ejecutar el modelo. La figura 2 de esta versión muestra únicamente la proporción de parámetros de bajo rango; para un cómputo independiente de los anchos en bits de los pesos, véase la revisión sobre inferencia de pocos bits de esta colección. No se trata del mismo mecanismo de memoria.作者分析与复核建议 / Author analysis
5. FlashAttention optimiza un componente diferente
FlashAttention reduce las lecturas y escrituras en la memoria del acelerador y el almacenamiento intermedio durante el cálculo de la atención mediante técnicas como la división en bloques que tiene en cuenta la entrada y salida. No sustituye a LoRA: uno modifica el incremento entrenable y el otro modifica la ejecución de la atención exacta. Combinar los tres métodos puede afectar a distintos componentes del coste; su compatibilidad y la consecución de la calidad y la velocidad esperadas siguen requiriendo mediciones con la implementación y las entradas concretas.[3] FlashAttention: Fast and Memory-Efficient Exact Attenti[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs
6. La comparación de calidad no puede basarse solo en la pérdida de entrenamiento
El bajo rango, la cuantización y la selección de datos pueden afectar al rendimiento en la tarea de formas diferentes. Esta revisión recomienda fijar el punto de control base y los materiales de entrenamiento, comparar el ajuste fino completo con configuraciones de distintos rangos y precisiones, y registrar las métricas de la tarea, las distribuciones de salida y los tipos de fallo. Si el adaptador se entrena únicamente con una clase concreta de instrucciones, deben conservarse pruebas fuera del dominio. Una disminución de la pérdida de entrenamiento no permite concluir que la factualidad o las capacidades generales no se hayan deteriorado.作者分析与复核建议 / Author analysis
7. La fusión, el cambio de adaptadores y el despliegue también requieren validación
Los incrementos de LoRA pueden fusionarse con los pesos en implementaciones adecuadas, pero la fusión con pesos cuantizados, la recuantización y el cambio entre múltiples adaptadores tienen sus propios detalles de ejecución. Deben conservarse las versiones del modelo base, del adaptador, de la configuración de cuantización y del procedimiento de fusión, y comprobarse que las salidas del despliegue sean coherentes con el artefacto evaluado. Las conclusiones sobre la latencia deben proceder de mediciones de la ruta real de despliegue, no de inferencias basadas únicamente en el número de parámetros.[1] LoRA: Low-Rank Adaptation of Large Language Models
Las actualizaciones dispersas también difieren del tamaño real de los archivos
El número de valores entrenables de un adaptador puede contarse con exactitud, pero el archivo guardado también contiene nombres de tensores, metadatos e información sobre la precisión. El número de bytes obtenido al comprimir un archivo de adaptador no puede compararse directamente con otro punto de control completo sin comprimir para afirmar que se ha logrado el mismo factor de ahorro de parámetros. Del mismo modo, el pico de memoria del acelerador incluye diversos tipos de objetos que coexisten; aunque se reduzca el tamaño de los pesos congelados, las activaciones pueden convertirse en el nuevo componente predominante.作者分析与复核建议 / Author analysis
8. El rango de actualización es una restricción estructural, no una garantía de exactitud
Sea W una matriz base de dimensiones m×n y exprésese la actualización como BA, donde B tiene dimensiones m×r y A tiene dimensiones r×n. Entonces, el rango de la actualización es como máximo r y el número de parámetros entrenables es r(m+n). El ahorro respecto a los mn parámetros de la matriz completa puede calcularse directamente; sin embargo, con el mismo presupuesto de parámetros, la elección de las capas y proyecciones a las que se asignan las actualizaciones también modifica la capacidad expresiva. Si los cambios que requiere una tarea no pueden representarse adecuadamente en el subespacio seleccionado, aumentar los pasos de entrenamiento no necesariamente resuelve el problema. Debe separarse la exploración de rangos de la selección de capas, sin interpretar directamente una baja proporción de parámetros como una reducción proporcional del coste de entrenamiento o como una adaptación sin pérdidas.[1] LoRA: Low-Rank Adaptation of Large Language Models
9. La inicialización determina qué parámetros reciben gradientes en el primer paso
Para que el modelo inicial sea igual al modelo base, las implementaciones habituales inicializan un factor de bajo rango a cero y el otro con valores distintos de cero. Si B=0, el gradiente respecto a A es cero en el primer paso, mientras que el gradiente respecto a B puede seguir siendo distinto de cero; posteriormente, ambos pueden cambiar. Por tanto, que «ambos factores sean entrenables» no significa que reciban la misma señal de aprendizaje en todo momento. La verificación de la implementación también debe conservar el coeficiente de escalado, el optimizador, el decaimiento de pesos y el dropout; estas elecciones pueden cambiar la escala efectiva de la actualización entre distintos rangos.[1] LoRA: Low-Rank Adaptation of Large Language Models
10. La equivalencia de fusión exige explicitar los supuestos
En una capa lineal, con coeficientes fijos, dropout desactivado durante la inferencia y una representación numérica coherente, Wx+sBAx y (W+sBA)x son iguales en el álgebra de números reales. Con precisión finita, la suma, la multiplicación matricial y la recuantización introducen errores; si el modelo base se almacena con pocos bits, volver a cuantizar tras la fusión no necesariamente conserva el cálculo original. La comprobación de fusión debe comparar aquí los errores reales de salida y, después, medir por separado la latencia y los recursos. La posibilidad de fusión algebraica no basta para declarar que una ruta concreta de despliegue cuantizado carece por completo de pérdidas.[1] LoRA: Low-Rank Adaptation of Large Language Models[2] QLoRA: Efficient Finetuning of Quantized LLMs
11. La eficiencia en parámetros y los cuellos de botella de memoria son ejes distintos
Congelar los pesos base puede reducir los gradientes y los estados del optimizador correspondientes, pero la propagación hacia delante y hacia atrás sigue requiriendo numerosas activaciones; las secuencias más largas también incrementan los costes relacionados con la atención. QLoRA aborda la combinación de pesos base cuantizados y entrenamiento de adaptación, mientras que FlashAttention aborda la entrada y salida y la organización de las activaciones; no deben tratarse como mecanismos de la misma clase en una figura de recuento de parámetros. Deben registrarse por separado los pesos, los parámetros entrenables, el optimizador, las activaciones y el pico de memoria del acelerador, y comparar los costes totales a igual calidad en la tarea.[2] QLoRA: Efficient Finetuning of Quantized LLMs[3] FlashAttention: Fast and Memory-Efficient Exact Attenti[4] Distilling the Knowledge in a Neural Network
Ecuaciones fundamentales y derivaciones
(1) En comparación con mn para la matriz completa, este es el recuento exacto de parámetros entrenables; no incluye otros sesgos entrenables, módulos adicionales, optimizadores ni activaciones.
LaTeX
\Delta W=sBA,\quad \operatorname{rank}(\Delta W)\le r,\quad P_{\mathrm{train}}=r(m+n)(2) G es el gradiente de la pérdida respecto a la actualización compuesta de los pesos. Cuando B=0, el gradiente inicial de A es cero, lo que muestra que la inicialización y el escalado influyen en el comportamiento inicial de la optimización.
LaTeX
\nabla_A\mathcal L=sB^\top G,\qquad\nabla_B\mathcal L=sGA^\top(3) La igualdad se cumple en el álgebra de números reales; la implementación real también debe considerar el estado del dropout, el orden de las operaciones en coma flotante y la cuantización. La figura comprueba únicamente esta transformación lineal bajo las condiciones indicadas.
LaTeX
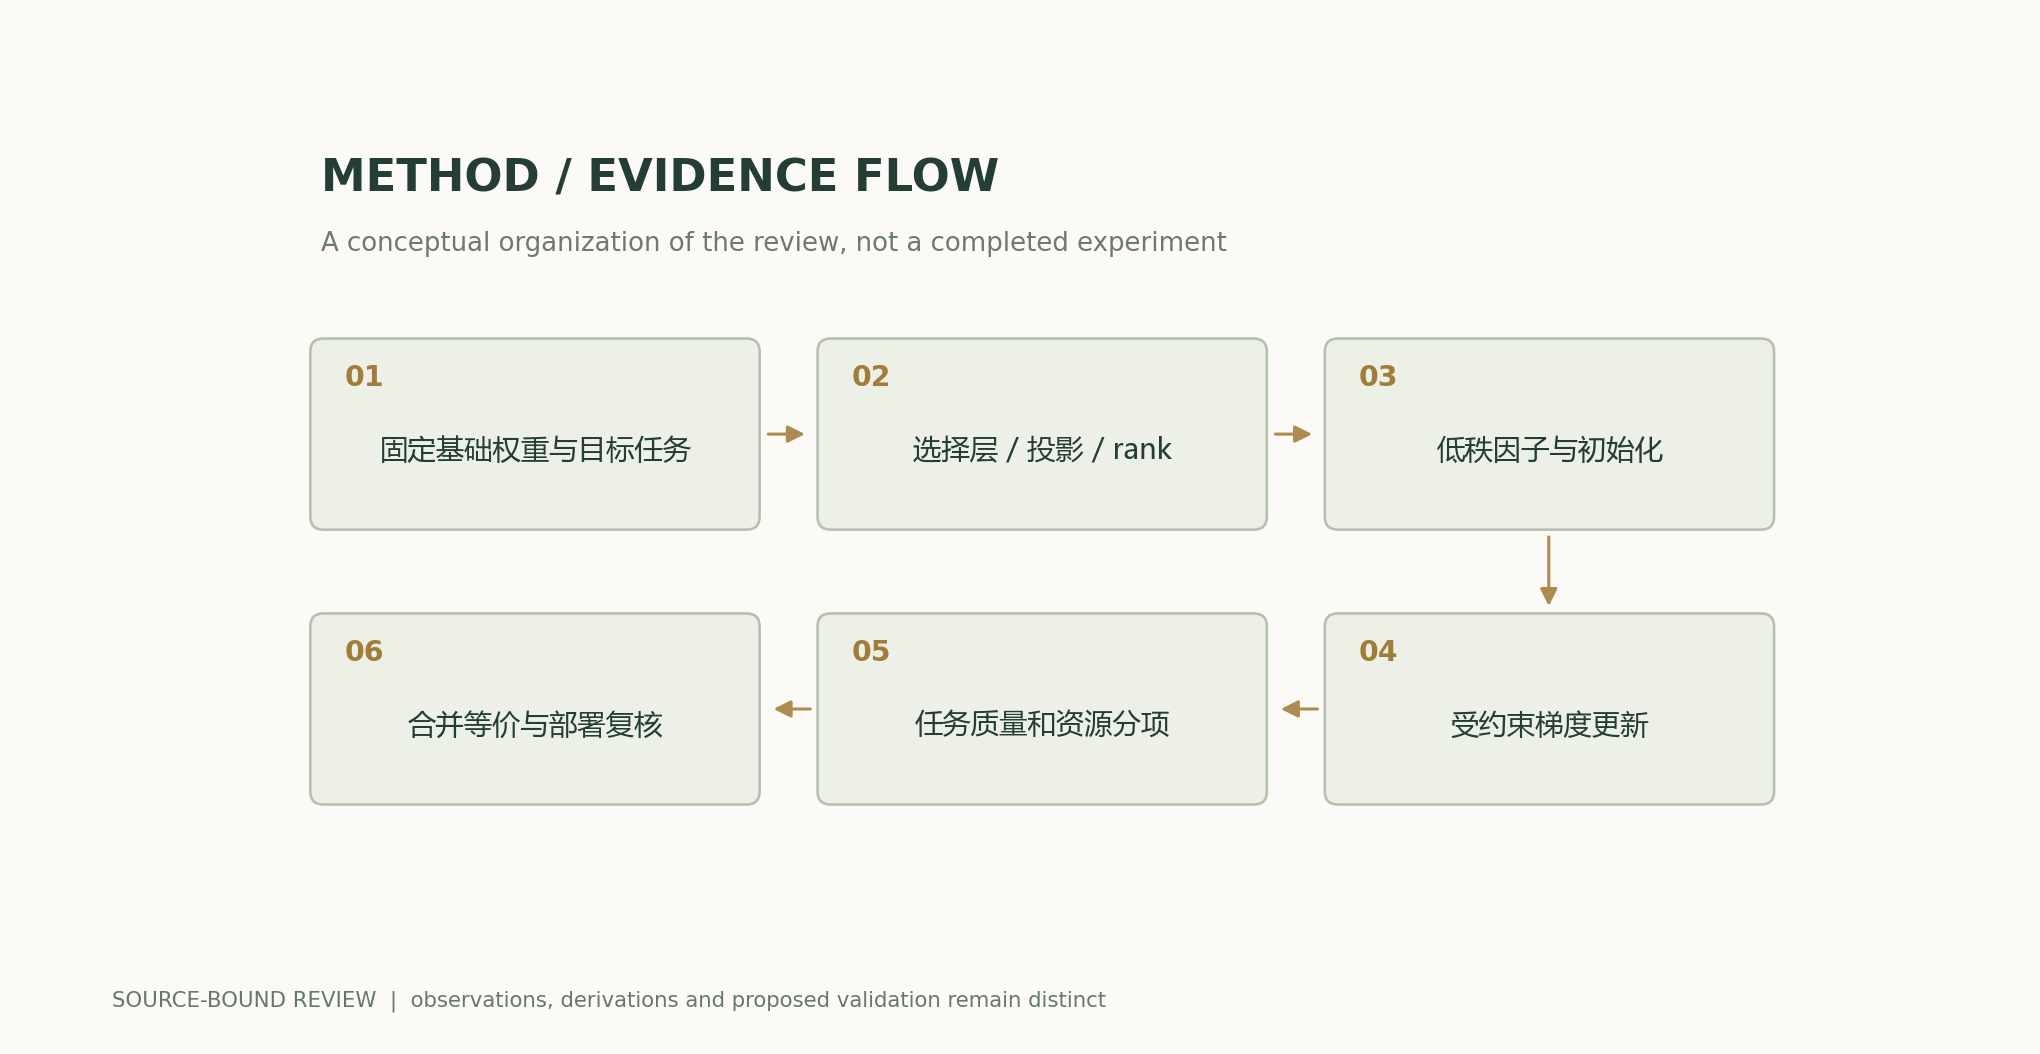
Wx+sBAx=(W+sBA)xFlujo metodológico y de evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto reproducible
Para una matriz de 4096×4096 con r=16, los factores de bajo rango contienen 131072 parámetros, aproximadamente el 0.78125% del total. La diferencia absoluta máxima en una comprobación independiente en coma flotante con matrices pequeñas es 3.55e-15; esto verifica la implementación lineal, pero no demuestra que la fusión cuantizada sea sin pérdidas ni acredita las capacidades en tareas posteriores.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Proporción de parámetros entrenables | Fijar las dimensiones de la matriz, el rango y la selección de módulos | No permite predecir directamente la memoria total del acelerador ni el tiempo de entrenamiento |
| Aumento del rango | Fijar los datos, el presupuesto y el escalado, y comparar la calidad en la tarea | Una mayor capacidad no garantiza una mejor generalización fuera de los datos |
| Fusión del adaptador | Desactivar el dropout, fijar la precisión y medir el error | Tras la recuantización, ya no se conserva automáticamente el mismo cálculo numérico |
| Cuantización más bajo rango | Desglosar por separado los costes de los pesos base y los del entrenamiento y las activaciones | Los distintos mecanismos de optimización no pueden compararse solo por el número de parámetros |
Plan de verificación y experimentación
- Fijar el modelo base, el tokenizador, la versión de los datos y la partición de entrenamiento, y especificar qué módulos se adaptan y qué parámetros se congelan.
- Registrar el rango, el escalado, la inicialización, el dropout, el optimizador y el presupuesto de entrenamiento, y realizar ablaciones con configuraciones de presupuesto equivalente.
- Variar por separado el rango y la asignación de módulos, conservando una referencia sin adaptación y al menos una comparación con ajuste de todos los parámetros o con otro método de adaptación.
- Cuantificar la memoria asociada a los pesos durante el entrenamiento, los gradientes, el optimizador y las activaciones, e informar del pico real en lugar de contar únicamente los parámetros de bajo rango.
- Comparar las salidas antes y después de la fusión en modo de inferencia con la aleatoriedad desactivada, informar de los errores absolutos y relativos, y probar por separado la ruta de recuantización.
- Evaluar la transferencia y el olvido en tareas independientes y capacidades básicas, conservar los casos de fallo y no inferir toda la calidad de la adaptación a partir de la pérdida de entrenamiento.
Ámbito de aplicación y limitaciones
- El rango de actualización no equivale directamente a la dimensionalidad intrínseca requerida por la tarea.
- El recuento de parámetros no es una medición del rendimiento del dispositivo.
- La cuantización y el dropout pueden modificar la ruta de fusión.
- No se presenta nuevo entrenamiento de modelos ni se concluye que la adaptación sea sin pérdidas.
Correspondencia entre fuentes primarias y afirmaciones
- LoRA: Low-Rank Adaptation of Large Language ModelsHu et al. · 2021-06-17v2; low-rank update formulation
- QLoRA: Efficient Finetuning of Quantized LLMsDettmers et al. · 2023-05-23v1; NF4, double quantization, paged optimizers and limitations
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el texto y realizó las derivaciones analíticas a partir de la bibliografía primaria indicada. Este sitio no dispone de registros de revisión independiente por pares ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag no cambia. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se presenta por separado de las figuras científicas; estas se calculan a partir de fórmulas públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Autor, versiones e historial de correcciones · /guides/efficient-adaptation-lora/v5/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770