
الملخص
أظهر التحكم القائم على التعلم قدرات على التحكم في الشكل وتجنب عدم الاستقرار في تجارب التوكاماك، لكن لا يمكن جمع أجهزة ومهام ومقاييس زمنية مختلفة في معدل نجاح عام واحد. يقارن هذا المقال التحكم المغناطيسي في الشكل في TCV بأعمال تجنب التمزق في DIII-D، ويفصل تقدير الحالة والسياسة وقيود التنفيذ وأنظمة الحماية إلى طبقات. ومن خلال مثال مضاد للتغذية الراجعة الخطية يتضمن تأخرًا، نوضح أن دقة التنبؤ في الحلقة المفتوحة لا تضمن استقرار الحلقة المغلقة؛ ومن خلال هدف مقيد بالمخاطر، نوضح أن انخفاض متوسط خطأ التتبع لا يعوض الانحرافات النادرة والشديدة. ولا تعرض الرسوم إلا حسابات لنظام تحكم مطبَّع، ولا تتضمن معلمات أجهزة حقيقية أو تشغيلًا للبلازما أو تعليمات تحكم تجريبية.[1] Magnetic control of tokamak plasmas through deep reinfo[2] Avoiding fusion plasma tearing instability with deep re
ترجمة الملخص الإنجليزي الأصلي
يجب أن يحقق التحكم في البلازما القائم على التعلم أهداف الحلقة المغلقة في ظل ديناميكيات غير يقينية وقيود تشغيلية صارمة. ندرس التحكم المغناطيسي في الشكل في TCV ودراسات تجنب التمزق في DIII-D بوصفهما إنجازين متميزين. ويوضح نظام تغذية راجعة قياسي ذو تأخر كيف يمكن أن تتزامن الدقة الاسمية مع عدم الاستقرار؛ ويفصل هدف مقيد بالمخاطر التتبع عن الانحرافات غير المقبولة. نقترح تقييمًا على مستوى التفريغ باستخدام سياسات مجمَّدة، ونطاقات تشغيل متطابقة، واحتساب صريح لتدخلات التحكم الاحتياطي. لا يُجرى هنا أي تشغيل لمفاعل ولا تُولَّد أي إشارة تحكم حقيقية.
1. التحكم المغناطيسي في الشكل وتجنب عدم الاستقرار ليسا المهمة نفسها
تستخدم دراسة TCV سياسة تعلم للتحكم في الملفات المغناطيسية وتحقيق أشكال متعددة للبلازما؛ أما دراسة DIII-D فتستخدم نموذجًا ديناميكيًا لتدريب سياسة تقلل مخاطر عدم استقرار التمزق أثناء تتبع حالات عالية الأداء. وتوضح الدراستان أن التحكم القائم على التعلم يمكن أن يدخل حلقة مغلقة فيزيائية حقيقية، لكن أهدافهما ورصودهما ومشغلاتهما ونطاقات تشغيلهما مختلفة. يقترح هذا المقال أولًا تمثيل كل دراسة برباعية الحالة والفعل والهدف والقيود، مع تحديد المتغيرات المقاسة مباشرة وتلك المعتمدة على التقدير. ودون مواءمة المهام أولًا، قد تعكس مقارنة «أعداد النجاحات» مجرد اختلافات في صعوبة الهدف ونطاق التشغيل.[1] Magnetic control of tokamak plasmas through deep reinfo[2] Avoiding fusion plasma tearing instability with deep re
2. تكمن قيمة التدريب بالمحاكاة في الاستكشاف المنهجي، وتكمن حدوده في أخطاء النموذج
درَّب عمل TCV سياسة التحكم بالمحاكاة وتحقق منها في تجارب على الجهاز، بينما استخدم عمل DIII-D نموذجًا ديناميكيًا يتنبأ بعدم الاستقرار للتدريب. تتيح المحاكاة للسياسة الاستكشاف بتكلفة تجريبية أقل، لكن الفروق بينها وبين النظام الحقيقي قد تنشأ من تأخر الاستجابة وتشبع المشغلات وانحياز التشخيص والحالات غير الممثلة في النموذج. يدعو هذا المقال إلى حفظ نطاق انطباق نموذج التدريب وتوزيع أخطائه، وإجراء تحقق منفصل في ظروف تختلف عن نطاق التدريب. ويساعد تغيير المعلمات عشوائيًا على كشف مواطن الهشاشة، لكنه لا يثبت تغطية جميع أوجه عدم التطابق الفيزيائي.[1] Magnetic control of tokamak plasmas through deep reinfo[2] Avoiding fusion plasma tearing instability with deep re
3. اشتقاق في هذا المقال: قد يُفقد تأخر بمقدار خطوة واحدة سياسةً مستقرةً دون تأخر استقرارها
لنعتبر أن قيمة x في الخطوة التالية تساوي a مضروبة في الحالة الحالية مضافًا إليها التحكم، وأن السياسة تغذية راجعة سالبة. دون تأخر، يكون مضاعف الحلقة المغلقة a−k؛ ومع تأخر بمقدار خطوة واحدة، تحدده معادلة مميزة من الدرجة الثانية. عند اختيار القيم المطبَّعة a=1.2 وk=1.1، يكون المضاعف دون تأخر 0.1، ويكون السلوك مستقرًا؛ أما مع تأخر بمقدار خطوة واحدة، فمقدار كل من الجذرين هو √1.1، وهو أكبر من الواحد، ولذلك يحدث تباعد. يحسب الشكل مباشرة مسارات النظامين ونصفي قطريهما الطيفيين. وهذا ليس تقديرًا لمعلمات جهاز، بل تذكير بأن التأخر من البداية إلى النهاية جزء من نظام التحكم نفسه، وأن زمن استدلال النموذج وحده لا يكفي لإثبات قابلية النشر.作者分析与复核建议 / Author analysis
4. يجب أن تسجل سلسلة العمل الآنية الزمن الكلي من الاستشعار إلى التنفيذ
تتضمن التغذية الراجعة الفعلية جمع بيانات التشخيص، والمعالجة المسبقة، وتقدير الحالة، وحساب السياسة، والاتصال، واستجابة المشغلات. يقترح هذا المقال قياس التوزيع الكامل باستخدام طوابع زمنية عتادية، والإبلاغ بصورة منفصلة عن الذيل وتجاوزات المهلة، بدل الاكتفاء بنشر متوسط زمن مرور أمامي واحد في الشبكة. إذا استمرت السياسة في إخراج أفعال تبدو صالحة رغم تقادم المدخلات، فقد تُغلق الحلقة اعتمادًا على حالة خاطئة. ينبغي تحديد حالات الرصد المتقادم وفقد الحزم وعدم تنفيذ الأفعال مسبقًا، واحتساب تدخل السياسة الاحتياطية ضمن النتائج. وقد تظل لمرحلة تجريبية تعتمد كثيرًا على تصحيحات بشرية أو من أنظمة الحماية قيمة بحثية، لكن يجب فصلها عن معدل إتمام المهمة بالسياسة وحدها.作者分析与复核建议 / Author analysis
5. ينبغي تقييم خطأ التتبع والمخاطر كلٌّ على حدة
تراعي دراسة تجنب التمزق في DIII-D التشغيل عالي الأداء ومخاطر عدم الاستقرار معًا، ما يبين أن هدف التحكم لا يقتصر على تتبع قيمة مرجعية معينة. يقسم هذا المقال الهدف العام إلى متوسط خسارة التتبع واحتمال الحالات غير المقبولة، ويعبر عن العلاقة بينهما بصيغة مقيدة. وهذه الصيغة لا تقدم بحد ذاتها ضمانًا فعليًا للسلامة: فقد يكون مُقدِّر المخاطر غير معاير بما يكفي، وقد يتغير أيضًا توزيع عينات عدم الاستقرار النادرة. ينبغي أن يسرد التقييم انتهاكات القيود وموثوقية درجات المخاطر وزمن التعافي والأداء التشغيلي، وألا يسمح للأخطاء المنخفضة في عدد كبير من اللحظات الطبيعية بحجب عدد قليل من الانحرافات الشديدة.[2] Avoiding fusion plasma tearing instability with deep re
6. تحليل في هذا المقال: تشبع المشغلات يغير الحلقة المغلقة الفعلية
تصبح التغذية الراجعة الصالحة في النموذج الخطي ديناميكيات مختلفة عندما تبلغ الأفعال حدود السعة أو معدل التغير. يقترح هذا المقال اتخاذ عدد مرات التشبع ومدتها ومناطق الحالة مؤشرات تشخيصية رئيسية؛ فإذا كانت السياسة تحقق الخطأ المنخفض أساسًا بالوصول المستمر إلى الحدود، فقد يكون هامش استقرائها ضيقًا جدًا. ولا تستخدم المسارات المقيدة في الشكل إلا تقييدًا صريحًا ومطبَّعًا للسعة، لإظهار أن الكسب نفسه قد ينتج سلوكًا مختلفًا باختلاف الحالات الابتدائية. وهي لا تمثل حدود تشغيل التوكاماك، ولا توصي بنقل معلمات التحكم التحليلية مباشرة إلى المعدات.作者分析与复核建议 / Author analysis
7. ينبغي أن تكون الوحدات الإحصائية هي التفريغات وظروف التشغيل، لا خطوات التحكم
قد تأتي عشرات الآلاف من خطوات التحكم من التفريغ نفسه، وتكون مترابطة بشدة. يقترح هذا المقال اعتماد التفريغات أو ظروف التشغيل المحددة مسبقًا بوصفها الوحدات الإحصائية الأساسية، مع الاحتفاظ بسجلات على مستوى الخطوة لأغراض التشخيص. وعند مقارنة السياسات، ينبغي مطابقة نطاق التشغيل والظروف الابتدائية وتعقيد الأهداف، والإبلاغ عن جميع الاختبارات المقررة، بما فيها تلك التي أُوقفت لأسباب تتعلق بالتشخيص أو المشغلات أو السياسة. ولا يجوز اعتبار كل خطوة تحكم في تفريغ واحد سار بسلاسة نجاحًا مستقلًا، ثم استخدام العدد الهائل للعينات لتقديم فواصل ثقة بعرض يكاد يساوي الصفر.作者分析与复核建议 / Author analysis
8. فصل إسهامات الحماية والتحكم الاحتياطي وسياسات التعلم
يمكن أن يضم نظام تحكم واقعي سياسة تعلم ومتحكمًا تقليديًا وحماية مستقلة في الوقت نفسه. يرى هذا المقال أن هذا التقسيم الطبقي تصميم هندسي معقول، لكن يجب أن يكون تدخل كل طبقة قابلًا للتتبع: متى تولت التحكم، وما الشروط التي حفزت ذلك، وهل كانت الحالة قد انحرفت قبل توليها، وهل تظل النتائج بعد التعافي محسوبة ضمن نقطة النهاية الأساسية. وإذا كان أداء السياسة يعتمد على تصحيحات متكررة من الحماية، فينبغي الإبلاغ عن ذلك بأمانة. كما لا يجوز أن توجد أنظمة الحماية في المحاكاة وحدها؛ ويجب أن توضح استنتاجات البحث الآليات التي شُغلت على أجهزة حقيقية وتلك التي لا تزال مقترحات.作者分析与复核建议 / Author analysis
9. سُلَّم تحقق قابل للتوسع التدريجي
نقترح إجراء مسح للمعلمات المتعلقة بالتأخر والضوضاء وتقييد السعة أولًا على نموذج ديناميكي مجمَّد، ثم الاختبار على نموذج مستقل، ثم التحقق تدريجيًا باستخدام تنبؤات في وضع الظل وظروف تشغيل محدودة. ويجب أن تُحدد مسبقًا في كل مستوى قواعد الإيقاف والنطاق المسموح ونقاط النهاية الأساسية، مع الاحتفاظ بإخفاقات المستويات السابقة. ولا يمكن التوسع إلى أشكال جديدة أو أجهزة جديدة أو مدد تشغيل أطول إلا بعد تجميع أدلة مكتملة بالقدر الكافي ضمن النطاق الحالي. وهذا السلم إطار لتقييم البحوث، وليس تشغيلًا لأجهزة أُنجز في هذا المقال؛ ولا يزال النقل بين الأجهزة يتطلب إعادة تحديد الرصود والأفعال والقيود الفيزيائية.作者分析与复核建议 / Author analysis
ملحق تقني A · الحالة القابلة للرصد جزئيًا وترميز التاريخ
لا يستطيع متحكم البلازما عادة قراءة الحالة الفيزيائية كاملة مباشرة، بل يعتمد على التشخيص والتاريخ لتقديرها. وقد يقابل رصدان حاليان متطابقان حالتين خفيتين مختلفتين، ومن ثم يحتاجان إلى فعلين مختلفين. يقترح هذا المقال التمييز بين ترميز الرصد وتقدير الحالة والسياسة، واختبار طول التاريخ والبيانات المفقودة وانجراف التشخيص. وإذا استكملت السياسة المعلومات بذاكرة تكرارية، فينبغي حفظ كيفية تهيئة الحالة الخفية عند إعادة الضبط وتولي التحكم. فالحالة التي تعمل جيدًا مدة طويلة قد لا تظل صالحة بعد إعادة تشغيل البرمجيات أو تبديل المتحكم؛ ويعد سلوك التهيئة هذا جزءًا من التحقق من الحلقة المغلقة.作者分析与复核建议 / Author analysis
ملحق تقني B · العقوبات في المكافأة لا تعادل القيود الصارمة
يغير إسناد مكافأة سالبة كبيرة للحالات عالية المخاطر تفضيلات التحسين في المتوسط، لكن العقوبة المحدودة قد تظل تسمح للسياسة بقبول عدد قليل من الانتهاكات مقابل مكاسب قصيرة الأجل. وإذا ادعت الدراسة الالتزام بنطاق صارم، فيجب التعبير عنه بقيود مستقلة أو آلية ترشيح جرى التحقق منها، مع بيان أخطاء القياس. يقترح هذا المقال تسجيل الأفعال المقترحة قبل فرض القيود والأفعال المنفذة فعليًا معًا، للتمييز بين ما تعلمته السياسة وما صححه الترشيح الخارجي. ويجب إدراج تكرار تفعيل القيود في التقرير، وألا يُتجاهل تكرر تولي التحكم لمجرد أن المسار النهائي مستقر.作者分析与复核建议 / Author analysis
ملحق تقني C · حدود الاستقرار الدقيقة للمثال المضاد منخفض الرتبة ذي التأخر
كثيرة الحدود المميزة للنظام ذي التأخر بمقدار خطوة واحدة هي z²−az+k. وفي حالة الدرجة الثانية ذات المعاملات الحقيقية، يتطلب وقوع الجذور داخل دائرة الوحدة تحقق الشروط 1−a+k>0 و1+a+k>0 و1−k>0 معًا. تخالف القيمتان a=1.2 وk=1.1 في هذا المقال الشرط الأخير، رغم أن النظام دون تأخر مستقر جدًا. ويوفر هذا المعيار مسار تحقق مستقلًا ثانيًا لنصف القطر الطيفي في الشكل. وهو لا ينطبق إلا على هذا النموذج القياسي المتقطع، لكنه يبين بوضوح ضرورة التصميم المشترك لكسب التحكم والتأخر والاستقرار، وعدم زيادة شدة الاستجابة بمعزل عنها.作者分析与复核建议 / Author analysis
ملحق تقني D · النقل بين الأجهزة يبدأ بالواجهات والمطابقة الفيزيائية
تختلف الأجهزة في عدد المشغلات والاقتران والتشخيص ونطاق التشغيل، ولا تعني إعادة استخدام أوزان السياسة مباشرة أن مسألة التحكم واحدة. يقترح هذا المقال أولًا توضيح المتغيرات التي يمكن جعلها بلا أبعاد أو إنشاء مطابقة مكافئة لها، والمتغيرات التي لا تزال تحتاج إلى إعادة تحديد، ثم مقارنة كفاءة استخدام العينات التي يحققها النقل. وإذا تغير الهدف أو قيود الأفعال، فينبغي تعريف مهمة جديدة بصورة مستقلة، بدل الاكتفاء بتسميتها نقلًا دون عينات. ويجب أن تسرد تقارير الأداء تكاليف إعادة المعايرة والتصميم اليدوي وتحديث المحاكاة، كي يمكن تقدير مقدار موارد التجارب الحقيقية التي وفرتها سياسة التعلم نفسها.作者分析与复核建议 / Author analysis
10. الخلاصة: أدلة الحلقة المغلقة أهم من درجات السياسة
أهم إسهام للتحكم القائم على التعلم هو تحويل الأهداف المعقدة إلى سلوك تغذية راجعة يمكن اختباره في أنظمة حقيقية. يوضح المثال المضاد المتعلق بالتأخر في هذا المقال وجود حلقة وصل بين دقة النموذج واستقرار التحكم يجب اجتيازها بصورة مستقلة. وينبغي وضع نتائج دراسات TCV وDIII-D في سياق أجهزتها ومهامها، بينما تحتاج الأعمال المقبلة إلى مزيد من التفريغات الكاملة وظروف التشغيل الحدية وسجلات التحكم الاحتياطي. وينبغي أن تتيح المخرجات الجديرة بالثقة للباحثين تتبع أي انحراف إلى الرصد والسياسة والفعل والتأخر والحماية، بدل الاحتفاظ فقط بأكثر صور البلازما نجاحًا.作者分析与复核建议 / Author analysis
المعادلات والاشتقاقات الأساسية
(1) نظام قياسي مُنشأ ذو تغذية راجعة سالبة دون تأخر؛ يتطلب الاستقرار |a−k|<1.
LaTeX
x_{t+1}=a x_t+u_t,\qquad u_t=-k x_t(2) يغير التأخر بمقدار خطوة واحدة الجذور المميزة للحلقة المغلقة؛ عند a=1.2 وk=1.1، يكون مقدار الجذر √1.1>1.
LaTeX
u_t=-k x_{t-1}\quad\Longrightarrow\quad z^2-a z+k=0(3) هدف عام للتحكم المقيد بالمخاطر؛ لا تعني كتابة القيد أن الحد الأعلى للمخاطر الفعلية قد جرى التحقق منه.
LaTeX
\min_\pi\ \mathbb E\!\sum_t\gamma^t\ell(x_t,u_t)\quad\mathrm{s.t.}\quad P_\pi(\exists t:x_t\notin\mathcal S)\le\varepsilon(4) تعريف التأخر الكلي من الاستشعار إلى التنفيذ؛ يجب الإبلاغ بصورة منفصلة عن التذبذب الزمني والذيل والفقد.
LaTeX
\tau_{\mathrm{loop}}=\tau_{\mathrm{sense}}+\tau_{\mathrm{estimate}}+\tau_{\mathrm{infer}}+\tau_{\mathrm{transport}}+\tau_{\mathrm{actuate}}مسار المنهج والأدلة
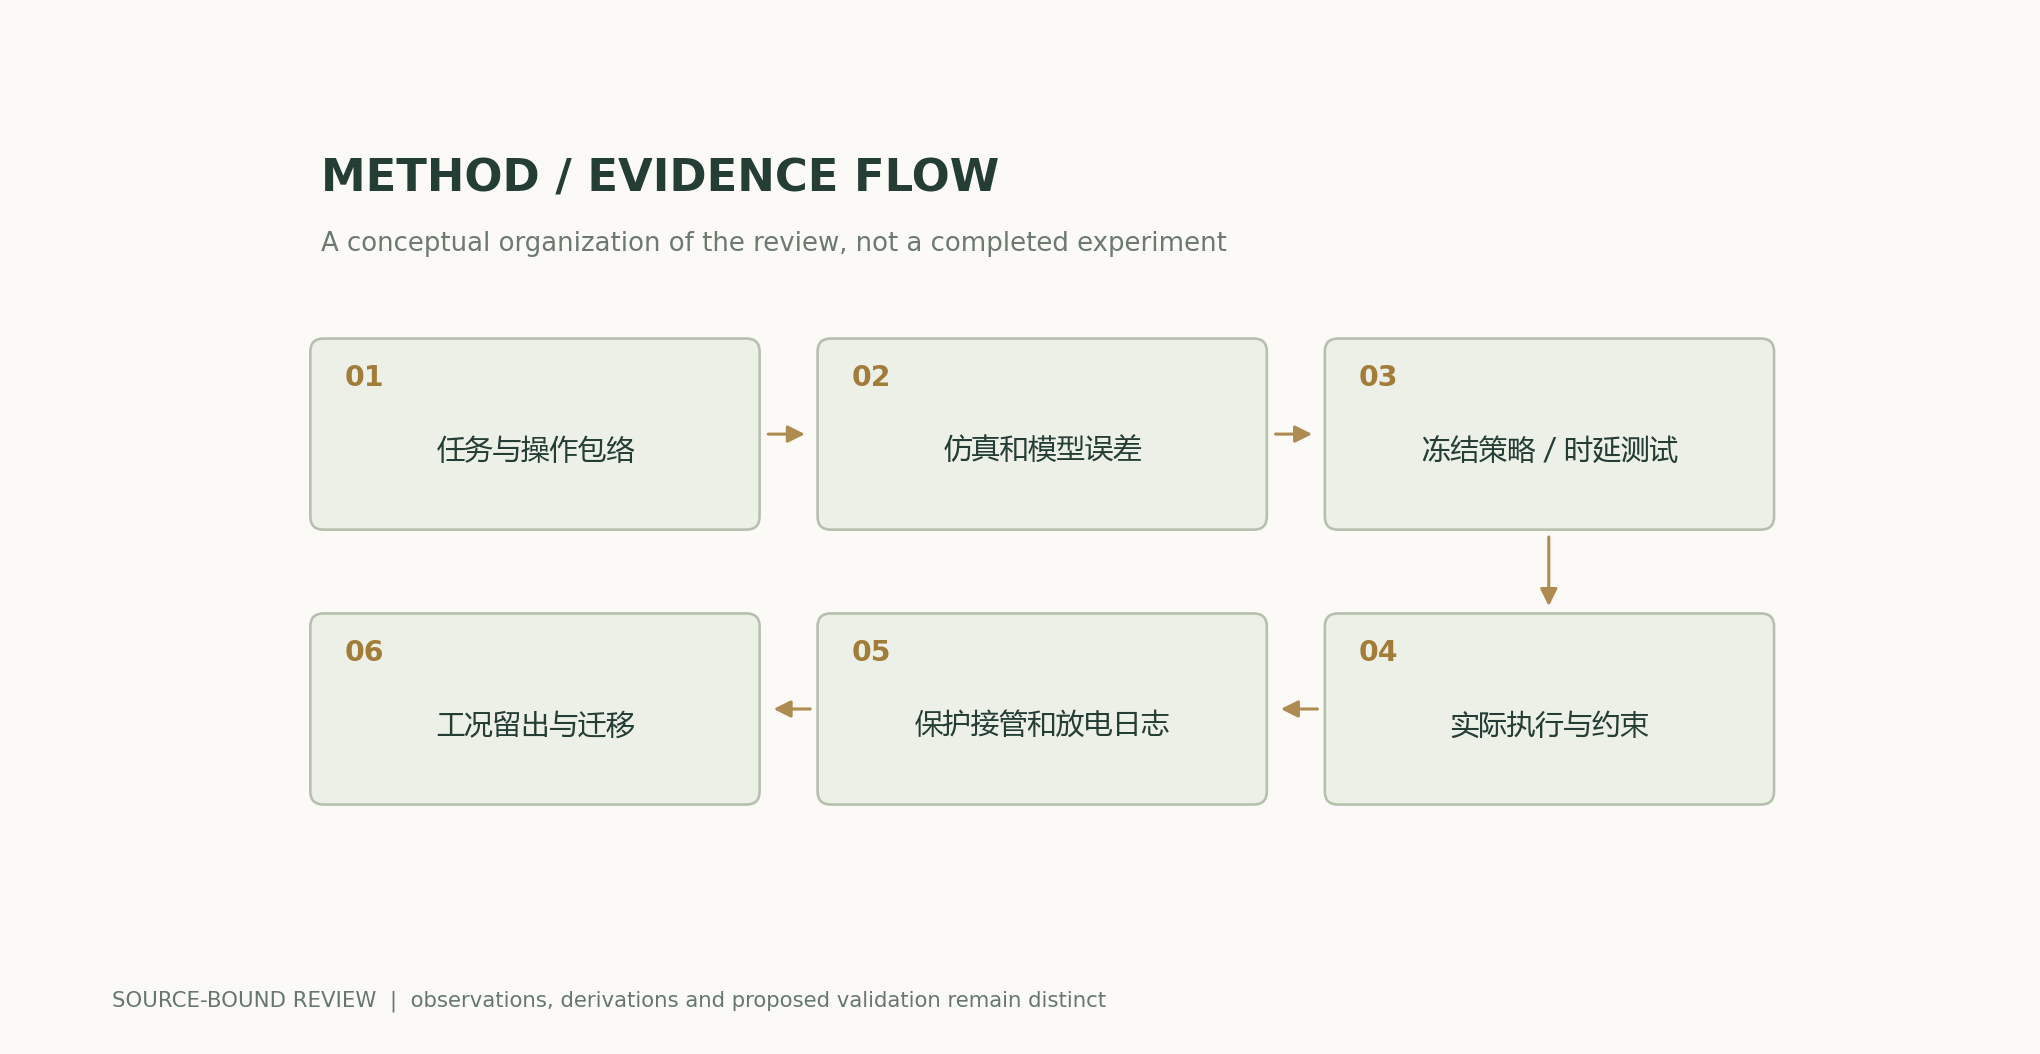
رسوم تحليلية وأمثلة عددية
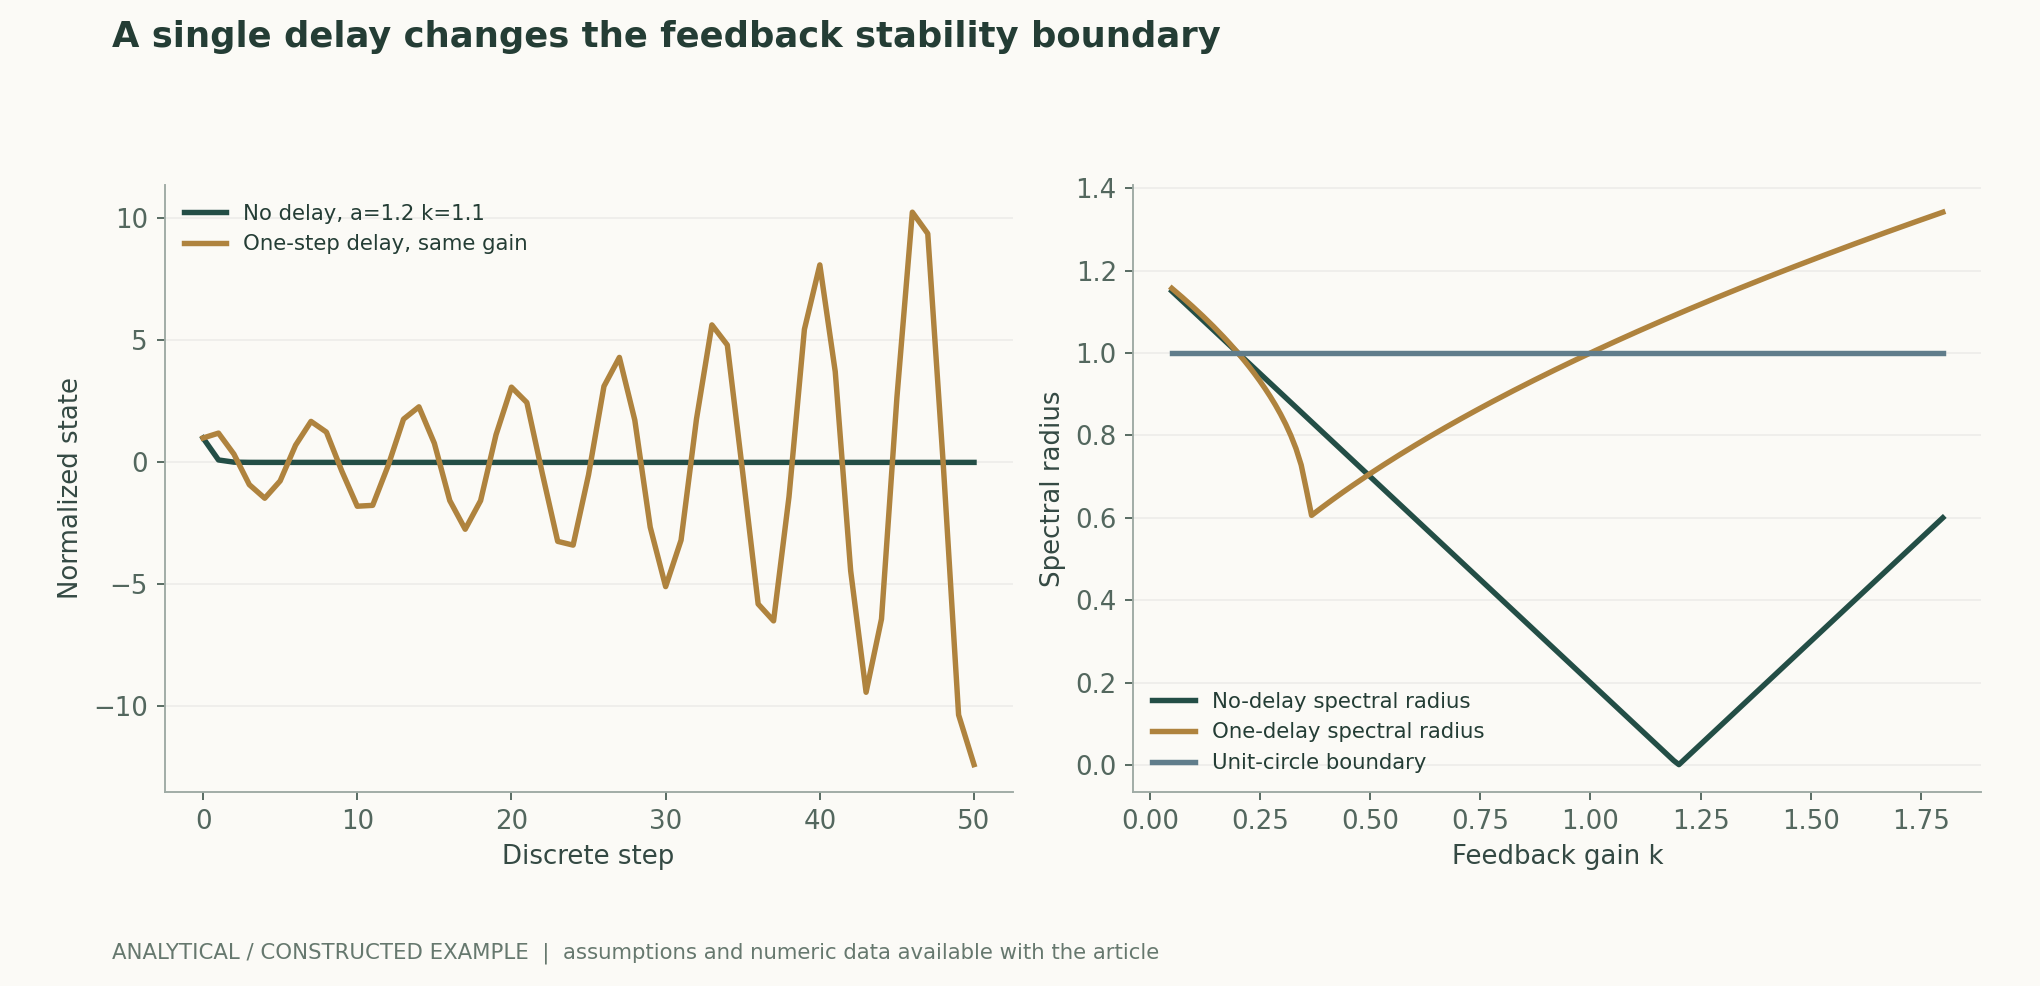
مثال محلول قابل لإعادة الحساب
المضاعف دون تأخر هو 0.1؛ ومقدار جذر المعادلة المميزة ذات التأخر بمقدار خطوة واحدة z^2-1.2z+1.1 هو sqrt(1.1)≈1.04881، ويتجاوز 1.
مقارنة المناهج
| الطبقة | الأدلة التي ينبغي قياسها | الاستعاضة الخاطئة |
|---|---|---|
| تقدير الحالة | الانحياز والتأخر والقياسات المفقودة | مدخلات السياسة هي دائمًا الحالة الحقيقية |
| هدف السياسة | فصل التتبع عن المخاطر | ارتفاع مكافأة واحدة يعادل الموثوقية |
| التنفيذ | حدود السعة ومعدل التغير وعدم التنفيذ | صلاحية المخرج تعني أن الفعل أصبح نافذًا |
| التأخر | التوزيع عبر السلسلة الكاملة | زمن المرور الأمامي يمثل الحلقة المغلقة |
| الحماية والتحكم الاحتياطي | سجلات التفعيل وتولي التحكم والتعافي | احتساب نجاح الحماية نجاحًا مستقلًا للسياسة |
| عبر ظروف التشغيل | مقارنة متطابقة على مستوى التفريغ | اعتبار خطوات التحكم تجارب مستقلة |
خطة المراجعة والتجارب
- تثبيت الرصود والأفعال والأهداف ونطاق التشغيل لمهمة الجهاز.
- حفظ أخطاء النموذج الديناميكي ونطاق التدريب، وعدم اعتبار عشوائية المعلمات تغطية شاملة.
- إجراء مسح للتأخر والضوضاء وحدود السعة والحالات الابتدائية باستخدام سياسة مجمَّدة.
- تسجيل السلسلة الكاملة من الاستشعار إلى التنفيذ باستخدام طوابع زمنية عتادية.
- التسجيل المسبق لنقاط نهاية مستقلة، مثل الانتهاكات والتتبع والتعافي والتحكم الاحتياطي.
- اعتماد التفريغات وظروف التشغيل وحدات إحصائية، وإدراج جميع حالات الإيقاف في المقام.
- فصل تدخلات التحكم التقليدي والبشر والحماية عن نتائج السياسة المستقلة.
- إعادة التحقق قبل النقل بين الأجهزة أو توسيع النطاق؛ ولا تُستخدم المسارات التحليلية في هذا المقال مدخلاتٍ للتحكم في الأجهزة.
نطاق الانطباق والقيود
- النظام الخطي المطبَّع لا يصف بلازما حقيقية.
- لم يتعامل هذا المقال مع معدات، ولم ينفذ تحكمًا، ولم ينتج بيانات تفريغ جديدة.
- صيغة التحسين المقيد لا تقدم بحد ذاتها برهانًا على السلامة.
- لا يمكن لعدد محدود من التفريغات استبعاد جميع المسارات النادرة لعدم الاستقرار.
- لا تسمح الفروق بين مهام TCV وDIII-D وأجهزتهما بدمج معدلات النجاح مباشرة.
أدلة الدراسات الأصلية ونطاق انطباقها
| نتائج الدراسات الأصلية | نطاق الانطباق | المصدر والموضع |
|---|---|---|
| أظهرت تجارب TCV تحكمًا قائمًا على التعلم في أشكال مغناطيسية متعددة. | مقيد بالجهاز الأصلي والرصود ونطاق المهام. | التحكم المغناطيسي في بلازما التوكاماك بواسطة التعلم المعزز العميقالملخص وتجارب التحكم |
| درست تجارب DIII-D تجنب التمزق أثناء التشغيل عالي الأداء. | تختلف عن التحكم المغناطيسي في الشكل؛ ويجب التحقق من تقدير المخاطر ونطاق التشغيل بصورة منفصلة. | تجنب عدم استقرار التمزق في بلازما الاندماج باستخدام التعلم المعزز العميقالملخص وتقييم المتحكم |
أسئلة بحثية جديرة بالاختبار
- ما مدى تأثير ذيل توزيع التأخر من البداية إلى النهاية في نطاق استقرار السياسة؟
- ما أخطاء النموذج الأكثر احتمالًا للتسبب في تشبع الأفعال وعدم تطابق المخاطر؟
- بعد مطابقة ظروف التشغيل، هل يمكن أن يستمر الإسهام المستقل لسياسة التعلم عبر دفعات التفريغ؟
المصادر الأولية والادعاءات المرتبطة بها
- Magnetic control of tokamak plasmas through deep reinforcement learningDegrave et al. · 2022TCV magnetic shape-control experiments, simulator training and device-specific control scope.
- Avoiding fusion plasma tearing instability with deep reinforcement learningSeo et al. · 2024-02-21DIII-D tearing-avoidance controller; model-based training and high-performance operational constraints.
الاستشهاد وتصدير المقال
BibTeXRISCSL JSONTXTالمقال JSON
المؤلف والإصدار والمصادر
مراجعة بحثية موثقة بالمصادر وتحليل أصيل أعدهما Codex (ذكاء اصطناعي). تعود تجارب الأوراق الأصلية إلى فرق البحث الأصلية؛ ولا تختبر حسابات هذا المقال إلا المعادلات المدرجة والافتراضات المصرح بها. لا توجد لدى هذا الموقع حتى الآن مراجعة مستقلة من الأقران لهذا المقال، ولا سجلات لنماذج أصلية أو تجارب سريرية أو فيزيائية أصلية.
النشر الأول: ملف معمق عن الذكاء الاصطناعي والاكتشاف العلمي؛ مع الحفاظ على مصادر كل قسم والحدود الفاصلة بين أدلة الدراسات الأصلية وتحليل المؤلف.
وُلِّد الغلاف المفاهيمي بواسطة ImageGen. ورُسمت الأشكال العلمية باستخدام الشيفرة والملفات العددية المرافقة، وتوضح تعليقات الأشكال الافتراضات وتعريفات القياس بندًا بندًا.
مصادر الغلاف والأشكال العلمية · البيانات والمصادر والافتراضات · Python · شيفرة لإعادة الحساب · سجل النشر والإصدارات
مراجعة المصدر: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c