
Resumen
El control basado en aprendizaje ha demostrado capacidades de control de forma y evitación de inestabilidades en experimentos de tokamak, pero no es posible combinar dispositivos, tareas y escalas temporales diferentes en una tasa de éxito universal. Este artículo compara el control magnético de la forma en TCV con los trabajos de evitación del desgarro en DIII-D, separando en capas la estimación del estado, la política, las restricciones de ejecución y los sistemas de protección. Mediante un contraejemplo de realimentación lineal con retardo, mostramos que la precisión de la predicción en lazo abierto no garantiza la estabilidad en lazo cerrado; mediante un objetivo sujeto a restricciones de riesgo, mostramos que un error medio de seguimiento bajo no compensa desviaciones infrecuentes pero graves. Los gráficos contienen únicamente cálculos de sistemas de control normalizados, sin parámetros de dispositivos reales, operación de plasma ni instrucciones de control experimental.[1] Magnetic control of tokamak plasmas through deep reinfo[2] Avoiding fusion plasma tearing instability with deep re
Traducción del resumen original en inglés
El control del plasma basado en aprendizaje debe satisfacer objetivos en lazo cerrado bajo dinámicas inciertas y restricciones operativas estrictas. Examinamos los estudios de control magnético de la forma en TCV y de evitación del desgarro en DIII-D como logros distintos. Un sistema escalar de realimentación con retardo demuestra por qué la precisión nominal puede coexistir con la inestabilidad; un objetivo sujeto a restricciones de riesgo separa el seguimiento de las desviaciones inaceptables. Proponemos una evaluación por descarga con políticas congeladas, envolventes operativas equiparadas y contabilización explícita del control de respaldo. Aquí no se realiza ninguna operación de reactor ni se genera ninguna señal de control real.
1. El control magnético de la forma y la evitación de inestabilidades no son la misma tarea
El estudio de TCV utiliza una política aprendida para controlar las bobinas magnéticas y obtener diversas formas de plasma; el estudio de DIII-D utiliza un modelo dinámico para entrenar una política que reduce el riesgo de inestabilidad de desgarro mientras sigue estados de alto rendimiento. Ambos demuestran que el control basado en aprendizaje puede integrarse en un lazo cerrado físico real, pero difieren en sus objetivos, observaciones, actuadores y rangos operativos. Este artículo recomienda describir primero cada estudio mediante una tupla de estado, acción, objetivo y restricciones, indicando qué variables se miden directamente y cuáles se estiman. Sin equiparar antes las tareas, comparar «números de éxitos» puede reflejar únicamente diferencias en la dificultad del objetivo y en la envolvente operativa.[1] Magnetic control of tokamak plasmas through deep reinfo[2] Avoiding fusion plasma tearing instability with deep re
2. El entrenamiento en simulación permite una exploración sistemática, pero está limitado por el error del modelo
El trabajo de TCV entrena una política de control mediante simulación y la valida en experimentos con el dispositivo, mientras que el de DIII-D utiliza para el entrenamiento un modelo dinámico que predice la inestabilidad. La simulación permite explorar políticas con un coste experimental menor, pero las diferencias respecto al sistema real pueden proceder de retardos de respuesta, saturación de actuadores, sesgos de diagnóstico y estados no modelados. Este artículo aboga por conservar el alcance de aplicación y la distribución de errores del modelo de entrenamiento, y por validar por separado en condiciones distintas de la envolvente de entrenamiento. La aleatorización de parámetros ayuda a revelar vulnerabilidades, pero no demuestra que se cubran todos los desajustes físicos.[1] Magnetic control of tokamak plasmas through deep reinfo[2] Avoiding fusion plasma tearing instability with deep re
3. Derivación de este artículo: un retardo de un paso puede desestabilizar una política estable sin retardo
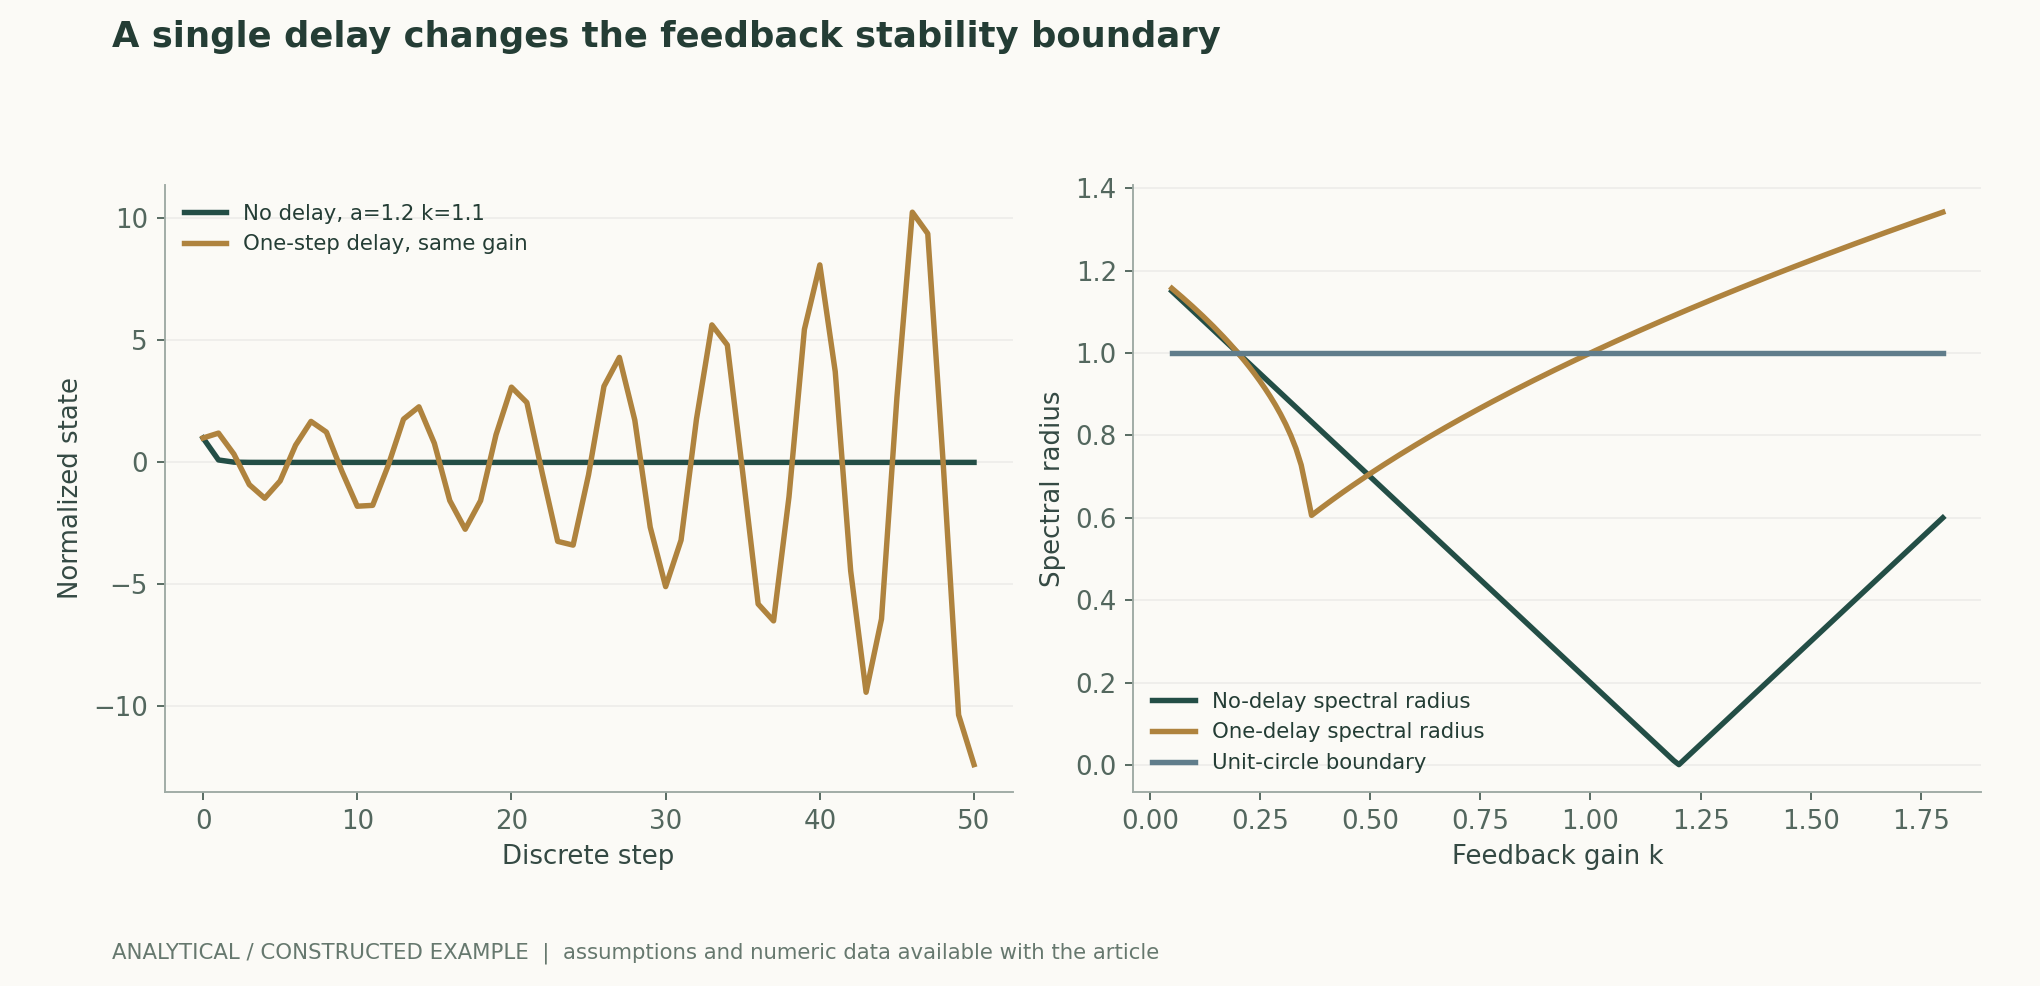
Consideremos un sistema en el que el siguiente valor de x es igual a a veces el estado actual más el control, con una política de realimentación negativa. Sin retardo, el multiplicador en lazo cerrado es a−k; con un retardo de un paso, lo determina una ecuación característica de segundo orden. Tomando los valores normalizados a=1.2 y k=1.1, el multiplicador sin retardo es 0.1, con un comportamiento estable; con un retardo de un paso, el módulo de ambas raíces es √1.1, mayor que uno, por lo que el sistema diverge. La figura calcula directamente las trayectorias y los radios espectrales de ambos sistemas. No se trata de una estimación de parámetros del dispositivo, sino de un recordatorio de que el retardo de extremo a extremo forma parte del propio sistema de control: el tiempo de inferencia del modelo por sí solo no demuestra la viabilidad de su despliegue.作者分析与复核建议 / Author analysis
4. La cadena en tiempo real debe registrar el tiempo total desde la detección hasta la actuación
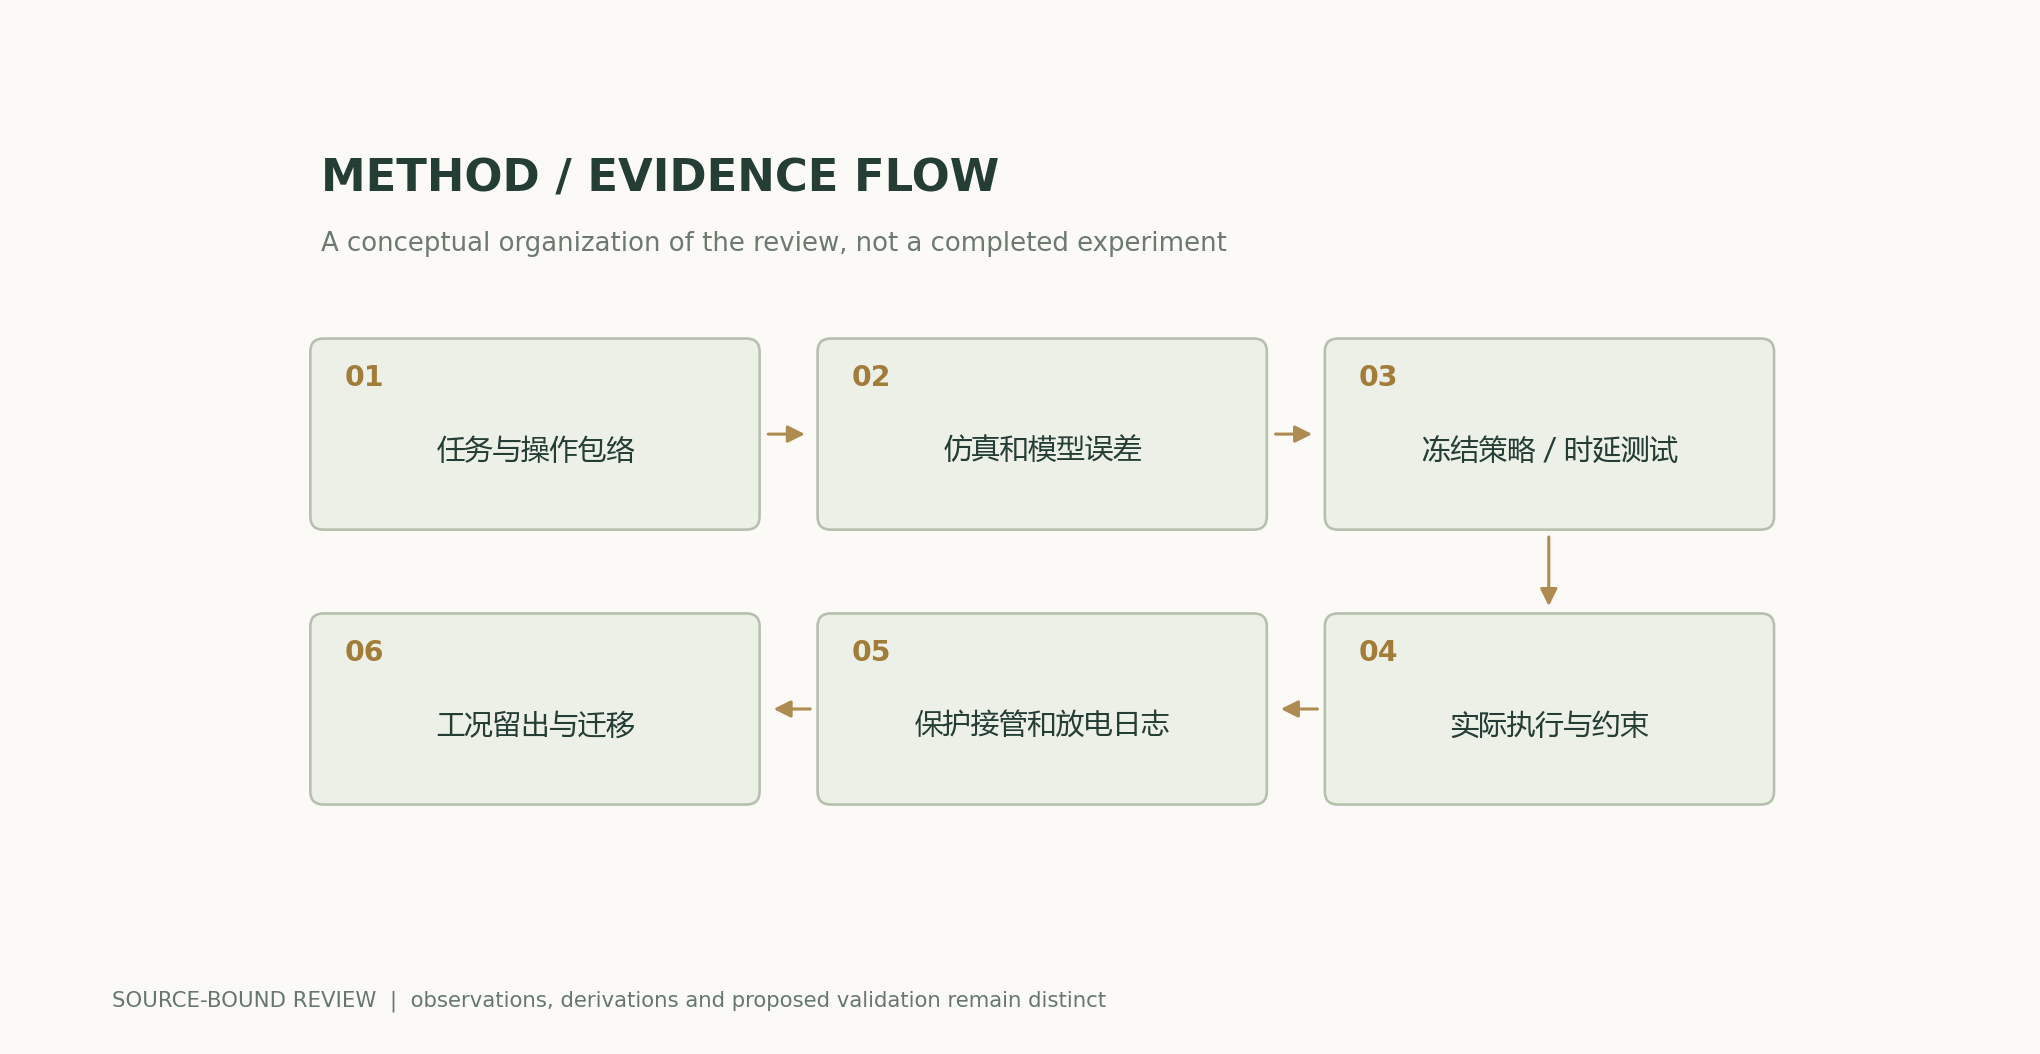
La realimentación real incluye la adquisición de diagnósticos, el preprocesamiento, la estimación del estado, el cálculo de la política, la comunicación y la respuesta de los actuadores. Este artículo recomienda medir la distribución completa mediante marcas de tiempo de hardware e informar por separado sobre la cola y los vencimientos de plazo, en lugar de publicar únicamente el tiempo medio de una pasada hacia delante de la red. Si una política sigue produciendo acciones aparentemente válidas con entradas obsoletas, el sistema puede cerrar el lazo sobre un estado incorrecto. Deben definirse de antemano las situaciones de observaciones caducadas, pérdida de paquetes y acciones no ejecutadas, y contabilizar en los resultados las intervenciones de la política de respaldo. Una fase experimental que depende en gran medida de correcciones humanas o del sistema de protección puede conservar valor científico, pero debe distinguirse de la tasa de finalización independiente de la política.作者分析与复核建议 / Author analysis
5. El error de seguimiento y el riesgo deben evaluarse por separado
El estudio de evitación del desgarro en DIII-D considera conjuntamente la operación de alto rendimiento y el riesgo de inestabilidad, lo que demuestra que el objetivo de control no consiste solo en seguir un valor de referencia. Este artículo divide el objetivo general en la pérdida media de seguimiento y la probabilidad de estados inaceptables, y expresa su relación mediante restricciones. Esta formulación no proporciona por sí misma una garantía real de seguridad: el estimador de riesgo puede estar insuficientemente calibrado, y también puede cambiar la distribución de las escasas muestras de inestabilidad. La evaluación debe enumerar las violaciones de restricciones, la fiabilidad de las puntuaciones de riesgo, el tiempo de recuperación y el rendimiento operativo, sin permitir que los errores bajos en numerosos instantes normales oculten unas pocas desviaciones graves.[2] Avoiding fusion plasma tearing instability with deep re
6. Análisis de este artículo: la saturación de los actuadores modifica el lazo cerrado efectivo
La realimentación válida en un modelo lineal pasa a obedecer otra dinámica cuando las acciones alcanzan límites de amplitud o de tasa de variación. Este artículo recomienda considerar el número de saturaciones, su duración y las regiones del estado como diagnósticos principales; si una política consigue errores bajos sobre todo alcanzando continuamente los límites, su margen de extrapolación puede ser muy reducido. Las trayectorias restringidas de la figura emplean únicamente una limitación de amplitud normalizada y explícita para mostrar que una misma ganancia puede comportarse de forma distinta con estados iniciales diferentes. No representan límites operativos de tokamaks ni recomiendan transferir directamente parámetros analíticos de control a los equipos.作者分析与复核建议 / Author analysis
7. Las unidades estadísticas deben ser las descargas y las condiciones de operación, no los pasos de control
Decenas de miles de pasos de control pueden proceder de una sola descarga y estar fuertemente correlacionados. Este artículo propone utilizar las descargas o las condiciones operativas predefinidas como unidades estadísticas principales, conservando registros por paso para el diagnóstico. Al comparar políticas, deben equipararse el rango operativo, las condiciones iniciales y la complejidad de los objetivos, e informarse todos los ensayos previstos, incluidos los interrumpidos por motivos relacionados con los diagnósticos, los actuadores o la política. No se debe considerar cada paso de control de una descarga satisfactoria como un éxito independiente y luego utilizar un enorme tamaño muestral para obtener intervalos de confianza de anchura casi nula.作者分析与复核建议 / Author analysis
8. Separar las contribuciones de la protección, el control de respaldo y las políticas aprendidas
Un sistema de control real puede incluir simultáneamente una política aprendida, un controlador convencional y protección independiente. Este artículo considera que esta organización por capas es un diseño de ingeniería razonable, pero la intervención de cada capa debe ser trazable: cuándo asumió el control, qué condiciones la activaron, si el estado ya se había desviado antes de la toma de control y si los resultados posteriores a la recuperación siguieron contabilizándose en el criterio de valoración principal. Si el rendimiento de la política depende de correcciones frecuentes de la protección, debe indicarse fielmente. Los sistemas de protección tampoco pueden existir solo en simulación; las conclusiones deben especificar qué mecanismos han funcionado en dispositivos reales y cuáles siguen siendo propuestas.作者分析与复核建议 / Author analysis
9. Una escala de validación ampliable progresivamente
Proponemos realizar primero barridos de retardo, ruido y límites de amplitud con un modelo dinámico congelado, después probar con un modelo independiente y, a continuación, validar progresivamente mediante predicciones en modo sombra y condiciones operativas limitadas. Cada nivel debe especificar previamente reglas de parada, la envolvente permitida y los criterios de valoración principales, conservando los fallos de las etapas anteriores. Solo tras acumular evidencia suficientemente completa dentro del alcance actual se puede ampliar a nuevas formas, nuevos dispositivos o tiempos de operación mayores. Esta escala es un marco de evaluación de la investigación, no una operación de dispositivos realizada en este artículo; la transferencia entre dispositivos sigue exigiendo identificar de nuevo las observaciones, las acciones y las restricciones físicas.作者分析与复核建议 / Author analysis
Suplemento técnico A · Estados parcialmente observables y codificación del historial
Los controladores de plasma normalmente no pueden acceder directamente a todo el estado físico y deben estimarlo a partir de diagnósticos e historial. Dos observaciones actuales idénticas pueden corresponder a estados ocultos diferentes y, por tanto, requerir acciones distintas. Este artículo recomienda distinguir entre codificación de observaciones, estimación del estado y política, y probar la longitud del historial, la ausencia de mediciones y la deriva de los diagnósticos. Si la política complementa la información mediante memoria recurrente, debe registrarse cómo se inicializa el estado oculto al reiniciar y asumir el control. Un estado que ha funcionado bien durante mucho tiempo puede dejar de ser válido tras reiniciar el software o cambiar de controlador; este comportamiento de inicialización forma parte de la validación en lazo cerrado.作者分析与复核建议 / Author analysis
Suplemento técnico B · Las penalizaciones en la recompensa no equivalen a restricciones estrictas
Asignar una recompensa negativa muy grande a los estados de alto riesgo modifica las preferencias medias de optimización, pero una penalización finita todavía puede permitir que la política acepte unas pocas violaciones a cambio de ganancias a corto plazo. Si un estudio afirma respetar una envolvente estricta, debe expresarla mediante restricciones independientes o un mecanismo de filtrado validado, y explicar los errores de medición. Este artículo recomienda registrar tanto las acciones propuestas sin restricciones como las realmente ejecutadas, para distinguir lo que aprendió la política de lo que corrigió el filtrado externo. La frecuencia de activación de las restricciones debe figurar en los informes; no deben ignorarse las frecuentes tomas de control porque la trayectoria final sea estable.作者分析与复核建议 / Author analysis
Suplemento técnico C · Límites exactos de estabilidad del contraejemplo de bajo orden con retardo
El polinomio característico del sistema con retardo de un paso es z²−az+k. Para un polinomio de segundo orden con coeficientes reales, que las raíces estén dentro del círculo unidad requiere que se cumplan simultáneamente 1−a+k>0, 1+a+k>0 y 1−k>0. Los valores a=1.2 y k=1.1 empleados en este artículo incumplen la última condición, aunque el sistema sin retardo es muy estable. Este criterio proporciona una segunda vía independiente de verificación del radio espectral de la figura. Solo se aplica a este modelo escalar en tiempo discreto, pero muestra claramente que la ganancia de control, el retardo y la estabilidad deben diseñarse conjuntamente; no se puede aumentar de forma aislada la intensidad de la respuesta.作者分析与复核建议 / Author analysis
Suplemento técnico D · La transferencia entre dispositivos comienza por las interfaces y las correspondencias físicas
Los dispositivos difieren en el número de actuadores, los acoplamientos, los diagnósticos y las envolventes operativas; reutilizar directamente los pesos de una política no equivale a resolver el mismo problema de control. Este artículo propone aclarar primero qué variables pueden adimensionalizarse o asociarse mediante una correspondencia equivalente y cuáles requieren nueva identificación, para después comparar la eficiencia muestral obtenida mediante la transferencia. Si cambian el objetivo o las restricciones de las acciones, debe definirse una nueva tarea por separado, en lugar de denominarla simplemente transferencia sin ejemplos. Los informes de rendimiento deben enumerar los costes de recalibración, diseño manual y actualización de la simulación para determinar cuántos recursos experimentales reales ahorra la propia política aprendida.作者分析与复核建议 / Author analysis
10. Conclusión: la evidencia en lazo cerrado importa más que las puntuaciones de las políticas
La contribución más importante del control basado en aprendizaje consiste en convertir objetivos complejos en comportamientos de realimentación comprobables en sistemas reales. El contraejemplo con retardo de este artículo muestra que existe una brecha entre la precisión del modelo y la estabilidad del control que debe salvarse por separado. Los resultados de TCV y DIII-D deben situarse en las condiciones de sus respectivos dispositivos y tareas, mientras que los trabajos futuros necesitan más descargas completas, condiciones operativas de frontera y registros de respaldo. Un resultado fiable debe permitir a los investigadores rastrear una desviación hasta las observaciones, la política, las acciones, los retardos y la protección, en lugar de conservar únicamente las imágenes de plasma más exitosas.作者分析与复核建议 / Author analysis
Ecuaciones y derivaciones fundamentales
(1) Sistema escalar construido con realimentación negativa sin retardo; la estabilidad requiere |a−k|<1.
LaTeX
x_{t+1}=a x_t+u_t,\qquad u_t=-k x_t(2) Un retardo de un paso modifica las raíces características del lazo cerrado; con a=1.2 y k=1.1, su módulo es √1.1>1.
LaTeX
u_t=-k x_{t-1}\quad\Longrightarrow\quad z^2-a z+k=0(3) Objetivo general de control sujeto a restricciones de riesgo; formular la restricción no equivale a haber validado una cota superior del riesgo real.
LaTeX
\min_\pi\ \mathbb E\!\sum_t\gamma^t\ell(x_t,u_t)\quad\mathrm{s.t.}\quad P_\pi(\exists t:x_t\notin\mathcal S)\le\varepsilon(4) Definición del retardo total desde la detección hasta la actuación; deben informarse por separado la variación temporal, la cola y las pérdidas.
LaTeX
\tau_{\mathrm{loop}}=\tau_{\mathrm{sense}}+\tau_{\mathrm{estimate}}+\tau_{\mathrm{infer}}+\tau_{\mathrm{transport}}+\tau_{\mathrm{actuate}}Flujo de métodos y evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto que puede recalcularse
El multiplicador sin retardo es 0.1; las raíces de la ecuación característica con retardo de un paso z^2-1.2z+1.1 tienen módulo sqrt(1.1)≈1.04881, superior a 1.
Comparación de métodos
| Capa | Evidencia que debe medirse | Sustitución errónea |
|---|---|---|
| Estimación del estado | Sesgo, retardo y mediciones ausentes | Las entradas de la política siempre son el estado real |
| Objetivo de la política | Separar seguimiento y riesgo | Una recompensa individual alta equivale a fiabilidad |
| Ejecución | Límites de amplitud, tasa de variación y falta de ejecución | Una salida válida significa que la acción ya ha surtido efecto |
| Retardo | Distribución de la cadena completa | El tiempo de una pasada hacia delante representa el lazo cerrado |
| Protección y respaldo | Registros de activación, toma de control y recuperación | Contabilizar el éxito de la protección como éxito independiente de la política |
| Entre condiciones operativas | Comparación equiparada por descarga | Tratar los pasos de control como experimentos independientes |
Plan de verificación y experimentación
- Fijar las observaciones, las acciones, los objetivos y la envolvente operativa de la tarea del dispositivo.
- Conservar los errores del modelo dinámico y el rango de entrenamiento; no considerar la aleatorización de parámetros como una cobertura completa.
- Realizar barridos de retardo, ruido, límites de amplitud y estados iniciales con una política congelada.
- Registrar la cadena completa desde la detección hasta la actuación mediante marcas de tiempo de hardware.
- Prerregistrar criterios de valoración independientes para violaciones, seguimiento, recuperación y respaldo.
- Utilizar descargas y condiciones operativas como unidades estadísticas, incluyendo todos los ensayos interrumpidos en el denominador.
- Separar las intervenciones del control convencional, de personas y de la protección de los resultados independientes de la política.
- Validar de nuevo antes de transferir entre dispositivos o ampliar la envolvente; las trayectorias analíticas de este artículo no se utilizarán como entradas de control del dispositivo.
Alcance y limitaciones
- El sistema lineal normalizado no describe plasma real.
- Este artículo no accedió a equipos, ejecutó control ni generó nuevos datos de descargas.
- La expresión de optimización restringida no proporciona por sí sola una demostración de seguridad.
- Un número finito de descargas no permite descartar todas las vías infrecuentes de inestabilidad.
- Las diferencias entre las tareas y los dispositivos de TCV y DIII-D impiden combinar directamente sus tasas de éxito.
Evidencia de las investigaciones originales y su alcance
| Resultados de la investigación original | Alcance | Fuente y ubicación |
|---|---|---|
| Los experimentos de TCV demuestran el control basado en aprendizaje de diversas formas magnéticas. | Limitado al dispositivo, las observaciones y el alcance de las tareas originales. | Control magnético de plasmas de tokamak mediante aprendizaje por refuerzo profundoResumen y experimentos de control |
| Los experimentos de DIII-D investigan la evitación del desgarro durante la operación de alto rendimiento. | Difiere del control magnético de la forma; la estimación del riesgo y el rango operativo requieren comprobaciones independientes. | Evitación de la inestabilidad de desgarro del plasma de fusión mediante aprendizaje por refuerzo profundoResumen y evaluación del controlador |
Preguntas de investigación que merece la pena contrastar
- ¿Cuánto afecta la cola del retardo de extremo a extremo al intervalo de estabilidad de la política?
- ¿Qué errores del modelo desencadenan con mayor facilidad la saturación de las acciones y el desajuste del riesgo?
- Tras equiparar las condiciones operativas, ¿puede mantenerse la contribución independiente de la política aprendida entre lotes de descargas?
Fuentes primarias y afirmaciones correspondientes
- Magnetic control of tokamak plasmas through deep reinforcement learningDegrave et al. · 2022TCV magnetic shape-control experiments, simulator training and device-specific control scope.
- Avoiding fusion plasma tearing instability with deep reinforcement learningSeo et al. · 2024-02-21DIII-D tearing-avoidance controller; model-based training and high-performance operational constraints.
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación con fuentes y análisis original redactados por Codex (IA). Los experimentos de los artículos originales pertenecen a los equipos de investigación originales; los cálculos de este artículo solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio aún no dispone de una revisión por pares independiente de este artículo ni de registros de modelos originales o experimentos clínicos y físicos originales.
Primera publicación: dossier en profundidad sobre IA y descubrimiento científico; se conservan las fuentes por sección y la distinción entre la evidencia de las investigaciones originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos adjuntos; sus leyendas explican, elemento por elemento, los supuestos y las definiciones de medición.
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Python · Código para recalcular · Historial de publicación y versiones
Revisión de la fuente: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c