
要旨
学習制御はトカマク実験において形状制御と不安定性回避の能力を示してきたが、異なる装置、課題、時間スケールを一つの汎用的な成功率にまとめることはできない。本稿はTCVの磁気的形状制御とDIII-Dのテアリング回避の研究を比較し、状態推定、方策、実行制約、保護系を層別化する。遅延を含む線形フィードバックの反例によって、開ループ予測の正確さは閉ループ安定性を保証しないことを示す。また、リスク制約付きの目的によって、平均追従誤差の低さでは、まれだが深刻な逸脱を相殺できないことを示す。図は正規化した制御系の計算のみを示しており、実装置のパラメータ、プラズマ運転、実験用の制御指令は含まない。[1] Magnetic control of tokamak plasmas through deep reinfo[2] Avoiding fusion plasma tearing instability with deep re
原文の英語要旨の日本語訳
学習に基づくプラズマ制御は、不確かな動特性と厳しい運転制約の下で閉ループの目的を達成しなければならない。本稿では、TCVの磁気的形状制御とDIII-Dのテアリング回避の研究を、それぞれ異なる成果として検討する。遅延を伴うスカラーフィードバック系により、公称条件での精度と不安定性がなぜ両立しうるかを示す。また、リスク制約付きの目的により、追従と許容できない逸脱を分離する。方策を固定し、運転包絡を整合させ、フォールバックを明示的に計上する、放電単位の評価を提案する。本稿では炉の運転を行わず、実際の制御信号も生成しない。
1. 磁気的形状制御と不安定性回避は同じ課題ではない
TCVの研究は、学習方策によって磁場コイルを制御し、多様なプラズマ形状を実現する。一方、DIII-Dの研究は動的モデルを用いて方策を訓練し、高性能状態に追従しながらテアリング不安定性のリスクを低減する。いずれも学習制御を実際の物理的閉ループに組み込めることを示すが、目的、観測、アクチュエータ、運転範囲は異なる。本稿は、まず各研究を状態、行動、目的、制約の組として記述し、直接計測される変数と推定に依存する変数を明記することを提案する。先に課題を整合させなければ、「成功回数」の比較は目的の難易度や運転包絡の差を反映するだけになりうる。[1] Magnetic control of tokamak plasmas through deep reinfo[2] Avoiding fusion plasma tearing instability with deep re
2. シミュレーション訓練の価値は系統的な探索にあり、その限界はモデル誤差にある
TCVの研究はシミュレーションで制御方策を訓練し、装置実験で検証している。DIII-Dの研究は、不安定性を予測する動的モデルを訓練に用いている。シミュレーションは実験コストを抑えた方策探索を可能にするが、実系との差は応答遅延、アクチュエータ飽和、診断のバイアス、モデル化されていない状態などから生じうる。本稿は、訓練モデルの適用範囲と誤差分布を保存し、訓練包絡とは異なる条件で別途検証することを主張する。パラメータのランダム化は脆弱性の発見に役立つが、あらゆる物理的不整合を網羅した証明にはならない。[1] Magnetic control of tokamak plasmas through deep reinfo[2] Avoiding fusion plasma tearing instability with deep re
3. 本稿の導出:遅延なしで安定な方策も、一ステップの遅延によって不安定化しうる
xの次の値が現在の状態のa倍に制御入力を加えたものとなり、方策が負帰還である系を考える。遅延がない場合、閉ループの乗数はa−kとなるが、一ステップの遅延がある場合は二次の特性方程式で決まる。正規化した値a=1.2、k=1.1を取ると、遅延なしの乗数は0.1であり、安定に振る舞う。一ステップの遅延がある場合、両根の絶対値は√1.1で一を超えるため、発散する。図は両系の軌道とスペクトル半径を直接計算したものである。これは装置パラメータの推定ではなく、端から端までの遅延が制御系そのものの一部であり、モデルの推論時間だけでは実装可能性を証明できないことを示すためのものである。作者分析与复核建议 / Author analysis
4. リアルタイム処理系ではセンシングから作動までの総時間を記録しなければならない
実際のフィードバックには、診断データの取得、前処理、状態推定、方策計算、通信、アクチュエータ応答が含まれる。本稿は、ネットワークの一回の順伝播に要する平均時間だけを公表するのではなく、ハードウェアのタイムスタンプで分布全体を測定し、裾部とタイムアウトを別途報告することを提案する。入力が古くなっても方策が見かけ上妥当な行動を出力し続ければ、系は誤った状態に基づいて閉ループを形成しうる。観測の期限切れ、パケット損失、行動の未実行を事前に定義し、フォールバック方策の介入を結果に計上すべきである。人間や保護系による修正に大きく依存した実験段階にも研究価値はありうるが、方策単独での完遂率とは区別しなければならない。作者分析与复核建议 / Author analysis
5. 追従誤差とリスクは別々に評価すべきである
DIII-Dのテアリング回避研究は、高性能運転と不安定性リスクを同時に考慮し、制御目的が単一の設定値への追従だけではないことを示している。本稿は一般的な目的を平均追従損失と許容できない状態の確率に分け、その関係を制約形式で表す。ただし、この形式自体が実際の安全保証を与えるわけではない。リスク推定器の較正が不十分な可能性があり、まれな不安定性サンプルの分布も変化しうる。評価では、制約違反、リスクスコアの信頼性、回復時間、運転性能を列挙し、多数の正常時点における小さな誤差によって少数の深刻な逸脱が埋もれないようにすべきである。[2] Avoiding fusion plasma tearing instability with deep re
6. 本稿の分析:アクチュエータ飽和は実効的な閉ループを変える
線形モデルで成立するフィードバックも、行動が振幅または変化率の制限に達すると、別の動特性となる。本稿は飽和の回数、持続時間、状態領域を主要な診断項目とすることを提案する。方策が主として境界に連続的に達することで低誤差を得ているなら、外挿の余裕はきわめて小さい可能性がある。図の制約付き軌道は、明示的な正規化振幅制限のみを用いて、同じゲインでも初期状態によって異なる挙動を取りうることを示している。これはトカマクの運転限界を表すものではなく、解析的な制御パラメータを装置へ直接転用することを推奨するものでもない。作者分析与复核建议 / Author analysis
7. 統計単位は制御ステップ数ではなく放電と運転条件とすべきである
数万の制御ステップが同一の放電に由来し、互いに強く相関していることがある。本稿は、放電または事前に定義した運転条件を主要な統計単位とし、診断用にステップ単位のログも保存することを提案する。方策を比較する際は、運転範囲、初期条件、目的の複雑さを整合させ、診断、アクチュエータ、方策に起因する中止を含め、予定したすべての試験を報告すべきである。順調な一回の放電における各制御ステップを独立した成功とみなし、巨大な標本数を使って幅がほぼゼロの信頼区間を提示してはならない。作者分析与复核建议 / Author analysis
8. 保護、フォールバック、学習方策の寄与を分離する
現実の制御系は、学習方策、従来型制御器、独立した保護機構を同時に含みうる。本稿はこの階層化を妥当な工学設計と考えるが、各層の介入は追跡可能でなければならない。具体的には、いつ制御を引き継いだか、どの条件で作動したか、引き継ぎ前に状態がすでに逸脱していたか、回復後も主要評価項目への計上を続けるかを記録する。方策の性能が保護機構による頻繁な修正に依存するなら、その事実を正確に報告すべきである。また、保護系がシミュレーション内にしか存在しない状態では不十分であり、研究の結論では、実装置で稼働した機構と提案段階の機構を明確にすべきである。作者分析与复核建议 / Author analysis
9. 段階的に拡張可能な検証階梯
本稿は、まず固定した動力学モデルで遅延、ノイズ、振幅制限のパラメータ走査を行い、次に独立したモデルで試験し、その後にシャドーモードでの予測と限定的な運転条件を通じて段階的に検証することを提案する。各段階では停止規則、許容包絡、主要評価項目を事前に定め、前段階の失敗も保存する。現在の範囲で十分に完全な証拠を蓄積して初めて、新しい形状、新しい装置、より長い運転時間へ拡張できる。この階梯は研究評価の枠組みであり、本稿で実施済みの装置運転ではない。装置間転移では、観測、行動、物理的制約を改めて同定する必要がある。作者分析与复核建议 / Author analysis
技術補足 A · 部分観測可能な状態と履歴の符号化
プラズマ制御器は通常、物理状態全体を直接読み取ることができず、診断と履歴に基づいて推定する。同一の現在観測が異なる隠れ状態に対応し、そのため異なる行動を必要とする場合がある。本稿は、観測の符号化、状態推定、方策を区別し、履歴長、欠測、診断のドリフトを試験することを提案する。方策が再帰的な記憶によって情報を補う場合は、リセット時や制御引き継ぎ時に隠れ状態をどのように初期化するかを記録すべきである。長時間良好に機能していた状態も、ソフトウェアの再起動や制御器の切り替え後に引き続き有効とは限らない。このような初期化の挙動も閉ループ検証の一部である。作者分析与复核建议 / Author analysis
技術補足 B · 報酬のペナルティはハード制約と同等ではない
高リスク状態に大きな負の報酬を与えると、平均的な最適化の選好は変わるが、有限のペナルティでは、短期的な利得のために少数の違反を受け入れる方策がなお許されうる。研究が厳格な運転包絡を主張するなら、独立した制約または検証済みのフィルタ機構で表現し、測定誤差を説明する必要がある。本稿は、方策が学習した内容と外部フィルタが修正した内容を区別するため、制約適用前の提案行動と実際に実行した行動の両方を記録することを提案する。制約の作動頻度を報告に含め、最終的な軌道が安定しているからといって頻繁な制御引き継ぎを無視してはならない。作者分析与复核建议 / Author analysis
技術補足 C · 低次の遅延反例における厳密な安定境界
一ステップ遅延系の特性多項式はz²−az+kである。実係数の二次多項式では、根が単位円内にあるために、1−a+k>0、1+a+k>0、1−k>0を同時に満たす必要がある。本稿のa=1.2、k=1.1は最後の条件に違反するが、遅延なしの系は非常に安定である。この判定条件は、図中のスペクトル半径に対する第二の独立した検証経路を与える。このスカラー離散時間モデルにのみ適用されるものの、制御ゲイン、遅延、安定性を一体的に設計する必要があり、応答の強さだけを独立に高めてはならないことを明確に示す。作者分析与复核建议 / Author analysis
技術補足 D · 装置間転移はまずインターフェースと物理的対応づけの問題である
装置ごとにアクチュエータ数、結合、診断、運転包絡が異なるため、方策の重みをそのまま再利用しても、同じ制御問題になるわけではない。本稿は、まず無次元化または等価な対応づけが可能な変数と、再同定が必要な変数を明確にし、そのうえで転移によるサンプル効率を比較することを提案する。目的や行動制約が変わる場合は、単にゼロショット転移と呼ぶのではなく、新たな課題として別途定義すべきである。学習方策自体が実際の実験資源をどれほど節約したかを判断するには、性能報告に再較正、人手による設計、シミュレーション更新のコストを列挙する必要がある。作者分析与复核建议 / Author analysis
10. 結論:方策スコアより閉ループの証拠が重要である
学習制御の最も重要な寄与は、複雑な目的を実系で検証可能なフィードバック挙動へと変換することにある。本稿の遅延反例は、モデル精度と制御安定性の間に、独立に越えなければならない段階があることを示す。TCVとDIII-Dの研究成果は、それぞれの装置と課題の条件の中に位置づけるべきであり、今後の研究には、より多くの完全な放電、境界的な運転条件、フォールバックの記録が必要である。信頼できる成果物は、最も成功したプラズマ画像だけを残すのではなく、ある逸脱から観測、方策、行動、遅延、保護へと遡って追跡できるものでなければならない。作者分析与复核建议 / Author analysis
主要な数式と導出
(1) 遅延のないスカラー負帰還系として構成した系。安定性には|a−k|<1が必要である。
LaTeX
x_{t+1}=a x_t+u_t,\qquad u_t=-k x_t(2) 一ステップの遅延は閉ループの特性根を変える。a=1.2、k=1.1のとき、根の絶対値は√1.1>1となる。
LaTeX
u_t=-k x_{t-1}\quad\Longrightarrow\quad z^2-a z+k=0(3) 一般的なリスク制約付き制御目的。制約を記述することは、実際のリスクの上限を検証したことと同義ではない。
LaTeX
\min_\pi\ \mathbb E\!\sum_t\gamma^t\ell(x_t,u_t)\quad\mathrm{s.t.}\quad P_\pi(\exists t:x_t\notin\mathcal S)\le\varepsilon(4) センシングから作動までの総遅延の定義。ジッタ、裾部、欠落を別途報告しなければならない。
LaTeX
\tau_{\mathrm{loop}}=\tau_{\mathrm{sense}}+\tau_{\mathrm{estimate}}+\tau_{\mathrm{infer}}+\tau_{\mathrm{transport}}+\tau_{\mathrm{actuate}}方法と証拠のフロー
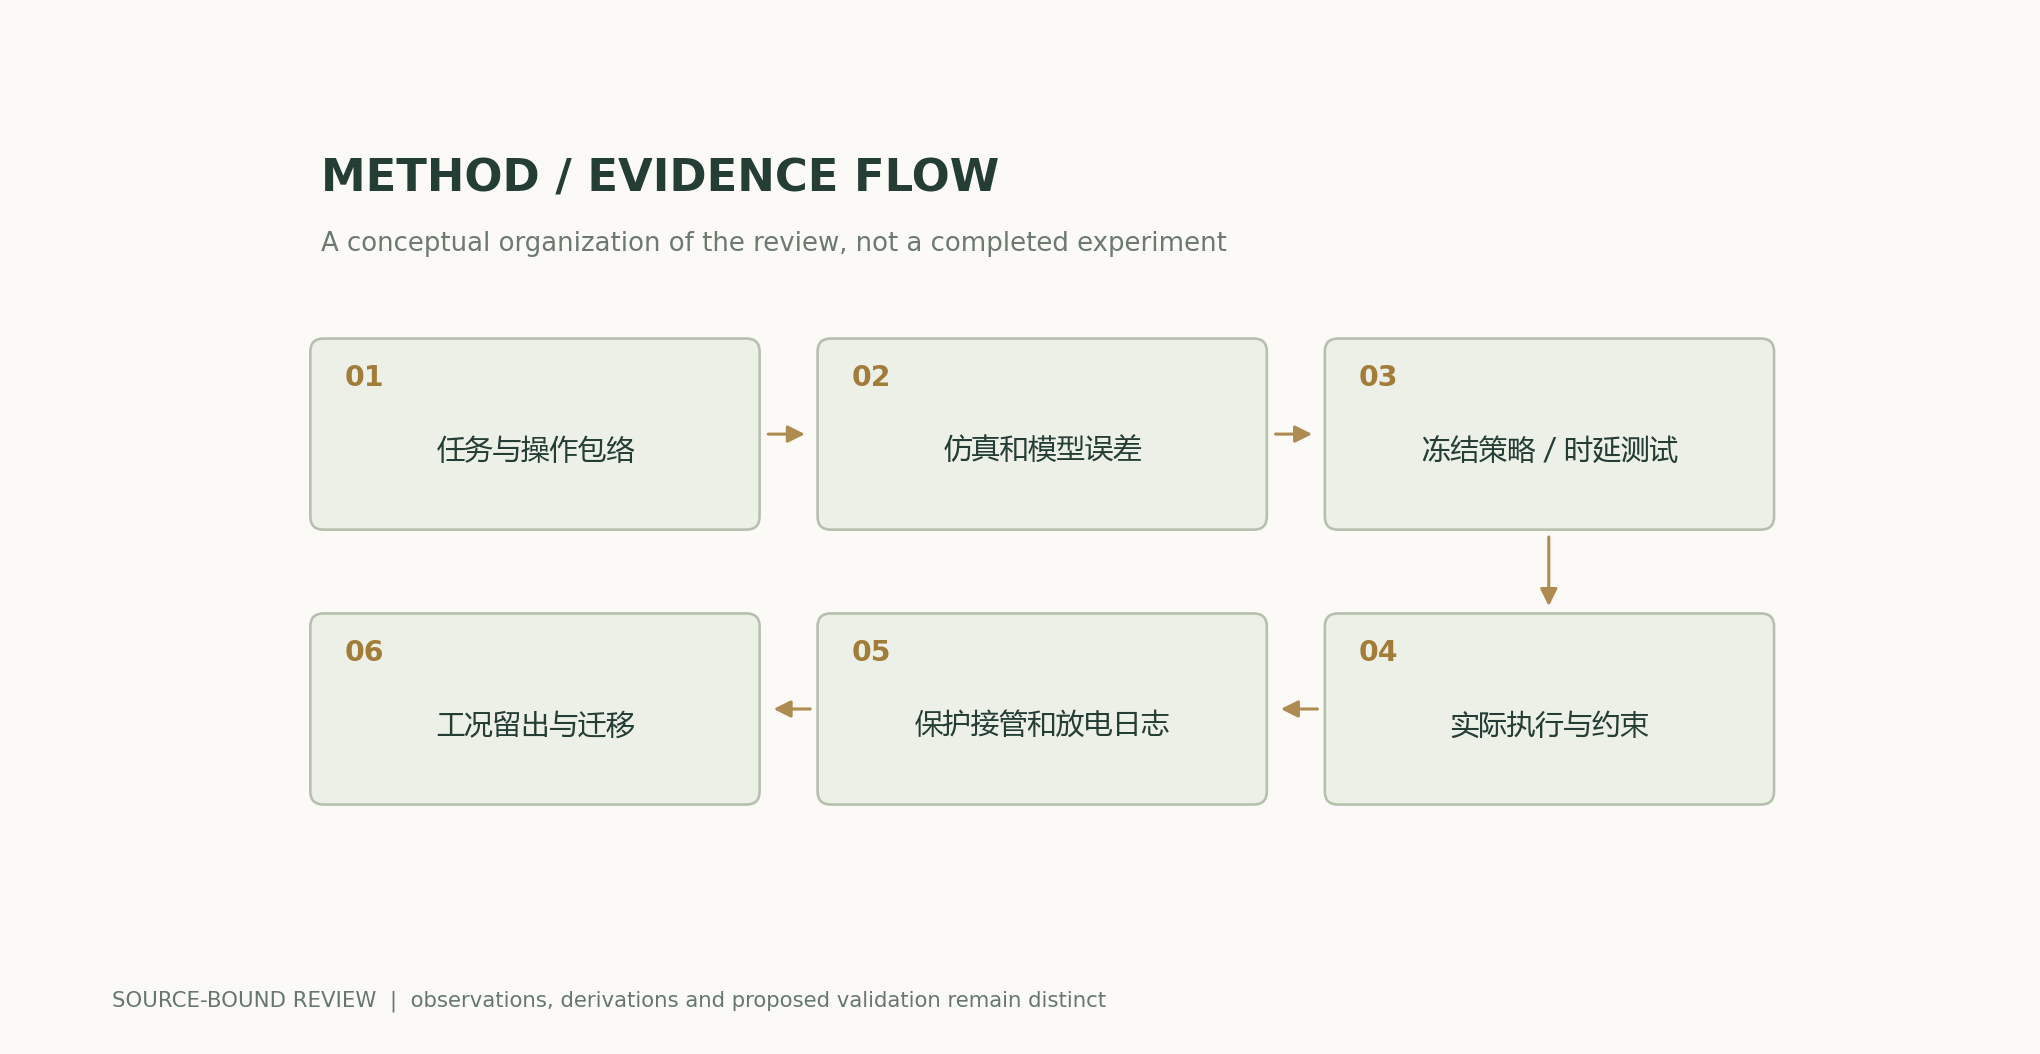
解析図と数値例
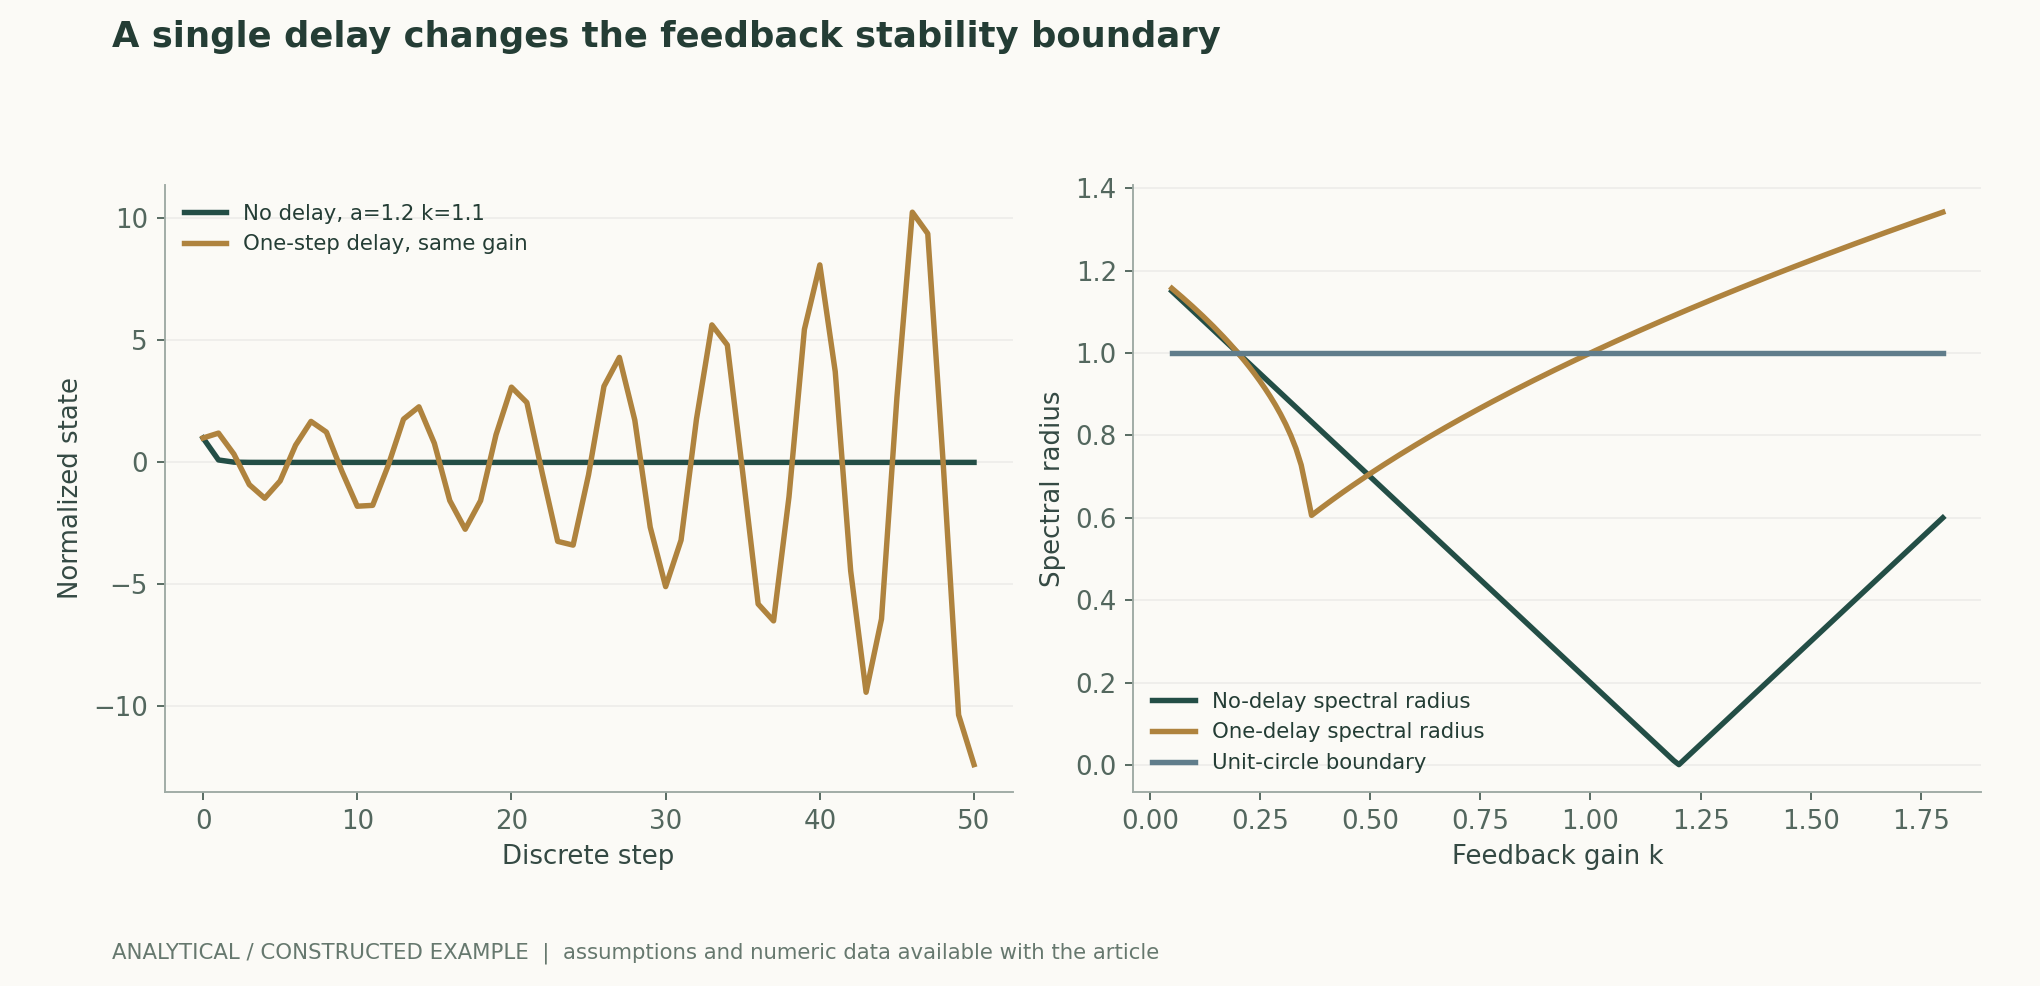
再計算可能な例題
遅延なしの乗数は0.1。一ステップ遅延の特性方程式z^2-1.2z+1.1の根の絶対値はsqrt(1.1)≈1.04881であり、1を超える。
方法の比較
| 階層 | 測定すべき証拠 | 誤った代用 |
|---|---|---|
| 状態推定 | バイアス、遅延、欠測 | 方策の入力は常に真の状態である |
| 方策の目的 | 追従とリスクを分離 | 単一の報酬が高ければ信頼できる |
| 実行 | 振幅制限、変化率、未実行 | 出力が妥当なら行動はすでに作用している |
| 遅延 | 処理系全体の分布 | 順伝播時間が閉ループを代表する |
| 保護とフォールバック | 作動、制御引き継ぎ、回復のログ | 保護の成功を方策単独の成功として計上する |
| 運転条件間 | 放電単位で条件を整合させた比較 | 制御ステップを独立した実験とみなす |
再検証と実験の計画
- 装置の課題について、観測、行動、目的、運転包絡を固定する。
- 動力学モデルの誤差と訓練範囲を保存し、パラメータのランダム化を完全な網羅とみなさない。
- 固定した方策で、遅延、ノイズ、振幅制限、初期状態を走査する。
- ハードウェアのタイムスタンプを用いて、センシングから作動までの処理系全体を記録する。
- 違反、追従、回復、フォールバックなどの独立した評価項目を事前登録する。
- 放電と運転条件を統計単位とし、すべての中止試験を分母に含める。
- 従来型制御、人間、保護の介入を、方策単独の結果から分離する。
- 装置間の転移または包絡の拡大前に再検証する。本稿の解析軌道は装置への制御入力として用いない。
適用範囲と限界
- 正規化した線形系は実際のプラズマを記述しない。
- 本稿では装置へのアクセス、制御の実行、新たな放電データの生成を行っていない。
- 制約付き最適化の式自体は安全性の証明を与えない。
- 有限回の放電では、まれな不安定性に至るすべての経路を排除できない。
- TCVとDIII-Dの課題および装置の違いにより、成功率を直接統合することはできない。
原研究の証拠と適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| TCV実験は、多様な磁気的形状の学習制御を示している。 | 元の装置、観測、課題の範囲に限定される。 | 深層強化学習によるトカマクプラズマの磁気制御要旨および制御実験 |
| DIII-D実験は、高性能運転中のテアリング回避を研究している。 | 磁気的形状制御とは異なり、リスク推定と運転範囲を個別に確認する必要がある。 | 深層強化学習による核融合プラズマのテアリング不安定性の回避要旨および制御器の評価 |
検証に値する研究課題
- 端から端までの遅延分布の裾部は、方策の安定範囲にどの程度影響するか。
- どのモデル誤差が行動の飽和とリスクの不整合を最も引き起こしやすいか。
- 運転条件を整合させた後、学習方策の独立した寄与は放電バッチをまたいで維持されるか。
一次資料と主張の対応
- Magnetic control of tokamak plasmas through deep reinforcement learningDegrave et al. · 2022TCV magnetic shape-control experiments, simulator training and device-specific control scope.
- Avoiding fusion plasma tearing instability with deep reinforcement learningSeo et al. · 2024-02-21DIII-D tearing-avoidance controller; model-based training and high-performance operational constraints.
引用と原稿のエクスポート
著者、版、出典
Codex(AI)が執筆した、出典付きの研究レビューと独自の解析である。原論文の実験は原研究チームに帰属し、本稿の計算は記載された数式と明示的な仮定のみを検証する。当サイトには現時点で、本稿の独立した査読、または独自のモデル、臨床実験、物理実験の記録はない。
初出:AIと科学的発見に関する詳細特集。節ごとの出典、および原研究の証拠と著者による解析の区別を保持している。
概念的な表紙画像はImageGenが生成した。科学図は付属のコードと数値ファイルから作成し、各図注で仮定と測定の定義を項目ごとに説明している。
表紙と科学図の出典 · データ、出典、仮定 · Python · 再計算用コード · 公開・版の履歴
ソースの改訂: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c