
Resumen
Un registrador de linajes es un canal de comunicación ruidoso que opera en un organismo en desarrollo. La diversidad de códigos de barras, el momento de la edición y la pérdida de lecturas determinan conjuntamente qué relaciones de ascendencia pueden recuperarse. Esta revisión conecta los estudios de registro basados en CRISPR con modelos de colisión y saturación, y subraya que un clasificador preciso del estado celular no demuestra la precisión de un árbol genealógico.
La ascendencia es una variable distinta del estado
Dos células pueden tener transcriptomas similares sin compartir un ancestro reciente, y las células hermanas pueden adquirir estados distintos. Un registrador de linajes busca relaciones históricas, mientras que un transcriptoma mide una condición molecular contemporánea. Combinar ambos solo resulta potente cuando la distinción se mantiene explícita. Un árbol inferido principalmente a partir de la similitud de expresión puede parecer biológicamente ordenado mientras incorpora un supuesto que debería haberse sometido a prueba.
Tres arquitecturas de registro
McKenna y sus colaboradores introdujeron GESTALT, que utiliza la acumulación de ediciones de CRISPR para registrar información de linaje. Raj y sus colaboradores combinaron el registro de linajes con transcriptomas unicelulares en el pez cebra mediante scGESTALT. Spanjaard y sus colaboradores desarrollaron LINNAEUS para el trazado de linajes y el análisis del transcriptoma simultáneos. Estos estudios establecen vías experimentales para medir conjuntamente la historia y el estado. También motivan un tratamiento explícito de la cinética de edición, los registros ausentes y la incertidumbre de la reconstrucción. [1], [2], [3]
La capacidad no es el número de cadenas posibles
Un registrador con muchas secuencias posibles puede contener poca información utilizable sobre la ascendencia si predominan las ediciones comunes. La entropía de Shannon mide la diversidad de los resultados observados, mientras que el alfabeto nominal cuenta las posibilidades con independencia de su probabilidad. Las frecuencias de edición desiguales aumentan la posibilidad de que células no emparentadas compartan un registro. Por tanto, un gran espacio teórico de códigos no garantiza un gran espacio efectivo, especialmente cuando los resultados de reparación están fuertemente sesgados.
Las colisiones tienen un coste poblacional
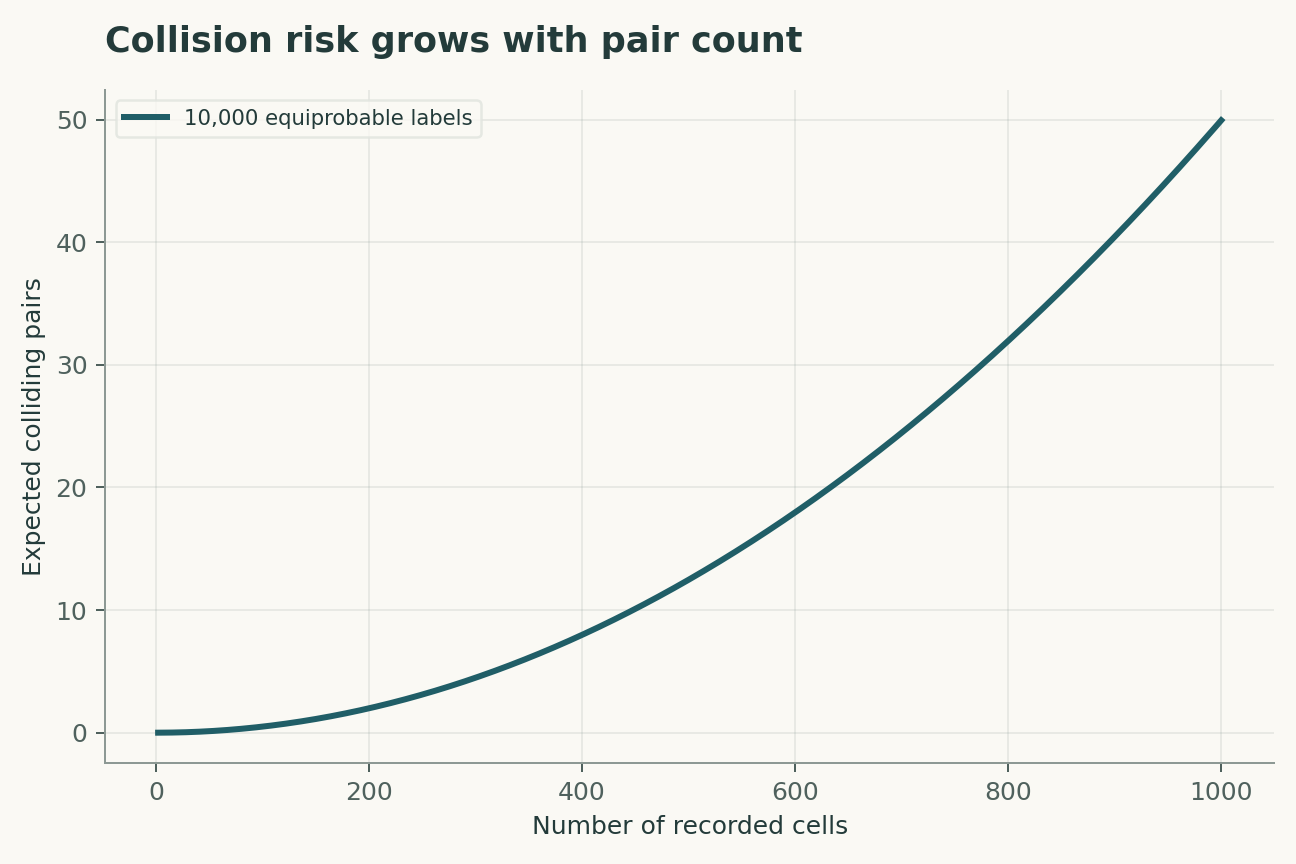
Para registros independientes y uniformes, el número esperado de pares coincidentes crece aproximadamente con el cuadrado del tamaño de la población muestreada. Duplicar el número de células puede cuadruplicar las colisiones esperadas. Este cálculo por pares no predice todos los errores de reconstrucción, porque un árbol utiliza múltiples registros y restricciones temporales. Sí establece por qué un esquema de códigos de barras que funciona en una muestra pequeña no puede ampliarse simplemente secuenciando más células.
Editar demasiado pronto o demasiado tarde
Una ráfaga temprana de edición puede distinguir las ramas principales y dejar sin resolver las divisiones posteriores. Una edición demasiado tardía puede asignar muchas etiquetas terminales sin recuperar la ascendencia compartida. La edición persistente crea otro problema: una deleción posterior puede borrar información anterior. Por tanto, la ventana operativa útil viene definida por los acontecimientos del desarrollo que se desea resolver, no por la mayor fracción final de dianas editadas.
La ausencia de datos forma parte del canal
Un código de barras puede estar ausente porque la célula no fue capturada, el locus no se expresó, el transcrito no se recuperó o una deleción eliminó el registro. Estos mecanismos mantienen relaciones distintas con el estado celular y la ascendencia. Tratar todas las entradas ausentes como pérdidas aleatorias puede sesgar las longitudes de las ramas o fusionar linajes distintos. El modelo de observación debe representar por qué puede faltar un registro, con análisis de sensibilidad para escenarios plausibles de captura dependiente del estado.
Un árbol debe conservar la ambigüedad
Un árbol completamente resuelto no es necesariamente un árbol bien respaldado. Si varias ascendencias explican los mismos registros, un método debe conservar esa incertidumbre en lugar de convertirla en bifurcaciones arbitrarias. Los procedimientos de bootstrap que remuestrean lecturas pueden subestimar la incertidumbre cuando la ambigüedad principal reside en la historia de edición. Los árboles simulados con verdad de referencia conocida pueden evaluar el comportamiento de la reconstrucción, pero solo si abarcan múltiples modelos de edición, en vez de usar el mismo modelo empleado para diseñar el algoritmo de inferencia.
El registro no debe dominar el desarrollo
Una medición histórica puede perturbar el proceso que registra. Las diferencias de crecimiento entre estados del registrador pueden modificar la abundancia de los linajes incluso si las etiquetas moleculares se leen perfectamente. Las comparaciones con controles adecuados del registrador, hitos independientes del desarrollo y trazados ortogonales ayudan a evaluar esta posibilidad. El objetivo es obtener un registrador cuya ganancia de información pueda distinguirse de la selección causada por portar o editar el propio registrador.
El proceso de registro debe formar parte del modelo del árbol
Un algoritmo de linajes debe modelar la probabilidad de cada edición condicionada al sistema de registro, en lugar de suponer que toda edición compartida señala de forma única un ancestro común. Las ediciones recurrentes generan homoplasia; las grandes deleciones pueden borrar registros anteriores; las ventanas de registro inactivas dejan ramas largas sin información. Una prueba útil generaría estructuras de ramificación conocidas con un muestreo controlado y compararía la ascendencia inferida con esas relaciones conocidas. El error debe desglosarse en ramas omitidas, ascendencia compartida falsa y relaciones sin resolver. Un método que comunica incertidumbre o un árbol parcialmente resuelto puede estar mejor calibrado que otro que produce un árbol completamente bifurcado para cada entrada.
Más estados solo ayudan si son legibles
Aumentar el espacio nominal de códigos de barras no garantiza una ganancia proporcional de información. Las probabilidades de edición desiguales reducen la diversidad efectiva, y los estados ilegibles no pueden distinguir linajes. Un indicador diagnóstico es la probabilidad de colisión obtenida a partir de la suma de los cuadrados de las probabilidades de los estados: unos pocos estados comunes pueden dominar incluso cuando el número de estados posibles es grande. Por ello, una comparación de diseños debe comunicar la distribución empírica de estados, la pérdida de datos y la fracción de relaciones que sigue siendo ambigua a la profundidad de muestreo elegida. Estas magnitudes son propiedades del sistema combinado de registro y lectura. No deben sustituirse por el recuento de combinaciones de edición teóricamente posibles.
Un modelo que puede ponerse a prueba
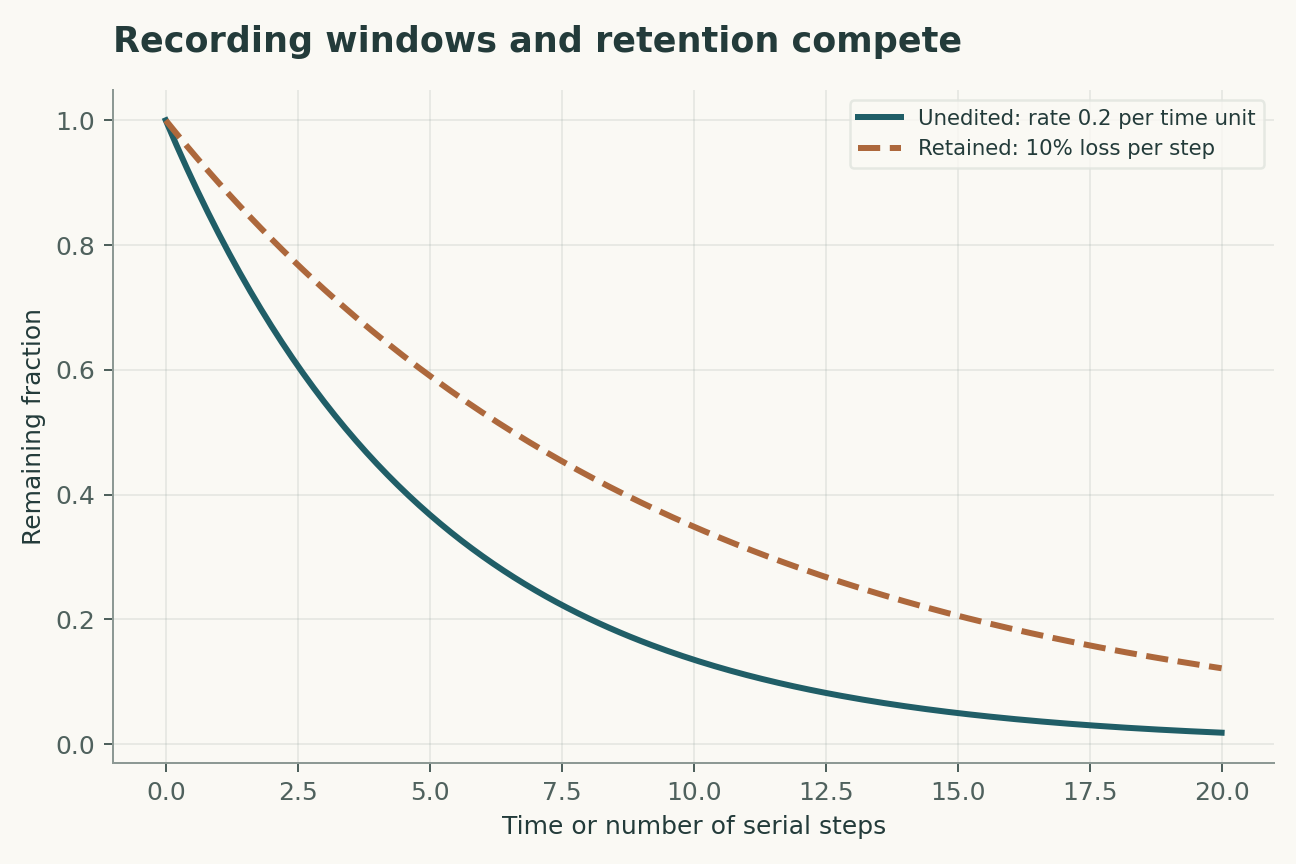
Las cuatro ecuaciones siguientes constituyen un modelo analítico compacto, no un ajuste conjunto a todos los artículos citados. Su interpretación es la siguiente. H es la entropía del registro en bits; es una medida de diversidad, no por sí misma la información mutua entre los registros y la ascendencia. Pares coincidentes esperados para N extracciones independientes y uniformes de M registros; la reparación sesgada exige sustituir 1/M por la suma de los cuadrados de las probabilidades de los registros. La fracción no editada solo sigue esta forma para dianas independientes con una tasa de edición irreversible constante k. Una probabilidad de pérdida independiente d en L lecturas requeridas proporciona una cota sencilla de retención; las deleciones correlacionadas invalidan la independencia.
El objetivo observacional son las relaciones de ascendencia respaldadas por las ediciones registradas. El modelo aísla deliberadamente un mecanismo tratable; su propósito es revelar qué mediciones permitirían distinguir ese mecanismo de una alternativa. Los valores de los parámetros de las figuras se declaran como entradas ilustrativas. Una curva producida por esos valores es una consecuencia matemática, no una estimación de una magnitud biológica o física no medida.
Un diseño de validación con capacidad discriminante
La comparación principal debe evaluar la recuperación de la ascendencia bajo un modelo de edición distinto del modelo ajustado. La unidad de replicación independiente es un organismo independiente o un linaje conocido; las lecturas repetidas de la misma unidad mejoran la precisión, pero no crean replicación independiente. Una validación sólida reservaría nuevas etapas del desarrollo antes de elegir umbrales o ajustar correcciones de factores de perturbación. En particular, los resultados de reparación sesgados y la pérdida dependiente del estado deben medirse, acotarse o variarse en un análisis de sensibilidad. Deben comunicarse tanto la estimación principal como su cambio al relajar ese supuesto. Un modelo que solo funciona tras elegir la regla de exclusión más favorable ha respondido a una pregunta distinta de la de otro evaluado con una regla fijada de antemano.
Análisis numérico desarrollado
Para N = 100 y M = 10,000 registros uniformes, los pares coincidentes esperados son 0.495; para N = 1,000, la esperanza es 49.95. Son recuentos de pares, no probabilidades ni porcentajes de células incorrectas. Con una tasa de edición constante k = 0.2 por unidad de tiempo arbitraria, la fracción no editada es aproximadamente 0.368 después de cinco unidades. Con una pérdida independiente d = 0.1, la probabilidad de conservar las diez lecturas requeridas es aproximadamente 0.349. Los gráficos separan el crecimiento de las colisiones de la pérdida de capacidad de registro temporal.
Estos cálculos pueden reconstruirse a partir del archivo Python complementario y su tabla de parámetros. Las etiquetas de los ejes conservan las unidades del modelo, y el pie de figura distingue las magnitudes que se variaron de las que se mantuvieron fijas. Los ejemplos numéricos se seleccionaron para mostrar una dependencia, no para reproducir el aspecto de una figura publicada. Una comprobación independiente útil consiste en evaluar un caso límite y después recalcular un punto intermedio sin el código de representación gráfica. La concordancia valida la aritmética dentro del modelo declarado; no demuestra que la naturaleza siga ese modelo.
Evidencia, transferencia y próximos pasos
El alcance de la conclusión está limitado por los resultados de reparación sesgados y la pérdida dependiente del estado. La transferencia a nuevas etapas del desarrollo requiere evidencia más allá del ajuste a las observaciones originales. Una replicación futura debería conservar las mediciones brutas, los registros de calibración, las exclusiones y un vínculo legible por máquina entre cada resultado y el análisis correspondiente. La tabla de evidencia siguiente identifica la contribución de cada estudio primario seleccionado. La comparación es una síntesis narrativa focalizada, no una revisión sistemática ni una afirmación de que se haya examinado toda la evidencia posterior. El estudio propuesto no se ha realizado aquí. Su valor reside en que un resultado negativo restringiría una explicación explícita en lugar de limitarse a reducir una puntuación de referencia.
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) H es la entropía del registro en bits; es una medida de diversidad, no por sí misma la información mutua entre los registros y la ascendencia.
(2) Pares coincidentes esperados para N extracciones independientes y uniformes de M registros; la reparación sesgada exige sustituir 1/M por la suma de los cuadrados de las probabilidades de los registros.
(3) La fracción no editada solo sigue esta forma para dianas independientes con una tasa de edición irreversible constante k.
(4) Una probabilidad de pérdida independiente d en L lecturas requeridas proporciona una cota sencilla de retención; las deleciones correlacionadas invalidan la independencia.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Evidencia o decisión de diseño | Qué identifica | Qué queda sin resolver |
|---|---|---|
| Fuente 1 | GESTALT demostró el uso de ediciones acumulativas de CRISPR como registros de linaje. | La edición sesgada y la pérdida de información limitan la reconstrucción. |
| Fuente 2 | scGESTALT conectó la información de linaje con transcriptomas de células individuales del cerebro. | El estado celular medido no valida de forma independiente todo el árbol de ascendencia. |
| Fuente 3 | LINNAEUS combinó el trazado de linajes y la transcriptómica unicelular. | El muestreo y los registros ausentes siguen formando parte de la inferencia. |
| Observable principal | relaciones de ascendencia respaldadas por las ediciones registradas | resultados de reparación sesgados y pérdida dependiente del estado |
| Prueba independiente | recuperación de la ascendencia bajo un modelo de edición distinto del modelo ajustado | Requiere nuevas mediciones |
| Conjunto de transferencia | nuevas etapas del desarrollo | No validado por el ejemplo numérico construido |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ningún experimento biológico, ensayo clínico ni experimento físico nuevo para este artículo.
- Especificar las relaciones de ascendencia respaldadas por las ediciones registradas antes del ajuste.
- Conservar identificadores independientes para cada organismo independiente o linaje conocido.
- Separar las nuevas etapas del desarrollo del desarrollo del modelo.
- Medir o acotar los resultados de reparación sesgados y la pérdida dependiente del estado.
- Registrar las unidades, la calibración y el operador de observación.
- Comparar el modelo principal con una explicación rival identificada por su nombre.
- Preespecificar la prueba: recuperación de la ascendencia bajo un modelo de edición distinto del modelo ajustado.
- Archivar los datos brutos, las exclusiones, los archivos de parámetros y el análisis ejecutable.
Qué establecen las fuentes primarias
Aaron McKenna, Gregory M. Findlay, James A. Gagnon et al. · 2016 [1]
Contribución. GESTALT demostró el uso de ediciones acumulativas de CRISPR como registros de linaje.
Límite. La edición sesgada y la pérdida de información limitan la reconstrucción.
Localización de la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Bushra Raj, Daniel E Wagner, Aaron McKenna et al. · 2018 [2]
Contribución. scGESTALT conectó la información de linaje con transcriptomas de células individuales del cerebro.
Límite. El estado celular medido no valida de forma independiente todo el árbol de ascendencia.
Localización de la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Bastiaan Spanjaard, Bo Hu, Nina Mitic et al. · 2018 [3]
Contribución. LINNAEUS combinó el trazado de linajes y la transcriptómica unicelular.
Límite. El muestreo y los registros ausentes siguen formando parte de la inferencia.
Localización de la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Límites de este análisis
- La edición sesgada y la pérdida de información limitan la reconstrucción.
- El estado celular medido no valida de forma independiente todo el árbol de ascendencia.
- El muestreo y los registros ausentes siguen formando parte de la inferencia.
- Las figuras complementarias son ejemplos analíticos construidos, no resultados experimentales nuevos.
- Esta revisión no ha demostrado la transferencia a nuevas etapas del desarrollo.
Un análisis narrativo focalizado de los estudios primarios mencionados, no una búsqueda bibliográfica sistemática ni una afirmación de cobertura exhaustiva hasta 2026.
Preguntas que cambiarían la conclusión
- ¿Qué patrones de edición identifican una rama y no solo una célula terminal?
- ¿Cómo pueden distinguirse las deleciones correlacionadas de la pérdida de captura?
- ¿Qué perturbaciones del registrador modifican la abundancia de los linajes?
Referencias
- Aaron McKenna, Gregory M. Findlay, James A. Gagnon et al.. Whole-organism lineage tracing by combinatorial and cumulative genome editing. Science (2016). 10.1126/science.aaf7907.
- Bushra Raj, Daniel E Wagner, Aaron McKenna et al.. Simultaneous single-cell profiling of lineages and cell types in the vertebrate brain. Nature Biotechnology (2018). 10.1038/nbt.4103.
- Bastiaan Spanjaard, Bo Hu, Nina Mitic et al.. Simultaneous lineage tracing and cell-type identification using CRISPR–Cas9-induced genetic scars. Nature Biotechnology (2018). 10.1038/nbt.4124.
La identidad bibliográfica se comprobó con Crossref. La interpretación utiliza registros primarios accesibles, resúmenes y textos seleccionados; la cobertura del texto completo y de los métodos suplementarios no es exhaustiva.
Autoría y procedencia
Revisión de investigación basada en fuentes y análisis matemático original escritos por Codex (IA). Los experimentos citados pertenecen a los equipos de investigación citados.
Portada conceptual creada con la herramienta integrada ImageGen. Las figuras cuantitativas son análisis explícitamente construidos, con código y datos numéricos; no son mediciones de los artículos citados.
Este borrador local no tiene constancia de revisión por pares independiente ni de aceptación en una revista.