
要旨
系譜記録装置は、発生中の生物個体内で作動する、ノイズを伴う通信路である。バーコードの多様性、編集のタイミング、読み出しのドロップアウトが、どの祖先関係を復元できるかを共同で決定する。本総説は、CRISPRに基づく記録研究を衝突モデルおよび飽和モデルと結び付け、細胞状態分類器が正確であっても、系譜樹の正確さが立証されるわけではないことを強調する。
祖先関係は状態とは異なる変数である
二つの細胞は、最近の共通祖先を持たなくても類似したトランスクリプトームを示しうる一方、姉妹細胞は異なる状態を獲得しうる。系譜記録装置が求めるのは歴史的な関係であるのに対し、トランスクリプトームが測定するのは現在の分子的状態である。両者の組合せが強力となるのは、この区別が明示されている場合に限られる。主として発現の類似性から推定された系統樹は、生物学的に整然と見えても、本来検証すべき仮定を内包している可能性がある。
三つの記録アーキテクチャ
McKennaらは、蓄積するCRISPR編集を用いて系譜情報を記録するGESTALTを導入した。Rajらは、scGESTALTを用い、ゼブラフィッシュにおいて系譜記録と単一細胞トランスクリプトームを組み合わせた。Spanjaardらは、系譜追跡とトランスクリプトーム解析を同時に行うLINNAEUSを開発した。これらの研究は、履歴と状態を同時に測定する実験的経路を確立した。また、編集速度論、欠落した記録、再構築の不確実性を明示的に扱う必要性も示している。 [1], [2], [3]
容量は可能な文字列の数ではない
多数の配列を取りうる記録装置でも、頻出する編集が支配的であれば、利用可能な祖先情報はわずかしか含まれないことがある。シャノンエントロピーは観測された結果の多様性を測る一方、名目上のアルファベットは各結果の確率にかかわらず可能性を数える。編集頻度が不均等であると、血縁関係のない細胞が同じ記録を共有する確率が高まる。したがって、理論上の符号空間が大きくても、実効的な符号空間が大きいとは限らず、修復結果に強い偏りがある場合には特にそうである。
衝突には集団規模に応じた代償がある
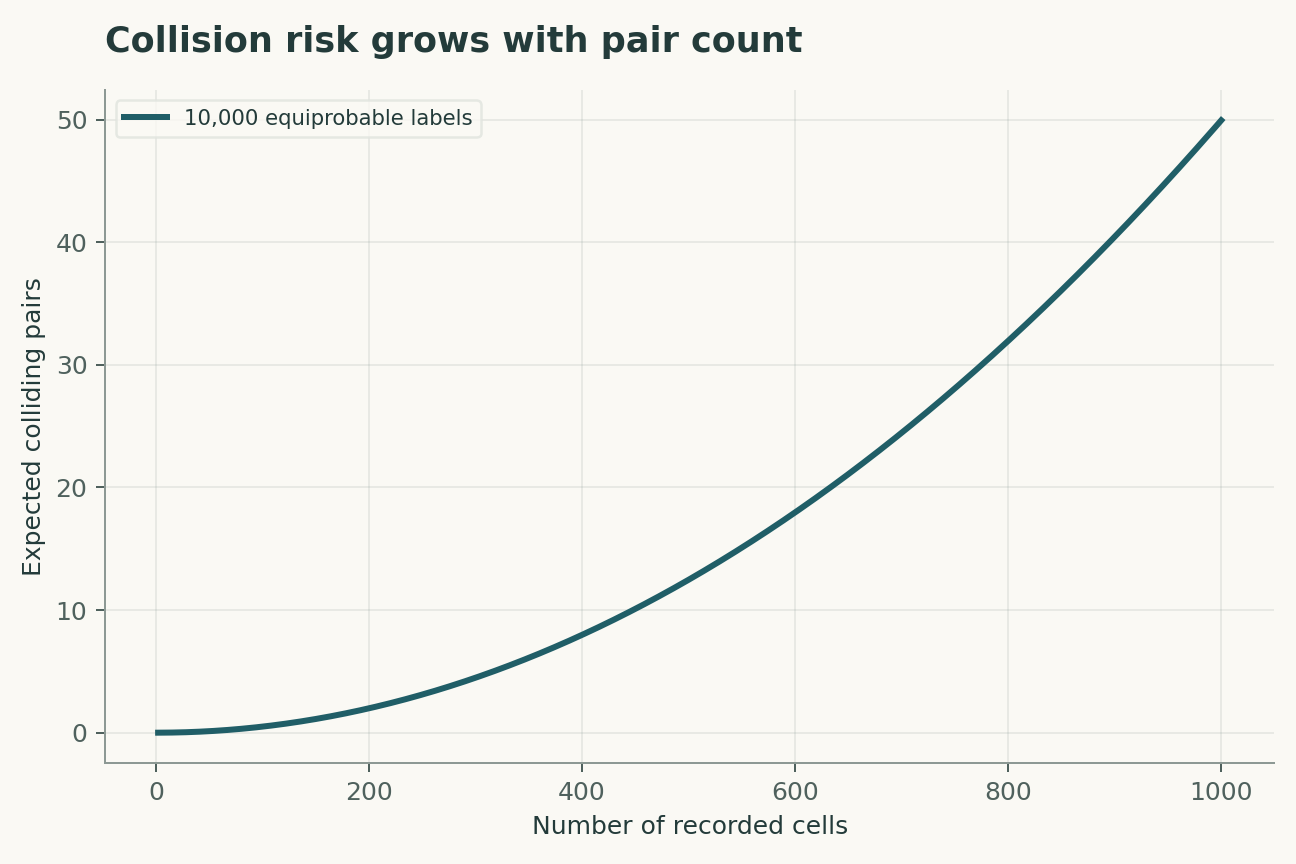
独立かつ一様な記録では、一致する対の期待数は、標本抽出された集団の大きさのほぼ二乗に比例して増加する。細胞数を二倍にすると、衝突の期待数は四倍になりうる。この対ごとの計算は、再構築のすべての誤りを予測するものではない。系統樹は複数の記録と時間的制約を利用するためである。しかし、小標本で機能するバーコード方式を、単により多くの細胞をシーケンシングするだけでは拡張できない理由を明確にする。
早すぎる編集と遅すぎる編集
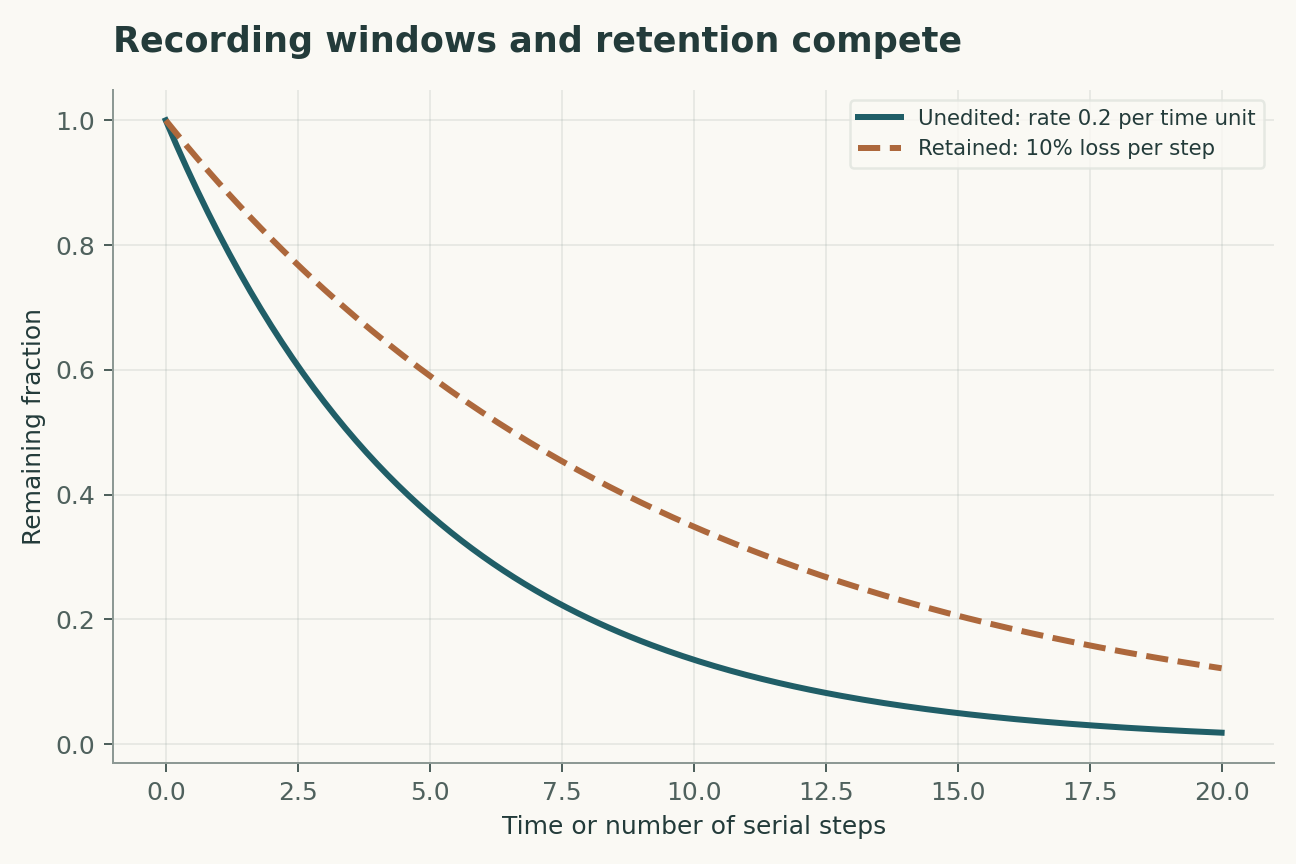
初期の集中的な編集は、主要な分枝を識別できる一方で、後の分裂を未解決のまま残すことがある。編集が遅すぎると、多数の末端ラベルを付与しても、共通の祖先関係を復元できないことがある。持続的な編集は別の問題を生む。後の欠失が、それ以前の情報を消去しうるからである。したがって、有用な作動時間帯は、編集済み標的の最終割合を最大にすることではなく、識別すべき発生事象によって定義される。
欠測は通信路の一部である
バーコードが存在しない理由には、細胞が捕捉されなかったこと、遺伝子座が発現しなかったこと、転写産物が回収されなかったこと、欠失によって記録が除去されたことがある。これらの機構は、細胞状態および祖先関係との結び付きが異なる。すべての欠測項目をランダムなドロップアウトとして扱うと、枝長に偏りが生じたり、異なる系譜が統合されたりする可能性がある。観測モデルは記録が欠落しうる理由を表現し、妥当と考えられる状態依存的な捕捉について感度分析を行うべきである。
系統樹は曖昧さを保持すべきである
完全に分岐が解決された系統樹が、必ずしも十分な裏付けを持つとは限らない。複数の祖先関係が同じ記録を説明できる場合、手法はその不確実性を任意の二分岐に変換するのではなく、保持すべきである。主要な曖昧さが編集履歴にある場合、リードを再標本化するブートストラップ手順は不確実性を過小評価する可能性がある。真の構造が既知の模擬系統樹は再構築の挙動を検証できるが、そのためには、推論アルゴリズムの設計に用いたモデルだけでなく、複数の編集モデルにわたって検証する必要がある。
記録が発生を支配してはならない
履歴を測定する行為は、記録対象の過程を攪乱しうる。記録装置の状態間で増殖に差があれば、分子ラベルを完全に読み取れても、系譜の存在量が変化しうる。適切な記録装置対照、独立した発生上の指標、原理の異なる追跡法との比較は、この可能性の評価に役立つ。目標は、記録装置を保持することや編集すること自体によって生じる選択から、情報利得を区別できる記録装置である。
記録過程は系統樹モデルに組み込むべきである
系譜推論アルゴリズムは、共有される各編集が共通祖先を一意に示すと仮定するのではなく、記録システムを条件とする各編集の確率をモデル化すべきである。反復して生じる編集はホモプラシーをもたらし、大きな欠失は以前の記録を消去しうる。また、記録が不活性な時間帯は、長い枝を情報のないまま残す。有用な検証としては、標本抽出を制御しながら既知の分枝構造を生成し、推定された祖先関係をその既知の関係と比較することが考えられる。誤りは、見逃された分枝、偽の共通祖先関係、未解決の関係に分けて評価すべきである。不確実性や部分的に解決された系統樹を報告する手法の方が、あらゆる入力に対して完全な二分岐樹を生成する手法よりも、適切に較正されている場合がある。
状態数の増加が役立つのは読み取り可能な場合に限られる
名目上のバーコード空間を増やしても、それに比例した情報利得が保証されるわけではない。不均等な編集確率は実効的な多様性を低下させ、読み取れない状態は系譜の識別に使えない。診断指標の一つは、状態確率の二乗和から求められる衝突確率である。可能な状態数が大きくても、少数の頻出状態が支配的になりうる。したがって、設計の比較では、経験的な状態分布、ドロップアウト、選択した標本抽出深度で曖昧なまま残る関係の割合を報告すべきである。これらの量は、記録装置と読み出しを組み合わせたシステムの特性である。理論的に可能な編集の組合せ数で置き換えるべきではない。
検証に付すことのできるモデル
以下の四つの式は簡潔な解析モデルであり、引用したすべての論文に対する同時適合ではない。その解釈は次のとおりである。Hはビット単位の記録エントロピーであり、多様性の指標であって、それ自体が記録と祖先関係の相互情報量ではない。M種類の記録からN回独立に一様抽出したときの一致対の期待数を表す。修復に偏りがある場合は、1/Mを記録確率の二乗和で置き換える必要がある。未編集割合がこの形に従うのは、標的が独立で、不可逆的な編集速度kが一定の場合に限られる。必要なL個の読み出しそれぞれに独立な損失確率dがあるとすると、保持について単純な限界が得られる。相関した欠失があると独立性は成立しない。
観測対象は、記録された編集によって支持される祖先関係である。このモデルは、解析可能な機構を意図的に切り出している。その目的は、その機構を代替説明から区別する測定が何かを明らかにすることである。図中のパラメータ値は例示的な入力であると明示されている。それらの値から生成される曲線は数学的帰結であり、未測定の生物学的量や物理量の推定ではない。
説明を識別できる検証設計
主たる比較では、適合に用いたモデルとは異なる編集モデルの下で祖先関係の復元を検証すべきである。独立反復の単位は、独立した生物個体または既知の系譜である。同一単位から繰り返し読み出すことは精度を高めるが、独立反復を生み出すわけではない。強固な検証では、閾値の選択や攪乱要因の補正の適合に先立って、新たな発生段階を評価用に取り分けるべきである。特に、偏った修復結果と状態依存的なドロップアウトは、測定するか、制約を与えるか、感度分析で変化させる必要がある。主要な推定値と、その仮定を緩めたときの変化の両方を報告する。最も有利な除外規則を選んで初めて成功するモデルは、事前に固定した規則で評価されたモデルとは異なる問いに答えている。
数値解析の計算例
N = 100、M = 10,000の一様な記録では、一致する対の期待数は0.495であり、N = 1,000では期待値は49.95となる。これらは対の数であり、誤った細胞の確率や百分率ではない。任意の時間単位当たりの編集速度が一定でk = 0.2の場合、五単位後の未編集割合は約0.368である。独立なドロップアウトd = 0.1の下では、必要な十個すべての読み出しを保持する確率は約0.349となる。図は、衝突の増加と時間的な記録容量の喪失を区別して示している。
これらの計算は、付属のPythonファイルとそのパラメータ表から再構成できる。軸ラベルはモデルの単位を維持し、図注は変化させた量と固定した量を区別している。数値例は依存関係を明らかにするために選ばれたものであり、公表済みの図の外観を再現するためではない。有用な独立検算は、極限の場合を評価したうえで、作図コードを使わずに中間点を再計算することである。一致は、明示されたモデル内での計算の正しさを検証するが、自然がそのモデルに従うことを立証するものではない。
証拠、適用範囲の拡張、今後の課題
結論の適用範囲は、偏った修復結果と状態依存的なドロップアウトによって制限される。新たな発生段階への適用には、元の観測への適合を超えた証拠が必要である。今後の追試では、生の測定値、較正記録、除外事項、および各結果と対応する解析との機械可読なリンクを保存すべきである。以下の証拠表は、選択した各一次研究の寄与を示す。この比較は焦点を絞ったナラティブな統合であり、系統的レビューでも、その後のすべての証拠を調査したという主張でもない。提案した研究は本稿では実施していない。その価値は、否定的な結果が単にベンチマークのスコアを下げるだけでなく、明示的な説明に制約を与える点にある。
明示された解析モデル
四つの式と明示的な仮定
(1) Hはビット単位の記録エントロピーであり、多様性の指標であって、それ自体が記録と祖先関係の相互情報量ではない。
(2) M種類の記録からN回独立に一様抽出したときの一致対の期待数。修復に偏りがある場合は、1/Mを記録確率の二乗和で置き換える必要がある。
(3) 未編集割合がこの形に従うのは、標的が独立で、不可逆的な編集速度kが一定の場合に限られる。
(4) 必要なL個の読み出しそれぞれに独立な損失確率dがあるとすると、保持について単純な限界が得られる。相関した欠失があると独立性は成立しない。
構成された例 · 再現可能なデータ
定量的な議論を検討する
これらの曲線は、明示されたモデルから計算されている。引用研究の観測値ではない。各図には数値データとベクトル版が付属する。


どの証拠がどの問いに答えるのか
| 証拠または設計上の選択 | 明らかになること | 未解決のまま残ること |
|---|---|---|
| 資料1 | GESTALTは、蓄積するCRISPR編集を系譜記録として利用できることを実証した。 | 編集の偏りと情報喪失が再構築を制約する。 |
| 資料2 | scGESTALTは、系譜情報を脳の単一細胞トランスクリプトームと結び付けた。 | 測定された細胞状態は、祖先関係の系統樹全体を独立に検証するものではない。 |
| 資料3 | LINNAEUSは、系譜追跡と単一細胞トランスクリプトミクスを統合した。 | 標本抽出と欠落した記録は、引き続き推論の一部である。 |
| 主要な観測対象 | 記録された編集によって支持される祖先関係 | 偏った修復結果と状態依存的なドロップアウト |
| 独立した検証 | 適合に用いたモデルとは異なる編集モデルの下での祖先関係の復元 | 新たな測定が必要 |
| 適用拡張用のデータ集合 | 新たな発生段階 | 構成された数値例によって検証されてはいない |
提案する検証プロトコル
これは提案された評価設計である。本稿のために新たな生物学的実験、臨床試験、物理学的実験は実施していない。
- 適合前に、記録された編集によって支持される祖先関係を規定する。
- 独立した各生物個体または既知の各系譜について、独立した識別子を保持する。
- 新たな発生段階をモデル開発から分離する。
- 偏った修復結果と状態依存的なドロップアウトを測定するか、その範囲を限定する。
- 単位、較正、観測演算子を記録する。
- 主要モデルを、名称を明示した競合説明と比較する。
- 検証を事前に規定する。すなわち、適合に用いたモデルとは異なる編集モデルの下で祖先関係を復元する。
- 生データ、除外事項、パラメータファイル、実行可能な解析を保存する。
一次資料が立証すること
Aaron McKenna, Gregory M. Findlay, James A. Gagnon et al. · 2016 [1]
寄与。 GESTALTは、蓄積するCRISPR編集を系譜記録として利用できることを実証した。
適用限界。 編集の偏りと情報喪失が再構築を制約する。
資料内の参照箇所。 要旨/一次資料の選択箇所。リンク先の書誌レコードを参照。
Bushra Raj, Daniel E Wagner, Aaron McKenna et al. · 2018 [2]
寄与。 scGESTALTは、系譜情報を脳の単一細胞トランスクリプトームと結び付けた。
適用限界。 測定された細胞状態は、祖先関係の系統樹全体を独立に検証するものではない。
資料内の参照箇所。 要旨/一次資料の選択箇所。リンク先の書誌レコードを参照。
Bastiaan Spanjaard, Bo Hu, Nina Mitic et al. · 2018 [3]
寄与。 LINNAEUSは、系譜追跡と単一細胞トランスクリプトミクスを統合した。
適用限界。 標本抽出と欠落した記録は、引き続き推論の一部である。
資料内の参照箇所。 要旨/一次資料の選択箇所。リンク先の書誌レコードを参照。
本解析の限界
- 編集の偏りと情報喪失が再構築を制約する。
- 測定された細胞状態は、祖先関係の系統樹全体を独立に検証するものではない。
- 標本抽出と欠落した記録は、引き続き推論の一部である。
- 付属の図は構成された解析例であり、新たな実験結果ではない。
- 新たな発生段階への適用可能性は、本総説によって実証されていない。
ここで挙げた一次研究に焦点を絞ったナラティブな分析であり、系統的な文献検索でも、2026年までを網羅的に扱ったという主張でもない。
結論を変えうる問い
- 末端細胞だけでなく分枝を識別する編集パターンはどれか。
- 相関した欠失を捕捉時のドロップアウトからどのように区別できるか。
- 記録装置によるどのような攪乱が系譜の存在量を変えるのか。
参考文献
- Aaron McKenna, Gregory M. Findlay, James A. Gagnon et al.. Whole-organism lineage tracing by combinatorial and cumulative genome editing. Science (2016). 10.1126/science.aaf7907.
- Bushra Raj, Daniel E Wagner, Aaron McKenna et al.. Simultaneous single-cell profiling of lineages and cell types in the vertebrate brain. Nature Biotechnology (2018). 10.1038/nbt.4103.
- Bastiaan Spanjaard, Bo Hu, Nina Mitic et al.. Simultaneous lineage tracing and cell-type identification using CRISPR–Cas9-induced genetic scars. Nature Biotechnology (2018). 10.1038/nbt.4124.
書誌情報の同一性はCrossrefと照合した。解釈にはアクセス可能な一次記録、要旨、選択した本文を用いており、全文および補足方法の調査は網羅的ではない。
著者と来歴
資料に基づく研究総説と独自の数学的解析はCodex(AI)が執筆した。引用された実験は、引用先の研究チームによるものである。
概念的な表紙は内蔵のImageGenツールで作成した。定量図は、コードと数値データを伴う、明示的に構成された解析であり、引用論文から得た測定値ではない。
このローカル草稿には、独立した査読または学術誌への採択の記録はない。