
摘要
神经算子试图学习函数到函数的映射,物理信息网络则常通过方程残差约束特定解;两者训练对象和成本结构并不相同。本文分析FNO的频域操作、DeepONet的分支—主干表示及PINN残差,讨论边界、网格与分布外参数。图示只重建一个公开周期信号,不是求解真实PDE或证明连续误差界。[1] Fourier Neural Operator for Parametric Partial Differen[2] DeepONet: Learning nonlinear operators for identifying [3] Physics Informed Deep Learning (Part I): Data-driven So
English abstract
Neural operators learn mappings between functions, while PINNs often optimize a particular equation instance. We compare Fourier and branch-trunk parameterizations and derive a periodic spectral truncation example. Reconstruction curves are analytical signal calculations rather than PDE solver benchmarks. Boundary conditions, discretization, conservation and out-of-distribution parameters require separate tests.
1. 学一个解与学一族解不是同一任务
PINN可将方程、边界和初值残差加入目标,为一个或若干实例拟合解;神经算子则利用参数化函数输入学习整族解的映射。训练、推理与生成数据的成本应分开。一个预训练算子的单次预测很快,不代表获得该模型的总成本低,也不代表在未见参数区间可靠。比较应明确方程族、输入函数分布与目标使用次数。[3] Physics Informed Deep Learning (Part I): Data-driven So[1] Fourier Neural Operator for Parametric Partial Differen
2. FNO的频谱截断控制表示与误差
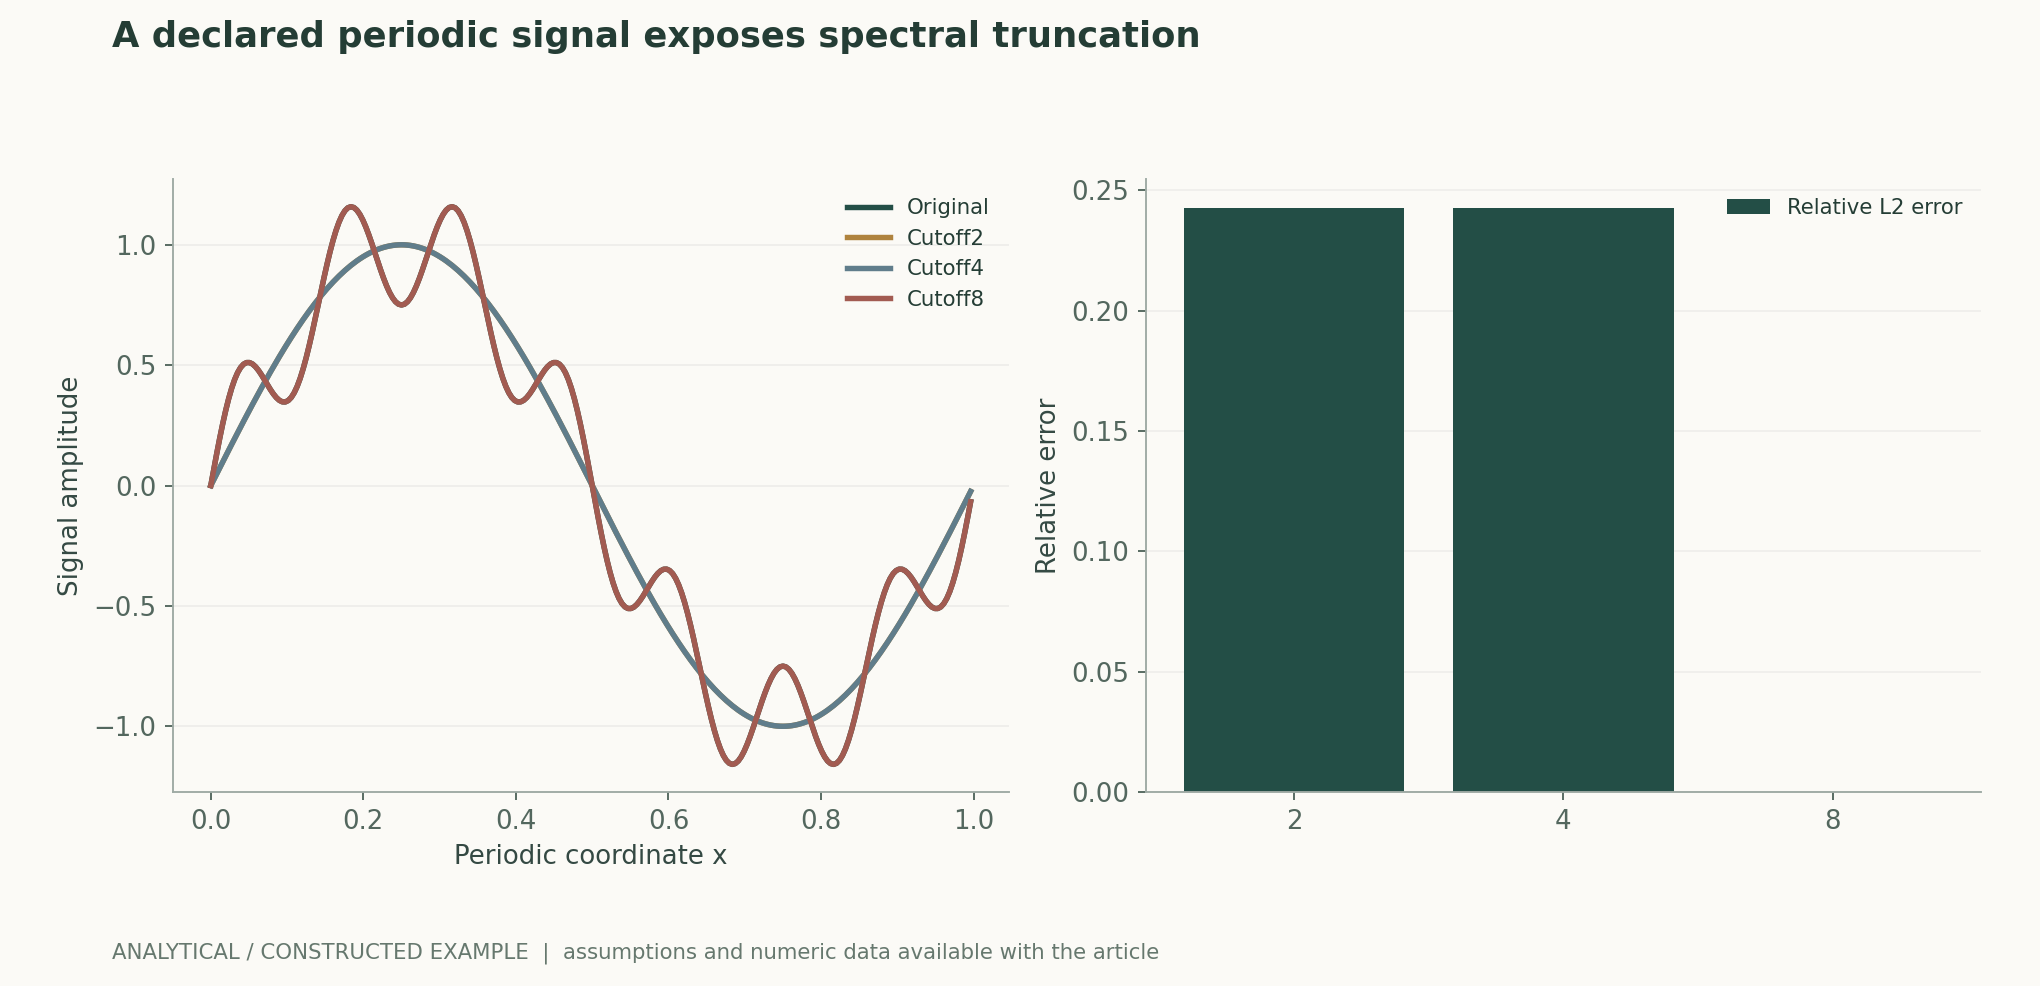
FNO层在频域对保留模式施加学习变换,再回到空间并结合局部项与非线性。截断降低计算,也限制直接表示的高频信息。周期FFT与非周期边界之间需要合适处理,网格采样还涉及混叠。图中使用sin(2πx)+0.25sin(14πx),低截止只保留低频,因此能精确指出丢失项;这不是复杂PDE中的全部误差来源。[1] Fourier Neural Operator for Parametric Partial Differen
3. DeepONet把输入编码与位置查询结合
分支网络编码输入函数采样,主干网络编码输出查询位置,二者组合得到预测。传感点、采样密度与输入分布决定网络能看到什么信息;连续位置查询不等于已经证明连续域上任意位置误差小。应记录传感器配置并测试新网格和新位置,区分插值、分辨率变化和真正分布外函数。[2] DeepONet: Learning nonlinear operators for identifying
4. 方程残差小不自动保证解误差小
离散采样上的残差可能遗漏局部尖峰,边界权重不足也可能使解偏离目标问题。残差与解误差的关系取决于方程稳定性、边界和所用范数。不同量纲的残差相加还需要合理缩放。PINN验收应包含独立密集网格、边界、守恒与参考解,而不能只报告训练点上的残差下降。[3] Physics Informed Deep Learning (Part I): Data-driven So
5. 跨网格与长期滚动需要额外验证
在一个分辨率上训练后换网格,可能遇到采样、频谱和数值积分差异;时间推进的误差还会逐步累积。应分别报告单步、长期轨迹、守恒漂移与不稳定失败,并测试参数范围、边界条件和激励变化。数据生成求解器本身的离散误差也是参考的不确定来源,不能把它无条件当作连续真解。[1] Fourier Neural Operator for Parametric Partial Differen[2] DeepONet: Learning nonlinear operators for identifying
6. 科学计算比较应以可复现误差预算为中心
冻结方程、单位、域、边界、参数分布、求解器和网格,按完整实例划分。报告相对L2之外的关键局部量、守恒和极值,连同数据生成、训练与推理成本。若宣称加速,应在相同误差要求下比较传统求解器,并计入准备成本。本文频谱例子只解释模式截断,没有完成PDE求解或宣称替代数值方法。[1] Fourier Neural Operator for Parametric Partial Differen[2] DeepONet: Learning nonlinear operators for identifying [3] Physics Informed Deep Learning (Part I): Data-driven So
核心公式与推导
(1) FNO式层的简化表达;保留模式、边界和网格实现需另行说明。
LaTeX
v^{\prime}=\sigma\left(Wv+\mathcal F^{-1}(R\mathcal Fv)\right)(2) DeepONet分支—主干组合示意;a的传感采样限制输入信息。
LaTeX
\hat u(a)(y)=\sum_{j=1}^{p}b_j(a)t_j(y)(3) 参考解、积分网格及近零分母处理都必须记录,单个全局范数可能掩盖局部误差。
LaTeX
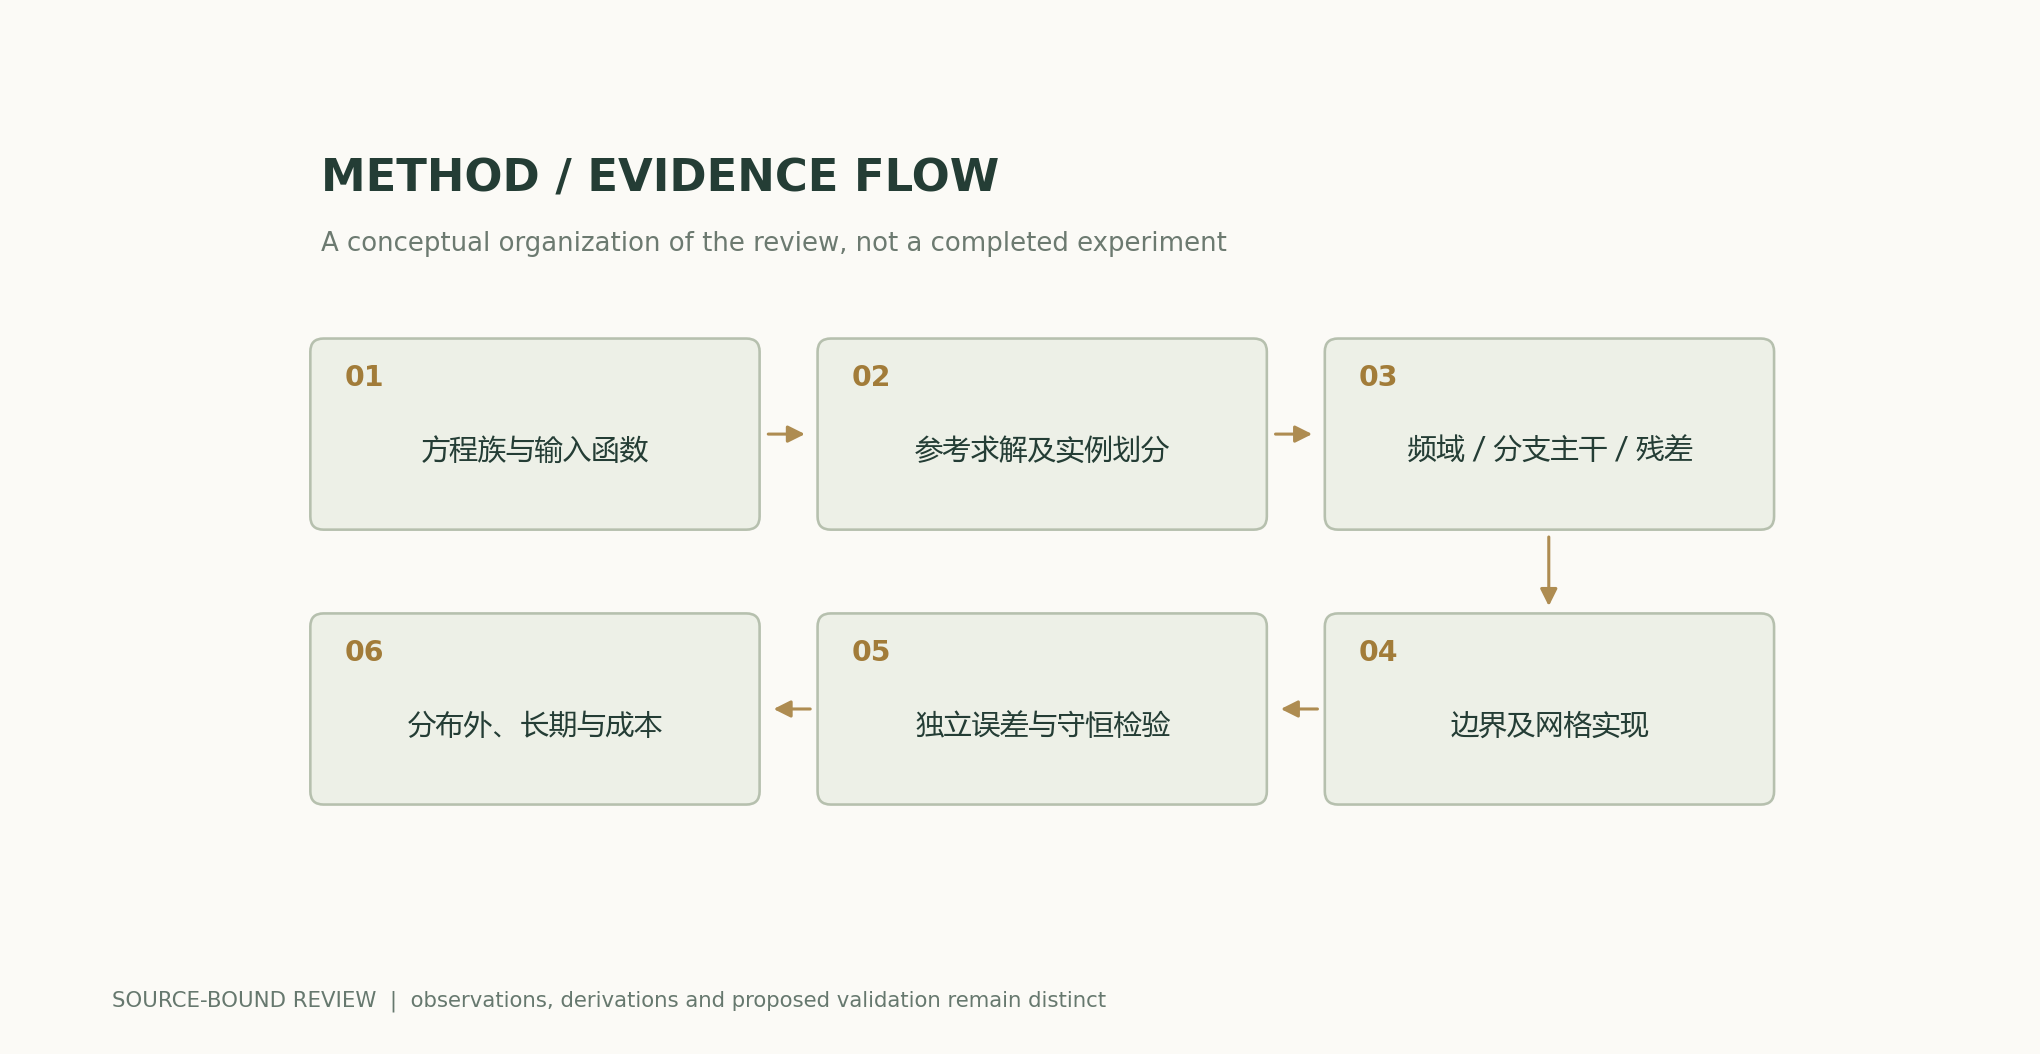
\epsilon_{L^2}=\frac{\|\hat u-u_{\mathrm{ref}}\|_{L^2}}{\|u_{\mathrm{ref}}\|_{L^2}}方法与证据流程
解析图与数值示例
可复算例题
截止2或4模式时丢失第7频率,相对L2误差约0.242536;截止8保留两项,误差仅浮点量级。它不是FNO训练结果或连续PDE误差界。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| FNO | 保存频率截断、网格与边界处理 | 跨网格不等于无限分辨率保证 |
| DeepONet | 固定传感点与查询位置分布 | 连续查询不自动保证连续误差 |
| PINN | 独立检验残差、边界和参考解 | 训练残差小不等于解准确 |
| 数值方法比较 | 相同误差及全部准备成本 | 只比单次推理会忽略训练费用 |
复核与实验方案
- 固定方程、单位、参数分布、域、初边值与参考求解器。
- 按完整实例划分,保存网格、传感器及求解器容差。
- 用解析解或小问题核对实现与数值积分。
- 分测全局、局部、边界、守恒和长期漂移。
- 扫描新网格、参数与激励,保留不稳定和分布外失败。
- 在相同误差目标下比较数据生成、训练、推理及传统求解成本。
适用范围与局限
- 频谱例子没有求解PDE。
- 离散参考不等于连续真解。
- 跨网格能力需要实测。
- 低残差不自动保证稳定解。
一手来源与主张对应
- Fourier Neural Operator for Parametric Partial Differential Equations, , , , , , · 2020-10-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
- DeepONet: Learning nonlinear operators for identifying differential equations based on the universal approximation theorem of operators, , · 2019-10-08Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Physics Informed Deep Learning (Part I): Data-driven Solutions of Nonlinear Partial Differential Equations, , · 2017-11-28Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
阅读器性能修订:新近 HEAD 返回 200 且 ETag 相同时也复用已读页面。正文、公式、来源和科学图的数据保持上一版本内容。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/neural-operators-pde/v1/
Source revision: 6251a250b27bb8b449f59b392f81abd355383770