
Resumen
La corrección de errores cuánticos utiliza mediciones redundantes para inferir si la información codificada ha sufrido un error lógico, y los decodificadores deben funcionar bajo ruido correlacionado, variable en el tiempo y parcialmente observable. AlphaQubit demuestra el potencial de precisión de la decodificación mediante aprendizaje, mientras que los experimentos de memoria cuántica por debajo del umbral del código de superficie indican que los requisitos de hardware, distancia del código y procesamiento en tiempo real deben cumplirse conjuntamente. Partiendo de las clases de equivalencia lógica, este artículo analiza la degeneración de errores, las muestras finitas, el escalado de la distancia del código, la tasa de procesamiento y la latencia. Distinguimos estrictamente entre los resultados de distancia del código en chips reales, la simulación de distancias mayores y los sistemas en tiempo real de extremo a extremo; los gráficos son únicamente cálculos analíticos clásicos, no experimentos con procesadores cuánticos realizados por este sitio.[1] Learning high-accuracy error decoding for quantum proce[2] Quantum error correction below the surface code thresho
Traducción del resumen original en inglés
La decodificación de códigos de superficie consiste en inferir clases de equivalencia lógica, no simplemente en localizar el error físico más probable. Examinamos AlphaQubit y los experimentos de memoria cuántica por debajo del umbral, manteniendo separadas las distancias de código experimentales y simuladas. Un ejemplo de degeneración explica por qué importa sumar sobre las clases de errores; los cálculos de paridad lógica y tasa de servicio vinculan los datos finitos con los requisitos operativos. Los gráficos numéricos son construcciones analíticas y no simulan un procesador cuántico ni establecen un umbral de tolerancia a fallos.
1. Las lecturas de los estabilizadores solo revelan parte del error
El código de superficie genera información de síndrome mediante mediciones repetidas de estabilizadores. Varios errores físicos distintos pueden producir las mismas observaciones; algunos son equivalentes entre sí, mientras que otros difieren en una operación lógica. Por tanto, decodificar no consiste en reconstruir de manera única lo ocurrido en cada cúbit, sino en elegir una clase de equivalencia que preserve la información lógica. AlphaQubit utiliza una arquitectura recurrente para procesar el historial de mediciones y transformar la información espaciotemporal en predicciones de errores lógicos. Sobre esta base, el artículo subraya que la evaluación debe centrarse en el fallo lógico, no solo en la precisión de clasificación de cada bit de medición; una gran cantidad de lecturas sin eventos puede hacer que esta última parezca excelente sin garantizar la conservación de la información cuántica.[1] Learning high-accuracy error decoding for quantum proce
2. Derivación de este artículo: la trayectoria más probable no pertenece necesariamente a la clase de equivalencia más probable
Construyamos tres candidatos mutuamente excluyentes para un síndrome dado: la clase A contiene una sola trayectoria, con probabilidad condicional 0.35; la clase B contiene dos trayectorias, con probabilidades 0.33 y 0.32. Maximizar la probabilidad por trayectoria selecciona A, pero la probabilidad total de B es 0.65, por lo que sumar por clase lógica selecciona B. Este pequeño ejemplo ilustra el significado de la degeneración de errores y no corresponde a una asignación de probabilidades de un código real. Al comparar decodificadores basados en emparejamiento, redes tensoriales y aprendizaje, lo importante es cómo tratan las correlaciones y la masa de probabilidad de las clases de equivalencia; los métodos de aprendizaje no deben interpretarse simplemente como clasificadores más grandes de posiciones de error.作者分析与复核建议 / Author analysis
3. Los chips reales y las distancias de código simuladas corresponden a niveles de evidencia distintos
El artículo original de AlphaQubit estudia las distancias de código 3 y 5 con datos reales de Sycamore, y compara situaciones de ruido correlacionado en simulaciones de distancias mayores, hasta 11. El preentrenamiento y la adaptación con muestras reales limitadas permiten al modelo aprovechar información de ruido más compleja, pero la distancia simulada 11 no debe presentarse como una demostración equivalente ya realizada en un chip real. El entrenamiento, la validación y la prueba también deben mantenerse separados en lo relativo a las muestras experimentales y al ajuste del modelo de ruido. Ajustar primero un modelo de ruido con todos los datos experimentales y generar después muestras de prueba a partir de él modifica la dificultad del problema de generalización externa.[1] Learning high-accuracy error decoding for quantum proce
4. El ruido correlacionado y las fugas hacen relevante el historial temporal
Un modelo de errores de Pauli independientes e idénticamente distribuidos facilita el cálculo, pero los dispositivos reales pueden presentar diafonía, fugas, cambios en las lecturas analógicas y correlaciones entre ciclos. El estudio de AlphaQubit utiliza el estado histórico y la información blanda para abordar estos fenómenos. Este artículo lo interpreta como un problema de inferencia de estados ocultos: el mismo síndrome actual puede corresponder a distribuciones posteriores distintas según el historial. La evaluación debería variar por separado la intensidad del ruido, la longitud de correlación y la deriva de calibración para observar cuándo aparece un desajuste del modelo, en lugar de limitarse a aumentar las muestras del mismo generador de ruido. Cuanto más se aproxime la distribución de entrenamiento al ruido de prueba, mayor será la necesidad de reservar períodos temporales verdaderamente independientes.[1] Learning high-accuracy error decoding for quantum proce[2] Quantum error correction below the surface code thresho
5. Derivación de este artículo: relación entre el fallo de paridad tras múltiples rondas y la tasa de error por ronda
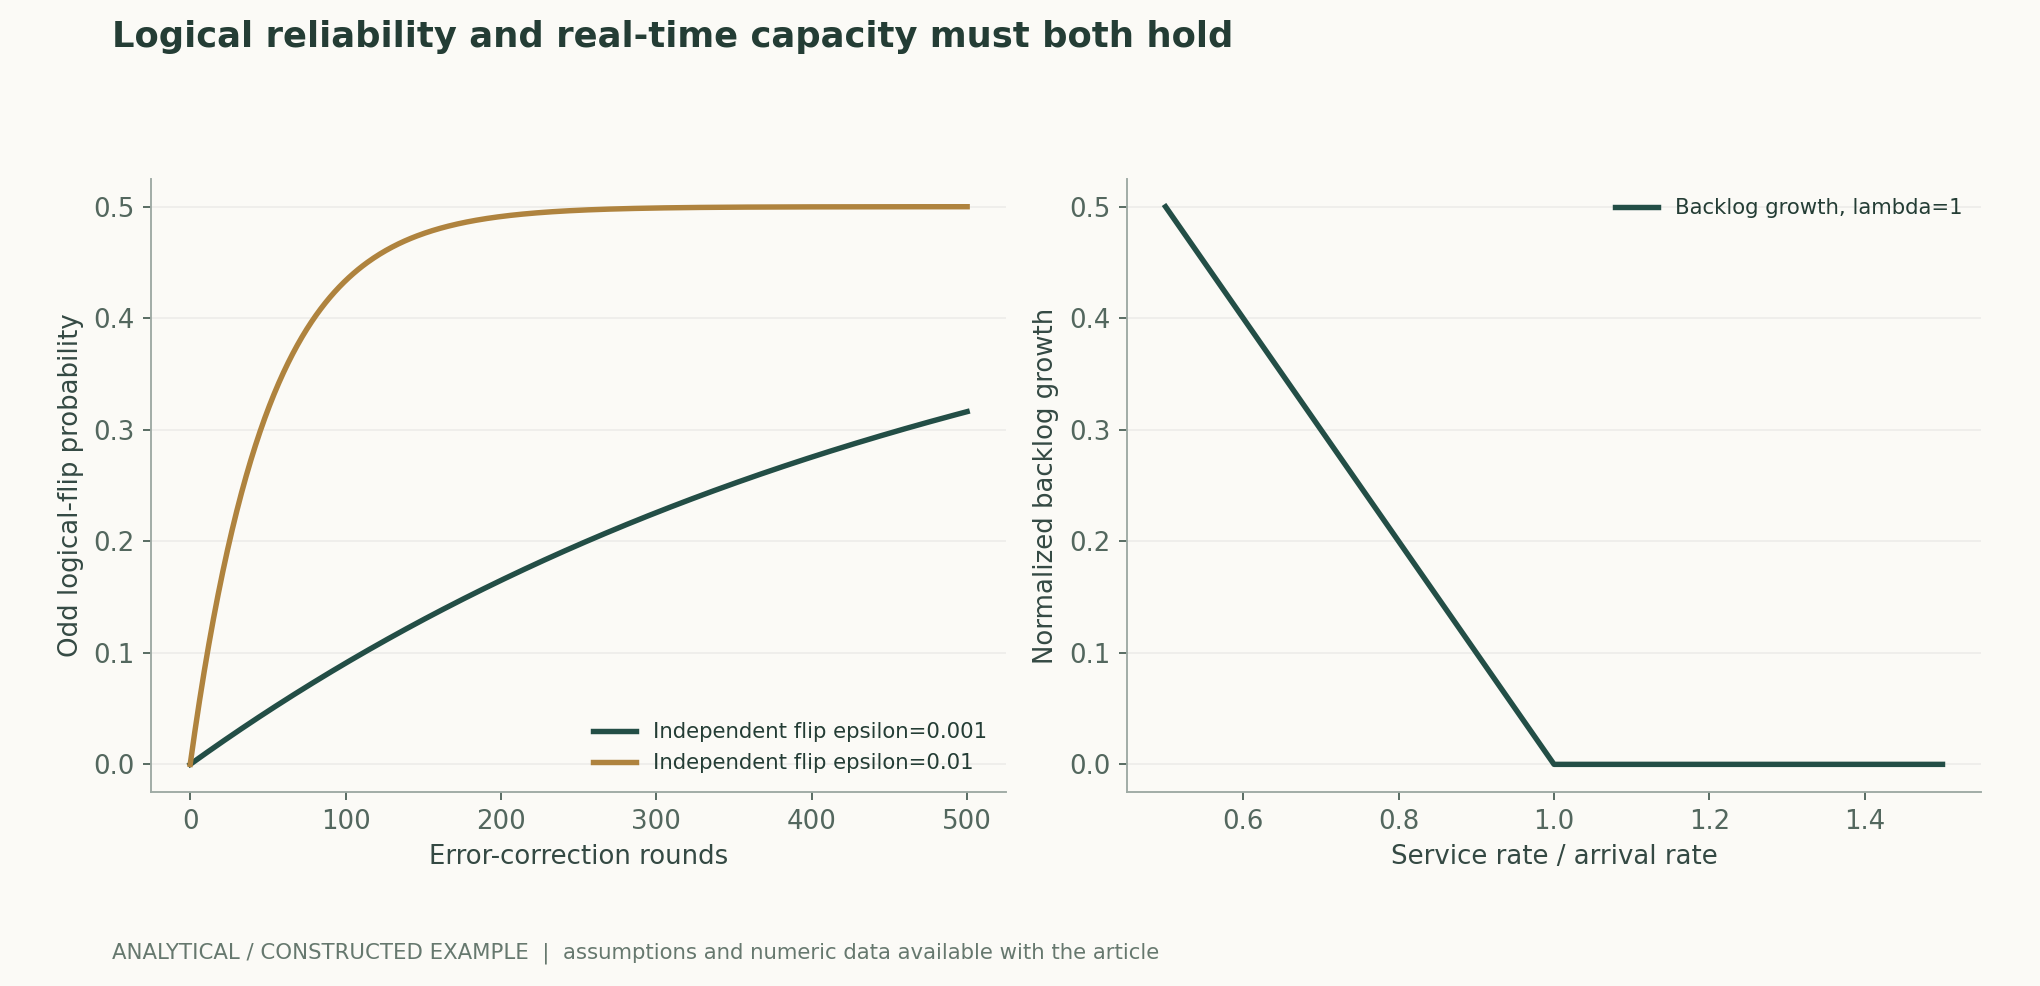
Si el bit lógico se invierte de forma independiente con probabilidad ε en cada ronda, la probabilidad de un número impar de inversiones tras R rondas es [1−(1−2ε)^R]/2. A tiempos cortos se aproxima a Rε y, a tiempos largos, tiende a 1/2; no puede crecer linealmente sin límite. Este artículo representa curvas para distintos valores supuestos de ε y las comprueba de forma independiente mediante una suma binomial. Los errores lógicos reales pueden estar correlacionados, por lo que esta fórmula no puede emplearse directamente para ajustar todos los dispositivos; sin embargo, ayuda a distinguir la tasa de fallo por ronda, la tasa de error final tras un número fijo de rondas y la vida útil de la memoria, evitando mezclar indicadores distintos en una misma clasificación.作者分析与复核建议 / Author analysis
6. La mejora al aumentar la distancia del código exige descartar un suelo de error
Por debajo del umbral del código de superficie, el error lógico puede disminuir al aumentar la distancia del código; los estudios asociados a Willow muestran resultados específicos de almacenamiento y decodificación en tiempo real y también analizan limitaciones, como los eventos correlacionados infrecuentes. Este artículo propone examinar conjuntamente las tendencias a varias distancias, la estabilidad temporal y los eventos raros, en lugar de ajustar una curva exponencial a unas pocas distancias y extrapolarla a tasas de error arbitrariamente bajas. La calidad del hardware, el decodificador y la calibración del ruido pueden variar con la distancia; si no se controlan estos cambios, la mejora observada no puede atribuirse de manera única a un componente algorítmico concreto.[2] Quantum error correction below the surface code thresho
7. Análisis de este artículo: la tasa de procesamiento, la latencia y la acumulación de trabajo pendiente son tres magnitudes distintas
La llegada del síndrome de cada ronda forma un flujo de datos que el sistema de decodificación debe procesar continuamente sin permitir que el trabajo pendiente crezca sin límite. La tasa de procesamiento describe cuántas rondas se completan por unidad de tiempo, mientras que la latencia describe el tiempo desde la entrada de una ronda hasta su respuesta; el procesamiento por lotes puede aumentar la primera y, a la vez, la segunda. Mediante una aproximación fluida con tasa de llegada λ y tasa de servicio μ, este artículo muestra que la acumulación no puede estabilizarse si λ≥μ a largo plazo, y que λ<μ tampoco garantiza el cumplimiento de los requisitos de latencia de cola. El gráfico solo compara tasas de servicio normalizadas y pendientes de acumulación, sin pretender medir hardware. Debe registrarse el tiempo completo de adquisición, transmisión, inferencia y realimentación, no solo el tiempo de ejecución de un núcleo computacional del acelerador.作者分析与复核建议 / Author analysis
8. Los artículos sobre precisión y los artículos sobre sistemas en tiempo real no pueden sustituirse automáticamente entre sí
El artículo original de AlphaQubit señala expresamente que su tasa de procesamiento sigue siendo inferior a la necesaria para el objetivo de una ronda en la escala de microsegundos de los cúbits superconductores, y analiza mejoras como la destilación, la baja precisión y la implementación en hardware; otro experimento por debajo del umbral utiliza su propio sistema de decodificación en tiempo real. Ambos impulsan la computación tolerante a fallos, pero no constituyen una misma cadena de producto cuyo lazo ya esté cerrado. Este artículo recomienda presentar por separado la evidencia sobre precisión algorítmica, distancia del código en chips reales, tasa de procesamiento en flujo, latencia de la realimentación final y operaciones de puertas lógicas. Si una aceleración posterior sacrifica la supresión de errores, deberá reevaluarse con el mismo ruido y la misma distancia del código, sin sustituirla por los resultados del modelo maestro sin comprimir.[1] Learning high-accuracy error decoding for quantum proce[2] Quantum error correction below the surface code thresho[3] Distilling the Knowledge in a Neural Network
9. Los errores infrecuentes requieren observaciones independientes suficientemente prolongadas
Si no se observan errores lógicos en la prueba, la cota superior depende del número de ensayos independientes, del número de rondas y de la estructura de correlación de los eventos. Las lecturas repetidas dentro de una secuencia larga no equivalen a nuevos experimentos completamente independientes, y la deriva del dispositivo puede invalidar el supuesto de distribución idéntica. Este artículo propone estratificar las estadísticas por lote experimental, período temporal y ciclo de calibración, conservando por separado los eventos de fuga, reinicialización y anomalía. En tareas con tasas de error bajas, la ausencia de errores observados debe acompañarse de una cota superior de confianza y no describirse como riesgo nulo; en las comparaciones entre distancias del código deben igualarse las condiciones de ruido y la duración de observación para evitar que las pruebas más cortas parezcan más perfectas.作者分析与复核建议 / Author analysis
10. Agenda de investigación: de la decodificación de memoria a los procesos lógicos componibles
Que un decodificador funcione para memoria lógica no significa que ya maneje todas las puertas lógicas, los cambios de frontera y la información entre bloques. Las investigaciones futuras deberían fijar las interfaces de los componentes y comprobar, durante la composición, la transferencia del estado histórico, los cambios de ruido y los presupuestos de latencia. Pueden reservarse tres grupos de prueba distintos para el desajuste de ruido, la transferencia entre distancias del código y las operaciones lógicas, con el fin de comparar los límites conjuntos de precisión y capacidad de procesamiento. Si el modelo solo funciona bien a la misma distancia y con la misma operación, las conclusiones deben limitarse en consecuencia, sin equiparar el éxito de una memoria de código de superficie con la computación cuántica universal tolerante a fallos.作者分析与复核建议 / Author analysis
Suplemento técnico A · Procesar primero el síndrome y determinar después la clase lógica
Los cambios entre rondas de medición pueden formar eventos de detección, pero los propios errores de medición también producen cambios, de modo que la dimensión temporal no es un adorno adicional. Las rondas repetidas permiten al decodificador distinguir entre cambios físicos persistentes y una anomalía aislada de lectura. Las redes recurrentes conservan un resumen del historial, mientras que estructuras como la atención propagan información espacial; el objetivo final sigue siendo el observable lógico, no recuperar una trayectoria física única. Este artículo recomienda realizar ablaciones separadas de las lecturas actuales, las lecturas blandas y el estado histórico, evaluando sus aportaciones respecto al mismo criterio final de error lógico. Si eliminar el historial no modifica el rendimiento, debe comprobarse si la tarea o la configuración de ruido requieren realmente inferencia de correlaciones temporales.[1] Learning high-accuracy error decoding for quantum proce
Suplemento técnico B · Requisitos de medición para ensayos sin errores observados
En ensayos de Bernoulli independientes e idénticamente distribuidos, la cota superior unilateral al 95% cuando no se observan fallos es aproximadamente 3/n. Para respaldar una tasa de error inferior a 10 elevado a menos seis basándose únicamente en la ausencia de errores observados, se necesitan unos tres millones de ensayos independientes; los objetivos inferiores requieren mediciones más prolongadas. Las rondas reales de corrección de errores pueden compartir deriva y eventos correlacionados, por lo que no se puede considerar sin más cada ronda como un ensayo independiente. Este artículo recomienda informar conjuntamente del número total de rondas, los segmentos experimentales independientes, los ciclos de calibración y las anomalías correlacionadas, estimando los intervalos al nivel adecuado. Si las mediciones son insuficientes, deben conservarse la cota superior y las incógnitas, en vez de sustituir la experimentación por la extrapolación del modelo.作者分析与复核建议 / Author analysis
Suplemento técnico C · Efecto de los cambios de calibración sobre las lecturas blandas
Las lecturas blandas contienen más información que los umbrales duros, pero también pueden ser más sensibles a la ganancia, el sesgo y la deriva del instrumento. Este artículo propone modificar de forma independiente la calibración de lectura después de fijar el decodificador, distinguiendo los cambios reales del ruido de los cambios meramente representacionales. Si el método depende sobre todo de un intervalo numérico específico de la información blanda, una recalibración o un nuevo lote pueden reducir su rendimiento. La evaluación debe conservar las reglas originales de procesamiento de lectura y el momento de calibración; no es válido optimizar primero la transformación con las etiquetas del lote de prueba y denominar después al resultado generalización sin adaptación. Aunque una referencia de lecturas duras contiene menos información, puede ayudar a identificar qué entrada adicional origina las mejoras.作者分析与复核建议 / Author analysis
Suplemento técnico D · Los estados de las ventanas de procesamiento en flujo no pueden concatenarse arbitrariamente
Dividir series temporales largas en ventanas puede reducir el cómputo en tiempo real, pero en las fronteras es necesario transferir correctamente la información histórica o procesar ventanas solapadas. Si cada ventana se decodifica por separado, las cadenas de errores que cruzan ventanas pueden truncarse; si se almacena el estado histórico, los reinicios y los cambios de operación lógica pueden invalidarlo. Este artículo recomienda probar diferentes longitudes de ventana, solapamientos y estrategias de reinicialización, evaluando el fallo lógico de la secuencia larga completa y la latencia de extremo a extremo. La precisión media dentro de las ventanas no basta para demostrar que la composición es correcta: deben comprobarse los eventos de frontera e incluirse en el presupuesto temporal el almacenamiento intermedio y la espera de la respuesta final.作者分析与复核建议 / Author analysis
11. Conclusión: la fiabilidad lógica es el objeto científico de la decodificación
La ventaja de la decodificación mediante aprendizaje es su capacidad de aprovechar información de datos complejos que las aproximaciones diseñadas manualmente pueden pasar por alto; su credibilidad depende de que las clases de equivalencia, el ruido, las muestras y las condiciones de tiempo real se especifiquen simultáneamente. Los ejemplos analíticos de degeneración y paridad de este artículo proporcionan una intuición verificable mediante cálculos independientes, mientras que los experimentos reales de las fuentes conservan sus respectivos límites. La investigación publicada debería facilitar las reglas de generación y ajuste del ruido, las particiones exactas de los datos, los criterios finales lógicos completos y los datos temporales, para que los métodos posteriores se comparen sobre el mismo problema. Solo así pueden transformarse gradualmente tasas de error fuera de línea más bajas en fiabilidad lógica operativa.作者分析与复核建议 / Author analysis
Ecuaciones y derivaciones fundamentales
(1) Sumar las probabilidades posteriores por clase de equivalencia lógica para un síndrome dado; la trayectoria individual más probable no es necesariamente óptima.
LaTeX
\widehat L(s)=\arg\max_L\sum_{E:\,\operatorname{syn}(E)=s,\,[E]=L}P(E\mid s)(2) Probabilidad de un número impar de inversiones lógicas independientes por ronda; no representa todo el ruido real.
LaTeX
P_{\mathrm{odd}}(R)=\frac{1-(1-2\varepsilon)^R}{2}(3) Forma aproximada de escalado en el régimen del umbral, que requiere ruido fijo y validación independiente; no puede extrapolarse a tasas de error arbitrarias.
LaTeX
\varepsilon_d\approx A\left(\frac p{p_{\mathrm{th}}}\right)^{(d+1)/2}(4) Ejemplo determinista de acumulación mediante una aproximación fluida; λ<μ es una condición básica de capacidad, no una garantía de latencia de cola.
LaTeX
Q(t)\approx\max\{0,Q(0)+(\lambda-\mu)t\},\qquad\lambda<\muFlujo de métodos y evidencias
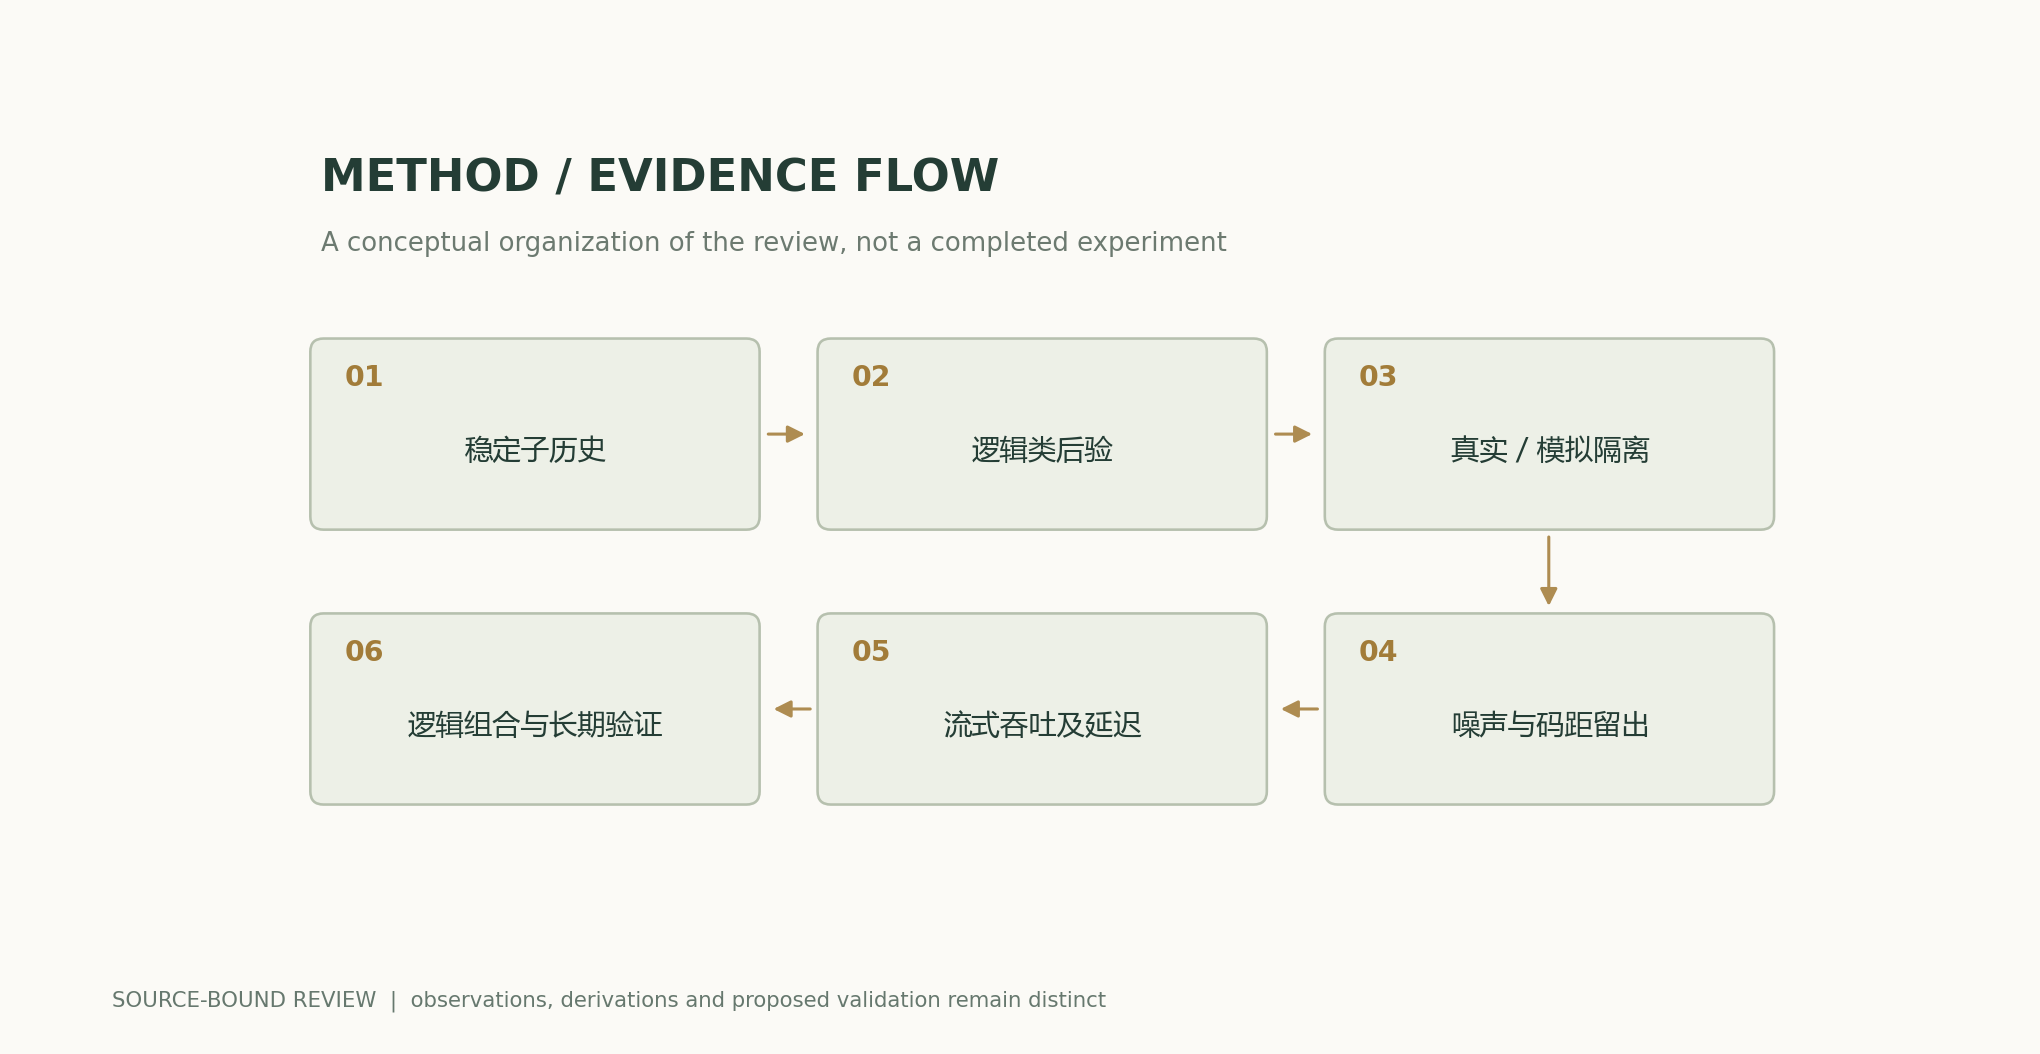
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto reproducible
Para el mismo síndrome, la trayectoria individual de mayor probabilidad, 0.35, pertenece a A, pero la probabilidad total de la clase B, 0.65, es mayor. La fórmula de inversión lógica da aproximadamente 0.090717 tras 100 rondas con epsilon=0.001; el trabajo pendiente aumenta cuando la tasa de servicio es insuficiente.
Comparación de métodos
| Evidencia | Qué debe comunicarse | Criterios que no deben confundirse |
|---|---|---|
| Decodificación lógica | Síndrome completo y fallo lógico | Precisión de clasificación por medición |
| Chip real | Dispositivo, distancia del código y período temporal | Simulación de distancias mayores |
| Ruido correlacionado | Fugas, lecturas blandas y fuentes del ajuste | Rendimiento con ruido independiente e idénticamente distribuido |
| Escalado de la distancia | Tendencias a varias distancias con ruido equiparado | Garantía de tasas de error arbitrariamente bajas |
| Ejecución en tiempo real | Tasa de procesamiento sostenida, latencia y trabajo pendiente | Velocidad de un único núcleo computacional |
| Composición tolerante a fallos | Operaciones lógicas y transferencia de estado | Equiparar memoria estática y computación universal |
Plan de verificación y experimentación
- Fijar el código, el observable lógico, el modelo de ruido y la versión del decodificador.
- Separar las muestras reales utilizadas para ajustar el ruido, entrenar, aplicar la parada temprana y evaluar.
- Registrar por separado las distancias de código en chips y en simulaciones, sin fusionarlas en una única clase de validación.
- Comparar el mismo criterio final lógico y conservar la definición de las clases de equivalencia de errores físicos.
- Comunicar errores e intervalos por tiempo, lote de calibración y eventos correlacionados.
- Medir la tasa de llegada, la tasa de servicio, la latencia de cola y el trabajo pendiente bajo carga sostenida.
- Volver a validar los errores lógicos tras acelerar o comprimir, sin sustituir esa validación por resultados del maestro original.
- Reservar pruebas separadas para puertas lógicas, fronteras y composición entre bloques, conservando todos los eventos anómalos.
Ámbito de aplicación y limitaciones
- El ejemplo de degeneración, las probabilidades de paridad y el modelo de cola son construcciones analíticas.
- No se ha simulado un chip cuántico, entrenado un decodificador ni realizado nuevos experimentos cuánticos.
- La aproximación del umbral depende de un ruido específico y puede existir un suelo de error debido a errores correlacionados.
- Los resultados de precisión y los sistemas en tiempo real de los estudios originales no corresponden a una misma implementación.
- La observación finita y la deriva limitan la inferencia de tasas de error extremadamente bajas.
Evidencia de los estudios originales y su ámbito de aplicación
| Resultados de los estudios originales | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| Distancias de código reales de Sycamore 3/5, con comparaciones simuladas hasta la distancia 11. | La sección sobre velocidad del artículo original aún señala una brecha respecto al objetivo de procesamiento en la escala de microsegundos. | Aprendizaje de la decodificación de errores de alta precisión para procesadores cuánticosResumen; velocidad de decodificación |
| El almacenamiento y la decodificación en tiempo real de Willow demuestran experimentos específicos por debajo del umbral. | Utiliza su propio sistema de decodificación; no son resultados de AlphaQubit en tiempo real. | Corrección de errores cuánticos por debajo del umbral del código de superficieResumen; memoria de código de superficie; decodificación en tiempo real |
Preguntas de investigación que conviene contrastar
- Con un mismo objetivo de fallo lógico, ¿cuánto aportan, respectivamente, las lecturas blandas y la información histórica?
- ¿Se mantienen simultáneamente los límites de precisión y tasa de procesamiento después de una deriva del ruido?
- ¿Puede un decodificador comprimido admitir la composición de operaciones lógicas sin acumular sesgo en el estado oculto?
Fuentes primarias y afirmaciones correspondientes
- Learning high-accuracy error decoding for quantum processorsBausch et al. · 2024-11-20Experimental distance 3/5; simulated distances through 11; Methods decoding speed distinguishes throughput and latency.
- Quantum error correction below the surface code thresholdGoogle Quantum AI and Collaborators · 2024-12-09Willow surface-code memories, real-time distance-5 decoder and rare correlated errors; updated article noted.
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación documentada y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a sus equipos de investigación; los cálculos de este artículo solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio todavía no dispone, para este artículo, de registros de revisión independiente por pares ni de modelos originales o experimentos clínicos o físicos originales.
Primera publicación: monográfico en profundidad sobre IA y descubrimiento científico; se conservan las fuentes por sección y los límites entre la evidencia de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos adjuntos; sus leyendas detallan los supuestos y los criterios de medición.
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Python · Código para reproducir los cálculos · Historial de publicación y versiones
Revisión de la fuente: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c