
要旨
量子誤り訂正は、冗長な測定を通じて符号化された情報に論理誤りが生じたかを推定するものであり、復号器は相関を持ち、時間変動し、部分的にしか観測できないノイズの下で動作しなければならない。AlphaQubitは学習型復号の精度面での可能性を示し、表面符号のしきい値を下回る量子メモリ実験は、ハードウェア、符号距離、リアルタイム処理の要件が同時に成立する必要性を示している。本稿は論理的同値類を出発点として、誤りの縮退、有限標本、符号距離に伴うスケーリング、スループットと遅延を分析する。実チップでの符号距離に関する結果、より大きな符号距離のシミュレーション、エンドツーエンドのリアルタイムシステムを厳密に区別する。図表は古典的な解析計算にすぎず、当サイトによる量子プロセッサ実験ではない。[1] Learning high-accuracy error decoding for quantum proce[2] Quantum error correction below the surface code thresho
原文の英語要旨の日本語訳
表面符号の復号は論理的同値類に対する推論であり、単に最も確からしい物理誤りの位置を特定することではない。本稿では、実験とシミュレーションの符号距離を区別しながら、AlphaQubitとしきい値以下の量子メモリ実験を検討する。縮退の例によって誤りクラスについて確率を足し合わせる重要性を説明し、論理パリティとサービス率の計算によって有限データと運用要件を結び付ける。数値プロットは解析的に構成したものであり、量子プロセッサをシミュレートするものでも、耐故障性のしきい値を確立するものでもない。
1. スタビライザーの読み出しが明らかにするのは誤りの一部にすぎない
表面符号では、スタビライザー測定の反復によってシンドローム情報を得る。異なる複数の物理誤りが同じ観測を与えることがあり、その一部は互いに同値である一方、別のもの同士は論理操作の分だけ異なる。したがって、復号は各量子ビットに起こったことを一意に復元する作業ではなく、論理情報を保持できる同値類を選ぶ作業である。AlphaQubitは再帰的な構造によって測定履歴を処理し、時空間情報を論理誤りの予測に変換する。このことから本稿では、評価対象は論理的失敗であるべきであり、測定ビットごとの分類精度だけでは不十分であると強調する。イベントのない読み出しが大量にあれば後者は良好に見えるが、それによって量子情報の保存が保証されるわけではない。[1] Learning high-accuracy error decoding for quantum proce
2. 本稿での導出:最も確からしい経路が最も確からしい同値類に属するとは限らない
あるシンドロームの下で、互いに排他的な三つの候補を構成する。クラスAには経路が一つだけあり、その条件付き確率は0.35である。クラスBには二つの経路があり、それぞれの確率は0.33と0.32である。経路ごとの最大確率ではAが選ばれるが、Bの総確率は0.65であるため、論理クラスごとに確率を足し合わせるとBが選ばれる。この小さな例は誤りの縮退の意味を示すものであり、実際の符号における確率分布には対応しない。マッチング、テンソルネットワーク、学習型の復号器を比較する際に重要なのは、相関と同値類の確率質量をどのように扱うかであり、学習手法を単に大規模な誤り位置分類器と解釈すべきではない。作者分析与复核建议 / Author analysis
3. 実チップとシミュレーション上の符号距離は異なる証拠水準にある
AlphaQubitの原論文は、Sycamoreの実データを用いて符号距離3と5を研究し、さらに大きな符号距離11までのシミュレーションで相関ノイズの条件を比較している。事前学習と限られた実標本による適応によって、モデルはより複雑なノイズ情報を利用できるが、シミュレーション上の符号距離11を、実チップですでに同等の実証を達成したかのように記述してはならない。学習、検証、テストについても、実験標本の使用とノイズモデルのフィッティングを通じた情報の分離が必要である。全実験データを用いて先にノイズモデルをフィッティングし、そのモデルからテスト標本を生成すると、外部汎化の問題の難しさが変わる。[1] Learning high-accuracy error decoding for quantum proce
4. 相関ノイズとリーケージによって時間履歴が重要になる
独立同分布のPauli誤りモデルは計算に便利であるが、実機ではクロストーク、リーケージ、アナログ読み出しの変化、周期をまたぐ相関が生じうる。AlphaQubitの研究は、履歴状態とソフト情報を用いてこれらの現象に対処している。本稿ではこれを隠れ状態の推論問題と解釈する。すなわち、現在のシンドロームが同じでも、履歴条件が異なれば対応する事後分布は異なりうる。評価では、同じノイズ生成器から標本数を増やすだけでなく、ノイズ強度、相関長、較正ドリフトを個別に変化させ、モデルがどの時点で不適合になるかを観察すべきである。学習分布がテスト時のノイズに近いほど、真に独立した時間区間を別途確保する必要性が高まる。[1] Learning high-accuracy error decoding for quantum proce[2] Quantum error correction below the surface code thresho
5. 本稿での導出:複数ラウンドのパリティ失敗とラウンド当たり誤り率の関係
各ラウンドで論理ビットが独立に確率εで反転するなら、Rラウンド後に奇数回の反転が起こる確率は[1−(1−2ε)^R]/2である。これは短時間ではRεで近似され、長時間では1/2に近づくため、無限に線形増加することはない。本稿では、仮定したεの異なる値について曲線を描き、二項和によって独立に照合する。実際の論理誤りには相関がありうるため、この式をあらゆる装置に直接フィッティングすることはできない。しかし、この式は、ラウンド当たりの失敗率、固定ラウンド数後の最終誤り率、メモリ寿命を区別し、異なる指標を同じランキングに混在させないために役立つ。作者分析与复核建议 / Author analysis
6. 符号距離増大による改善ではエラーフロアを除外する必要がある
表面符号がしきい値以下にある場合、符号距離の増大に伴って論理誤りは低下しうる。Willow関連の研究は特定のメモリおよびリアルタイム復号の結果を示すとともに、まれな相関イベントなどの制約も論じている。本稿では、少数の距離に指数曲線を当てはめて任意に低い誤り率まで外挿するのではなく、複数の符号距離にわたる傾向、時間的安定性、希少イベントを併せて調べるべきだとする。ハードウェアの品質、復号器、ノイズ較正はいずれも距離とともに変化しうる。こうした変化を統制しなければ、観測された改善を特定のアルゴリズム構成要素に一意に帰属させることはできない。[2] Quantum error correction below the surface code thresho
7. 本稿での分析:スループット、遅延、処理待ち量は別々の量である
各ラウンドのシンドロームの到着はデータストリームを形成し、復号システムは処理待ち量を無制限に増加させることなく継続処理しなければならない。スループットは単位時間に完了するラウンド数を表し、遅延はあるラウンドの入力から回答までの時間を表す。バッチ処理は前者を高める一方、後者を増加させうる。本稿では到着率λとサービス率μを用いた流体近似により、長期的にλ≥μであれば処理待ち量は安定せず、λ<μでもテール遅延の要件達成は保証されないことを示す。図は正規化したサービス率と処理待ち量の増加勾配を比較するだけであり、ハードウェアを測定したと称するものではない。アクセラレータの単一カーネルの実行時間だけでなく、取得、転送、推論、フィードバックまでの全時間を記録すべきである。作者分析与复核建议 / Author analysis
8. 精度に関する論文とリアルタイムシステムに関する論文は自動的に相互代替できない
AlphaQubitの原論文は、そのスループットが超伝導量子ビットの一ラウンド当たりマイクロ秒級という目標にまだ届かないことを明示し、蒸留、低精度化、ハードウェア実装などの改善方向を論じている。一方、別のしきい値以下の実験は独自のリアルタイム復号システムを使用している。両者はともに耐故障計算を前進させるが、すでに閉ループ化された単一の製品系を構成するわけではない。本稿では、アルゴリズムの精度、実チップの符号距離、ストリーミングスループット、最終フィードバック遅延、論理ゲート操作について、証拠を個別に列挙することを提案する。後続の高速化で誤り抑制が犠牲になる場合も、同じノイズと符号距離の下で再評価する必要があり、非圧縮の教師モデルの結果を代わりに引用してはならない。[1] Learning high-accuracy error decoding for quantum proce[2] Quantum error correction below the surface code thresho[3] Distilling the Knowledge in a Neural Network
9. まれな誤りには十分に長い独立観測が必要である
テストで論理誤りが観測されなかった場合、その上限は独立試行数、ラウンド数、イベントの相関構造に依存する。長い系列内の反復読み出しは、完全に独立した新たな実験と同等ではなく、装置のドリフトによって同一分布の仮定が崩れる可能性もある。本稿では、実験バッチ、時間区間、較正周期ごとに統計を層別化し、リーケージ、リセット、異常イベントを個別に保存することを提案する。低誤り率の課題では、誤り観測ゼロをリスクゼロと記述するのではなく、片側信頼上限を報告すべきである。符号距離間の比較ではノイズ条件と観測時間をそろえ、短いテストほど完全に見えることを避ける必要がある。作者分析与复核建议 / Author analysis
10. 研究課題:メモリ復号から合成可能な論理プロセスへ
ある復号器が論理メモリで動作するからといって、すべての論理ゲート、境界変化、ブロック間情報をすでに扱えることにはならない。今後の研究では構成要素のインターフェースを固定し、合成過程での履歴状態の受け渡し、ノイズ変化、遅延予算を検証すべきである。ノイズ不一致、符号距離の転移、論理操作についてそれぞれホールドアウト群を設け、精度と処理能力の共同限界を比較できる。同じ距離かつ同じ操作でしか良好な性能を示さないモデルについては、表面符号メモリでの成功を汎用的な耐故障量子計算と同一視せず、実態に即して結論を限定すべきである。作者分析与复核建议 / Author analysis
技術補足 A · まずシンドロームを処理し、その後に論理クラスを判定する
ラウンド間の測定値の変化は検出イベントを形成しうるが、測定誤りそのものも変化を生むため、時間次元は付加的な装飾ではない。ラウンドの反復によって、復号器は持続的な物理変化と単発の読み出し異常を区別できる。再帰型ネットワークは履歴の要約を保持し、注意機構などの構造は空間情報を伝播するが、最終的な目標は依然として論理観測量であり、一意な物理経路の復元ではない。本稿では、現在の読み出し、ソフト読み出し、履歴状態をそれぞれ除去するアブレーションを行い、同じ論理誤りの評価終点における寄与を評価することを提案する。履歴を除いても性能が変わらない場合には、その課題やノイズ設定が本当に時間相関の推論を必要とするかを検討すべきである。[1] Learning high-accuracy error decoding for quantum proce
技術補足 B · 誤り観測ゼロの試験に必要な測定量
独立同分布のベルヌーイ試行では、失敗ゼロの場合の片側95%上限はおよそ3/nである。誤り率が10の負の六乗未満であることを、誤り観測ゼロだけに基づいて支持するには、約三百万回の独立試行が必要となり、さらに低い目標にはより長い測定が必要である。実際の誤り訂正ラウンドはドリフトや相関イベントを共有しうるため、各ラウンドを単純に独立試行と見なすことはできない。本稿では、総ラウンド数、独立した実験区間、較正周期、相関した異常を併せて報告し、適切な階層で区間推定を行うことを提案する。測定が不十分な場合は、モデルの外挿で実験を代替せず、上限と未確定事項をそのまま示すべきである。作者分析与复核建议 / Author analysis
技術補足 C · 較正の変化がソフト読み出しに及ぼす影響
ソフト読み出しはハードなしきい値判定より多くの情報を持つ一方、測定器の利得、オフセット、ドリフトに対してより敏感である可能性もある。本稿では、復号器を固定した後に読み出し較正を独立に変え、実際のノイズ変化と表現だけの変化を区別することを提案する。手法が主としてソフト情報の特定の数値範囲に依存する場合、再較正や新たなバッチによって性能が低下しうる。評価では元の読み出し処理規則と較正時刻を保持すべきであり、テストバッチのラベルで写像を先に最適化してから、適応なしの汎化と称してはならない。ハード読み出しのベースラインは情報量が少ないものの、どの追加入力に由来する利得かを特定する助けになる。作者分析与复核建议 / Author analysis
技術補足 D · ストリーミングウィンドウの状態は任意に接続できない
長い時系列をウィンドウに分割するとリアルタイム計算を削減できるが、境界では履歴情報の正しい受け渡しか、重なりを持たせた処理が必要となる。各ウィンドウを独立に復号すると、ウィンドウをまたぐ誤り鎖が切断されうる。一方、履歴状態をキャッシュする場合は、再起動や論理操作の切り替えによって状態が無効になる可能性がある。本稿では、異なるウィンドウ長、重なり、リセット方式を試験し、長い系列全体での論理的失敗とエンドツーエンド遅延を評価することを提案する。ウィンドウ内の平均精度だけでは合成の正しさを証明できない。境界イベントを照合し、バッファリングと最終回答までの待ち時間を時間予算に含める必要がある。作者分析与复核建议 / Author analysis
11. 結論:復号の科学的な対象は論理的信頼性である
学習型復号の利点は、手作業による近似が見落としうる情報を複雑なデータから利用できる点にある。その信頼性は、同値類、ノイズ、標本、リアルタイム条件が同時に明確化されているかに依存する。本稿の縮退とパリティの解析例は独立に再計算できる直観を与えるものであり、出典にある実実験はそれぞれ固有の適用範囲を保つ。公開研究では、後続の手法が同じ問題で比較できるよう、ノイズの生成・フィッティング規則、正確なデータ分割、完全な論理的評価終点、タイミングデータを提供すべきである。そうして初めて、オフライン誤り率の低下を実際に運用可能な論理的信頼性へ段階的に転換できる。作者分析与复核建议 / Author analysis
主要な数式と導出
(1) 与えられたシンドロームの下で、論理的同値類ごとに事後確率を足し合わせる。最も確からしい単一経路が最適とは限らない。
LaTeX
\widehat L(s)=\arg\max_L\sum_{E:\,\operatorname{syn}(E)=s,\,[E]=L}P(E\mid s)(2) ラウンドごとに独立な論理反転が奇数回起こる確率。実際のすべてのノイズを表すものではない。
LaTeX
P_{\mathrm{odd}}(R)=\frac{1-(1-2\varepsilon)^R}{2}(3) しきい値領域における近似的なスケーリング形式。ノイズの固定と独立検証が必要であり、任意の誤り率まで外挿できない。
LaTeX
\varepsilon_d\approx A\left(\frac p{p_{\mathrm{th}}}\right)^{(d+1)/2}(4) 決定論的な流体近似による処理待ち量の例。λ<μは基本的な容量条件であり、テール遅延を保証するものではない。
LaTeX
Q(t)\approx\max\{0,Q(0)+(\lambda-\mu)t\},\qquad\lambda<\mu方法と証拠の流れ
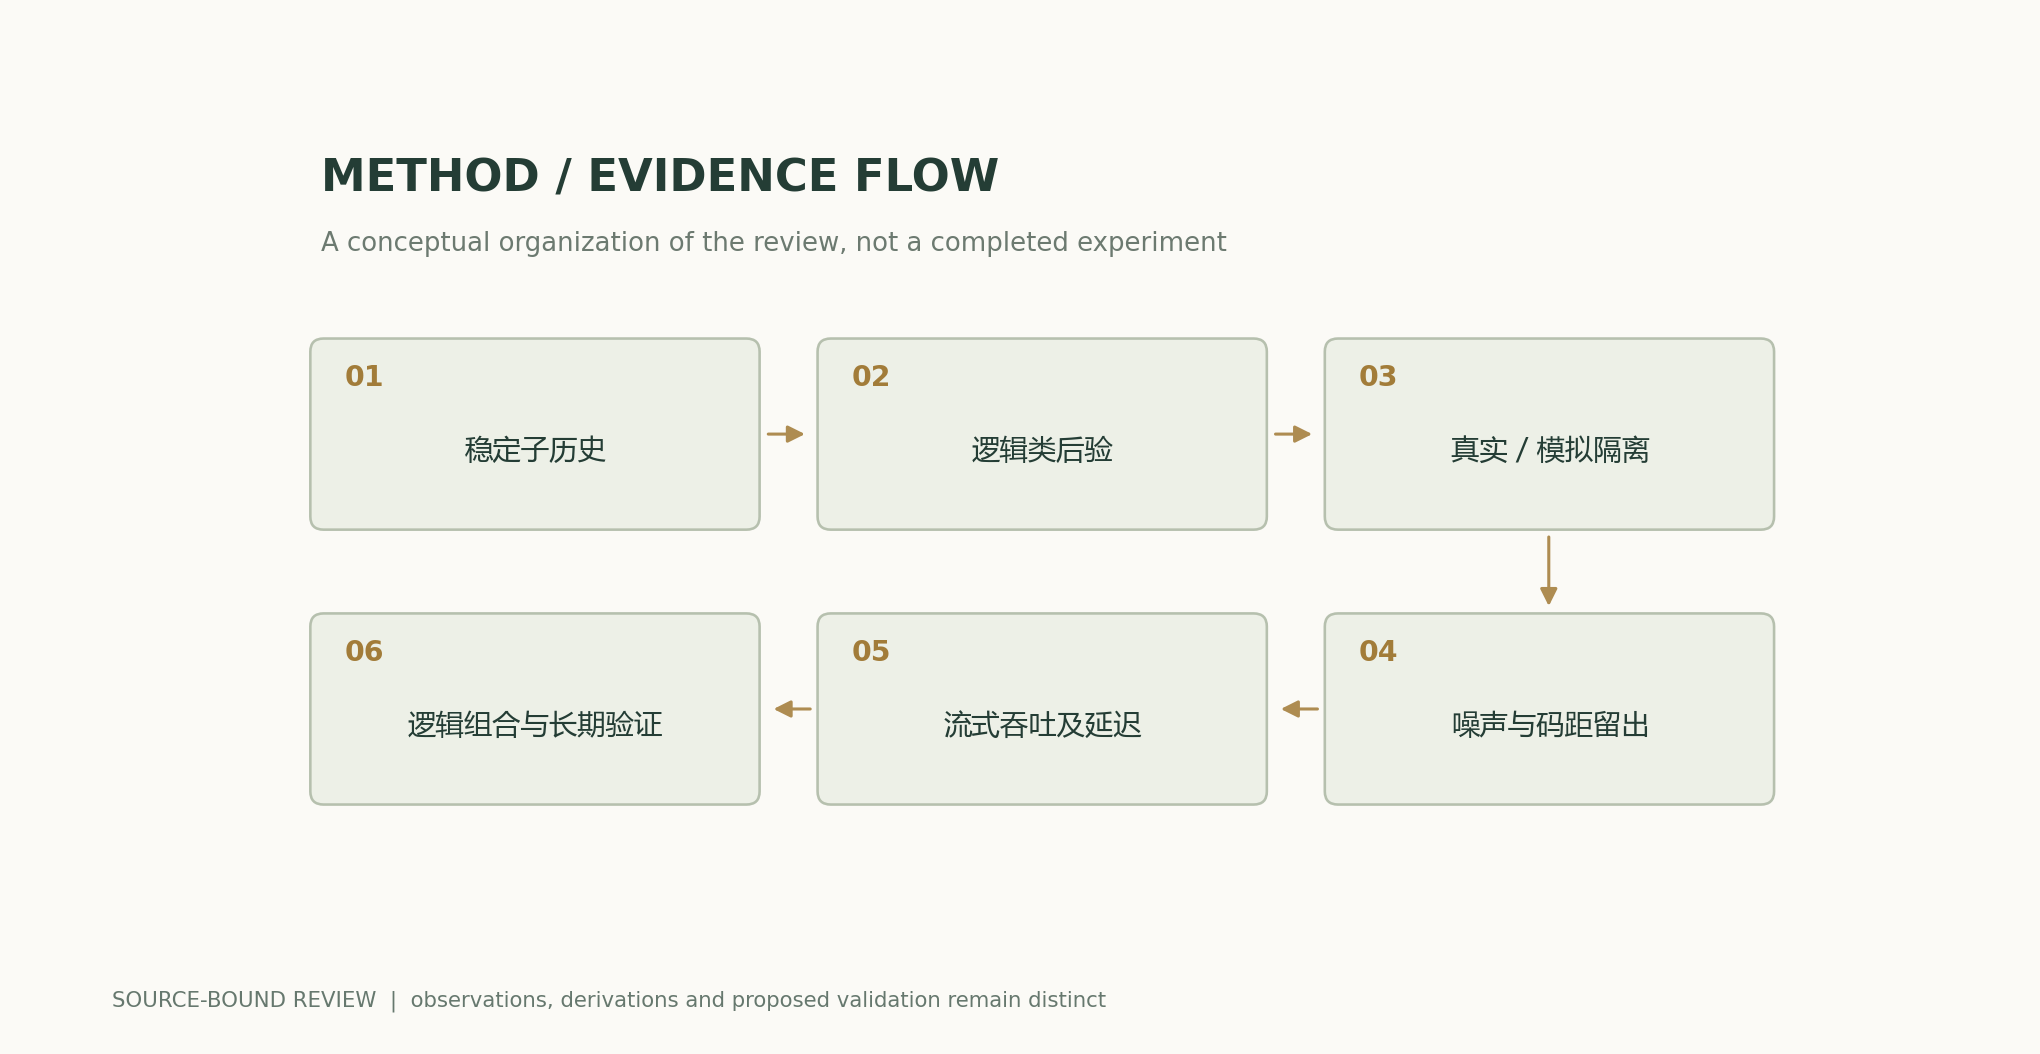
解析的な図と数値例
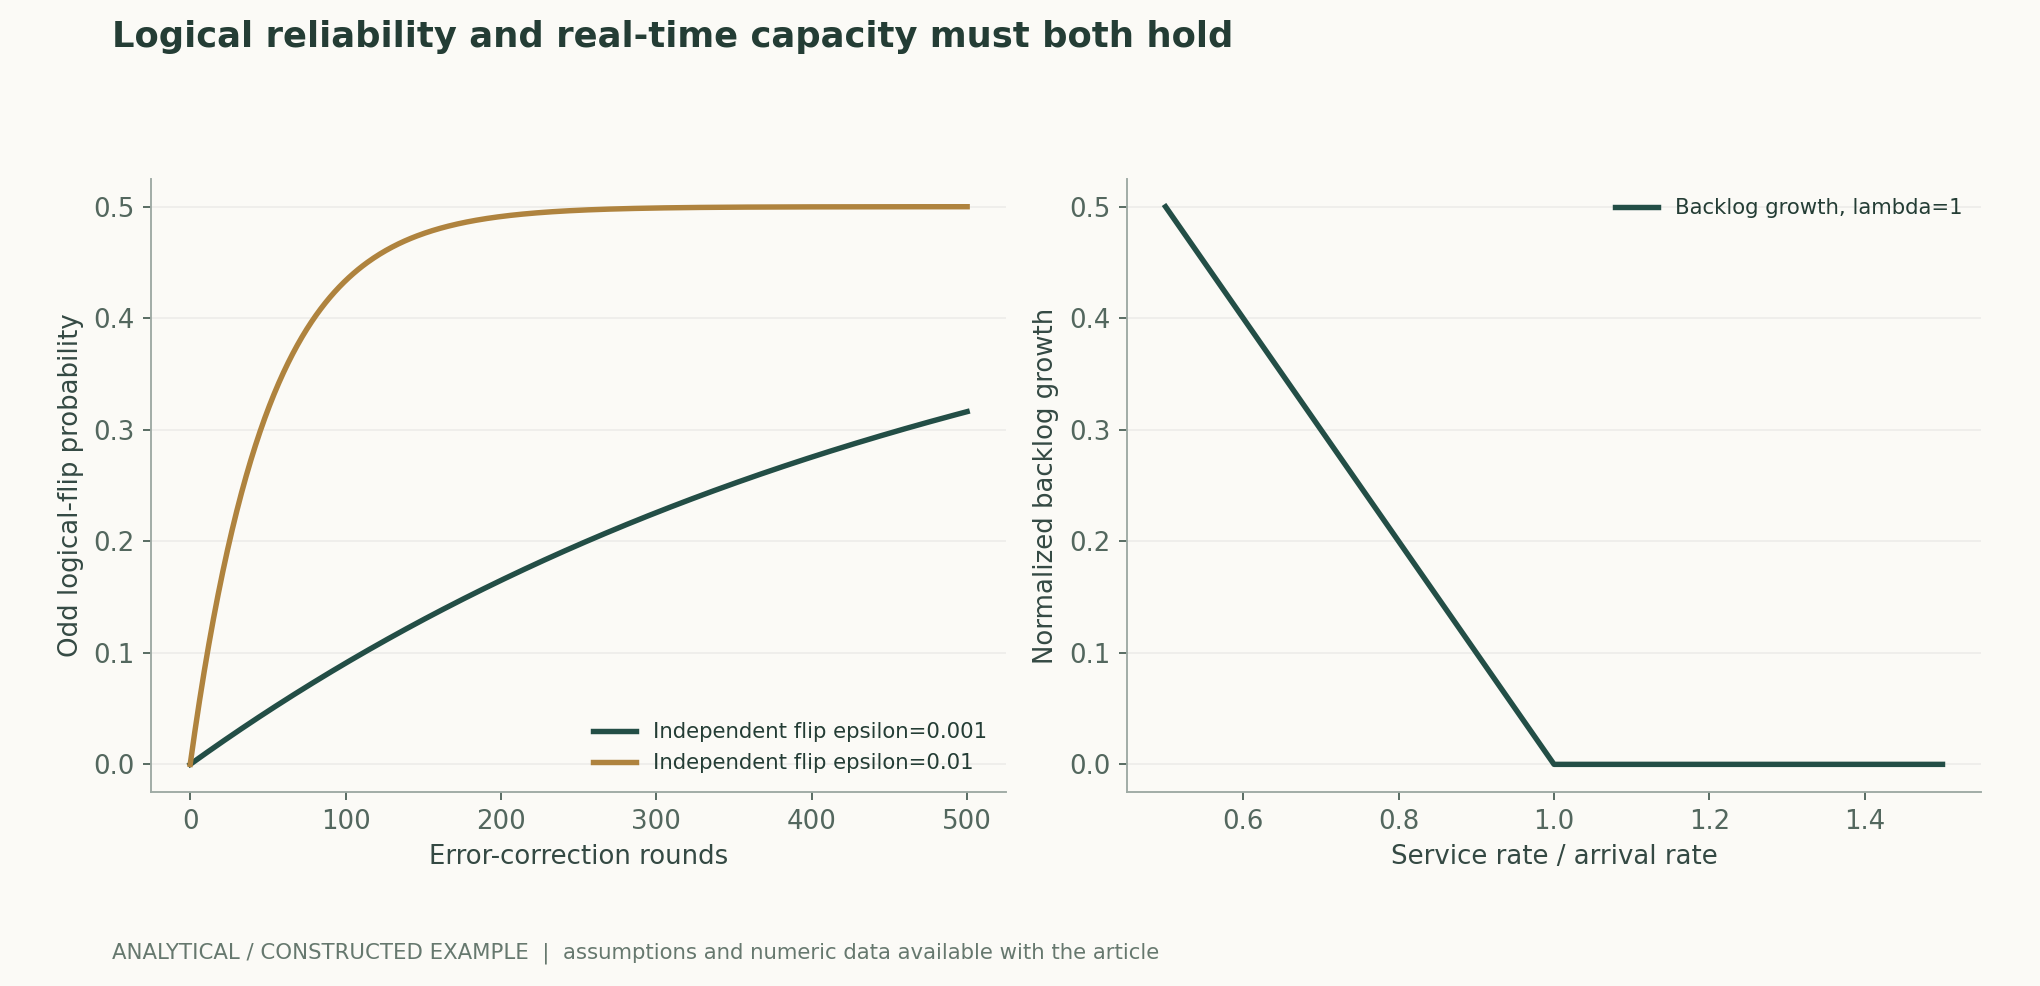
再計算可能な例題
同じシンドロームの下で、最大の単一経路確率0.35はAに属するが、Bクラスの総確率0.65のほうが大きい。論理反転の式では、100ラウンド、epsilon=0.001のとき約0.090717となる。サービス率が不足すると処理待ち量は増加する。
方法の比較
| 証拠 | 報告すべき対象 | 混同してはならない評価基準 |
|---|---|---|
| 論理復号 | 完全なシンドロームと論理的失敗 | 測定ごとの分類精度 |
| 実チップ | デバイス、符号距離、時間区間 | より大きな距離のシミュレーション |
| 相関ノイズ | リーケージ、ソフト読み出し、フィッティングの情報源 | 独立同分布ノイズ下の性能 |
| 距離の拡張 | ノイズをそろえた複数距離での傾向 | 任意に低い誤り率の保証 |
| リアルタイム実行 | 持続的スループット、遅延、処理待ち量 | 単一カーネルの速度 |
| 耐故障的な合成 | 論理操作と状態の受け渡し | 静的メモリと汎用計算の同一視 |
再検証と実験の計画
- 符号、論理観測量、ノイズモデル、復号器のバージョンを固定する。
- ノイズのフィッティング、学習、早期停止、テストの間で実標本を分離する。
- チップ上とシミュレーション上の符号距離を別々に記録し、一種類の検証に統合しない。
- 同じ論理的評価終点を比較し、物理誤りの同値類の定義を保持する。
- 時間、較正バッチ、相関イベントごとに誤りと区間を報告する。
- 持続負荷の下で、到着率、サービス率、テール遅延、処理待ち量を測定する。
- 高速化や圧縮後には論理誤りを再検証し、元の教師モデルの結果の引用で代替しない。
- 論理ゲート、境界、ブロック間合成について別途ホールドアウトを設け、すべての異常イベントを保持する。
適用範囲と限界
- 縮退の例、パリティ確率、待ち行列モデルはいずれも解析的な構成である。
- 量子チップのシミュレーション、復号器の学習、新たな量子実験はいずれも行っていない。
- しきい値近似は特定のノイズに依存し、相関誤りによるエラーフロアが存在する可能性がある。
- 原研究の精度結果とリアルタイムシステムは同一の実装ではない。
- 有限の観測とドリフトによって、極めて低い誤り率の推論には制約が生じる。
原研究の証拠と適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| 実機Sycamoreでの符号距離は3/5であり、シミュレーションでは符号距離11まで比較している。 | 原論文の速度に関する節では、マイクロ秒級のスループット目標に対してなお隔たりがある。 | 量子プロセッサのための高精度誤り復号の学習要旨;復号速度 |
| Willowのメモリとリアルタイム復号は、しきい値以下の特定の実験を実証している。 | 独自の復号システムを使用しており、AlphaQubitのリアルタイム結果ではない。 | 表面符号のしきい値を下回る量子誤り訂正要旨;表面符号メモリ;リアルタイム復号 |
検証に値する研究上の問い
- 同じ論理的失敗の目標の下で、ソフト読み出しと履歴情報はそれぞれどれだけ寄与するか。
- ノイズのドリフト後も、精度とスループットの限界はともに維持されるか。
- 圧縮後の復号器は、隠れ状態のバイアスを蓄積せずに論理操作の合成を支えられるか。
一次資料と主張の対応
- Learning high-accuracy error decoding for quantum processorsBausch et al. · 2024-11-20Experimental distance 3/5; simulated distances through 11; Methods decoding speed distinguishes throughput and latency.
- Quantum error correction below the surface code thresholdGoogle Quantum AI and Collaborators · 2024-12-09Willow surface-code memories, real-time distance-5 decoder and rare correlated errors; updated article noted.
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、バージョン、出典
Codex(AI)が執筆した、出典を伴う研究レビューと独自の解析である。原論文の実験は元の研究チームに帰属し、本稿の計算は記載した数式と明示した仮定のみを検証する。当サイトには、本稿について独立した査読、独自モデル、独自の臨床実験および物理実験の記録は現時点で存在しない。
初出:AIと科学的発見に関する詳細特集。節ごとの出典を保持し、原研究の証拠と著者による解析の境界を明確にする。
概念的な表紙図はImageGenが生成した。科学図は付属のコードと数値ファイルから作図し、図注では仮定と測定基準を項目ごとに説明している。
表紙図と科学図の出典 · データ、出典、仮定 · Python · 再計算可能なコード · 公開・改版履歴
ソースのリビジョン: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c