
摘要
量子纠错通过冗余测量推断编码信息是否发生逻辑错误,而译码器必须在相关、时变且部分可见的噪声下工作。AlphaQubit 展示学习译码的准确性潜力,低于表面码阈值的量子存储实验则表明硬件、码距与实时处理必须共同成立。本文从逻辑等价类出发,分析误差简并、有限样本、码距缩放与吞吐延迟。我们严格区分真实芯片上的码距结果、模拟更大码距和端到端实时系统;图表只是经典解析计算,不是本站量子处理器实验。[1] Learning high-accuracy error decoding for quantum proce[2] Quantum error correction below the surface code thresho
English abstract
Surface-code decoding is inference over logical equivalence classes, not simply localization of the most likely physical error. We examine AlphaQubit and below-threshold quantum-memory experiments while keeping experimental and simulated code distances separate. A degeneracy example explains why summing over error classes matters; logical-parity and service-rate calculations connect finite data to operational requirements. The numerical plots are analytical constructions and do not simulate a quantum processor or establish a fault-tolerance threshold.
1. 稳定子读数只揭示误差的一部分
表面码以重复稳定子测量形成 syndrome 信息,多个不同物理误差可以给出相同观测,其中一部分彼此等价,另一部分则相差逻辑操作。因此,译码不是唯一恢复每个量子比特上发生过什么,而是选择能保持逻辑信息的等价类。AlphaQubit 用循环结构处理测量历史,把时空信息转换为逻辑错误预测。本文据此强调评价对象必须是逻辑失败,而不只是逐测量位的分类准确率;大量无事件读数可以让后者很好看,却不能保证量子信息保存。[1] Learning high-accuracy error decoding for quantum proce
2. 本文推导:最可能路径不一定属于最可能等价类
构造某个 syndrome 下的三个互斥候选:类 A 只有一条路径,条件概率为 0.35;类 B 有两条路径,概率分别为 0.33 和 0.32。逐路径最大概率会选 A,但 B 的总概率为 0.65,因此按逻辑类求和会选择 B。这个小例子说明误差简并的意义,不对应真实码上的概率分配。比较匹配、张量网络和学习译码器时,重要的是它们如何处理相关性与等价类质量,而不能只把学习方法解释成更大的错误位置分类器。作者分析与复核建议 / Author analysis
3. 真实芯片与模拟码距是不同证据层级
AlphaQubit 原文在 Sycamore 真实数据上研究码距 3 和 5,并在更大码距到 11 的模拟中比较相关噪声情形。预训练与有限真实样本适配使模型能够利用较复杂的噪声信息,但不能把模拟码距 11 写成真实芯片已完成同等演示。训练、验证和测试还需在实验样本与噪声模型拟合之间隔离。若用全部实验数据先拟合噪声模型,再从该模型生成测试样本,会改变外部泛化问题的难度。[1] Learning high-accuracy error decoding for quantum proce
4. 相关噪声与泄漏让时间历史变得重要
独立同分布的 Pauli 错误模型便于计算,但真实装置可能出现串扰、泄漏、模拟读数变化和跨周期相关。AlphaQubit 的研究利用历史状态与软信息处理这些现象。本文将其解释为隐状态推断问题:相同当前 syndrome 在不同历史条件下可能对应不同后验。评价应分别改变噪声强度、相关长度与校准漂移,观察模型何时失配,而不只在同一噪声生成器上增加样本。训练分布越接近测试噪声,越需要另外保留真正独立的时间段。[1] Learning high-accuracy error decoding for quantum proce[2] Quantum error correction below the surface code thresho
5. 本文推导:多轮奇偶失败与单轮错误率的关系
若每轮独立地以概率 ε 翻转逻辑比特,R 轮后发生奇数次翻转的概率为 [1−(1−2ε)^R]/2。它在短时间近似 Rε,长时间趋向 1/2,不能无限线性增长。本文绘制不同假定 ε 的曲线,并用二项求和独立核对。实际逻辑错误可能相关,因此不能用该式直接拟合所有设备;但它帮助研究者区分每轮失败率、固定轮数的最终错误率和存储寿命,避免把不同指标放进同一排行榜。作者分析与复核建议 / Author analysis
6. 码距增加后的改善需要排除错误地板
表面码低于阈值时,逻辑错误可随码距增加而下降;Willow 相关研究展示了特定存储与实时译码结果,同时讨论稀少相关事件等限制。本文主张同时检查多码距趋势、时间稳定性和罕见事件,不在少数距离上拟合一条指数线后外推到任意低错误率。硬件质量、译码器和噪声校准都可能随距离变化,若没有控制这些变化,观察到的改进无法唯一归因于某个算法部件。[2] Quantum error correction below the surface code thresho
7. 本文分析:吞吐率、延迟与积压是三个量
每轮 syndrome 到达形成数据流,译码系统需持续处理而不让积压无界增长。吞吐率描述单位时间完成多少轮,延迟描述某轮从输入到答案的时间,批处理可以提高前者却增加后者。本文用到达率 λ 与服务率 μ 的流体近似说明:长期 λ≥μ 时积压无法稳定,λ<μ 仍不能保证尾延迟达标。图只比较归一化服务率和积压斜率,不假装测量硬件。应记录采集、传输、推理和反馈的完整时间,而非单次加速器内核耗时。作者分析与复核建议 / Author analysis
8. 准确率论文与实时系统论文不能自动互相替代
AlphaQubit 原文明确其吞吐尚慢于超导量子比特每轮微秒级目标,讨论蒸馏、低精度和硬件实现等改进方向;另一项低阈值实验使用自己的实时译码系统。两者共同推进容错计算,却不是同一个已经闭合的产品链。本文建议对算法准确性、实际芯片码距、流式吞吐、最终反馈延迟和逻辑门操作分别列证据。后续加速若牺牲错误抑制,也必须在相同噪声和码距上重新评价,不能引用未压缩教师的结果。[1] Learning high-accuracy error decoding for quantum proce[2] Quantum error correction below the surface code thresho[3] Distilling the Knowledge in a Neural Network
9. 稀少错误需要足够长的独立观测
若测试没有看到逻辑错误,上界取决于独立试验数、轮数和事件相关结构。长序列内重复读数不等于完全独立的新实验,设备漂移又可能让同分布假设失效。本文提出按实验批次、时间段和校准周期分层统计,单独保存泄漏、复位与异常事件。对低错误率任务,零观测应报告置信上界,而不能写成零风险;对跨码距比较,则应匹配噪声条件和观测长度,避免较短测试看起来更完美。作者分析与复核建议 / Author analysis
10. 研究议程:从记忆译码到可组合逻辑过程
一个译码器在逻辑存储上工作,并不意味着它已经处理全部逻辑门、边界变化与跨块信息。未来研究应冻结部件接口,在组合过程中检验历史状态传递、噪声变化和延迟预算。可分别设置噪声失配、码距迁移和逻辑操作三组留出,比较准确性与处理能力的联合边界。若模型只能在同距离同操作中表现好,应据实限定结论,而不是把表面码记忆的成功等同于通用容错量子计算。作者分析与复核建议 / Author analysis
技术补充 A · 先处理 syndrome,再判逻辑类
每轮测量的变化可以形成探测事件,但测量错误本身也会产生变化,因此时间维不是额外装饰。重复轮次让译码器区分持续物理变化与一次读出异常。循环网络保存历史摘要,注意力等结构传播空间信息;最终目标仍是逻辑观测,而非恢复一条唯一物理路径。本文建议分别消融当前读数、软读数和历史状态,评价在相同逻辑错误终点上的增益。若移除历史后性能不变,应检查任务或噪声设置是否真的需要时间相关推断。[1] Learning high-accuracy error decoding for quantum proce
技术补充 B · 零错误试验的测量需求
在独立同分布伯努利试验下,零失败的单侧 95% 上界约为 3/n。若希望仅靠零观测支持错误率低于 10⁻⁶,就需要约三百万次独立试验;更低目标需要更长测量。真实纠错轮次可能共享漂移和相关事件,因此不能简单把每轮当独立试验。本文建议同时报告总轮数、独立实验段、校准周期和相关异常,区间按适当层级估计。没有足够测量时,应保存上界与未知,而不是用模型外推替代实验。作者分析与复核建议 / Author analysis
技术补充 C · 校准变化对软读数的影响
软读数携带比硬阈值更多信息,也可能对仪器增益、偏置和漂移更敏感。本文提出在冻结译码器后独立改变读出校准,并区分真实噪声变化与仅表示变化。如果方法主要依赖软信息的特定数值范围,重标定或新批次可能降低表现。评估应保留原始读出处理规则与校准时间,不能先用测试批次标签优化映射再称为无适配泛化。硬读数基线虽信息较少,仍可帮助识别增益来自哪种额外输入。作者分析与复核建议 / Author analysis
技术补充 D · 流式窗口的状态不能任意拼接
将长时间序列拆成窗口可以降低实时计算,但边界处需要正确传递历史信息或重叠处理。若每窗独立译码,跨窗错误链可能被截断;若缓存历史状态,重启与逻辑操作切换又可能使状态失效。本文建议测试不同窗口长度、重叠和重置方式,评价完整长序列逻辑失败以及端到端延迟。窗口内平均准确率不足以证明组合正确,必须核对边界事件,并把缓冲与最终答案等待时间计入时序预算。作者分析与复核建议 / Author analysis
11. 结论:译码的科学对象是逻辑可靠性
学习译码的优势在于能够从复杂数据中利用手工近似可能遗漏的信息;它的可信性则取决于等价类、噪声、样本和实时条件是否同时明确。本文的简并与奇偶解析例子提供可独立核算的直觉,而来源中的真实实验仍保持各自边界。公开研究应交付噪声生成与拟合规则、准确划分、完整逻辑终点和时序数据,让后续方法在同一问题上比较。这样才能将更低的离线错误率逐步转化为真正可运行的逻辑可靠性。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 在 syndrome 给定时按逻辑等价类累加后验;最可能单路径不一定最优。
LaTeX
\widehat L(s)=\arg\max_L\sum_{E:\,\operatorname{syn}(E)=s,\,[E]=L}P(E\mid s)(2) 独立逐轮逻辑翻转的奇数次概率;不代表所有真实噪声。
LaTeX
P_{\mathrm{odd}}(R)=\frac{1-(1-2\varepsilon)^R}{2}(3) 阈值区间的近似缩放形式,需要固定噪声和独立验证,不可外推任意错误率。
LaTeX
\varepsilon_d\approx A\left(\frac p{p_{\mathrm{th}}}\right)^{(d+1)/2}(4) 确定性流体积压示例;λ<μ 是基本容量条件而非尾延迟保证。
LaTeX
Q(t)\approx\max\{0,Q(0)+(\lambda-\mu)t\},\qquad\lambda<\mu方法与证据流程
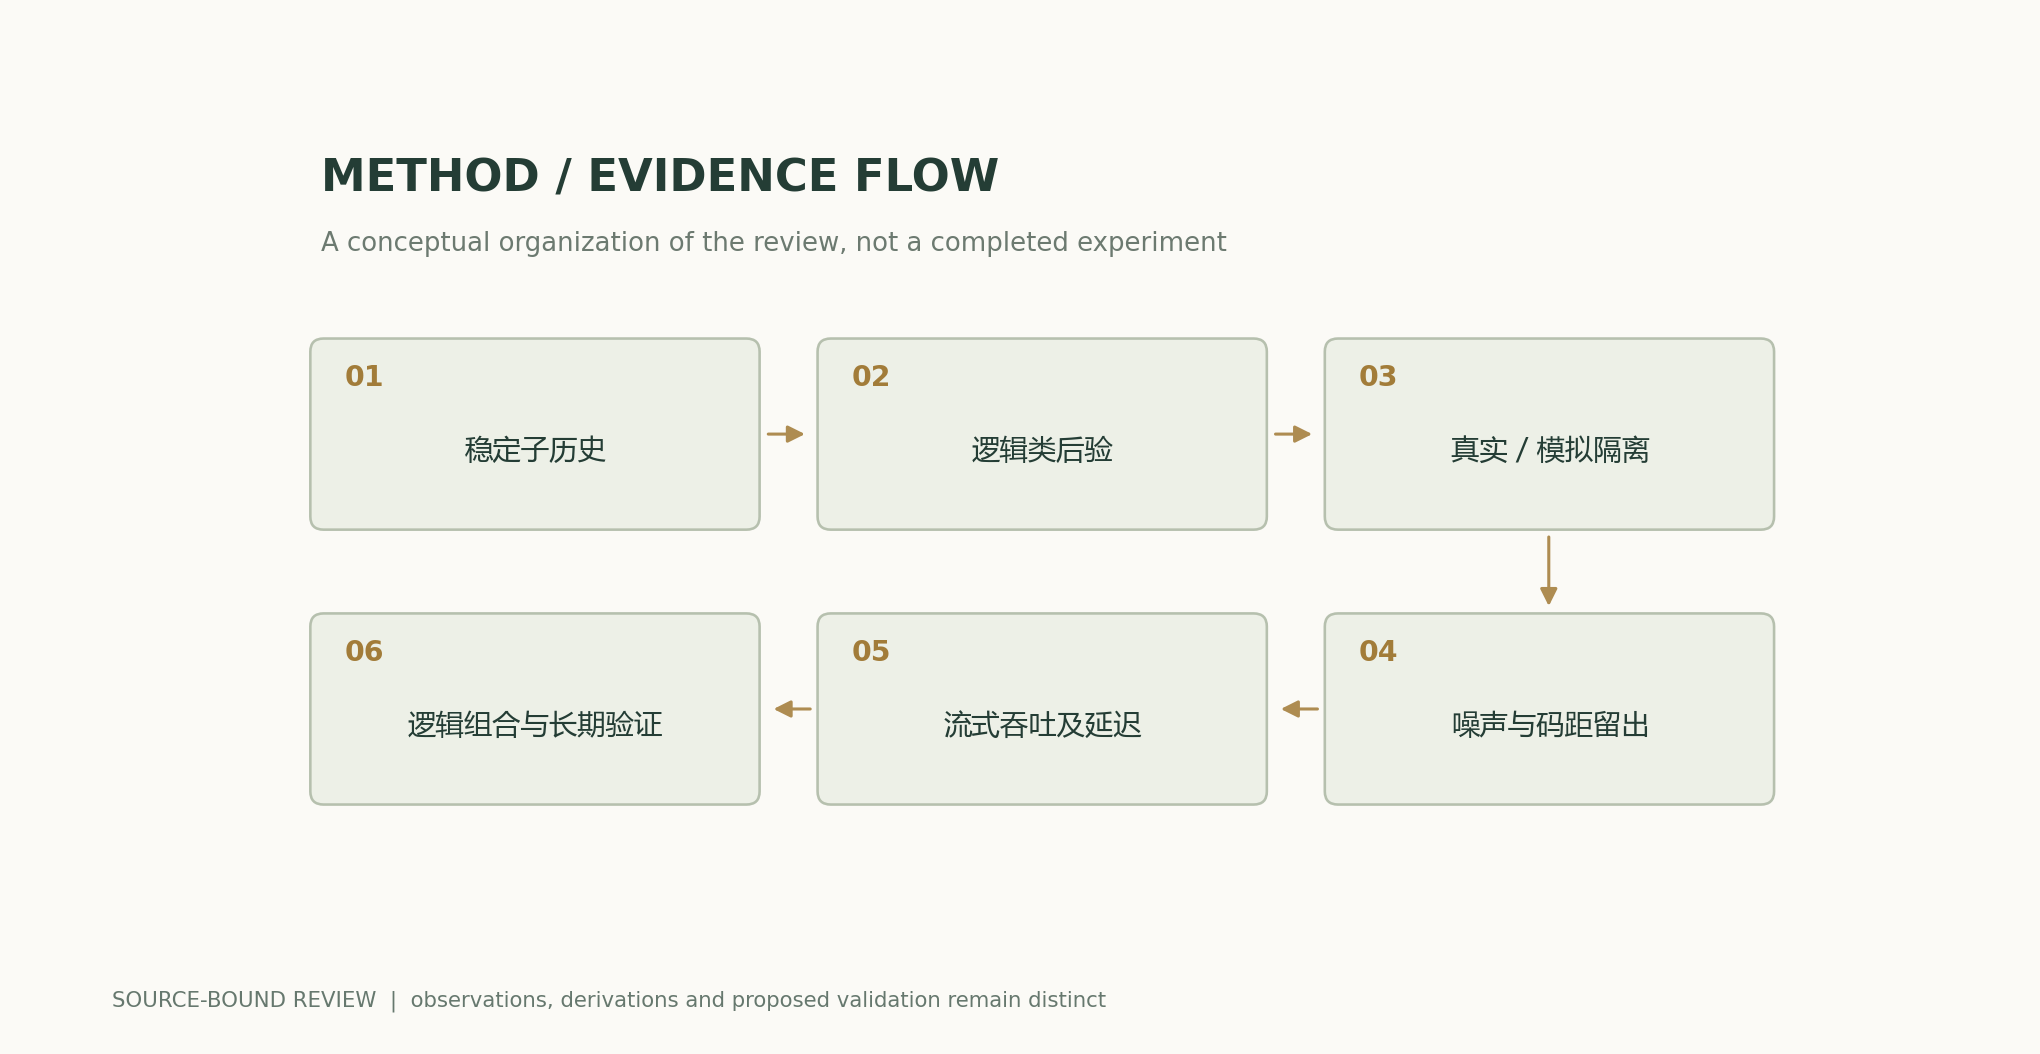
解析图与数值示例
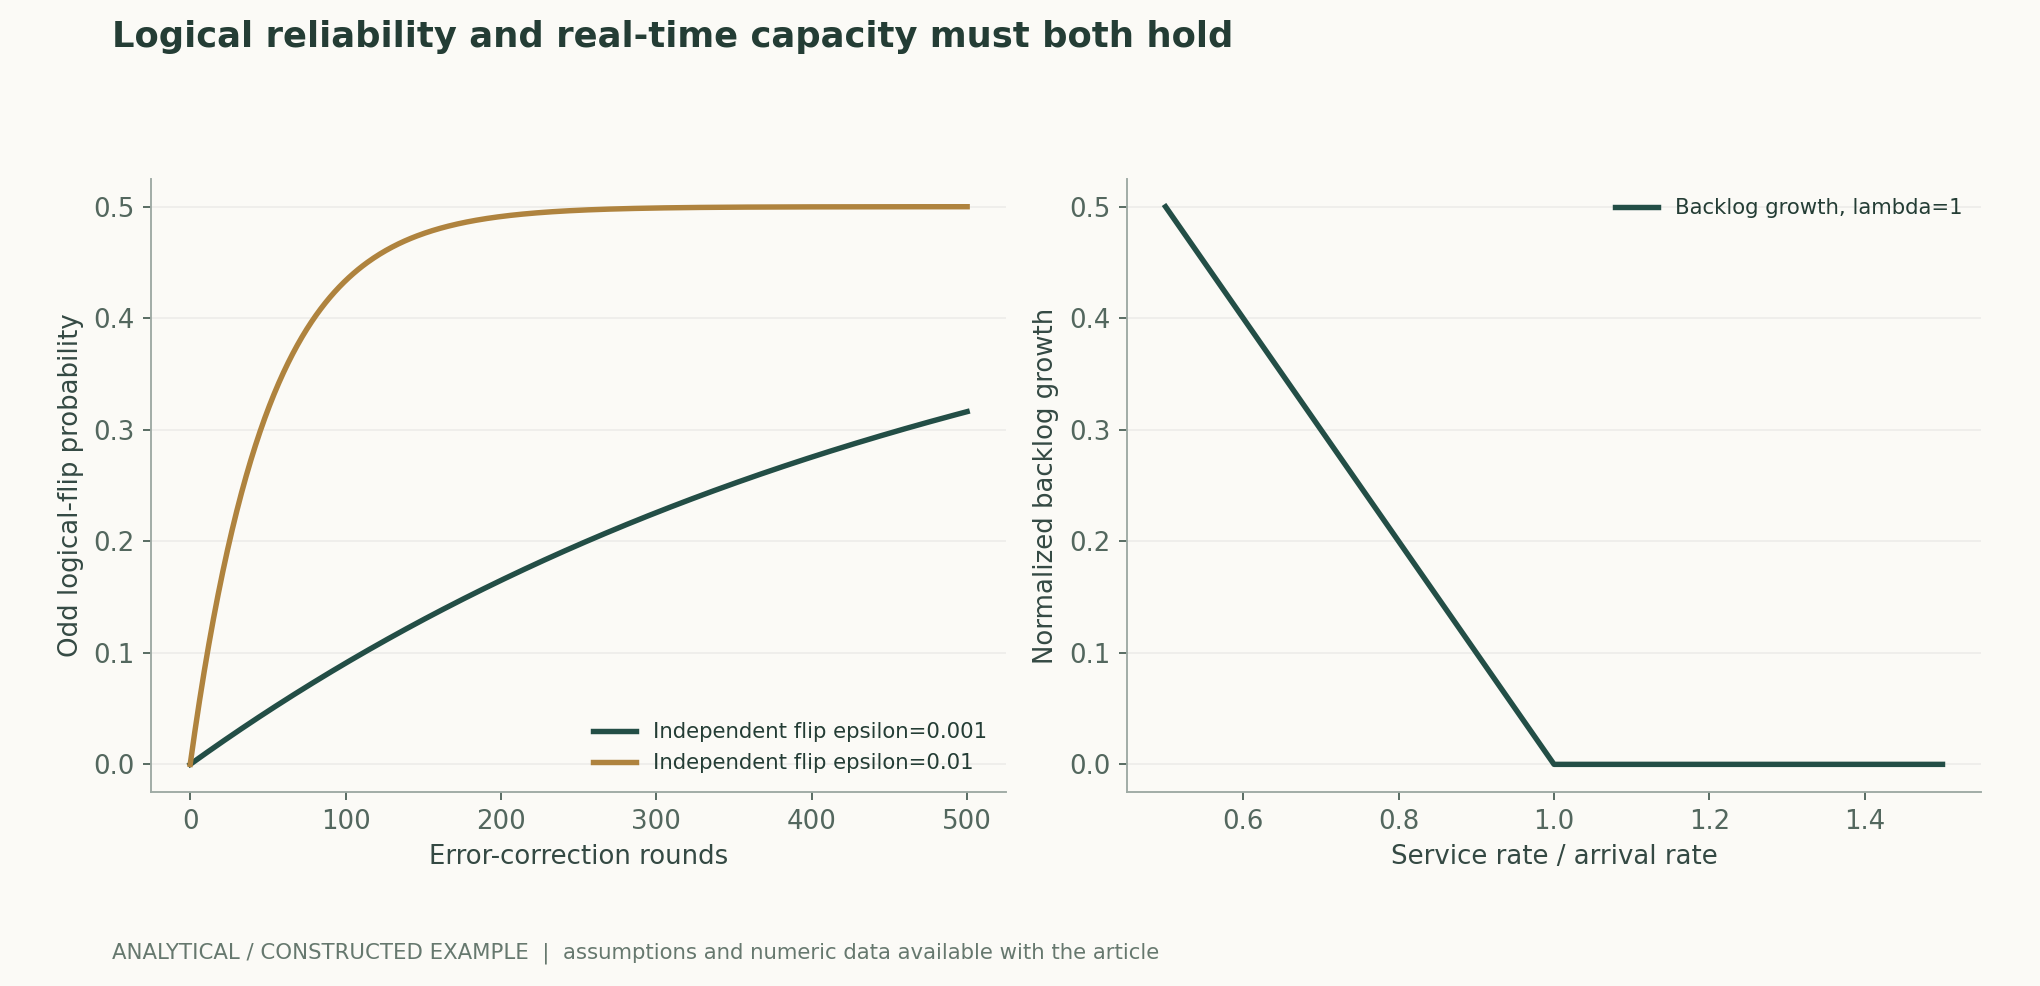
可复算例题
同syndrome下最大单路径0.35属于A,但B类总概率0.65更大。逻辑翻转公式100轮epsilon=0.001约0.090717;服务率不足时积压增长。
方法比较
| 证据 | 需报告的对象 | 不能合并的口径 |
|---|---|---|
| 逻辑译码 | 完整 syndrome 与逻辑失败 | 逐测量分类准确率 |
| 真实芯片 | 器件、码距和时间段 | 模拟更大距离 |
| 相关噪声 | 泄漏、软读数及拟合来源 | 独立噪声同分布性能 |
| 距离扩展 | 匹配噪声的多距离趋势 | 任意低错误率保证 |
| 实时执行 | 持续吞吐、延迟和积压 | 单内核速度 |
| 容错组合 | 逻辑操作与状态传递 | 静态记忆等于通用计算 |
复核与实验方案
- 固定码、逻辑观测、噪声模型与译码器版本。
- 在噪声拟合、训练、早停与测试之间隔离真实样本。
- 分开登记芯片与模拟码距,不合并为一种验证。
- 比较同一逻辑终点,并保留物理错误等价类定义。
- 按时间、校准批次及相关事件报告误差和区间。
- 持续压力测量到达率、服务率、尾延迟与积压。
- 加速或压缩后重新验证逻辑错误,不引用原教师替代。
- 对逻辑门、边界与跨块组合另设留出,保留所有异常事件。
适用范围与局限
- 简并例子、奇偶概率与队列模型均为解析构造。
- 没有模拟量子芯片、训练译码器或新增量子实验。
- 阈值近似依赖特定噪声,存在相关错误地板的可能。
- 原研究的准确性和实时系统不是同一套实现。
- 有限观测与漂移限制极低错误率的推断。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 真实 Sycamore 码距 3/5,模拟比较至码距 11。 | 原文速度部分仍有微秒级吞吐目标缺口。 | Learning high-accuracy error decoding for quantum processorsAbstract; Decoding speed |
| Willow 存储和实时译码展示低于阈值的特定实验。 | 使用自身译码系统;不是 AlphaQubit 实时结果。 | Quantum error correction below the surface code thresholdAbstract; surface-code memory; real-time decoding |
值得检验的研究问题
- 在同一逻辑失败目标下,软读数和历史信息分别贡献多少?
- 噪声漂移后准确率与吞吐边界是否同时保持?
- 压缩后的译码器能否支持逻辑操作组合而不积累隐藏状态偏差?
一手来源与主张对应
- Learning high-accuracy error decoding for quantum processorsBausch et al. · 2024-11-20Experimental distance 3/5; simulated distances through 11; Methods decoding speed distinguishes throughput and latency.
- Quantum error correction below the surface code thresholdGoogle Quantum AI and Collaborators · 2024-12-09Willow surface-code memories, real-time distance-5 decoder and rare correlated errors; updated article noted.
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:AI与科学发现深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c