
الملخص
يمكن لسلاسل الاستدلال، والبحث عن المرشحات، والمتحققات أن تحسّن النتائج النهائية لبعض المهام، لكنها تغيّر مراحل مختلفة. يناقش هذا المقال أيضًا شروط معدل النجاح عند تكرار أخذ العينات، وترابط الأخطاء، وإخفاق المتحقق على التوزيع الناتج بعد الانتقاء، ويقدم تصميمًا للمقارنة في ظل ميزانية استدلال موحدة. نص الاستدلال ليس سوى خرج للنموذج، ولا يمكنه أن يثبت بذاته صحة العمليات الحسابية أو الوقائع. توضّح الأمثلة الحسابية التحليلية لماذا قد تكون لزيادة عدد المحاولات فوائد، كما توضّح أنه لا يمكن إعلان تحسن الموثوقية استنادًا إلى إجابة الأغلبية أو تفسير أطول في غياب الاستقلال وأدلة التحقق.[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
ترجمة الملخص الإنجليزي
يُفصل أداء الاستدلال إلى توليد المرشحات واختيارها والتحقق منها. وتشرح عملية حسابية تقوم على أخذ عينات مستقلة الإمكانات التي تتيحها المحاولات الإضافية، مع التصريح بافتراضاتها. وقد تؤدي الإخفاقات المترابطة، والقبول الخاطئ من جانب المتحقق، وعدم تساوي ميزانيات الاستدلال إلى إبطال المقارنات الساذجة. ويسجل البروتوكول المقترح مسارات النجاح والإخفاق معًا، من دون اعتبار التفسيرات المولّدة دليلًا على صحة استنتاجاتها.
1. النص الوسيط ليس برهانًا على الصحة
أظهرت أبحاث سلسلة التفكير أن الأمثلة التي تتضمن خطوات وسيطة يمكن أن تحسن الأداء في الاستدلال الحسابي، والاستدلال القائم على الحس المشترك، والاستدلال الرمزي، ضمن النماذج والمهام التي خضعت للدراسة. وتشير هذه النتيجة إلى أن تنظيم الموجّه قد يؤثر في حل المهمة، لكنها لا تضمن صلاحية كل خطوة مولّدة. وينبغي للقارئ أن يميز بين صحة الإجابة النهائية، وصلاحية الخطوات، ومدى أمانة التفسير في تمثيل الحساب الفعلي، وألا يستعيض عن الفحص بتماسك السرد.[1] Chain-of-Thought Prompting Elicits Reasoning in Large L
2. يخصص الاتساق الذاتي الحساب لمسارات متعددة
تأخذ طريقة الاتساق الذاتي عينات من مسارات استدلال مختلفة، ثم تجمع الإجابات وتختار منها. وهي تستفيد من بنية مفادها أن «مسارات مختلفة قد تتلاقى عند الإجابة الصحيحة»، بخلاف التوليد عبر مسار جشع واحد فقط. لكن إذا كرر النموذج استخدام المقدمة الخاطئة نفسها، فقد لا تعني زيادة عدد العينات سوى تكرار الخطأ. وينبغي الإبلاغ عن التنوع الفعلي للمرشحات بصورة منفصلة عن عدد مرات أخذ العينات.[2] Self-Consistency Improves Chain of Thought Reasoning in
3. يركز الإشراف على العملية على الأحكام الوسيطة
تقارن دراسة Let's Verify Step by Step بين الإشراف على النتيجة النهائية والإشراف على العملية، وتفيد بوجود مزايا للإشراف على العملية في مهام رياضية محددة وإعدادات معينة لاختيار المرشحات. وتشير قيمة 78% الواردة في ملخصها إلى مجموعة فرعية ممثلة من مجموعة اختبار MATH وإلى إجراء التقييم المعتمد في الورقة، ولا يجوز إعادة صياغتها باعتبارها «دقة حل جميع المسائل الرياضية». ولا يستخدم هذا المقال ذلك الرقم لرسم ترتيب عام للقدرات.[3] Let's Verify Step by Step
4. اشتقاق واضح للتصويت
إذا كانت المرشحات مستقلة، وكان احتمال صحتها ثابتًا ويساوي p، وأمكن جمع جميع المرشحات الصحيحة ضمن إجابة واحدة، فإن احتمال نجاح تصويت الأغلبية عبر عدد فردي n من المحاولات يساوي مجموع احتمالات التوزيع ذي الحدين منإلى n. وهذا يختلف عن «وجود مرشح صحيح واحد على الأقل»؛ فحتى عندما يكون احتمال الحالة الأخيرة مرتفعًا، تظل هناك حاجة إلى آلية اختيار موثوقة. يعرض الشكل 2 في هذه النسخة احتمال النجاح مرة واحدة على الأقل والقيمة التنبؤية الإيجابية للمتحقق، ولا يعرض قياسات تجريبية لتصويت الأغلبية. والاستقلال، والتوزيع المتماثل، وتجميع الإجابات كلها افتراضات تحتاج إلى اختبار.作者分析与复核建议 / Author analysis
5. لماذا لا يكفي افتراض الاستقلال غالبًا
قد تتشارك مخرجات النموذج نفسه فجوات معرفية، وتحيزات في الموجّه، وسوء فهم للمسألة؛ ولذلك تظل الأخطاء مترابطة حتى إن أسفر أخذ العينات عن نصوص مختلفة. فوجود «تسع إجابات» من الناحية الشكلية لا يعني وجود تسعة أدلة مستقلة. وقد يتيح الاسترجاع الخارجي، أو تنفيذ البرامج، أو فحص القيود القابل للإثبات إدخال معلومات تختلف عن إعادة الصياغة اللغوية؛ لكن قياس فعاليتها الفعلية يظل لازمًا لكل مهمة.[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
6. لا بد من بيان الميزانية عند المقارنة
إذا استخدمت طريقة ما عددًا أكبر من الرموز، أو مرشحات أكثر، أو متحققًا أقوى، فإن تغير الجودة يحدث بالتزامن مع تغير الموارد الحسابية المبذولة. ويوصي هذا المقال بالإبلاغ معًا عن إجمالي الرموز لكل مسألة، وعدد الاستدعاءات، ومعدل تجاوز المهلة، ودقة الإجابة النهائية، وزمن الاستجابة الكامل، مع الاحتفاظ بالنتائج المصنفة بحسب الصعوبة. فالإبلاغ عن متوسط زمن المسائل الأسهل وحدها يخفي الذيل الطويل، وعرض أفضل إجابة فقط يخفي تكلفة الاختيار.作者分析与复核建议 / Author analysis
7. إرساء حدود تحقق قابلة للفحص
في الحساب، تُنفَّذ العمليات وتُراجَع الوحدات؛ وفي الشيفرة، تُستخدم اختبارات معزولة ويُفحَص السلوك المتوقع؛ وفي الحقائق المستمدة من الأدبيات، تُراجَع المصادر والإصدارات. وينبغي أيضًا تقييم الأحكام الخاطئة التي يصدرها المتحقق نفسه. وإذا كان المتحقق، في جوهره، لا يزال يعتمد على تقييم ذاتي من نموذج من النوع نفسه، فيجب الإفصاح عن هذا الاعتماد، وألا يُعرض الأمر كما لو أن تجارب خارجية قد أكدته. وما يُدرج هنا هو مبادئ تصميم؛ ولا يدّعي هذا الموقع أنه أجرى تجارب جديدة على النماذج استنادًا إليها.作者分析与复核建议 / Author analysis
قدرات المتحقق مشروطة أيضًا بالميزانية
يضيف فحص العملية نوعًا آخر من الموارد الحسابية المبذولة. وإذا كان المتحقق يستطيع الوصول إلى الإجابات المرجعية، أو أدوات خاصة، أو سياق أوسع، فينبغي تمييز ذلك عن المعلومات المتاحة للنموذج المولّد للمرشحات. وإذا اختيرت أفضل إجابة من بين مئة مرشح، فينبغي عرض الدقة النهائية إلى جانب تكلفة توليد مئة مرشح. ويمكن أن تكون المقارنة المباشرة بين هذه النتيجة والتوليد مرة واحدة مقارنةً على مستوى النظام، لكن لا يجوز إغفال الفروق في الموارد ثم الادعاء بأن قدرة النموذج الأساسي على الاستدلال تحسنت بالمقدار نفسه.作者分析与复核建议 / Author analysis
8. الفكرة الحدسية وراء pass@k والكمية المستهدفة بالتقدير
إذا كان احتمال النجاح في كل محاولة يساوي p وكانت المحاولات مستقلة بعضها عن بعض، فإن احتمال النجاح مرة واحدة على الأقل يساوي 1−(1−p)^k. وهذا مناسب لشرح الفوائد المحتملة لزيادة الميزانية، لكنه لا يعني أن مجموعة المرشحات الفعلية تحقق الاستقلال. وعند أخذ عينات من دون إرجاع من مجموعة عينات ثابتة واحدة، تستخدم صيغة التقدير الشائعة أعداد التوافيق، ولا تتطابق الكمية المستهدفة بتقديرها تمامًا مع تلك الخاصة بنموذج برنولي المستقل. ويجب أن توضّح الورقة عدد مرات أخذ العينات، ودرجة الحرارة، ومجموعة العينات، واستراتيجية الاختيار، وأن تميّز بين «توليد إجابة صحيحة في إحدى المرات» و«قدرة النظام على اختيار الإجابة الصحيحة»؛ فالأخيرة تتطلب أيضًا خطوة اختيار أو تحقق.[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
9. قد ينشأ اتفاق الأغلبية عن آلية خطأ مشتركة
عندما تستخدم المرشحات معارف التدريب نفسها والموجّه نفسه ومواد الاسترجاع نفسها، فقد تتشارك مقدمة خاطئة واحدة. وحتى إن اختلفت صياغتها، فقد لا تقدم أدلة مستقلة. ويمكن دراسة ترابط الأخطاء بتغيير الصياغة السطحية للمسألة، ومصادر الأدلة، وأدوات الحل، وأساليب التحقق، لكن هذه التغييرات قد تغيّر أيضًا معدل النجاح في المحاولة الواحدة، ولذلك يلزم تسجيلها بصورة منفصلة. وفي المهام الرياضية أو البرمجية، يكون الفحص القادر على إعادة الحساب أو التنفيذ بصورة مستقلة أقرب إلى الدليل الخارجي من مجرد الاتفاق اللغوي المتبادل. وفي المهام المفتوحة المتعلقة بالحقائق، تكتسب إصدارات مواد التحقق ومصادرها أهمية مماثلة.[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
10. يجب اختبار المتحقق على التوزيع الناتج بعد الانتقاء
لنفترض أن نسبة المرشحات الصحيحة التي ينتجها المولّد هي p، وأن معدل قبول المتحقق للمرشحات الصحيحة هو t، ومعدل قبوله للمرشحات الخاطئة هو f؛ عندئذ تكون نسبة الإجابات الصحيحة في المجموعة المقبولة هي pt/[pt+(1−p)f]. وحتى إن بدا f صغيرًا، فقد تشكل الأخطاء نسبة كبيرة من المجموعة المقبولة عندما تكون المرشحات الصحيحة نادرة جدًا. وينبغي الإبلاغ عن معدل الصحة الأساسي وعتبة القبول، وإجراء التقييم على المرشحات التي ينتجها البحث الفعلي، لا الاكتفاء بالاختبار على عينات واضحة الصحة أو الخطأ منتقاة يدويًا.[3] Let's Verify Step by Step
11. يجب فصل إسناد الأثر إلى ميزانية الاستدلال عن إسناده إلى تحسين النظام
غالبًا ما تؤدي زيادة عقد البحث، أو رموز الخرج، أو استدعاءات الأدوات إلى زيادة الميزانية الحسابية؛ أما الأساليب النظامية مثل فك الترميز التكهني فقد تقلل زمن الانتظار مع الإبقاء على توزيع أخذ العينات المستهدف نفسه. وقد يتيح كلاهما للمستخدم الوصول إلى الإجابة الصحيحة بسرعة أكبر، لكن التفسير العلمي يختلف. وينبغي للدراسة المنصفة أن تبلغ معًا عن إجمالي الحساب، والزمن الفعلي المنقضي، وعدد المرشحات، ومعدل النجاح، وأن تقارن حدود الأداء في ظل ميزانية ثابتة. ولا ينبغي إسناد كامل الزيادة في معدل النجاح الناتجة عن محاولات أكثر إلى أن النموذج الأساسي أصبح «أقدر على الاستدلال».[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[4] Fast Inference from Transformers via Speculative Decodi
الصيغ الأساسية والاشتقاقات
(1) لا تصح إلا بافتراض استقلال كل محاولة وثبات معدل النجاح. وتأخذ p في الشكل قيمة ثابتة مصرحًا بها، وليست معدل نجاح مقاسًا تجريبيًا لنموذج لغوي معين.
LaTeX
P(\text{至少一次成功})=1-(1-p)^k(2) إذا كان من بين n عينة مولّدة مسبقًا عدد c من العينات الصحيحة، فإنها تقدّر، في ظل الشروط المنطبقة، احتمال الحصول على عينة صحيحة واحدة على الأقل عند اختيار k عينات عشوائيًا؛ وعندما n−c<k يكون البسط 0. ولا تتضمن هذه الكمية القدرة على انتقاء الإجابة الصحيحة.
LaTeX
\widehat{\mathrm{pass@}k}=1-\frac{\binom{n-c}{k}}{\binom{n}{k}}(3) تمثل t معدل القبول الصحيح، وتمثل f معدل القبول الخاطئ. وتُظهر الصيغة أهمية النسبة الأساسية؛ فلا يكفي الإبلاغ عن قيمة إجمالية واحدة لدقة المتحقق.
LaTeX
P(\mathrm{correct}\mid\mathrm{accepted})=\frac{pt}{pt+(1-p)f}مسار المنهج والأدلة
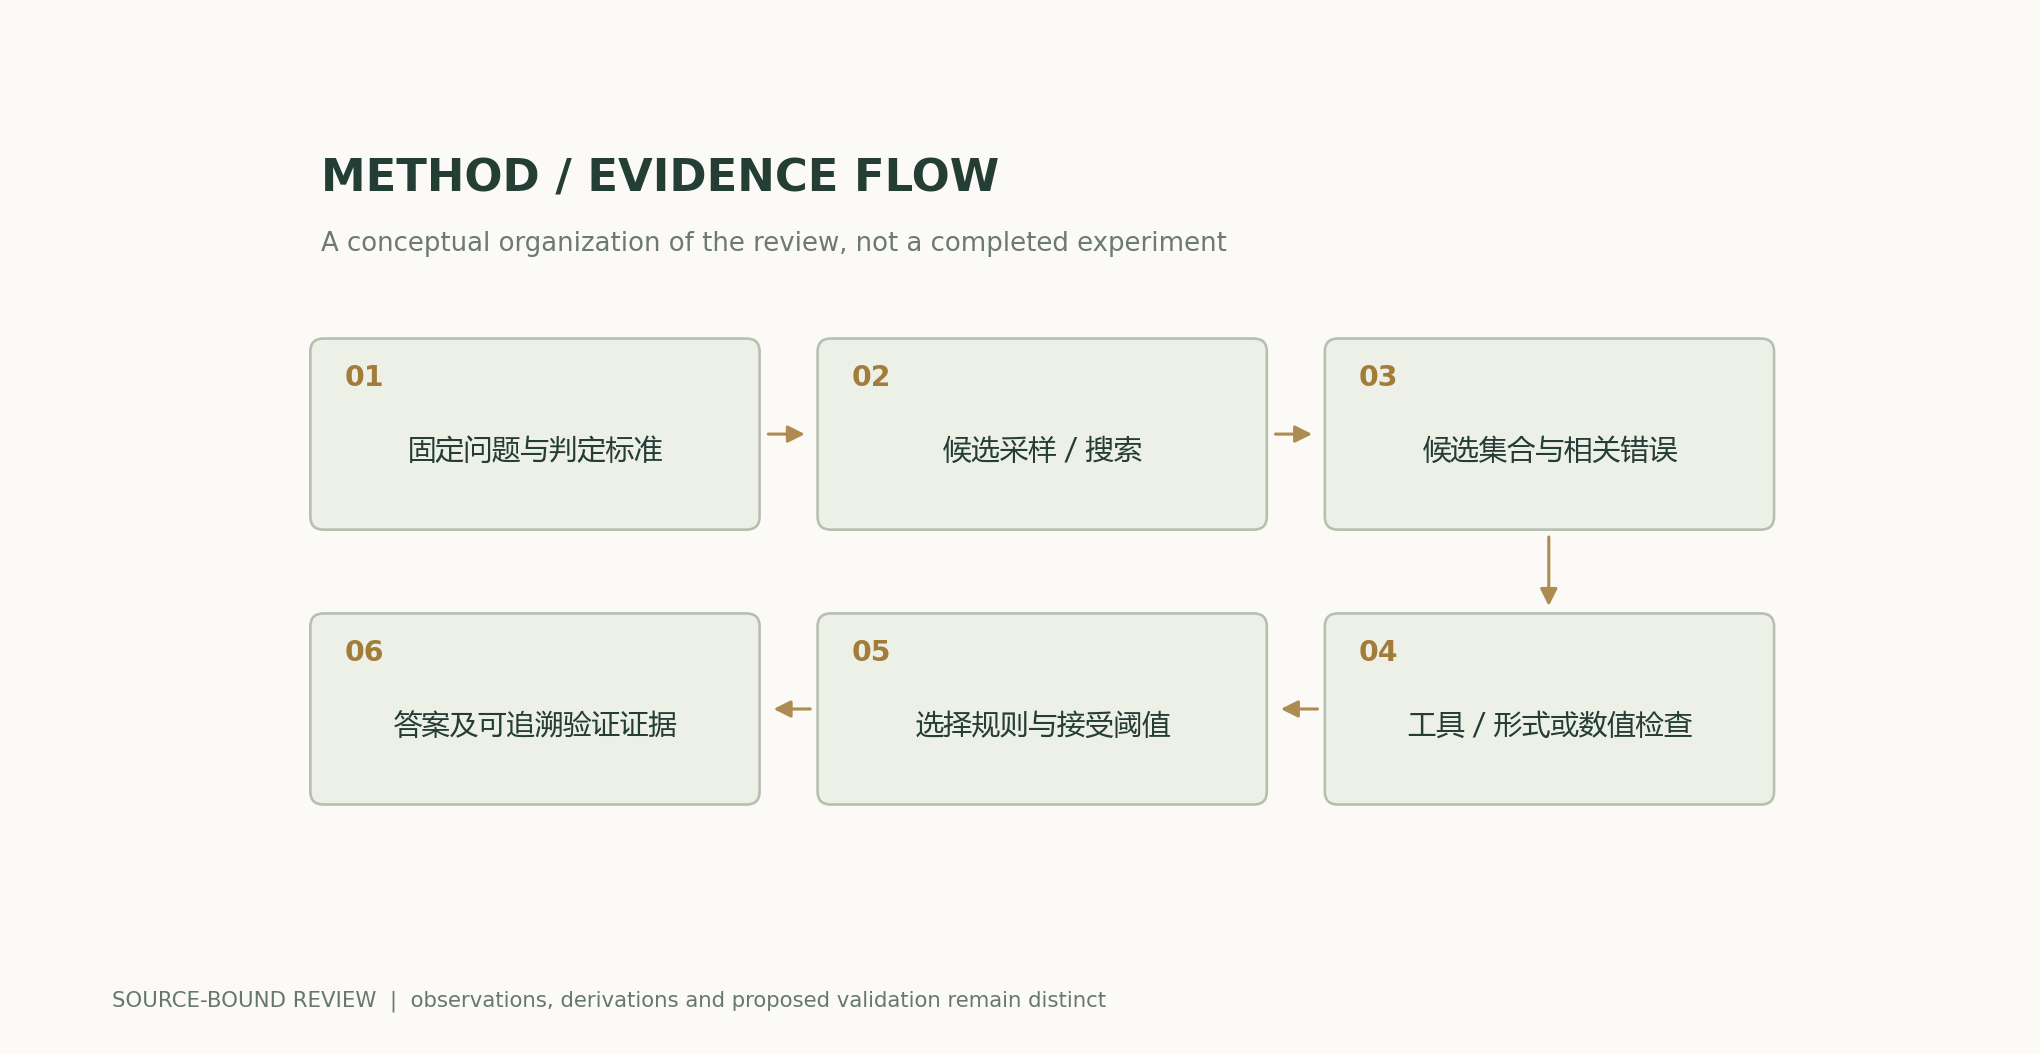
الرسوم التحليلية والأمثلة العددية
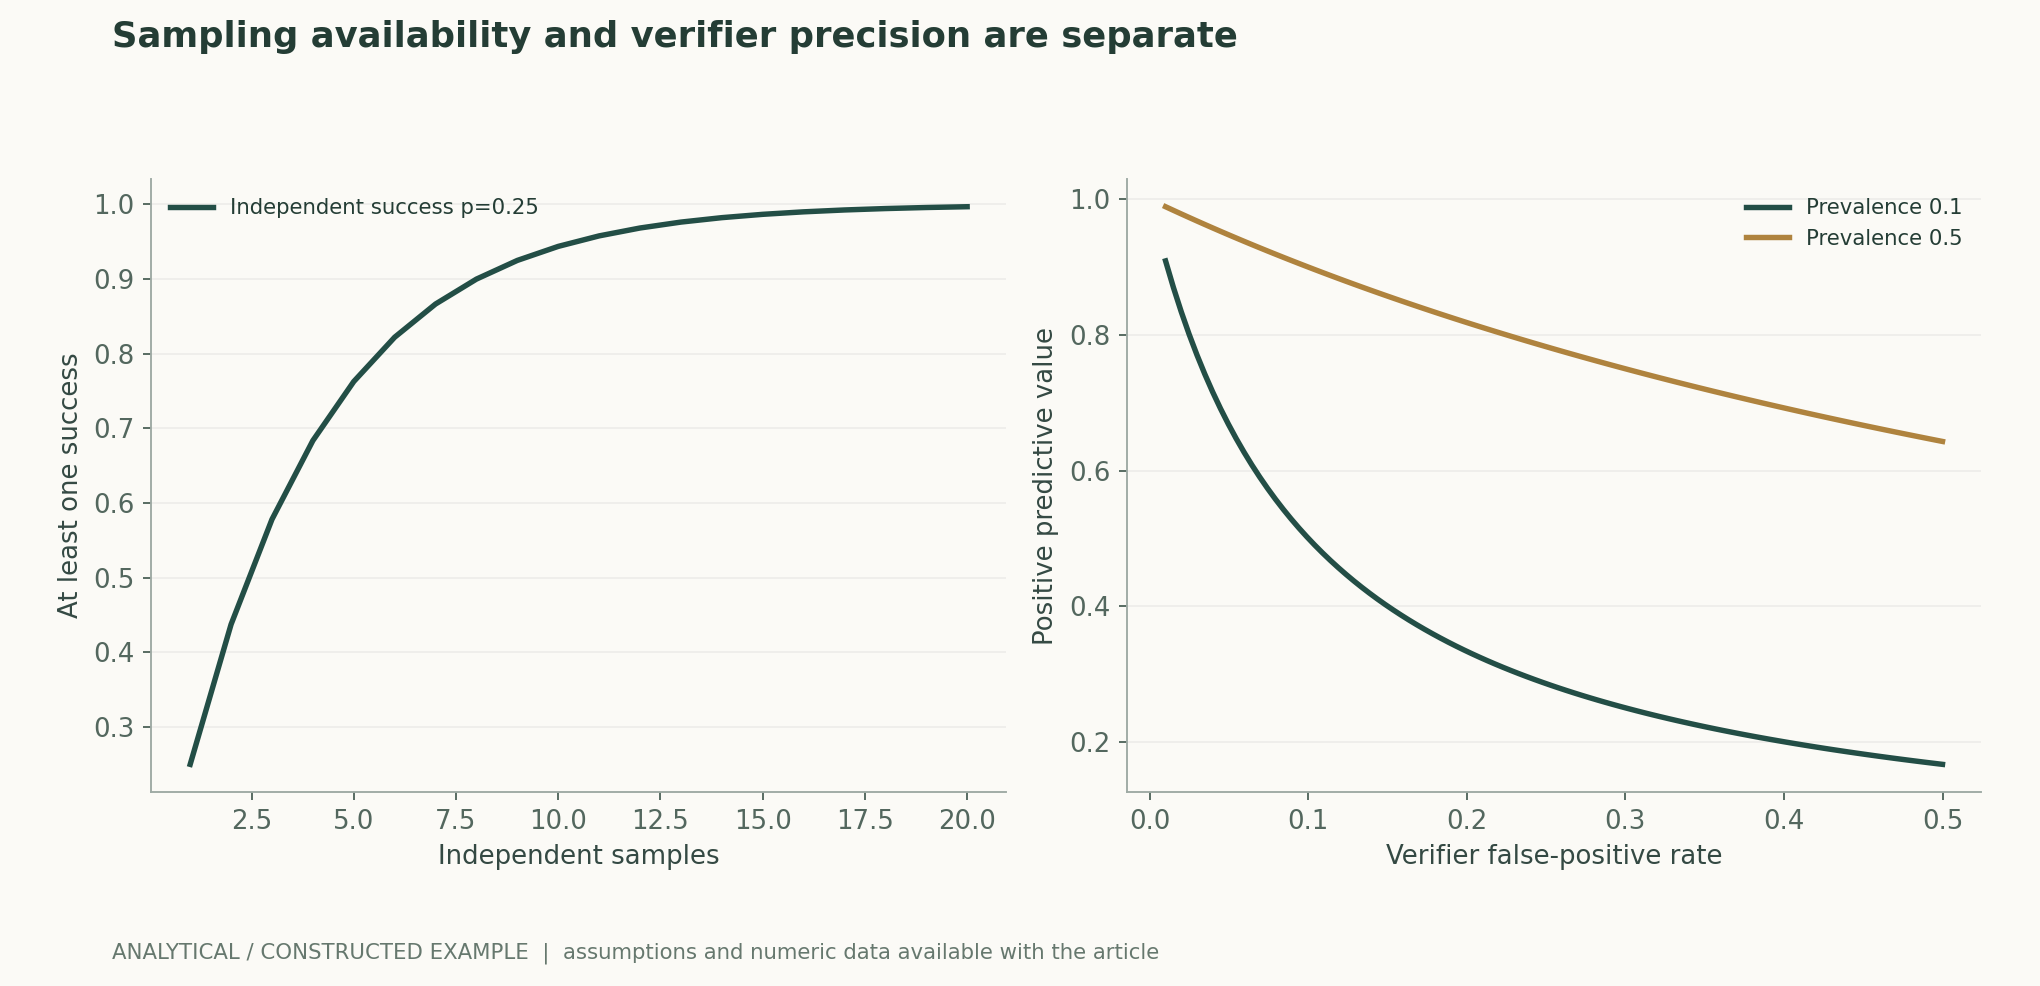
مثال قابل لإعادة الحساب
عندما يكون احتمال النجاح المستقل 0.25، يبلغ احتمال النجاح مرة واحدة على الأقل خلال 8 محاولات نحو 0.900؛ لكن إذا كانت حساسية المتحقق 0.9، ومعدل الإيجابيات الكاذبة 0.1، ومعدل صحة المرشحات 0.1، فإن قيمته التنبؤية الإيجابية تساوي 0.5 فقط. فوجود مرشح صحيح لا يعني اختياره في النهاية.
مقارنة الطرائق
| الطريقة أو الحكم | المتغيرات المضبوطة والقياسات | شروط الإخفاق وتفسيرها |
|---|---|---|
| التوليد مرة واحدة | تثبيت الموجّه وفك الترميز، والإبلاغ عن النتائج لكل مهمة | التفسير الأطول لا يعني استنتاجًا أكثر موثوقية |
| أخذ العينات المتكرر | توحيد الميزانية الإجمالية، والتمييز بين نجاح التوليد ونجاح الاختيار | تضعف الأخطاء المترابطة الاستدلال الحدسي القائم على أخذ عينات مستقلة |
| الانتقاء بواسطة المتحقق | مرشحات البحث الفعلي، والعتبات، ومعدل القبول الخاطئ | قد تكون النتائج على العينات المصطنعة مفرطة في التفاؤل |
| تسريع النظام | تثبيت التوزيع المستهدف وميزانية المرشحات، وقياس الزمن الفعلي المنقضي بصورة منفصلة | تقليل زمن الانتظار لا يزيد تلقائيًا القدرة على الاستدلال في المحاولة الواحدة |
خطة المراجعة والتجارب
- اختيار مجموعة مهام يمكن الحكم عليها بوضوح، والاحتفاظ بمعايير الإجابة وإصدارات البيانات وفحوص تلوث البيانات؛ ووضع قواعد مستقلة للمصادر والوسم في الأسئلة المفتوحة.
- تثبيت الميزانية الإجمالية للمرشحات، ومقارنة التوليد مرة واحدة، وأخذ العينات، والتصويت، والأدوات الخارجية، والاختيار بواسطة المتحقق كلًّا على حدة، مع الاحتفاظ بجميع حالات الإخفاق.
- الإبلاغ عن pass@k، ودقة الإجابات التي يختارها النظام، ونسبة الحالات التي يتعذر الحكم عليها؛ وعدم الاكتفاء بعرض أفضل خرج.
- قياس ترابط الأخطاء بين المرشحات، وفحص ما إذا كانت الصياغات المختلفة لا تزال تعتمد على المقدمات الخاطئة نفسها أو المصادر نفسها.
- إجراء مسح لعتبات المتحقق، وتسجيل معدلات القبول الصحيح، والقبول الخاطئ، والرفض، والتحقق منها على توزيع البحث الفعلي.
- احتساب الرموز، واستدعاءات الأدوات، والحساب الفعلي، والزمن الفعلي المنقضي في الميزانية بصورة منفصلة؛ وإعادة التقييم على مجموعة محجوزة مستقلة بعد تغيير التدريب أو الموجّه.
نطاق التطبيق والقيود
- أخذ العينات المستقلة مجرد افتراض تحليلي.
- غالبًا ما تفتقر الأسئلة المفتوحة إلى متحقق شامل وقادر على الحسم.
- التفسيرات المولّدة لا يمكن أن تحل محل التحقق الخارجي.
- لا تُقدَّم هنا معايير مرجعية جديدة للاستدلال أو تصنيفات للنماذج.
المصادر الأولية وما يقابلها من ادعاءات
- Chain-of-Thought Prompting Elicits Reasoning in Large Language ModelsWei et al. · 2022-01-28v6; method and limitations
- Self-Consistency Improves Chain of Thought Reasoning in Language ModelsWang et al. · 2022-03-21v4 abstract
- Let's Verify Step by StepLightman et al. · 2023-05-31v1 abstract; process vs outcome supervision
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
الاستشهاد وتصدير المقال
BibTeXRISCSL JSONTXTالمقال JSON
المؤلف والإصدار والمصادر
مراجعة بحثية بمساعدة الذكاء الاصطناعي؛ كتبها Codex، وهو نظام ذكاء اصطناعي، وأجرى الاشتقاقات التحليلية استنادًا إلى الأدبيات الأولية المدرجة. لا يتوفر لدى هذا الموقع سجل لتحكيم مستقل لهذا المقال أو لتجارب أصلية على النماذج.
تعديل أداء القارئ: تُعاد أيضًا الاستفادة من الصفحة التي سبق قراءتها عندما يعيد طلب HEAD حديث 200 وتبقى ETag مطابقة. ويحتفظ النص والصيغ والمصادر وبيانات الرسوم العلمية بمحتوى الإصدار السابق.
يُفصل الغلاف المفاهيمي عن الرسوم العلمية؛ وتُحسب الرسوم العلمية باستخدام صيغ متاحة علنًا وافتراضات مصرح بها، وتُنسب جميع نتائج الأوراق الأصلية إلى مصادرها.
سجل المؤلف والإصدارات والتصحيحات · /guides/reasoning-verification/v5/
مصادر الغلاف والرسوم العلمية · البيانات والمصادر والافتراضات · سجل النشر والإصدارات
مراجعة المصدر: 6251a250b27bb8b449f59b392f81abd355383770