
Resumen
Las cadenas de razonamiento, la búsqueda de candidatos y los verificadores pueden mejorar los resultados finales en algunas tareas, pero modifican etapas distintas. Este artículo examina además las condiciones de la tasa de éxito del muestreo repetido, la correlación de los errores y los fallos del verificador sobre la distribución posterior a la selección, y presenta un diseño comparativo con un presupuesto de inferencia común. El texto de razonamiento es solo una salida del modelo y no puede demostrar por sí mismo la validez de cálculos o hechos. Los ejemplos analíticos explican por qué aumentar el número de intentos puede ser beneficioso, pero también por qué, sin independencia ni evidencia de verificación, no se puede afirmar que la fiabilidad haya mejorado basándose en respuestas mayoritarias o explicaciones más largas.[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
Traducción del resumen en inglés
El rendimiento del razonamiento se descompone en generación, selección y verificación de candidatos. Un cálculo basado en muestreo independiente explica el potencial de los intentos adicionales y explicita sus supuestos. Los fallos correlacionados, la aceptación falsa por parte del verificador y los presupuestos de inferencia desiguales pueden invalidar las comparaciones ingenuas. El protocolo propuesto registra las trazas tanto de éxito como de fallo, sin tratar las explicaciones generadas como evidencia de que sus conclusiones sean correctas.
1. El texto intermedio no es una prueba de corrección
La investigación sobre cadenas de pensamiento muestra que, en los modelos y las tareas estudiados, los ejemplos con pasos intermedios pueden mejorar el rendimiento en razonamiento aritmético, de sentido común y simbólico. Este resultado indica que la organización de las instrucciones puede influir en la resolución de tareas, pero no garantiza que cada paso generado sea válido. El lector debe distinguir entre la corrección de la respuesta final, la validez de los pasos y la fidelidad de la explicación al cómputo real, sin sustituir la comprobación por la coherencia narrativa.[1] Chain-of-Thought Prompting Elicits Reasoning in Large L
2. La autoconsistencia dedica cómputo a múltiples trayectorias
El método de autoconsistencia muestrea distintas trayectorias de razonamiento y después agrega las respuestas para realizar una selección. Aprovecha la estructura según la cual «distintas trayectorias pueden converger en la respuesta correcta», a diferencia de la generación que sigue una única trayectoria voraz. Sin embargo, si el modelo reutiliza reiteradamente la misma premisa errónea, aumentar el número de muestras puede limitarse a repetir el error. La diversidad efectiva de los candidatos debe comunicarse por separado del número de muestras extraídas.[2] Self-Consistency Improves Chain of Thought Reasoning in
3. La supervisión del proceso se centra en los juicios intermedios
Let's Verify Step by Step compara la supervisión del resultado final con la supervisión del proceso e informa de ventajas de esta última en tareas matemáticas específicas y configuraciones concretas de selección de candidatos. El 78% de su resumen corresponde a un subconjunto representativo del conjunto de prueba MATH y al procedimiento de evaluación del artículo; no puede reformularse como «exactitud al resolver todos los problemas matemáticos». Este artículo no utiliza esa cifra para elaborar una clasificación general de capacidades.[3] Let's Verify Step by Step
4. Una derivación transparente de la votación
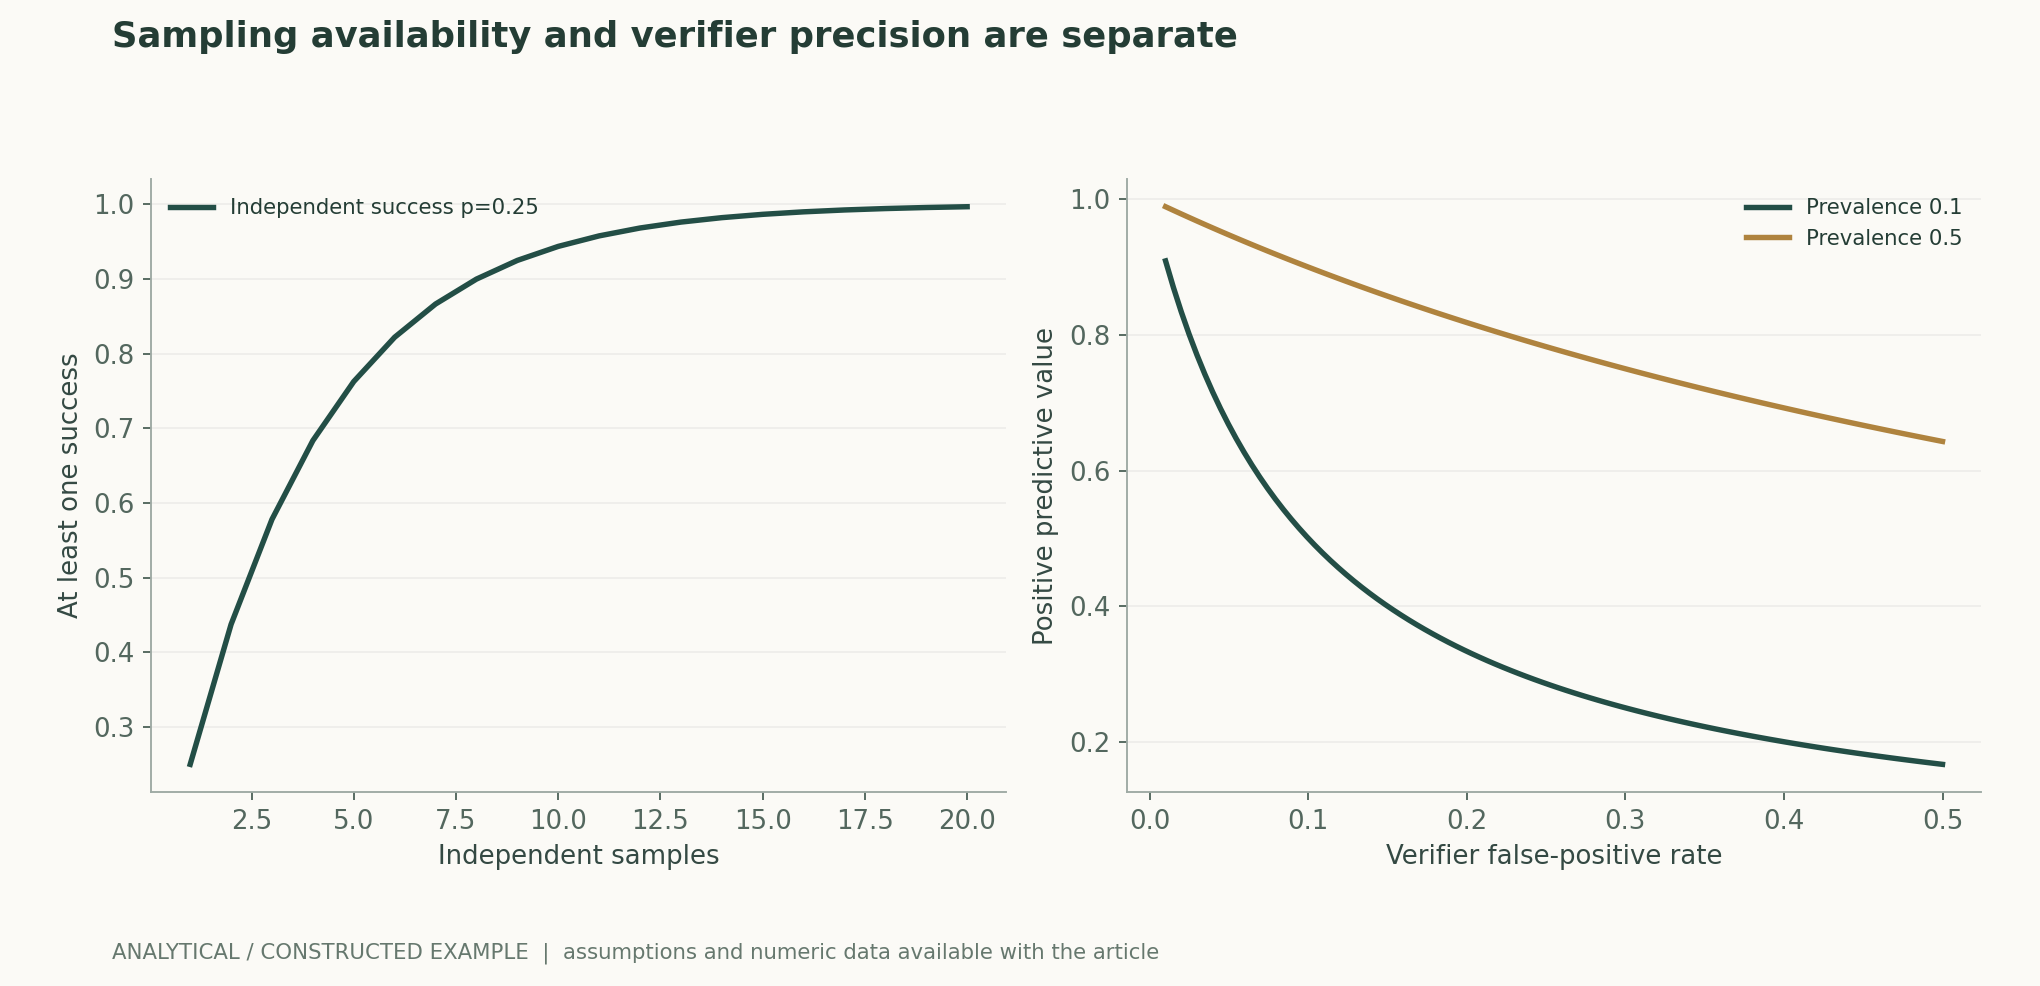
Si los candidatos son independientes, su probabilidad de ser correctos es una constante p y todos los candidatos correctos pueden agruparse como una misma respuesta, la probabilidad de éxito de la votación mayoritaria en un número impar n de intentos es la suma de las probabilidades binomiales desdehasta n. Esto difiere de que «al menos un candidato sea correcto»; aunque esta última probabilidad sea elevada, sigue siendo necesario un selector fiable. La figura 2 de esta versión muestra la probabilidad de al menos un éxito y el valor predictivo positivo del verificador, no resultados empíricos de votación mayoritaria. La independencia, la distribución idéntica y la agrupación de respuestas son supuestos que deben comprobarse.作者分析与复核建议 / Author analysis
5. Por qué el supuesto de independencia suele ser insuficiente
Las salidas de un mismo modelo pueden compartir lagunas de conocimiento, sesgos de las instrucciones e interpretaciones erróneas de los problemas; por ello, los errores pueden seguir correlacionados aunque el muestreo produzca textos diferentes. Tener formalmente «nueve respuestas» no equivale a disponer de nueve evidencias independientes. La recuperación externa de información, la ejecución de programas o la comprobación demostrable de restricciones pueden incorporar información distinta de una reformulación lingüística; su eficacia real sigue requiriendo mediciones específicas para cada tarea.[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
6. Las comparaciones deben especificar el presupuesto
Si un método utiliza más tokens, más candidatos o un verificador más potente, el cambio de calidad se produce junto con un cambio en la inversión computacional. Este artículo recomienda informar conjuntamente del total de tokens por problema, el número de llamadas, la tasa de agotamiento del tiempo límite, la exactitud final y la latencia completa, conservando también los resultados agrupados por dificultad. Informar únicamente del tiempo medio de los problemas más fáciles oculta la cola larga; mostrar solo la mejor respuesta oculta el coste de selección.作者分析与复核建议 / Author analysis
7. Establecer límites de verificación que puedan examinarse
Para la aritmética, se deben ejecutar los cálculos y comprobar las unidades; para el código, utilizar pruebas aisladas y el comportamiento esperado; para los hechos de la literatura, comprobar las fuentes y las versiones. Los verificadores también deben someterse a una evaluación de sus propios juicios erróneos. Si el verificador sigue siendo, en esencia, un evaluador subjetivo basado en el mismo tipo de modelo, debe declararse esa dependencia, sin presentarla como una confirmación obtenida mediante experimentos externos. Lo que se expone aquí son principios de diseño; este sitio no afirma haber realizado nuevos experimentos con modelos basándose en ellos.作者分析与复核建议 / Author analysis
Las capacidades del verificador también están condicionadas por el presupuesto
La comprobación del proceso añade otra clase de inversión computacional. Si el verificador puede acceder a respuestas de referencia, herramientas especiales o más contexto, estos recursos deben distinguirse de la información disponible para el modelo que genera los candidatos. Si se elige la mejor respuesta entre cien candidatos, la exactitud final debe mostrarse junto con el coste de generar esos cien candidatos. Comparar directamente este resultado con una sola generación puede servir como comparación a nivel de sistema, pero no se pueden omitir las diferencias de recursos para afirmar que la capacidad de razonamiento del modelo base ha aumentado en la misma medida.作者分析与复核建议 / Author analysis
8. La intuición de pass@k y su estimando
Si cada intento tiene una probabilidad de éxito p y los intentos son mutuamente independientes, la probabilidad de al menos un éxito es 1−(1−p)^k. Esto permite explicar los posibles beneficios de aumentar el presupuesto, pero no implica que el conjunto real de candidatos satisfaga la independencia. Al muestrear sin reemplazo de un mismo conjunto fijo de muestras, un estimador habitual utiliza coeficientes binomiales, y su estimando no coincide exactamente con el del modelo de Bernoulli independiente. Los artículos deben especificar el número de muestras, la temperatura, el conjunto de muestras y la estrategia de selección, distinguiendo entre «se generó una respuesta correcta» y «el sistema puede seleccionar la respuesta correcta»; lo segundo requiere además una etapa de selección o verificación.[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
9. El acuerdo mayoritario puede proceder de un mecanismo de error compartido
Cuando los candidatos utilizan los mismos conocimientos del entrenamiento, las mismas instrucciones y el mismo material recuperado, pueden compartir una premisa errónea. Aunque difieran en su formulación, no necesariamente aportan evidencia independiente. La correlación de los errores puede estudiarse variando la forma superficial de la pregunta, las fuentes de evidencia, las herramientas de resolución y los métodos de verificación, pero estos cambios también pueden modificar la tasa de éxito de un intento individual y deben registrarse por separado. Para tareas matemáticas o de código, las comprobaciones capaces de recalcular o ejecutar de manera independiente se aproximan más a la evidencia externa que el mero acuerdo lingüístico mutuo. En las tareas factuales abiertas, las versiones y las fuentes del material de verificación son igualmente importantes.[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
10. El verificador debe evaluarse sobre la distribución posterior a la selección
Supóngase que la proporción de candidatos correctos producidos por el generador es p, que la tasa de aceptación de candidatos correctos por el verificador es t y que su tasa de aceptación de candidatos incorrectos es f. Entonces, la proporción de respuestas correctas en el conjunto aceptado es pt/[pt+(1−p)f]. Aunque f parezca pequeña, los errores pueden constituir una proporción considerable del conjunto aceptado cuando los candidatos correctos son extremadamente escasos. Deben comunicarse la tasa base de corrección y el umbral de aceptación, y la evaluación debe realizarse sobre candidatos producidos por búsquedas reales, en lugar de limitar las pruebas a ejemplos elegidos manualmente que sean manifiestamente correctos o incorrectos.[3] Let's Verify Step by Step
11. Los efectos del presupuesto de inferencia y de la optimización del sistema deben atribuirse por separado
Aumentar los nodos de búsqueda, los tokens de salida o las llamadas a herramientas suele incrementar el presupuesto computacional; en cambio, los métodos de sistema, como la decodificación especulativa, pueden reducir el tiempo de espera manteniendo la misma distribución objetivo de muestreo. Ambos pueden permitir que el usuario obtenga antes una respuesta correcta, pero su explicación científica es distinta. Un estudio justo debe informar conjuntamente del cómputo total, el tiempo de reloj, el número de candidatos y la tasa de éxito, y comparar las fronteras de rendimiento con presupuestos fijos. No debe atribuirse íntegramente la mayor tasa de éxito obtenida mediante más intentos a que el modelo base «razona mejor».[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[4] Fast Inference from Transformers via Speculative Decodi
Fórmulas y derivaciones fundamentales
(1) solo se cumple bajo los supuestos de independencia entre intentos y tasa de éxito fija. En la figura, p es una constante explícitamente indicada, no una tasa de éxito medida empíricamente para un modelo de lenguaje.
LaTeX
P(\text{至少一次成功})=1-(1-p)^k(2) Si hay c muestras correctas entre n muestras ya generadas, estima, bajo las condiciones aplicables, la probabilidad de que al menos una de k muestras elegidas al azar sea correcta; cuando n−c<k, el numerador es 0. Esta cantidad no incluye la capacidad de seleccionar la respuesta correcta.
LaTeX
\widehat{\mathrm{pass@}k}=1-\frac{\binom{n-c}{k}}{\binom{n}{k}}(3) t es la tasa de aceptación verdadera y f la tasa de aceptación falsa. La fórmula muestra la importancia de la proporción base; no basta con comunicar una única exactitud agregada del verificador.
LaTeX
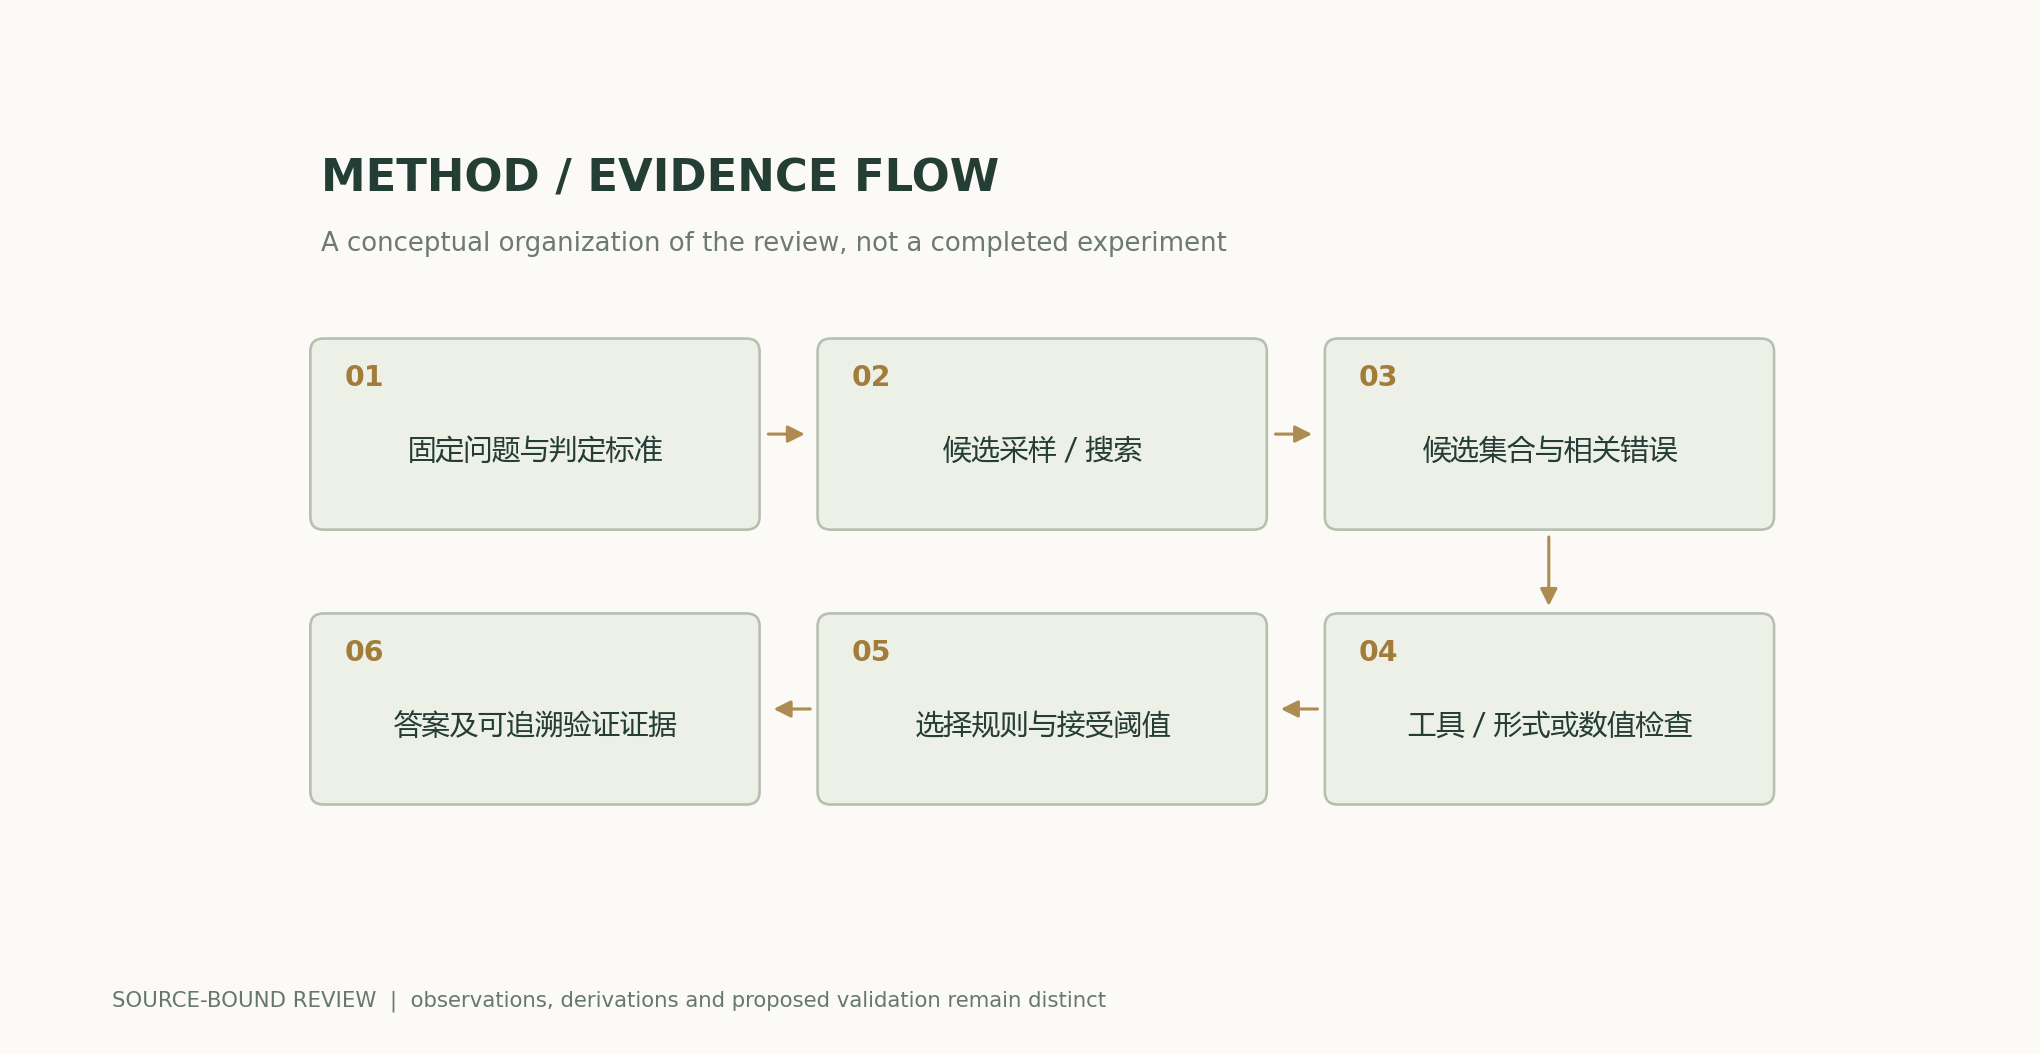
P(\mathrm{correct}\mid\mathrm{accepted})=\frac{pt}{pt+(1-p)f}Flujo de métodos y evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto reproducible
Con una probabilidad de éxito independiente de 0.25, la probabilidad de al menos un éxito en 8 intentos es aproximadamente 0.900; sin embargo, si la sensibilidad del verificador es 0.9, la tasa de falsos positivos es 0.1 y la tasa de corrección de los candidatos es 0.1, su valor predictivo positivo es solo 0.5. La existencia de un candidato correcto no equivale a su selección final.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo y explicaciones |
|---|---|---|
| Generación única | Fijar las instrucciones y la decodificación; informar de los resultados por tarea | Una explicación más larga no implica una conclusión más fiable |
| Muestreo repetido | Mantener el mismo presupuesto total; distinguir el éxito de generación del éxito de selección | Los errores correlacionados debilitan la intuición del muestreo independiente |
| Filtrado mediante verificador | Candidatos de búsquedas reales, umbrales y tasa de aceptación falsa | Los resultados con muestras construidas artificialmente pueden ser demasiado optimistas |
| Aceleración del sistema | Fijar la distribución objetivo y el presupuesto de candidatos; medir por separado el tiempo de reloj | Reducir el tiempo de espera no aumenta automáticamente la capacidad de razonamiento de un solo intento |
Protocolo de revisión y experimentación
- Elegir un conjunto de tareas cuyas respuestas puedan evaluarse con claridad y conservar los criterios de respuesta, las versiones de los datos y las comprobaciones de contaminación; establecer reglas independientes de fuentes y anotación para las preguntas abiertas.
- Fijar el presupuesto total de candidatos y comparar por separado la generación única, el muestreo, la votación, las herramientas externas y la selección mediante verificador, conservando todos los fallos.
- Informar de pass@k, la exactitud de las respuestas seleccionadas por el sistema y la proporción que no puede evaluarse; no mostrar únicamente la mejor salida.
- Medir la correlación de los errores entre candidatos y comprobar si las distintas formulaciones siguen dependiendo de las mismas premisas erróneas o de las mismas fuentes.
- Realizar un barrido de umbrales del verificador, registrar las tasas de aceptación verdadera, aceptación falsa y rechazo, y validar sobre la distribución de búsqueda real.
- Contabilizar por separado los tokens, las llamadas a herramientas, el cómputo real y el tiempo de reloj en el presupuesto; repetir la evaluación sobre un conjunto reservado independiente después de modificar el entrenamiento o las instrucciones.
Ámbito de aplicación y limitaciones
- El muestreo independiente es solo un supuesto analítico.
- Las preguntas abiertas suelen carecer de un verificador completo capaz de decidir la corrección.
- Las explicaciones generadas no pueden sustituir la verificación externa.
- No se introducen nuevas pruebas de referencia de razonamiento ni clasificaciones de modelos.
Fuentes primarias y afirmaciones correspondientes
- Chain-of-Thought Prompting Elicits Reasoning in Large Language ModelsWei et al. · 2022-01-28v6; method and limitations
- Self-Consistency Improves Chain of Thought Reasoning in Language ModelsWang et al. · 2022-03-21v4 abstract
- Let's Verify Step by StepLightman et al. · 2023-05-31v1 abstract; process vs outcome supervision
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas a partir de la literatura primaria enumerada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y la ETag no cambia. El texto, las fórmulas, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual está separada de los diagramas científicos; las figuras científicas se calculan a partir de fórmulas públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Historial de autoría, versiones y correcciones · /guides/reasoning-verification/v5/
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770