
要旨
推論連鎖、候補探索、検証器は、一部のタスクにおける最終結果を改善しうるが、それぞれが変化させる段階は異なる。本稿ではさらに、反復サンプリングの成功率が成り立つ条件、誤りの相関、選別後の分布における検証器の機能不全を論じ、共通の推論予算の下での比較設計を提示する。推論テキストはモデルの出力にすぎず、計算や事実の成立をそれ自体で証明することはできない。解析的な計算例は、試行回数を増やすことで利益が得られる可能性を説明するとともに、独立性と検証の証拠がなければ、多数派の回答や長い説明を根拠に信頼性の向上を宣言できない理由を示す。[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
原文の英語要旨の日本語訳
推論性能を、候補生成、選択、検証に分けて捉える。独立サンプリングに基づく計算によって、仮定を明示しながら、試行を追加することの可能性を説明する。相関した失敗、検証器による誤受理、不均等な推論予算は、単純な比較を無効にしうる。提案するプロトコルは、生成された説明をその結論が正しい証拠とはみなさず、成功と失敗の両方の履歴を記録する。
1. 中間テキストは正しさの証明ではない
思考連鎖の研究は、調査対象のモデルとタスクにおいて、中間ステップを含む例が算術、常識、記号推論の性能を改善しうることを示している。この結果は、プロンプトの構成がタスクの解決に影響しうることを示すが、生成される各ステップの妥当性を保証するものではない。読者は、最終回答の正しさ、ステップの妥当性、説明が実際の計算に忠実であるかを区別すべきであり、記述の一貫性を検査の代わりにしてはならない。[1] Chain-of-Thought Prompting Elicits Reasoning in Large L
2. 自己整合性は複数の経路に計算を費やす
自己整合性の手法は、異なる推論経路をサンプリングし、回答を集約して選択する。「異なる経路が正答に収束する可能性がある」という構造を利用するもので、単一の貪欲な経路だけに沿って生成する方法とは異なる。ただし、モデルが同じ誤った前提を繰り返し再利用する場合、サンプル数の増加は誤りの反復にとどまる可能性がある。候補の実効的な多様性は、サンプリング回数とは分けて報告すべきである。[2] Self-Consistency Improves Chain of Thought Reasoning in
3. 過程監督は中間の判断に着目する
Let's Verify Step by Stepは、最終結果の監督と過程監督を比較し、特定の数学タスクと候補選択の設定において、過程監督の優位性を報告している。その要旨に記載された78%は、MATHテストセットの代表的な部分集合と論文の評価手続きに関する数値であり、「あらゆる数学問題を解く正答率」と言い換えてはならない。本稿では、この数値を用いて汎用的な能力ランキングを作成しない。[3] Let's Verify Step by Step
4. 投票に関する明示的な導出
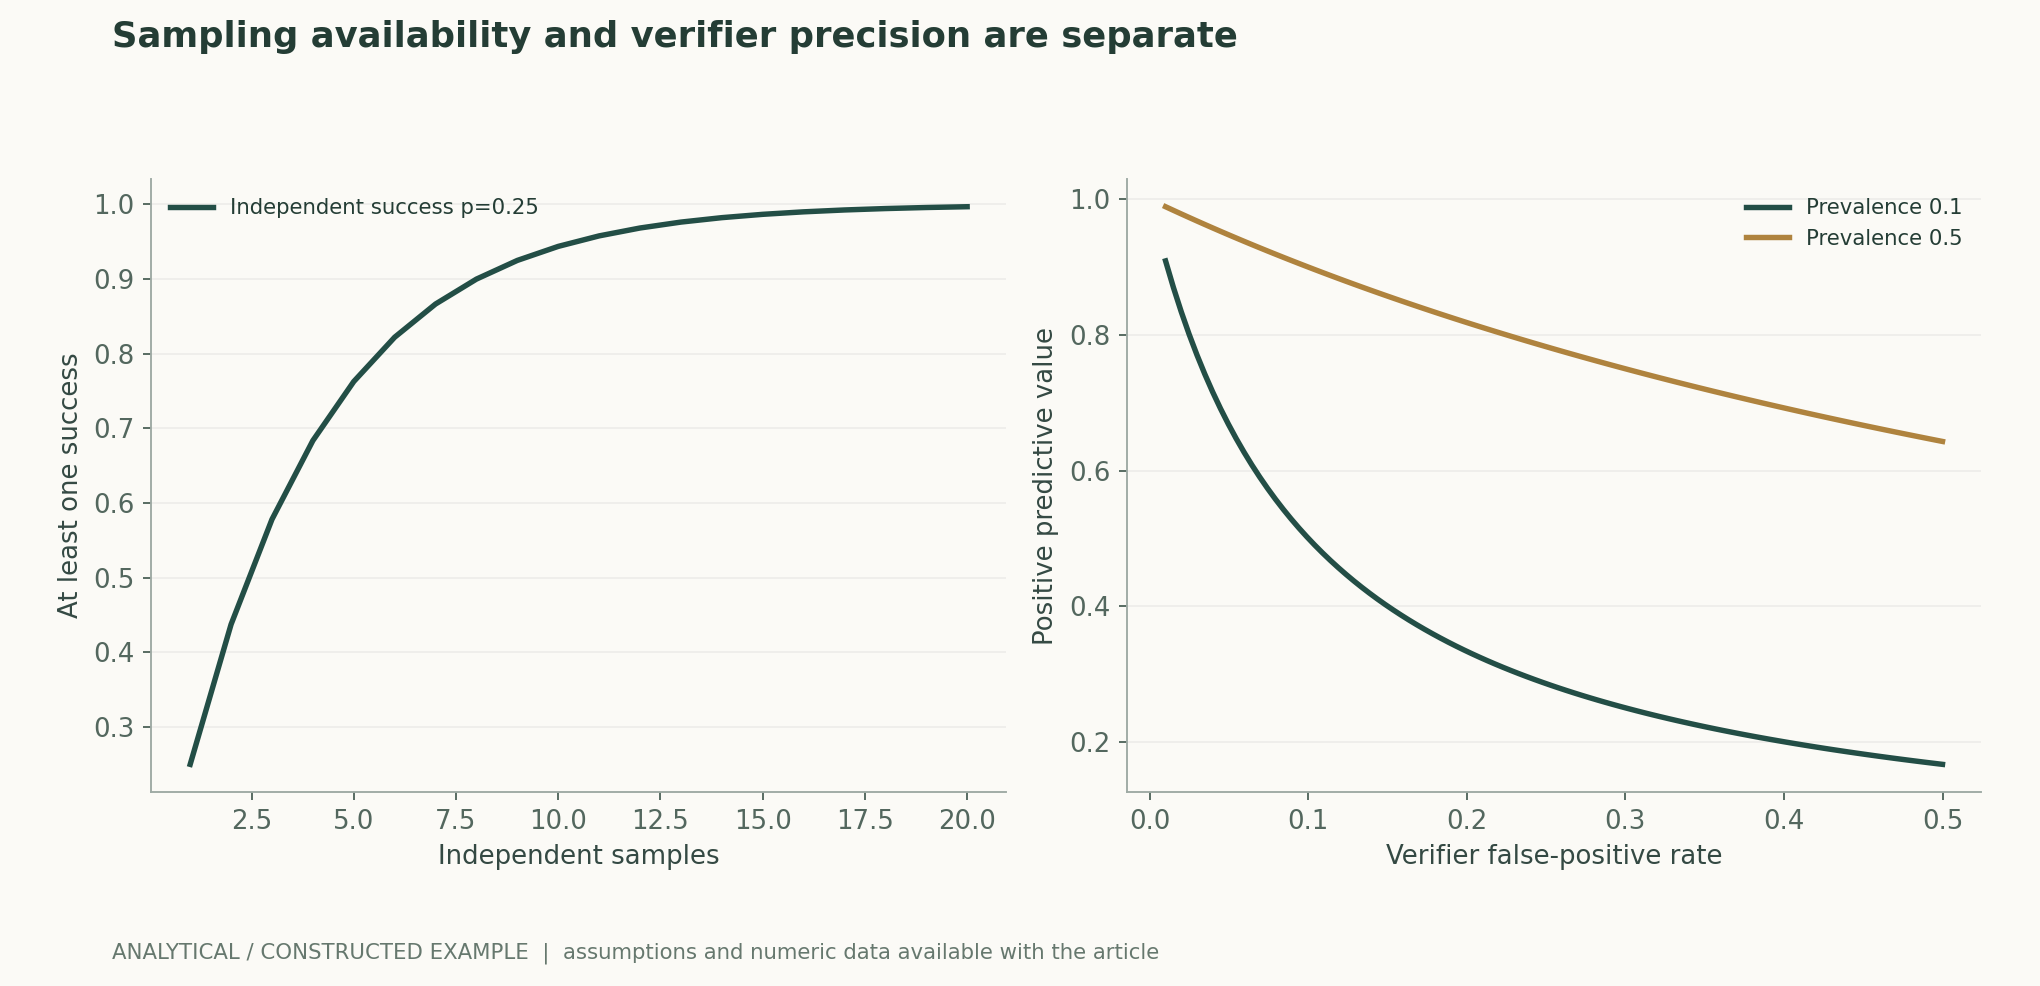
候補が独立で、正しい確率が一定のpであり、すべての正しい候補を同一の回答としてまとめられる場合、奇数回nの多数決の成功確率は、からnまでの二項確率の和となる。これは「少なくとも一つの候補が正しい」こととは異なり、後者の確率が高くても、信頼できる選択器がなお必要である。本版の図2は、少なくとも一度成功する確率と検証器の陽性的中率を示しており、多数決の実測結果ではない。独立性、同一分布、回答の統合はいずれも検証を要する仮定である。作者分析与复核建议 / Author analysis
5. 独立性の仮定がしばしば不十分である理由
同一モデルの出力は、知識の欠落、プロンプトの偏り、問題の読み違いを共有する可能性があり、サンプリングで異なる文章が得られても、誤りは相関しうる。形式上「九つの回答がある」ことは、九つの独立した証拠があることを意味しない。外部検索、プログラム実行、証明可能な制約検査は、言語的な言い換えとは異なる情報を導入する可能性があるが、実際に有効かどうかは、なおタスクごとに測定する必要がある。[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
6. 比較には予算の明示が必要である
ある手法がより多くのトークン、より多くの候補、あるいはより強力な検証器を使用する場合、品質の変化は計算投入量の変化と同時に生じる。本稿では、問題ごとの総トークン数、呼び出し回数、タイムアウト率、最終正答率、エンドツーエンドのレイテンシを併せて報告し、難易度別の結果も保持することを推奨する。最も容易な問題だけの平均所要時間を報告すればロングテールが隠れ、最良の回答だけを示せば選択コストが隠れる。作者分析与复核建议 / Author analysis
7. 点検可能な検証の境界を構築する
算術では計算を実行して単位を照合し、コードでは隔離されたテストと期待される動作を用い、文献上の事実では出典と版を照合する。検証器自体の誤判定も評価すべきである。検証器が本質的には同種のモデルによる主観的な採点にとどまる場合、その依存関係を公開し、外部実験によって確認済みであるかのように記述してはならない。ここに示すのは設計原則であり、本サイトはこれに基づく新たなモデル実験の実施を主張していない。作者分析与复核建议 / Author analysis
検証器の能力も予算の条件に依存する
過程の検査は、別種の計算投入を追加する。検証器が正解、特殊なツール、あるいはより多くの文脈にアクセスできる場合、それらは候補生成モデルが利用できる情報と区別すべきである。百個の候補から最良の回答を選ぶのであれば、最終正答率は百個の候補を生成するコストと併せて示す必要がある。この結果と単回生成を直接比較することは、システム水準の比較にはなりうるが、資源の差を省略したうえで、基盤モデルの推論能力が同じ幅で向上したと主張することはできない。作者分析与复核建议 / Author analysis
8. pass@kの直観と推定対象
各試行の成功確率がいずれもpで、互いに独立である場合、少なくとも一度成功する確率は1−(1−p)^kとなる。これは予算増加による潜在的な利益の説明に適しているが、実際の候補集合が独立性を満たすことを意味しない。同じ固定サンプルプールから非復元抽出する場合、一般的な推定式は組合せ数を用い、その推定対象も独立ベルヌーイモデルと完全には同じではない。論文では、サンプリング回数、温度、サンプルプール、選択方針を明示し、「正答が生成されたこと」と「システムが正答を選び出せること」を区別しなければならない。後者には、選択または検証の段階がさらに必要である。[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
9. 多数の一致は共通の誤りの機構から生じる可能性がある
候補が同じ訓練由来の知識、プロンプト、検索資料を使用する場合、同じ誤った前提を共有している可能性がある。表現が異なっていても、独立した証拠を提供しているとは限らない。問題の表層的な形式、証拠の出典、解法に用いるツール、検証方法を変えることで誤りの相関を調べられるが、これらの変更は単回の成功率も変えうるため、個別に記録する必要がある。数学やコードのタスクでは、独立に再計算または実行できる検査の方が、言語上の相互同意だけよりも外部証拠に近い。自由回答型の事実タスクでは、検証資料の版と出典も同様に重要である。[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
10. 検証器は選別後の分布で評価しなければならない
生成器が生成する正しい候補の割合をp、検証器の正しい候補に対する受理率をt、誤った候補に対する受理率をfとすると、受理された集合における正答の割合はpt/[pt+(1−p)f]となる。fが小さく見えても、正しい候補が極めて少ない場合には、受理された集合の相当部分を誤りが占める可能性がある。基礎となる正答率と受理閾値を報告し、人為的に選ばれた明らかな正誤の例だけでテストするのではなく、実際の探索が生成した候補で評価すべきである。[3] Let's Verify Step by Step
11. 推論予算とシステム最適化の寄与は分けて帰属させなければならない
探索ノード、出力トークン、ツール呼び出しを増やすと、通常は計算予算が増加する。一方、投機的デコーディングなどのシステム手法は、同じ目標サンプリング分布の下で待ち時間を短縮しうる。どちらも利用者がより早く正答を得ることに役立つ可能性があるが、科学的な説明は異なる。公平な研究では、総計算量、実経過時間、候補数、成功率を併せて報告し、固定予算の下で性能フロンティアを比較すべきである。試行の増加によって得られた高い成功率を、すべて基盤モデルが「よりよく推論できる」ようになったことに帰属させてはならない。[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[4] Fast Inference from Transformers via Speculative Decodi
主要な数式と導出
(1)は、各試行が独立で、成功率が一定であるという仮定の下でのみ成立する。図中のpには明示された定数を用いており、特定の言語モデルの実測成功率ではない。
LaTeX
P(\text{至少一次成功})=1-(1-p)^k(2)は、生成済みのn個のサンプルのうちc個が正しいとき、適用条件の下で、無作為に選んだk個のサンプルの少なくとも一つが正しい確率を推定する。n−c<kのとき、分子は0となる。この量には、正答を選び出す能力は含まれない。
LaTeX
\widehat{\mathrm{pass@}k}=1-\frac{\binom{n-c}{k}}{\binom{n}{k}}(3)において、tは真受理率、fは誤受理率である。この式は基礎比率の重要性を示しており、検証器の集約された正解率を一つ報告するだけでは不十分である。
LaTeX
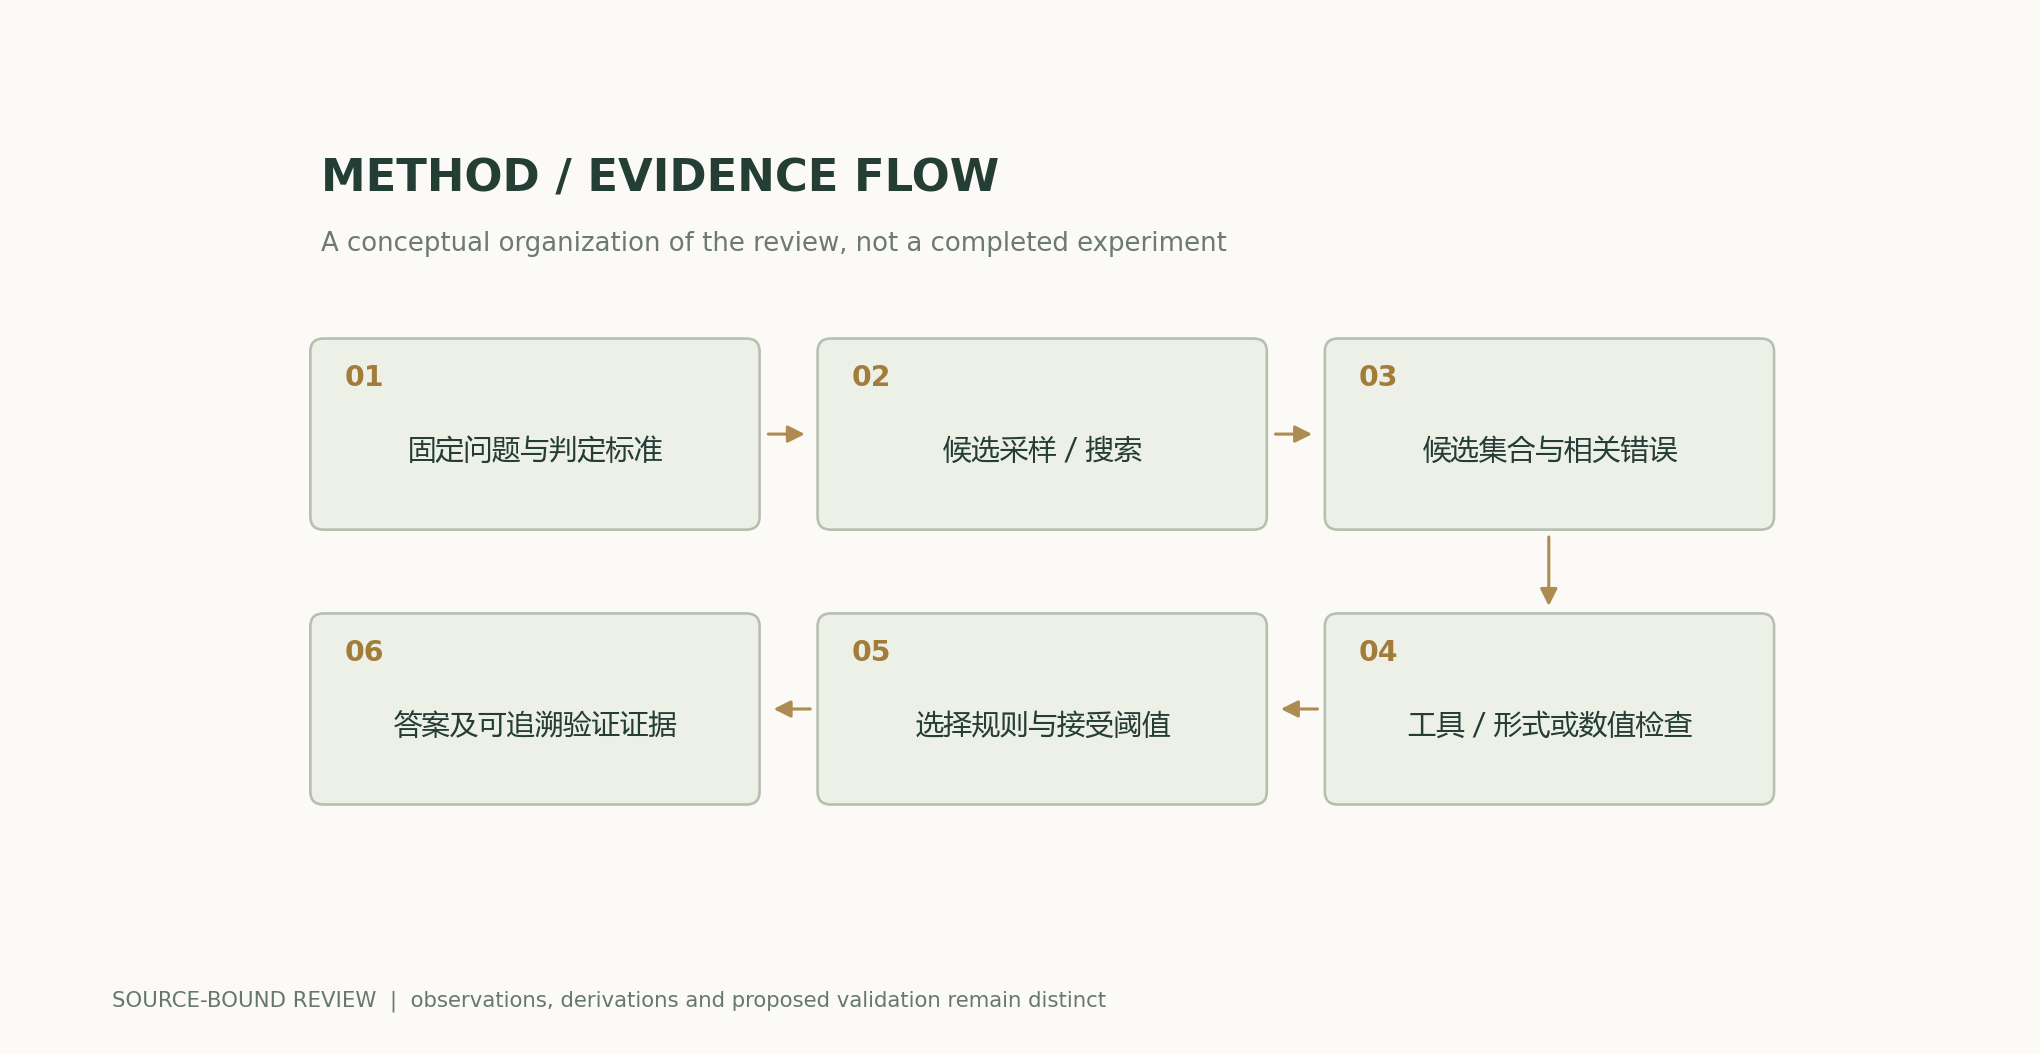
P(\mathrm{correct}\mid\mathrm{accepted})=\frac{pt}{pt+(1-p)f}方法と証拠のフロー
解析図と数値例
再計算可能な例題
独立な成功確率が0.25の場合、8回のうち少なくとも一度成功する確率は約0.900となる。しかし、検証器の感度が0.9、偽陽性率が0.1、候補の正答率が0.1であれば、その陽性的中率は0.5にすぎない。正しい候補が存在することは、最終的にそれが選ばれることを意味しない。
方法の比較
| 方法または判断 | 統制変数と測定 | 機能不全の条件と解釈 |
|---|---|---|
| 単回生成 | プロンプトとデコーディングを固定し、タスクごとの結果を報告する | 説明が長いことは、結論の信頼性が高いことを意味しない |
| 反復サンプリング | 総予算を同一にし、生成の成功と選択の成功を区別する | 相関した誤りは独立サンプリングの直観を弱める |
| 検証器による選別 | 実際の探索候補、閾値、誤受理率 | 人為的に構成されたサンプルでの成績は過度に楽観的である可能性がある |
| システムの高速化 | 目標分布と候補予算を固定し、実経過時間を別に測定する | 待ち時間の短縮は単回の推論能力を自動的に向上させるものではない |
再検証と実験の計画
- 明確に判定できるタスク集合を選び、回答基準、データの版、データ汚染の検査結果を保存する。自由回答問題には、出典とアノテーションの規則を別途設ける。
- 候補の総予算を固定し、単回生成、サンプリング、投票、外部ツール、検証器による選択を個別に比較して、すべての失敗を保存する。
- pass@k、システムが選択した回答の正答率、判定不能の割合を報告し、最良の出力だけを示してはならない。
- 候補間の誤りの相関を測定し、異なる表現がなお同じ誤った前提や同じ出典に依存していないかを調べる。
- 検証器の閾値を走査し、真受理率、誤受理率、拒否率を保存して、実際の探索分布で検証する。
- トークン、ツール呼び出し、実際の計算量、実経過時間を別々に予算へ算入する。訓練やプロンプトを変更した後は、独立したホールドアウト評価をやり直す。
適用範囲と限界
- 独立サンプリングは解析上の仮定にすぎない。
- 自由回答問題では、網羅的に正誤を判定できる検証器が存在しないことが多い。
- 生成された説明は外部検証の代わりにはならない。
- 新たな推論ベンチマークやモデルランキングは提示していない。
一次資料と主張の対応
- Chain-of-Thought Prompting Elicits Reasoning in Large Language ModelsWei et al. · 2022-01-28v6; method and limitations
- Self-Consistency Improves Chain of Thought Reasoning in Language ModelsWang et al. · 2022-03-21v4 abstract
- Let's Verify Step by StepLightman et al. · 2023-05-31v1 abstract; process vs outcome supervision
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、版、出典
AI支援による研究レビュー。Codex(AI)が、列挙した一次文献に基づいて執筆し、解析的な導出を行った。本サイトには、本稿の独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前版の内容を維持している。
概念的な表紙と科学的な図解は分離している。科学図は公開された数式と明示的な仮定から計算し、原論文の結果にはすべて帰属先を明記している。
著者、版、訂正の記録 · /guides/reasoning-verification/v5/
表紙と科学図の出典 · データ、出典、仮定 · 公開と版の履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770