
摘要
推理链、候选搜索和验证器可以改善某些任务的最终结果,但它们改变的是不同环节。本文进一步讨论多次采样成功率的条件、错误相关性以及验证器在筛选后分布上的失效,并给出统一推理预算下的对照设计。推理文字只是模型输出,不能自证运算或事实成立。解析算例说明为什么增加尝试次数可能有收益,也说明没有独立性与验证证据时,不能根据多数答案或更长解释宣布可靠性提高。[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
English abstract
Reasoning performance is separated into candidate generation, selection and verification. An independent-sampling calculation explains the potential of additional attempts while making its assumptions explicit. Correlated failures, verifier false acceptance and unequal inference budgets can invalidate naive comparisons. The proposed protocol records both success and failure traces without treating generated explanations as evidence that their conclusions are correct.
1. 中间文字不是正确性的证明
思维链研究展示,在被研究模型与任务中,带中间步骤的示例能改善算术、常识与符号推理表现。这个结果说明提示组织可能影响任务求解,并不保证生成的每一步都有效。读者应把最终答案正确性、步骤有效性和解释是否忠实于实际计算分开看,不能以叙述连贯代替检验。[1] Chain-of-Thought Prompting Elicits Reasoning in Large L
2. 自一致性把计算花在多路径上
自一致性方法采样不同推理路径,再对答案进行汇总选择。它利用“不同路径可能汇聚到正确答案”的结构,区别于只沿单一贪心路径生成。但如果模型反复复用同一个错误前提,样本数量增加也可能只是重复错误。有效候选多样性应与抽样次数分开报告。[2] Self-Consistency Improves Chain of Thought Reasoning in
3. 过程监督关注中间判断
Let's Verify Step by Step 比较最终结果监督与过程监督,在特定数学任务和候选选择设置中报告了过程监督的优势。其摘要中的 78% 属于 MATH 测试集的代表性子集及论文的评估过程,不能改写为“解决全部数学问题的准确率”。本文不以该数字绘制通用能力排行榜。[3] Let's Verify Step by Step
4. 一个透明的投票推导
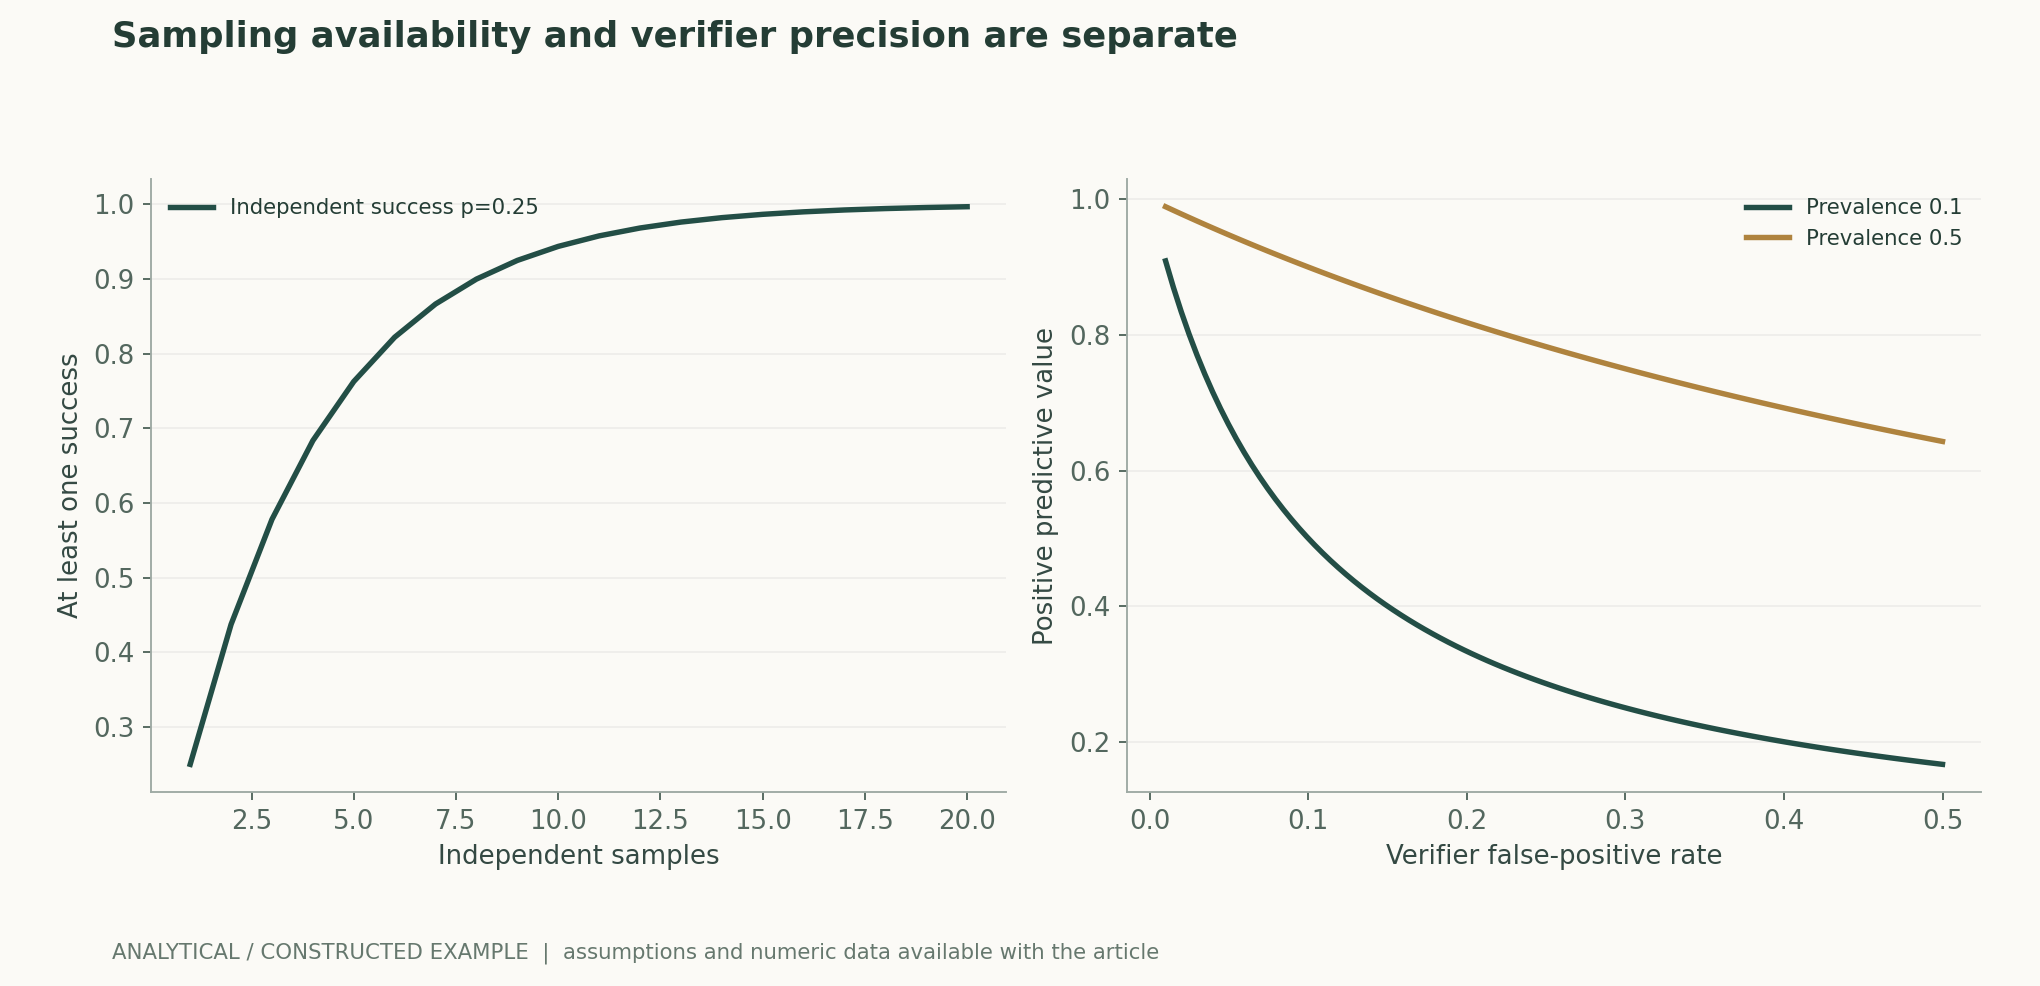
若候选独立、正确概率恒为p,且所有正确候选可归为同一答案,奇数n次多数票的成功概率是从到n的二项概率之和。这与“至少一个候选正确”不同;后者即使很高,也还需要可靠选择器。本版图2展示至少一次成功和验证器阳性预测值,不是多数票实测。独立、同分布及答案归并都是需要检验的假设。作者分析与复核建议 / Author analysis
5. 为什么独立假设经常不够
同一个模型可能共享知识缺口、提示偏差和题目误读,即使采样得到不同文字,错误仍然相关。形式上“有九个答案”不代表有九份独立证据。外部检索、程序执行或可证明的约束检查,有机会引入不同于语言重述的信息;是否真的有效,仍需针对任务测量。[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
6. 比较时必须给出预算
一个方法若使用更多词元、更多候选或更强验证器,质量变化就与计算投入共同发生。本文建议同时报告每题总词元、调用次数、超时率、最终正确率与完整延迟,并保留按难度分组的结果。只报告最容易题目的平均耗时,会掩盖长尾;只展示最好一次答案,会掩盖选择成本。作者分析与复核建议 / Author analysis
7. 建立可检查的验证边界
对于算术,执行计算并核对单位;对于代码,使用隔离测试与预期行为;对于文献事实,核对来源与版本。验证器也应有自己的误判评估。若验证器本质上仍是同类模型的主观评分,应公开这一依赖,不应把它写成外部实验已经确认。这里列出的是设计原则,本站未据此声称完成新的模型实验。作者分析与复核建议 / Author analysis
验证器的能力也有预算条件
过程检查增加了另一类计算投入。如果验证器能访问标准答案、特殊工具或更多上下文,应与候选模型的可用信息区分开。若在一百个候选中挑出最好答案,最终正确率应与生成一百个候选的成本同时展示。把这种结果与单次生成直接比较,可以作为系统层比较,却不能省略资源差异后宣称基础模型推理能力同幅度提高。作者分析与复核建议 / Author analysis
8. pass@k的直觉与估计对象
若每次尝试成功概率均为p且彼此独立,至少一次成功的概率为1−(1−p)^k。这适合解释预算增加的潜在收益,却不意味着实际候选集满足独立性。对同一固定样本池进行无放回抽样时,常见估计式使用组合数,其估计对象和独立伯努利模型又不完全相同。论文必须说明采样次数、温度、样本池与选取策略,区分“生成过正确答案”和“系统能挑出正确答案”;后者还需要选择或验证步骤。[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
9. 多数一致可能来自共同的错误机制
候选使用相同训练知识、提示和检索材料时,可能共享同一个错误前提。即使表述不同,也未必提供独立证据。可以通过改变问题表面形式、证据来源、解题工具和验证方式研究错误相关性,但这些变化同时可能改变单次成功率,需要分别记录。对于数学或代码任务,能独立重算或执行的检查比纯语言上的相互赞同更接近外部证据。对开放事实任务,验证材料的版本和来源同样重要。[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[3] Let's Verify Step by Step
10. 验证器必须在筛选后的分布上测试
假设生成器产生正确候选的比例为p,验证器对正确候选的接受率为t,对错误候选的接受率为f,则被接受集合中正确答案的比例为pt/[pt+(1−p)f]。即使f看起来很小,当正确候选极少时,错误仍可能在接受集合中占较大比例。应报告基础正确率和接受阈值,并在真实搜索产生的候选上评价,而不只在人工挑选的明显对错样本上测试。[3] Let's Verify Step by Step
11. 推理预算与系统优化必须分开归因
增加搜索节点、输出词元或工具调用往往增加计算预算;推测解码等系统方法则可能在相同目标采样分布下减少等待时间。两者都可能让用户更快得到正确答案,但科学解释不同。一个公平研究应同时报告总计算、壁钟时间、候选数与成功率,并比较固定预算下的性能前沿。不要把使用更多尝试得到的更高成功率全部归因于基础模型“更会推理”。[1] Chain-of-Thought Prompting Elicits Reasoning in Large L[2] Self-Consistency Improves Chain of Thought Reasoning in[4] Fast Inference from Transformers via Speculative Decodi
核心公式与推导
(1) 仅在每次尝试独立且成功率固定的假设下成立。图中的p取明示常数,不是某个语言模型的实测成功率。
LaTeX
P(\text{至少一次成功})=1-(1-p)^k(2) n个已生成样本中有c个正确,在适用条件下估计随机选k个样本至少命中一个的概率;当n−c<k时分子为0。该量不包含挑选正确答案的能力。
LaTeX
\widehat{\mathrm{pass@}k}=1-\frac{\binom{n-c}{k}}{\binom{n}{k}}(3) t为真接受率,f为假接受率。公式展示基础比例的重要性,不能只报告验证器的一个汇总准确率。
LaTeX
P(\mathrm{correct}\mid\mathrm{accepted})=\frac{pt}{pt+(1-p)f}方法与证据流程
解析图与数值示例
可复算例题
独立成功率0.25时,8次至少一次成功的概率约0.900;但若验证器敏感度0.9、假阳性率0.1、候选正确率0.1,其阳性预测值仅0.5。候选存在不等于最终选中。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 单次生成 | 固定提示与解码,报告逐任务结果 | 解释更长不代表结论更可靠 |
| 多次采样 | 相同总预算,区分生成成功与选择成功 | 相关错误会削弱独立采样直觉 |
| 验证器筛选 | 真实搜索候选、阈值及假接受率 | 人工构造样本上的成绩可能过于乐观 |
| 系统加速 | 固定目标分布与候选预算,分开测壁钟 | 减少等待时间不自动增加单次推理能力 |
复核与实验方案
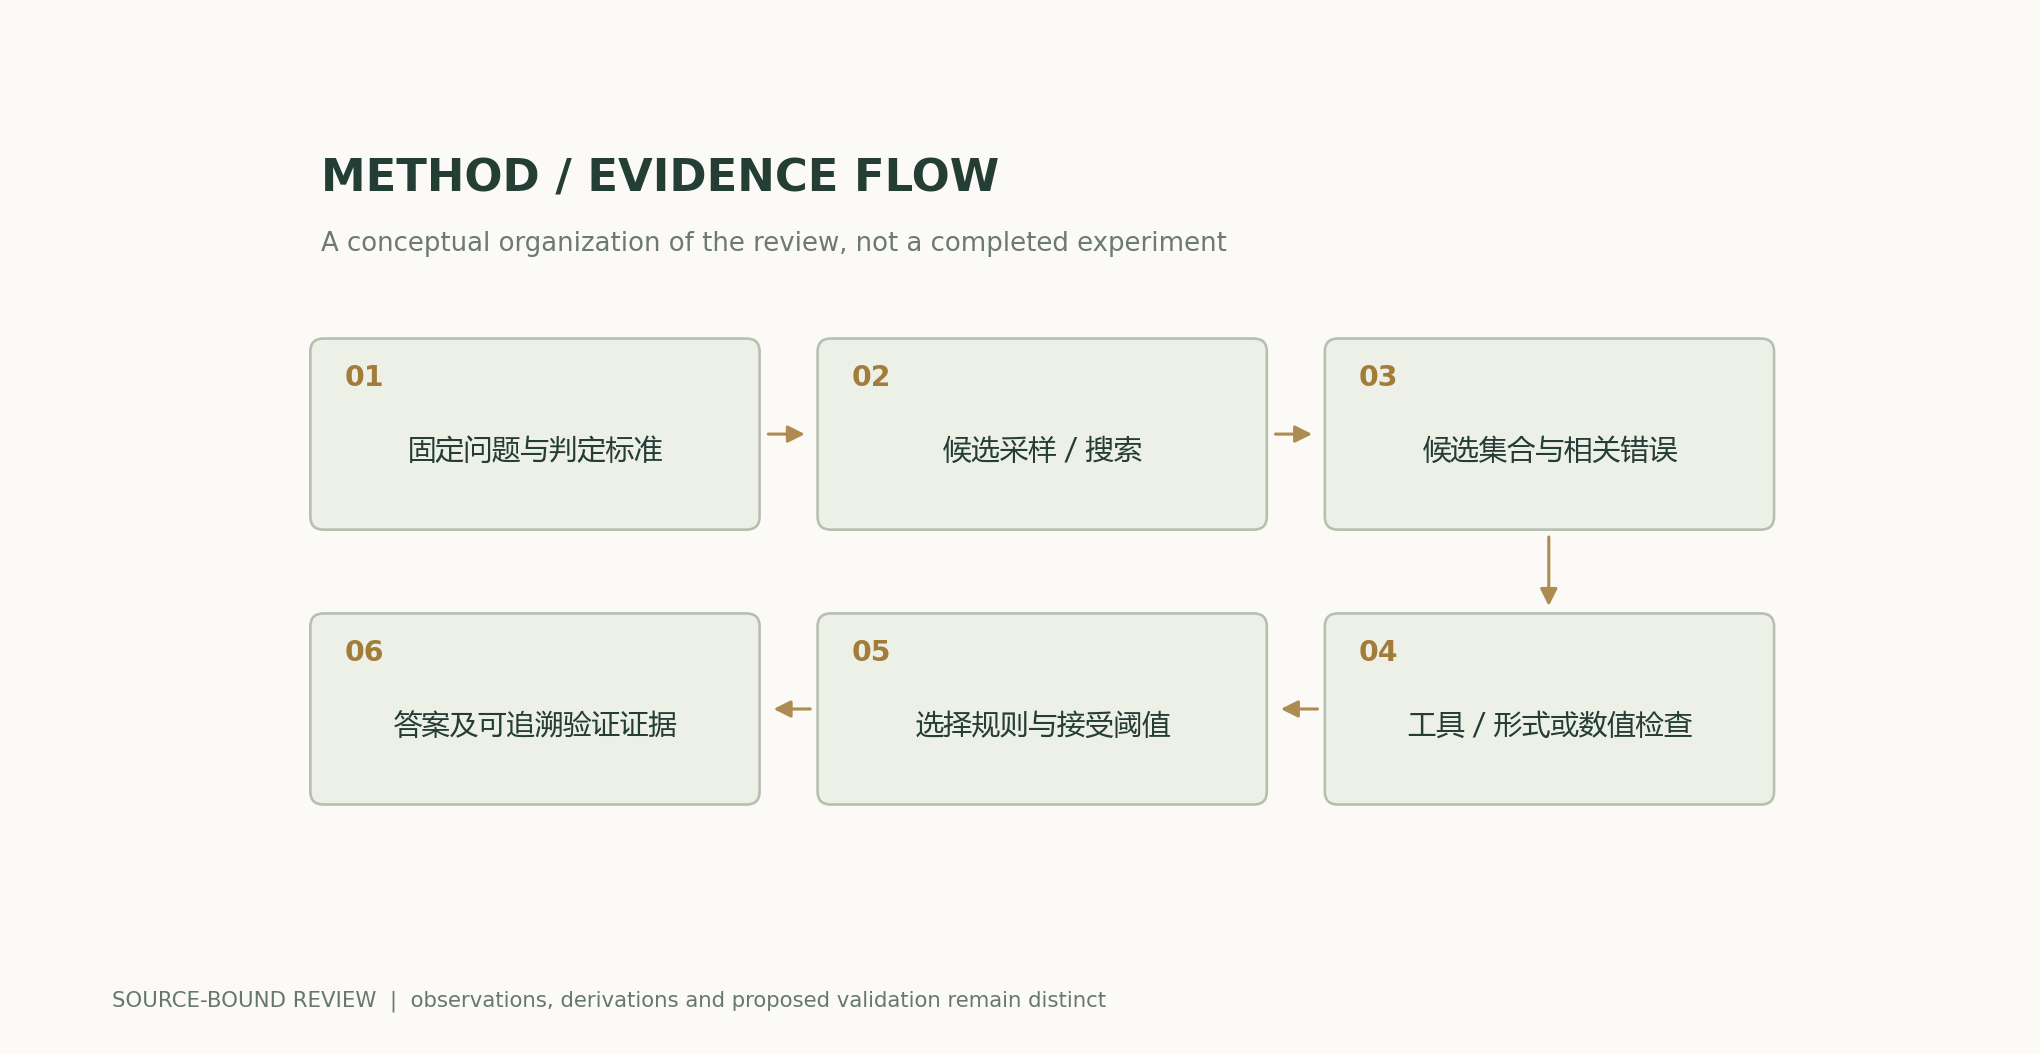
- 选择可明确判定的任务集,保存答案标准、数据版本和污染检查;开放题另设来源与标注规则。
- 固定总候选预算,分别比较单次、采样、投票、外部工具和验证器选择,保留所有失败。
- 报告pass@k、被系统选中的答案准确率与无法判定比例,不能只展示最好的一次输出。
- 测量候选间错误相关性,检查不同表述是否仍依赖相同错误前提或相同来源。
- 对验证器扫描阈值,保存真接受、假接受和拒绝率,并在真实搜索分布上验证。
- 把词元、工具调用、实际计算和壁钟时间分别计入预算;训练或提示改动后重做独立留出评价。
适用范围与局限
- 独立采样只是解析假设。
- 开放题往往没有完备可判定的验证器。
- 生成解释不能替代外部验证。
- 没有新增推理基准或模型排名。
一手来源与主张对应
- Chain-of-Thought Prompting Elicits Reasoning in Large Language ModelsWei et al. · 2022-01-28v6; method and limitations
- Self-Consistency Improves Chain of Thought Reasoning in Language ModelsWang et al. · 2022-03-21v4 abstract
- Let's Verify Step by StepLightman et al. · 2023-05-31v1 abstract; process vs outcome supervision
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
阅读器性能修订:新近 HEAD 返回 200 且 ETag 相同时也复用已读页面。正文、公式、来源和科学图的数据保持上一版本内容。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/reasoning-verification/v5/
Source revision: 6251a250b27bb8b449f59b392f81abd355383770