
Resumen
RETFound aprende representaciones a partir de imágenes de retina no etiquetadas a gran escala y después las adapta a tareas relacionadas con enfermedades, lo que demuestra el potencial del aprendizaje autosupervisado en medicina. Sin embargo, la eficiencia en el uso de etiquetas, la capacidad de discriminación, la calibración de probabilidades y el beneficio clínico son criterios de valoración distintos. Este artículo incorpora investigaciones tempranas sobre sistemas de derivación por patología retiniana para establecer un marco de evidencia que abarca desde las representaciones hasta la validación externa y los flujos de trabajo. Mediante valores supuestos de sensibilidad, especificidad y prevalencia, calculamos los cambios en el valor predictivo positivo y en la carga de derivaciones, y explicamos por qué una puntuación excelente no puede determinar por sí sola el valor de la implementación. El artículo no utiliza datos de pacientes ni ofrece recomendaciones individuales de diagnóstico o tratamiento.[1] A foundation model for generalizable disease detection [2] Clinically applicable deep learning for diagnosis and r
Traducción del resumen original en inglés
Los modelos fundacionales de retina aprenden representaciones reutilizables, pero su valor clínico requiere validación externa específica de cada tarea y evidencia sobre el flujo de trabajo. Examinamos RETFound y un sistema de derivación por patología retiniana, y después derivamos cómo la prevalencia modifica el valor predictivo positivo y cómo los casos inciertos alteran la carga de trabajo. Un ejemplo hipotético de matriz de confusión separa la discriminación, la calibración y la carga operativa. El análisis no contiene datos de pacientes ni constituye una recomendación diagnóstica o terapéutica.
1. El preentrenamiento autosupervisado aborda el aprovechamiento de las etiquetas, pero no resuelve automáticamente todos los problemas clínicos
El estudio original de RETFound utilizó aproximadamente 160 decenas de millar de imágenes no etiquetadas para aprender representaciones adaptables y las evaluó en tareas etiquetadas. Esto muestra que los datos no etiquetados pueden respaldar múltiples tareas posteriores, pero el número de muestras de preentrenamiento no equivale al de pacientes independientes ni significa que se hayan validado todas las enfermedades, dispositivos y poblaciones. Este artículo recomienda registrar simultáneamente cuatro unidades: imagen, ojo, paciente, visita e institución, para evitar que varias imágenes de un mismo paciente se distribuyan entre entrenamiento y prueba. La comparación de la eficiencia en el uso de etiquetas también requiere igualar los presupuestos de adaptación, la calidad de las entradas y las definiciones de las tareas, en lugar de comparar únicamente el AUC final.[1] A foundation model for generalizable disease detection
2. Las representaciones, las lesiones oculares y el riesgo sistémico son objetivos distintos
Predecir el estado ocular a partir de imágenes de retina y predecir futuros eventos sistémicos requieren etiquetas, seguimiento y control de factores de confusión distintos. RETFound explora varios tipos de tareas, pero las conclusiones siguen ligadas a sus respectivas muestras y criterios de valoración. Este artículo propone elaborar una ficha de tarea independiente para cada versión adaptada del modelo: ventana de observación, definición del desenlace, tratamiento de la censura, fuentes de las etiquetas y criterios de exclusión. Si la imagen se obtiene cerca del desenlace, el modelo puede aprovechar señales de enfermedad ya presentes pero aún no codificadas; esto difiere de una verdadera predicción del riesgo a largo plazo. La transferencia entre tareas no puede darse por supuesta solo porque compartan el nombre de un modelo fundacional.[1] A foundation model for generalizable disease detection
3. Los flujos con una capa intermedia interpretable siguen necesitando validación externa
El trabajo sobre retina de De Fauw y colaboradores separa en capas la segmentación de tejidos y la decisión de derivación, y muestra el papel de los resultados intermedios interpretables en un sistema concreto, conservando también ejemplos ambiguos y de fallos. La capa intermedia facilita la inspección humana, pero no garantiza la ausencia de omisiones o errores. Este artículo recomienda evaluar por separado la calidad de imagen, la segmentación de tejidos, las decisiones posteriores y la gestión humana; cuando la capa intermedia sea incierta, el sistema debe conservar un estado indeterminado. Forzar la asignación de todas las imágenes anómalas a una categoría disfraza un fallo de medición de conclusión clínica cierta.[2] Clinically applicable deep learning for diagnosis and r
4. Derivación de este artículo: una misma sensibilidad y especificidad corresponden a distintos significados de un resultado positivo
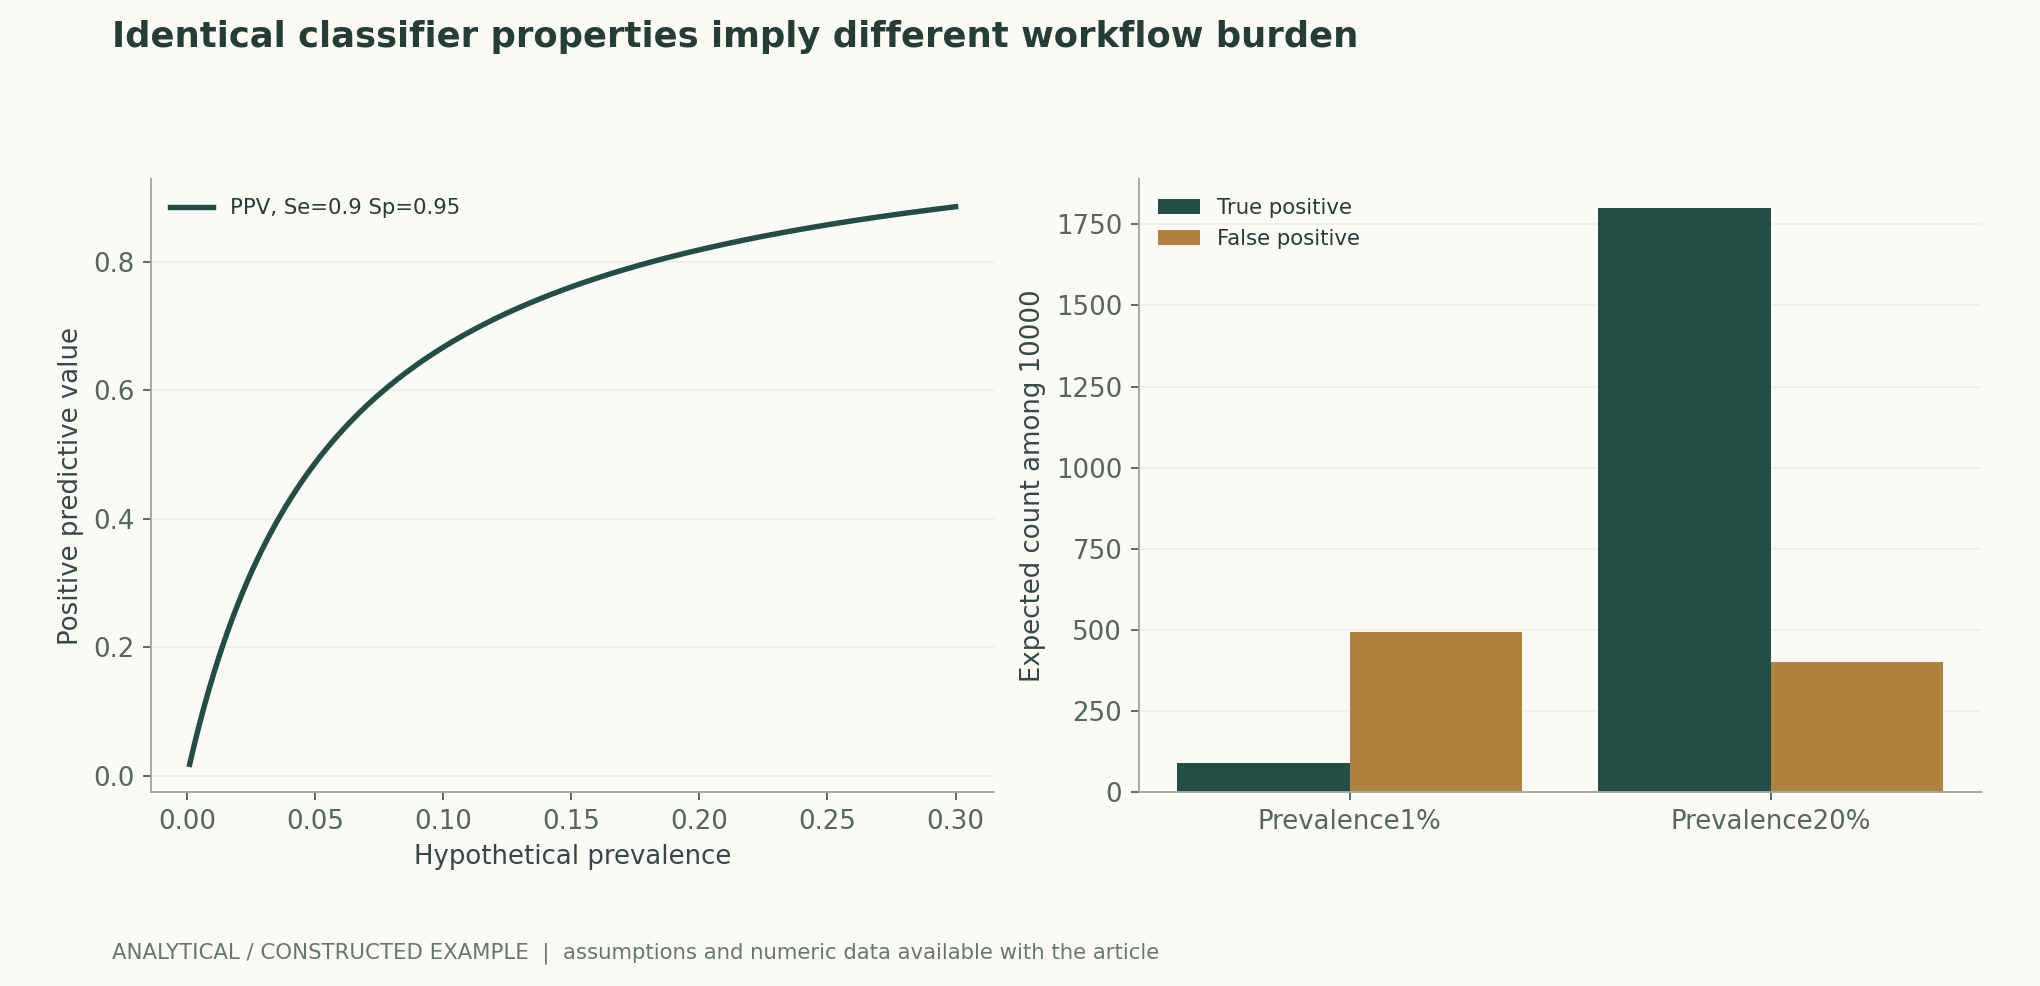
Considérese un clasificador con sensibilidad 0.9 y especificidad 0.95. Con una prevalencia de 1%, entre 10000 personas se esperan 90 verdaderos positivos y 495 falsos positivos, con un valor predictivo positivo aproximado de 15.4%; con una prevalencia de 20%, se esperan 1800 verdaderos positivos y 400 falsos positivos, con un valor predictivo positivo aproximado de 81.8%. Estas cifras no representan el rendimiento de RETFound ni recomendaciones reales de cribado; ilustran que la composición de la población externa modifica la carga del flujo de trabajo y la interpretación de los resultados positivos. Los resultados de muestras de casos y controles utilizadas en investigación no pueden tratarse directamente como los resultados efectivos en una población de baja prevalencia.作者分析与复核建议 / Author analysis
5. Discriminación, calibración y umbrales desempeñan funciones distintas
El AUC mide la discriminación relacionada con la ordenación, pero no garantiza que una puntuación determinada corresponda a una probabilidad concreta. La calibración de probabilidades debe comprobarse para cada tarea y población, mientras que el umbral depende además de los recursos del flujo de trabajo y del coste de los errores. Este artículo recomienda conservar las curvas ROC o PR, los diagramas de fiabilidad y las matrices de confusión con umbrales predefinidos, y proporcionar intervalos usando al paciente como unidad estadística. Si se vuelve a seleccionar el umbral en una nueva institución, este paso debe considerarse adaptación y debe mantenerse una prueba independiente; no es válido optimizarlo con todas las etiquetas externas y después denominarlo generalización sin ajustes.作者分析与复核建议 / Author analysis
6. La generalización externa debe someter a prueba activamente las diferencias entre dispositivos y poblaciones
La investigación sobre cambios de distribución muestra que el rendimiento dentro del entorno de entrenamiento no basta para garantizar la fiabilidad en entornos reales. Las tareas de retina pueden verse afectadas por los dispositivos, los procedimientos de adquisición, la calidad de imagen, el espectro de enfermedades y la selección de instituciones. Este artículo propone reservar conjuntos de prueba por dispositivo, institución y tiempo, y estratificar por calidad; cuando un grupo no tenga muestras suficientes, debe indicarse explícitamente que se desconoce su rendimiento, en lugar de sustituirlo por la media global. En el caso de ambos ojos o de visitas repetidas de un mismo paciente, debe evitarse suponer que las muestras son independientes. Los resultados por grupos también requieren considerar la coherencia de las definiciones de los criterios de valoración; los hábitos de codificación de distintas instituciones no pueden interpretarse directamente como diferencias biológicas.[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts[1] A foundation model for generalizable disease detection
7. Análisis de este artículo: la abstención y la derivación a revisión humana también son salidas del sistema
Si el modelo se abstiene de emitir resultados para algunas muestras de baja calidad o inciertas, puede reducir los errores entre las muestras aceptadas, pero también aumenta la carga de trabajo humana. Este artículo utiliza proporciones hipotéticas fijas para mostrar la relación entre cobertura, número de abstenciones y riesgo del procesamiento automático, y exige mantener a todas las personas atendidas en el denominador. Una estrategia de abstención no debe conservar únicamente el subconjunto más sencillo y después comunicar un rendimiento elevado; también debe comprobar si los casos con abstención se concentran en un dispositivo, una enfermedad o un grupo poblacional concretos. Un flujo de trabajo clínico necesita saber quién no recibió una respuesta y si esas personas fueron finalmente atendidas a tiempo.作者分析与复核建议 / Author analysis
8. La atribución de errores debe volver a la medición y al flujo de trabajo
Los fallos en la investigación sobre retina pueden deberse a la calidad de imagen, la segmentación, la ambigüedad de las etiquetas, la coexistencia de enfermedades o los umbrales posteriores. Este artículo recomienda construir un árbol de errores para cada caso y verificarlo mediante un muestreo independiente, en lugar de mostrar únicamente mapas de calor llamativos. Que un mapa de calor se concentre en vasos o regiones lesionadas tampoco demuestra que la base de decisión del modelo sea totalmente correcta; las marcas de los dispositivos, la información de los bordes u otras señales ajenas al objetivo pueden contribuir a la ordenación. Las conclusiones importantes deben contrastarse frente a explicaciones alternativas mediante perturbaciones de las entradas, dispositivos externos y anotaciones clínicas adecuadas, conservando los casos que no admitan una atribución unívoca.作者分析与复核建议 / Author analysis
9. De las métricas retrospectivas a los flujos de trabajo prospectivos
Los estudios retrospectivos permiten examinar la relación entre el modelo y las etiquetas ya recopiladas, mientras que los flujos prospectivos también incluyen fallos de adquisición, tiempos de espera, revisión humana y casos no procesados. Este artículo propone realizar primero una evaluación en modo sombra después de congelar el modelo, y luego comparar los flujos con criterios de valoración prerregistrados; los criterios principales deben corresponder a la pregunta de investigación, como la concordancia en las decisiones de derivación, la carga de trabajo o los desenlaces pertinentes, en lugar de asumir que una mejora del AUC implica beneficio para los pacientes. Cualquier estudio real del flujo de trabajo debe estar a cargo de los equipos profesionales correspondientes y ser verificado por ellos. Este artículo solo trata la estructura de evaluación y no ha ejecutado ni aprobado ninguna implementación clínica.作者分析与复核建议 / Author analysis
Suplemento técnico A · Objetivos de reconstrucción enmascarada y criterios de valoración clínicos
El aprendizaje autosupervisado con enmascaramiento obtiene señales de entrenamiento mediante la reconstrucción de partes de las imágenes, lo que favorece que las representaciones conserven estructuras predecibles, pero recuperar píxeles no exige comprender todos los factores clínicos. RETFound conecta el preentrenamiento con la adaptación etiquetada; las capacidades realmente pertinentes para la clínica siguen requiriendo validación en tareas posteriores. Este artículo recomienda examinar por separado las contribuciones del objetivo de preentrenamiento, las representaciones congeladas y el ajuste fino completo, comparándolas con el mismo presupuesto de etiquetas. Si las estadísticas simples de las imágenes ya explican la mayor parte de las ganancias, debe comunicarse fielmente, en lugar de atribuir todas las mejoras a un conocimiento médico general.[1] A foundation model for generalizable disease detection
Suplemento técnico B · El cambio de prevalencia difiere del cambio de concepto
Si solo cambia la proporción de casos y se mantiene la distribución de las imágenes condicionada al estado, algunas probabilidades pueden recalibrarse mediante un ajuste de las probabilidades a priori; si cambian los dispositivos, el espectro de enfermedades o las definiciones de las etiquetas, modificar únicamente las probabilidades a priori suele ser insuficiente. Este artículo recomienda comprobar primero qué tipo de cambio de distribución se ha producido y después decidir la adaptación. La evidencia de un sistema que funciona bien tras recalibrarse en una nueva institución debe describirse como evidencia con adaptación y no mezclarse con la generalización externa sin ajustes. Todos los ajustes requieren validación en un conjunto reservado independiente, para evitar ajustar y evaluar sobre las mismas etiquetas de prueba.作者分析与复核建议 / Author analysis
Suplemento técnico C · La colaboración entre modelos y personas no consiste en un simple promedio
Las indicaciones del modelo pueden modificar la atención humana, generar dependencia excesiva o provocar revisiones repetidas, por lo que el rendimiento del equipo no puede obtenerse sumando directamente las exactitudes independientes del modelo y de las personas. Este artículo propone registrar en los estudios del flujo de trabajo la decisión final, los motivos de modificación, el tiempo de procesamiento y los casos indeterminados, e incorporar las condiciones de visibilidad de las indicaciones al diseño del estudio. Los criterios principales de valoración deben comparar flujos reales, en lugar de tratar una puntuación aislada del modelo fuera del flujo operativo como si ya hubiera cambiado la conducta clínica. Las figuras explicativas también deben evaluarse por separado para determinar si ayudan a detectar errores, en vez de medir únicamente cuánto gustan a los usuarios.作者分析与复核建议 / Author analysis
Suplemento técnico D · Las tareas de seguimiento deben considerar el tiempo y la censura
La predicción de eventos futuros exige determinar quién entra en el conjunto en riesgo y cuándo, cuánto dura el seguimiento y cómo se tratan las pérdidas de seguimiento. Considerar libres de eventos a las personas con seguimiento breve, u obtener las imágenes solo después de que la enfermedad sea evidente, modifica la tarea. Este artículo recomienda fijar el momento índice y la ventana de predicción, registrar la censura y las visitas repetidas, y utilizar una evaluación compatible con el criterio de valoración. El AUC de una clasificación puntual no sustituye automáticamente a la evaluación del riesgo dependiente del tiempo. Los modelos fundacionales pueden aportar representaciones, pero no eliminan estas condiciones estadísticas del diseño de cohortes.作者分析与复核建议 / Author analysis
10. Conclusión: el valor de los modelos fundacionales debe materializarse en tareas concretas
El aprendizaje autosupervisado a gran escala ha aportado representaciones reutilizables a la imagen médica, pero las promesas científicas deben seguir vinculadas a una tarea y una población claramente definidas. Las derivaciones de prevalencia y carga de trabajo de este artículo muestran que la capacidad de ordenación, las probabilidades y los flujos de trabajo no son el mismo problema. Los resultados entregables verificables deben conservar las particiones por paciente, las condiciones externas, los umbrales, las abstenciones y los casos de fallo, y comunicar por separado la evidencia de cada adaptación. Esta estructura permite mostrar con precisión el valor de los modelos fundacionales y señalar a investigaciones posteriores qué mediciones adicionales siguen siendo necesarias para un uso clínico fiable.作者分析与复核建议 / Author analysis
Ecuaciones y derivaciones fundamentales
(1) La prevalencia π y las condiciones de clasificación determinan conjuntamente el valor predictivo positivo; los parámetros de la figura son totalmente hipotéticos.
LaTeX
\operatorname{PPV}=\frac{\operatorname{Se}\,\pi}{\operatorname{Se}\,\pi+(1-\operatorname{Sp})(1-\pi)}(2) Número esperado de resultados positivos suponiendo que todas las personas puedan clasificarse; no es una recomendación de derivación clínica.
LaTeX
N_{\mathrm{positive}}=N[\operatorname{Se}\,\pi+(1-\operatorname{Sp})(1-\pi)](3) Puntuación cuadrática de las predicciones probabilísticas; por sí sola no sustituye a la calibración por grupos ni a los criterios de valoración del flujo de trabajo clínico.
LaTeX
\operatorname{Brier}=\frac1N\sum_i(p_i-y_i)^2(4) Cobertura y riesgo entre los casos aceptados con una estrategia de abstención; también debe contabilizarse la gestión posterior de los casos con abstención.
LaTeX
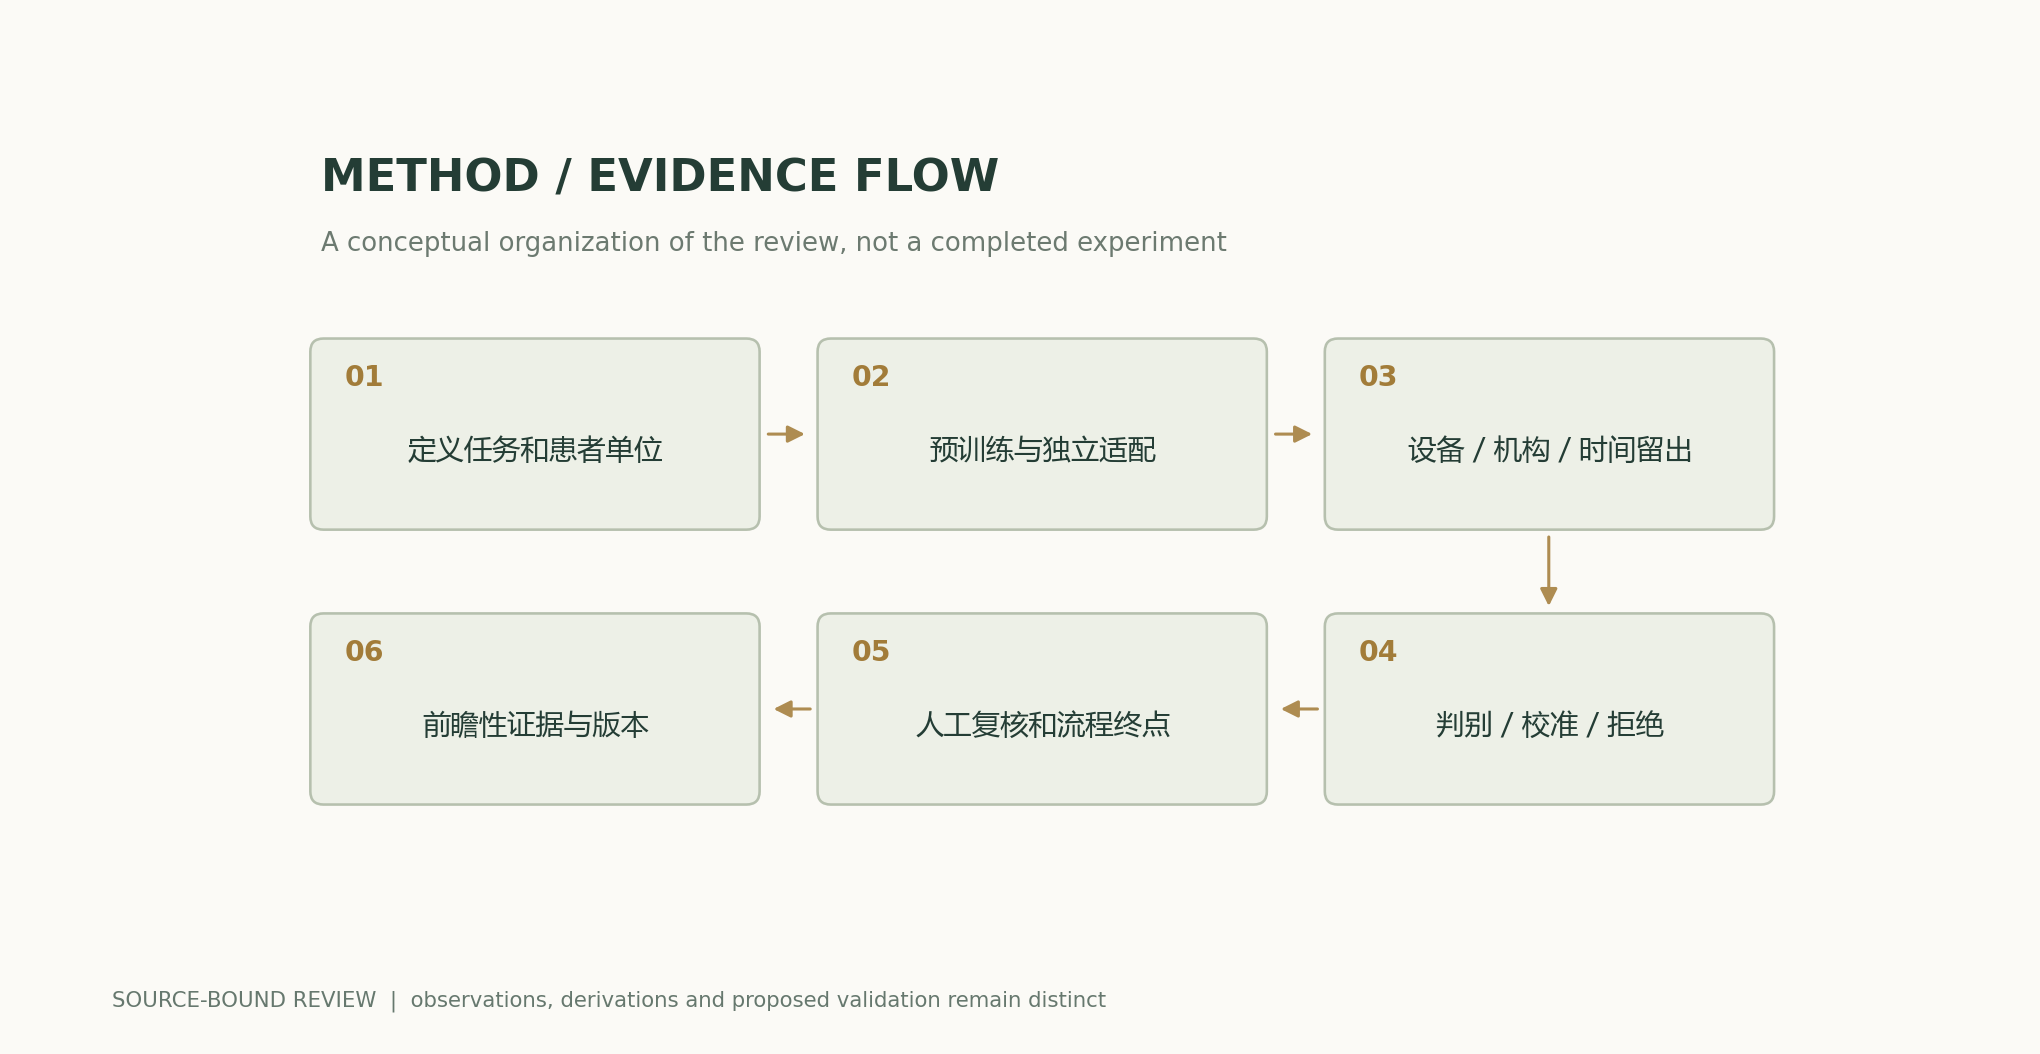
\operatorname{coverage}(\tau)=P(c(X)\ge\tau),\qquad R(\tau)=\mathbb E[\ell\mid c(X)\ge\tau]Flujo metodológico y de evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto reproducible mediante recálculo
Prevalencia 1%: TP 90, FP 495, PPV≈0.153846; prevalencia 20%: TP 1800, FP 400, PPV≈0.818182. Son únicamente recuentos esperados.
Comparación de métodos
| Afirmación | Evidencia adecuada | No puede sustituir a |
|---|---|---|
| Eficiencia en el uso de etiquetas | Curvas de aprendizaje con presupuestos de adaptación igualados | Generalización a todas las poblaciones |
| Ordenación según enfermedad | AUC / PR con independencia a nivel de paciente | Calibración de probabilidades absolutas |
| Probabilidades interpretables | Fiabilidad externa y muestras estratificadas | Que los umbrales del flujo de trabajo ya sean adecuados |
| Gestión de imágenes de baja calidad | Abstención, revisión y denominador completo | Comunicar solo el subconjunto sencillo |
| Fiabilidad externa | Conjuntos reservados por dispositivo / institución / tiempo | División aleatoria de imágenes de la misma fuente |
| Valor clínico | Flujos prospectivos y criterios de valoración pertinentes | Mejora retrospectiva del AUC |
Plan de verificación y experimentación
- Fijar las etiquetas, la ventana temporal, el modelo y las reglas de calidad de las entradas para cada tarea de adaptación.
- Separar entrenamiento y prueba por paciente, no por imagen, conservando las relaciones entre ambos ojos y entre visitas repetidas.
- Igualar los presupuestos de adaptación y ajuste de hiperparámetros, y documentar el solapamiento entre los datos de preentrenamiento y los externos.
- Reservar conjuntos y estratificar por separado según dispositivos, instituciones, tiempo y poblaciones.
- Comunicar conjuntamente discriminación, calibración, umbrales predefinidos y cobertura bajo abstención.
- Incluir todos los fallos de adquisición y los casos indeterminados en el denominador del flujo de trabajo.
- Establecer criterios de valoración específicos del flujo para los estudios en modo sombra o prospectivos, bajo la responsabilidad de un equipo de investigación profesional.
- Publicar estadísticas desidentificadas y reglas de análisis; las cifras construidas en este artículo no se destinan a decisiones médicas individuales.
Ámbito de aplicación y limitaciones
- No hay datos de pacientes ni pruebas reales de modelos médicos.
- La sensibilidad y la especificidad son valores supuestos, no resultados de RETFound.
- Las distintas tareas y criterios de valoración del seguimiento no pueden combinarse en un rendimiento diagnóstico general.
- Los cambios de distribución y el sesgo de las etiquetas pueden coexistir.
- Este artículo no constituye una recomendación de diagnóstico, tratamiento o implementación clínica.
Evidencia de los estudios originales y ámbito de aplicación
| Resultados de los estudios originales | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| Preentrenamiento con aproximadamente 160 decenas de millar de imágenes de retina no etiquetadas y adaptación a varios tipos de tareas. | El número de imágenes no equivale al de pacientes independientes ni a una validación clínica universal. | Un modelo fundacional para la detección generalizable de enfermedades a partir de imágenes de retinaResumen; desarrollo y evaluación del modelo |
| Apoya las decisiones de derivación por patología retiniana mediante una capa intermedia de segmentación y muestra casos de fallo. | La configuración de un estudio concreto no puede transferirse automáticamente a todos los dispositivos y poblaciones. | Aprendizaje profundo aplicable clínicamente al diagnóstico y la derivación en enfermedades de la retinaMétodo; ambigüedades y casos de fallo en el material suplementario |
Preguntas de investigación que merece la pena contrastar
- Tras igualar los presupuestos de etiquetas y adaptación, ¿en qué dispositivos externos se mantienen las ganancias?
- ¿La estrategia de abstención traslada la carga de trabajo de manera desproporcionada a determinados grupos?
- ¿Puede una mejora de la discriminación aportar beneficios sustanciales en un flujo prospectivo con umbrales congelados?
Correspondencia entre fuentes primarias y afirmaciones
- A foundation model for generalizable disease detection from retinal imagesZhou et al. · 2023-09-131.6 million unlabeled retinal images; task-specific adaptation and diagnosis/prognosis evaluation.
- Clinically applicable deep learning for diagnosis and referral in retinal diseaseDe Fauw et al. · 2018-08-13Device-independent tissue segmentation and referral classification; ambiguities and failure examples.
- WILDS: A Benchmark of in-the-Wild Distribution Shifts, , , , , , , , , , , , , , , , , , , , , , -------------------------------------------------------------------------------- · 2020-12-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autoría, versión y fuentes
Revisión de investigaciones documentada con fuentes y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a sus equipos de investigación; los cálculos de este artículo solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio aún no dispone de registros de revisión por pares independiente de este artículo ni de experimentos originales con modelos, clínicos o físicos.
Primera publicación: monográfico en profundidad sobre IA y descubrimiento científico; se mantienen, sección por sección, los límites entre fuentes, evidencia de los estudios originales y análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos adjuntos; sus leyendas detallan los supuestos y las definiciones de medición para cada elemento.
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Python · Código para reproducir los cálculos · Historial de publicación y versiones
Revisión de la fuente: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c