
摘要
RETFound 以大规模未标注视网膜图像学习表征,再适配疾病相关任务,展示了医学自监督学习的潜力。然而标签效率、判别能力、概率校准与临床收益是不同终点。本文结合早期视网膜转诊系统研究,建立从表征到外部验证和工作流的证据框架。通过假定敏感度、特异度与患病率,我们计算阳性预测值和转诊负荷的变化,解释为什么一个优秀分数不能独立决定部署价值。全文没有使用患者数据,不提供个体诊断或治疗建议。[1] A foundation model for generalizable disease detection [2] Clinically applicable deep learning for diagnosis and r
English abstract
Retinal foundation models learn reusable representations, but clinical value requires task-specific external validation and workflow evidence. We examine RETFound and a retinal referral system, then derive how prevalence changes positive predictive value and how uncertain cases alter workload. A hypothetical confusion-matrix example separates discrimination, calibration and operational burden. The analysis contains no patient data and is not a diagnostic or treatment recommendation.
1. 自监督预训练解决标签利用,不自动解决全部临床问题
RETFound 原文利用约 160 万未标注图像学习可适配表征,并在有标签任务上进行评估。这表明无标签数据能够支持多种下游任务,但预训练样本数量不是独立患者数,也不等于所有病种、设备和人群已验证。本文建议同时记录图像、眼、患者、就诊与机构四种单位,避免同一患者多幅图像跨训练测试。标签效率的比较还需匹配适配预算、输入质量和任务定义,而不是只比较最终 AUC。[1] A foundation model for generalizable disease detection
2. 表征、眼部病变与全身风险是不同目标
从视网膜图像预测眼部状态与预测未来全身事件,需要不同标签、随访和混杂控制。RETFound 探索多类任务,结论仍绑定各自样本与终点。本文主张为每个模型适配版本建立单独任务卡:观察窗口、结局定义、删失处理、标签来源与排除标准。若图像时间接近结局,模型可能利用已存在但尚未编码的疾病信号;这与真正长期风险预测不同。跨任务迁移不能凭共享基础模型名称推定。[1] A foundation model for generalizable disease detection
3. 具有解释中间层的流程仍需要外部验证
De Fauw 等人的视网膜工作把组织分割与转诊判断分层,展示了可解释中间结果在特定系统中的作用,也保留模糊和失败例子。中间层有助于人类检查,但不能保证没有遗漏或错误。本文建议将图像质量、组织分割、下游判断和人工处理分别评估;当中间层不确定时,系统应保留不可判定状态。把所有异常图像强行分到一个类别,会将测量故障伪装成确定临床结论。[2] Clinically applicable deep learning for diagnosis and r
4. 本文推导:同一敏感度和特异度对应不同阳性意义
构造敏感度 0.9、特异度 0.95 的分类器。患病率为 1% 时,10000 人中期望真阳性 90、假阳性 495,阳性预测值约 15.4%;患病率为 20% 时,期望真阳性 1800、假阳性 400,阳性预测值约 81.8%。这些数字不是 RETFound 的性能,也不是实际筛查建议;它们说明外部人群构成会改变工作流负荷和阳性解释。不能把研究病例对照样本中的结果直接当成低患病率人群中的实际产出。作者分析与复核建议 / Author analysis
5. 判别、校准与阈值各有不同职责
AUC 衡量排序相关的判别能力,不提供某个分数就是多大概率的保证。概率校准需在任务与人群上检验,阈值则还取决于流程资源与错误代价。本文建议同时保存 ROC 或 PR 曲线、可靠性图及预定阈值下的混淆矩阵,并以患者为统计单位给区间。若在新机构重新选择阈值,应把这一步视为适配并保留独立测试,不能在全部外部标签上调到最好再称其为无调整泛化。作者分析与复核建议 / Author analysis
6. 外部泛化要主动挑战设备与人群差异
分布变化研究说明训练环境内的表现不足以保证真实环境可靠。视网膜任务可能受设备、成像流程、图像质量、疾病谱和机构选择影响。本文提出设备与机构留出、时间留出和质量分层;某一组没有足够样本时,应明确未知,而不是用总体均值代替。对同一患者的两眼或重复就诊,应避免独立样本假设。分组结果还需考虑终点定义一致性,不能把不同机构的编码习惯直接当成生物差异。[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts[1] A foundation model for generalizable disease detection
7. 本文分析:拒绝与转人工也属于系统输出
如果模型拒绝一部分低质量或不确定样本,可以降低已接受样本中的错误,但也增加人工负荷。本文以固定假定比例展示覆盖率、拒绝量和自动处理风险之间的关系,并要求把全部来访对象保留在分母。拒绝策略不能只留下最容易的子集再报告高性能;还应检查被拒人群是否集中于某设备、疾病或群体。一个临床工作流需要知道谁没有得到答案,以及这些对象最后是否被及时处理。作者分析与复核建议 / Author analysis
8. 错误归因应回到测量和流程
视网膜研究中的失败可能来自图像质量、分割、标签歧义、疾病共存或下游阈值。本文建议建立逐例错误树,并在独立抽样中核对,而不是只展示显著热图。热图在血管或病变区域聚焦,也不证明模型依据完全正确;设备标记、边缘信息或其他非目标线索可能参与排序。对重要结论,应通过输入扰动、外部设备和适当临床标注检验替代解释,保留不能唯一归因的情况。作者分析与复核建议 / Author analysis
9. 从回顾性指标到前瞻性工作流
回顾性研究可检验模型与已收集标签的关系,前瞻性流程还涉及采集失败、等待时间、人工复核和漏处理。本文提出在模型冻结后先做影子评估,再以预注册终点比较流程;主要终点应与研究问题相符,例如转诊判断一致性、工作量或相关结局,而不是默认 AUC 改善即患者获益。任何实际流程研究都应由相应专业团队负责并核验。本文只讨论评价结构,没有执行或批准临床部署。作者分析与复核建议 / Author analysis
技术补充 A · 掩码重建目标与临床终点
自监督掩码学习通过部分图像恢复训练信号,鼓励表征保留可预测结构,但恢复像素并不要求理解所有临床因素。RETFound 将预训练与有标签适配连接,真正的临床相关能力仍由下游任务验证。本文建议分别检查预训练目标、冻结表征和完整微调的贡献,并在相同标签预算下比较。若简单图像统计已经能解释大部分增益,应据实报告,而不是把所有提升都归于通用医学知识。[1] A foundation model for generalizable disease detection
技术补充 B · 患病率变动与概念变动不同
如果只有病例比例变化,而给定状态下的图像分布保持,某些概率可通过先验调整重新校准;若设备、疾病谱或标签定义改变,单纯改先验通常不足。本文建议先检验是哪一种分布变化,再决定适配。一个在新机构重校准后表现良好的系统,其证据应称为经过适配,不应混入无调整外部泛化。所有调整需要独立留出验证,避免在测试标签上拟合又评价。作者分析与复核建议 / Author analysis
技术补充 C · 模型与人工协作不是简单取平均
人类可能因模型提示改变注意、过度依赖或反复复核,所以团队表现不能由模型与人类的独立准确率直接相加。本文提出在工作流研究中记录最终决定、修改原因、处理时间与不可判定,并将提示可见条件作为研究设计的一部分。主要终点应比较真实流程,而不是把一次离线模型分数假装成已改变临床行为。解释图也需单独检验是否帮助发现错误,而不是只测用户喜欢程度。作者分析与复核建议 / Author analysis
技术补充 D · 随访任务要处理时间与删失
预测未来事件涉及谁在何时进入风险集、随访多久以及失访如何处理。若短随访对象被当成未发生事件,或图像在疾病已明显后才获取,就会改变任务。本文建议固定索引时间和预测窗口,记录删失与重复就诊,使用与终点相容的评价。单次分类 AUC 不能自动替代时间相关风险评价。基础模型可以提供表示,但不能消除数据队列设计中的这些统计条件。作者分析与复核建议 / Author analysis
10. 结论:基础模型价值要由具体任务兑现
大规模自监督学习为医学影像带来了可复用表示,但科学承诺仍应落实到某个明确任务和人群。本文的患病率与工作量推导说明,排序能力、概率与流程不是同一个问题。可复核交付应保存患者层划分、外部条件、阈值、拒绝和失败病例,并为每项适配单独报告证据。这样的结构既能准确展示基础模型的价值,也能让后续研究知道距离可靠临床使用还需要补充哪种测量。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 患病率 π 与分类条件共同决定阳性预测值;图中参数纯属假定。
LaTeX
\operatorname{PPV}=\frac{\operatorname{Se}\,\pi}{\operatorname{Se}\,\pi+(1-\operatorname{Sp})(1-\pi)}(2) 假设所有对象可分类时的期望阳性数量,不是临床转诊建议。
LaTeX
N_{\mathrm{positive}}=N[\operatorname{Se}\,\pi+(1-\operatorname{Sp})(1-\pi)](3) 概率预测的平方评分,不能单独替代分组校准和临床流程终点。
LaTeX
\operatorname{Brier}=\frac1N\sum_i(p_i-y_i)^2(4) 拒绝策略的覆盖与已接受风险;还需统计被拒对象的后续处理。
LaTeX
\operatorname{coverage}(\tau)=P(c(X)\ge\tau),\qquad R(\tau)=\mathbb E[\ell\mid c(X)\ge\tau]方法与证据流程
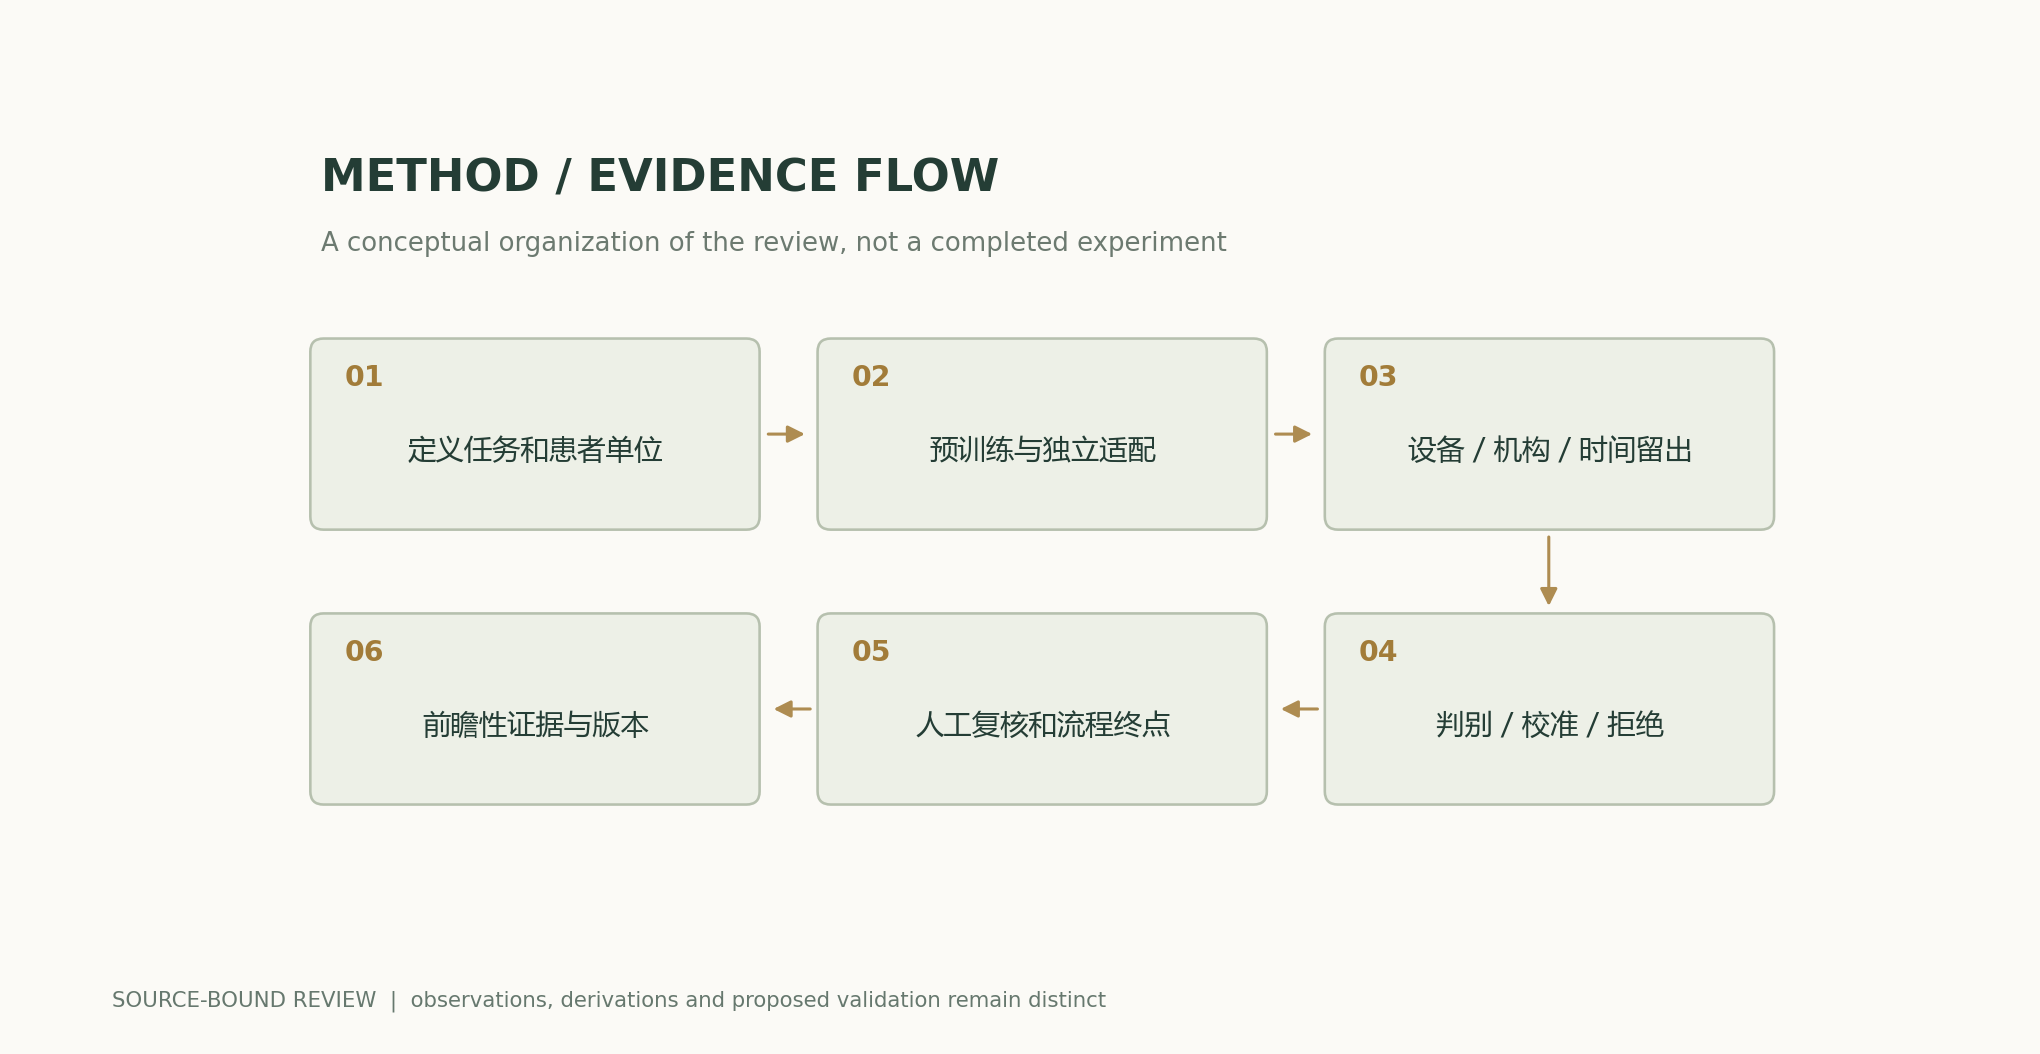
解析图与数值示例
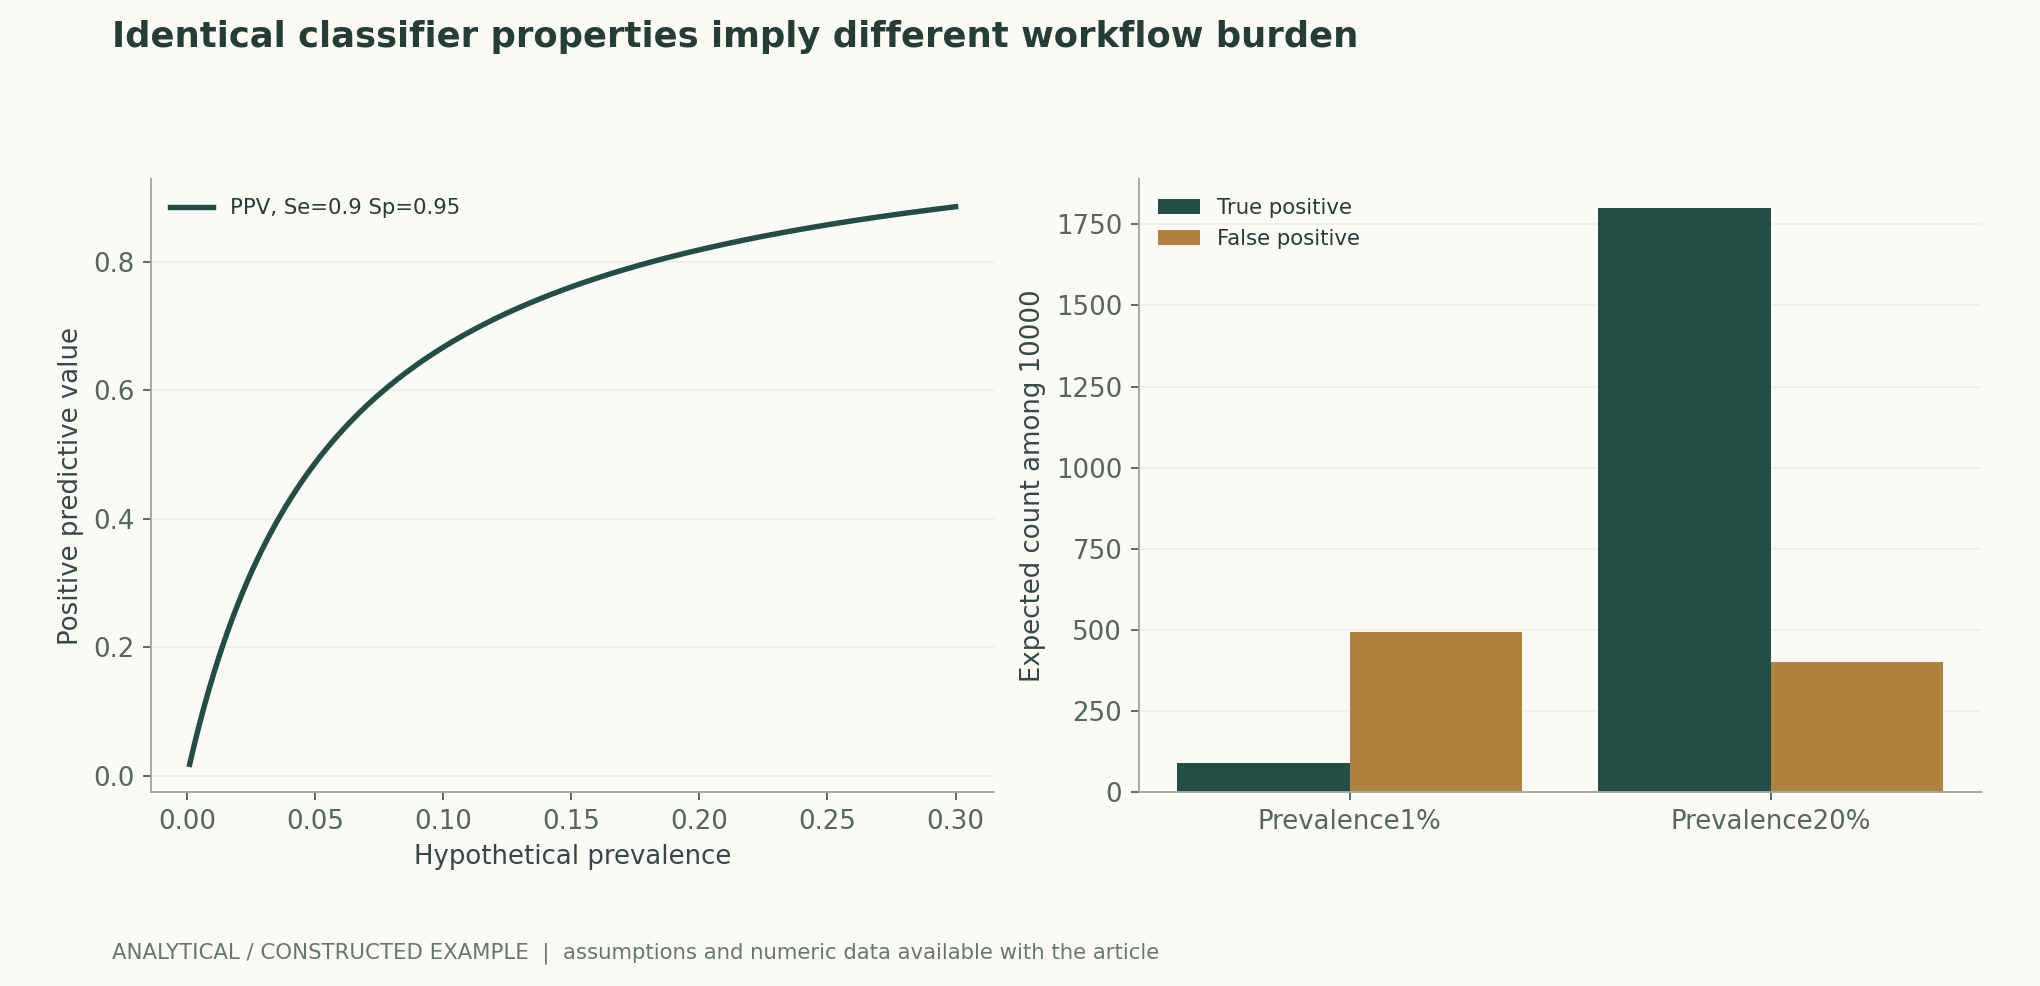
可复算例题
患病率1%:TP90、FP495、PPV≈0.153846;患病率20%:TP1800、FP400、PPV≈0.818182。这些只是期望计数。
方法比较
| 主张 | 适当证据 | 不能替代 |
|---|---|---|
| 标签效率 | 匹配适配预算的学习曲线 | 全部人群泛化 |
| 疾病排序 | 患者层独立 AUC / PR | 绝对概率校准 |
| 概率可解释 | 外部可靠性与分层样本 | 流程阈值已合理 |
| 低质图像处理 | 拒绝、复核与全分母 | 只报容易子集 |
| 外部可靠 | 设备 / 机构 / 时间留出 | 同源图像随机切分 |
| 临床价值 | 前瞻性流程和相关终点 | 回顾性 AUC 提高 |
复核与实验方案
- 为每个适配任务固定标签、时间窗口、模型与输入质量规则。
- 按患者而非图像隔离训练测试,保留双眼和重复就诊关系。
- 匹配适配与调参预算,记录预训练数据与外部数据重叠。
- 在设备、机构、时间与人群上分别留出和分层。
- 同时报告判别、校准、预定阈值与拒绝覆盖。
- 全部采集失败和不可判定进入工作流分母。
- 影子或前瞻性研究另设流程终点,由专业研究团队负责。
- 公开去标识化统计与分析规则;本文构造数字不用于个人医疗判断。
适用范围与局限
- 没有患者数据或实际医学模型测试。
- 敏感度和特异度是假定值,不是 RETFound 结果。
- 不同任务与随访终点不能合并为通用诊断性能。
- 分布变化与标签偏差可能同时存在。
- 本文不构成诊断、治疗或临床部署建议。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 以约 160 万未标注视网膜图像预训练并适配多类任务。 | 图像数量不是独立患者数或普适临床验证。 | A foundation model for generalizable disease detection from retinal imagesAbstract; model development and evaluation |
| 以分割中间层支持视网膜转诊判断并展示失败案例。 | 具体研究设置不能自动迁移到全部设备和人群。 | Clinically applicable deep learning for diagnosis and referral in retinal diseaseMethod; supplementary ambiguities and failure cases |
值得检验的研究问题
- 匹配标签和适配预算后,收益在哪些外部设备上保持?
- 拒绝策略是否把工作量不成比例地转移给特定群体?
- 判别改善能否在冻结阈值的前瞻性流程中带来实质收益?
一手来源与主张对应
- A foundation model for generalizable disease detection from retinal imagesZhou et al. · 2023-09-131.6 million unlabeled retinal images; task-specific adaptation and diagnosis/prognosis evaluation.
- Clinically applicable deep learning for diagnosis and referral in retinal diseaseDe Fauw et al. · 2018-08-13Device-independent tissue segmentation and referral classification; ambiguities and failure examples.
- WILDS: A Benchmark of in-the-Wild Distribution Shifts, , , , , , , , , , , , , , , , , , , , , , -------------------------------------------------------------------------------- · 2020-12-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:AI与科学发现深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c