
要旨
RETFoundは、大規模なラベルなし網膜画像から表現を学習し、疾患関連の課題に適応させることで、医療における自己教師あり学習の可能性を示している。しかし、ラベル効率、識別能力、確率較正、臨床的利益は異なる評価項目である。本稿は、初期の網膜疾患紹介システムの研究も踏まえ、表現から外部検証、ワークフローまでをつなぐエビデンスの枠組みを構築する。感度、特異度、有病率を仮定して陽性的中率と紹介負荷の変化を計算し、優れたスコアだけでは導入の価値を決定できない理由を説明する。本稿は患者データを一切使用せず、個人に対する診断や治療の推奨も行わない。[1] A foundation model for generalizable disease detection [2] Clinically applicable deep learning for diagnosis and r
原文の英語要旨の日本語訳
網膜基盤モデルは再利用可能な表現を学習するが、その臨床的価値には、課題ごとの外部検証とワークフローに関するエビデンスが必要である。RETFoundと網膜疾患紹介システムを検討したうえで、有病率が陽性的中率をどのように変化させ、不確実な症例が業務量をどのように変えるかを導出する。仮想的な混同行列の例により、識別、較正、運用負荷を区別する。本分析には患者データは含まれず、診断や治療の推奨ではない。
1. 自己教師あり事前学習はラベル活用を改善するが、すべての臨床課題を自動的に解決するわけではない
RETFoundの原論文では、約160万枚のラベルなし画像を用いて適応可能な表現を学習し、ラベル付き課題で評価している。これは、ラベルなしデータが複数の下流課題を支えうることを示すが、事前学習サンプル数は独立した患者数ではなく、すべての疾患、装置、集団で検証済みであることも意味しない。本稿では、画像、眼、患者、受診、施設という四つの単位を同時に記録し、同一患者の複数画像が訓練とテストにまたがることを避けるよう提案する。ラベル効率の比較では、最終的なAUCだけを比較するのではなく、適応予算、入力品質、課題定義も揃える必要がある。[1] A foundation model for generalizable disease detection
2. 表現、眼病変、全身リスクは異なる対象である
網膜画像から眼の状態を予測することと、将来の全身的なイベントを予測することでは、必要なラベル、追跡、交絡制御が異なる。RETFoundは複数の種類の課題を探索しているが、その結論は依然として各課題のサンプルと評価項目に限定される。本稿は、モデルの各適応版について、観察期間、アウトカム定義、打ち切りの扱い、ラベルの出典、除外基準を記載する独立した課題カードを作成することを提唱する。画像取得時点がアウトカムに近い場合、モデルは既に存在するがまだコード化されていない疾患の信号を利用している可能性があり、これは真の長期リスク予測とは異なる。共通の基盤モデル名を持つというだけで、課題間の転移を推定することはできない。[1] A foundation model for generalizable disease detection
3. 解釈可能な中間層を備えたワークフローにも外部検証が必要である
De Fauwらの網膜研究は、組織セグメンテーションと紹介判断を階層化し、特定のシステムにおける解釈可能な中間結果の役割を示すとともに、曖昧な例や失敗例も保持している。中間層は人間による確認に役立つが、見落としや誤りがないことを保証するものではない。本稿では、画像品質、組織セグメンテーション、下流の判断、人手による対応を個別に評価し、中間層が不確実な場合には判定不能の状態を保持するよう提案する。異常な画像をすべていずれかのカテゴリに強制的に分類すると、測定上の失敗が確定的な臨床結論であるかのように見せかけられる。[2] Clinically applicable deep learning for diagnosis and r
4. 本稿の導出:同じ感度と特異度でも陽性の意味は異なる
感度0.9、特異度0.95の分類器を仮定する。有病率が1%の場合、10000人における期待真陽性数は90、期待偽陽性数は495で、陽性的中率は約15.4%となる。有病率が20%の場合、期待真陽性数は1800、期待偽陽性数は400で、陽性的中率は約81.8%となる。これらの数値はRETFoundの性能でも実際のスクリーニングの推奨でもなく、外部集団の構成がワークフローの負荷と陽性結果の解釈を変えることを示している。研究用の症例対照サンプルにおける結果を、低有病率集団で実際に得られる結果と直接みなしてはならない。作者分析与复核建议 / Author analysis
5. 識別、較正、閾値はそれぞれ異なる役割を担う
AUCは順位付けに関する識別能力を測定するが、あるスコアが特定の確率を意味することを保証しない。確率較正は課題と集団に即して検証する必要があり、閾値はさらにワークフローの資源と誤りのコストに依存する。本稿では、ROC曲線またはPR曲線、信頼度図、事前指定した閾値での混同行列を併せて保存し、患者を統計単位として区間を提示することを提案する。新たな施設で閾値を選び直す場合、この段階を適応とみなし、独立したテストを保持する必要がある。外部ラベルのすべてで最良となるよう調整した後に、それを無調整の汎化と呼んではならない。作者分析与复核建议 / Author analysis
6. 外部汎化では装置と集団の差異を積極的に検証する必要がある
分布変化の研究は、訓練環境内の性能だけでは実環境での信頼性を保証できないことを示している。網膜課題は、装置、撮像手順、画像品質、疾患スペクトラム、施設選択の影響を受けうる。本稿では、装置別・施設別のホールドアウト、時間的ホールドアウト、品質別の層別化を提案する。ある群のサンプルが不足する場合は、全体平均で代用せず、未知であることを明示するべきである。同一患者の両眼や反復受診については、独立サンプルの仮定を避ける必要がある。群別の結果では評価項目の定義の一貫性も考慮する必要があり、施設ごとのコード付与慣行を生物学的差異と直接みなしてはならない。[3] WILDS: A Benchmark of in-the-Wild Distribution Shifts[1] A foundation model for generalizable disease detection
7. 本稿の分析:判定保留と人手への引き継ぎもシステム出力である
モデルが低品質または不確実なサンプルの一部で判定を保留する場合、受理されたサンプルの誤りを減らしうるが、人手の負荷も増加する。本稿では、固定した仮定の割合を用いて、カバレッジ、判定保留数、自動処理リスクの関係を示し、すべての受診者を分母に残すことを求める。判定保留戦略によって最も容易な部分集合だけを残し、高性能を報告してはならない。また、判定保留となった集団が特定の装置、疾患、集団に偏っていないかを検討する必要がある。臨床ワークフローでは、誰が回答を得られなかったのか、そしてその対象者が最終的に適時に対応されたのかを把握する必要がある。作者分析与复核建议 / Author analysis
8. 誤りの原因帰属は測定とワークフローに立ち返るべきである
網膜研究における失敗は、画像品質、セグメンテーション、ラベルの曖昧さ、疾患の併存、下流の閾値に起因しうる。本稿では、目を引くヒートマップを示すだけでなく、症例ごとのエラーツリーを作成し、独立に抽出したサンプルで確認することを提案する。ヒートマップが血管や病変領域に集中していても、モデルの判断根拠が完全に正しいことの証明にはならない。装置の標識、辺縁情報、その他の非対象の手がかりが順位付けに寄与している可能性がある。重要な結論については、入力摂動、外部装置、適切な臨床アノテーションを通じて代替説明を検証し、一意に原因帰属できない事例を残すべきである。作者分析与复核建议 / Author analysis
9. 後ろ向き評価指標から前向きワークフローへ
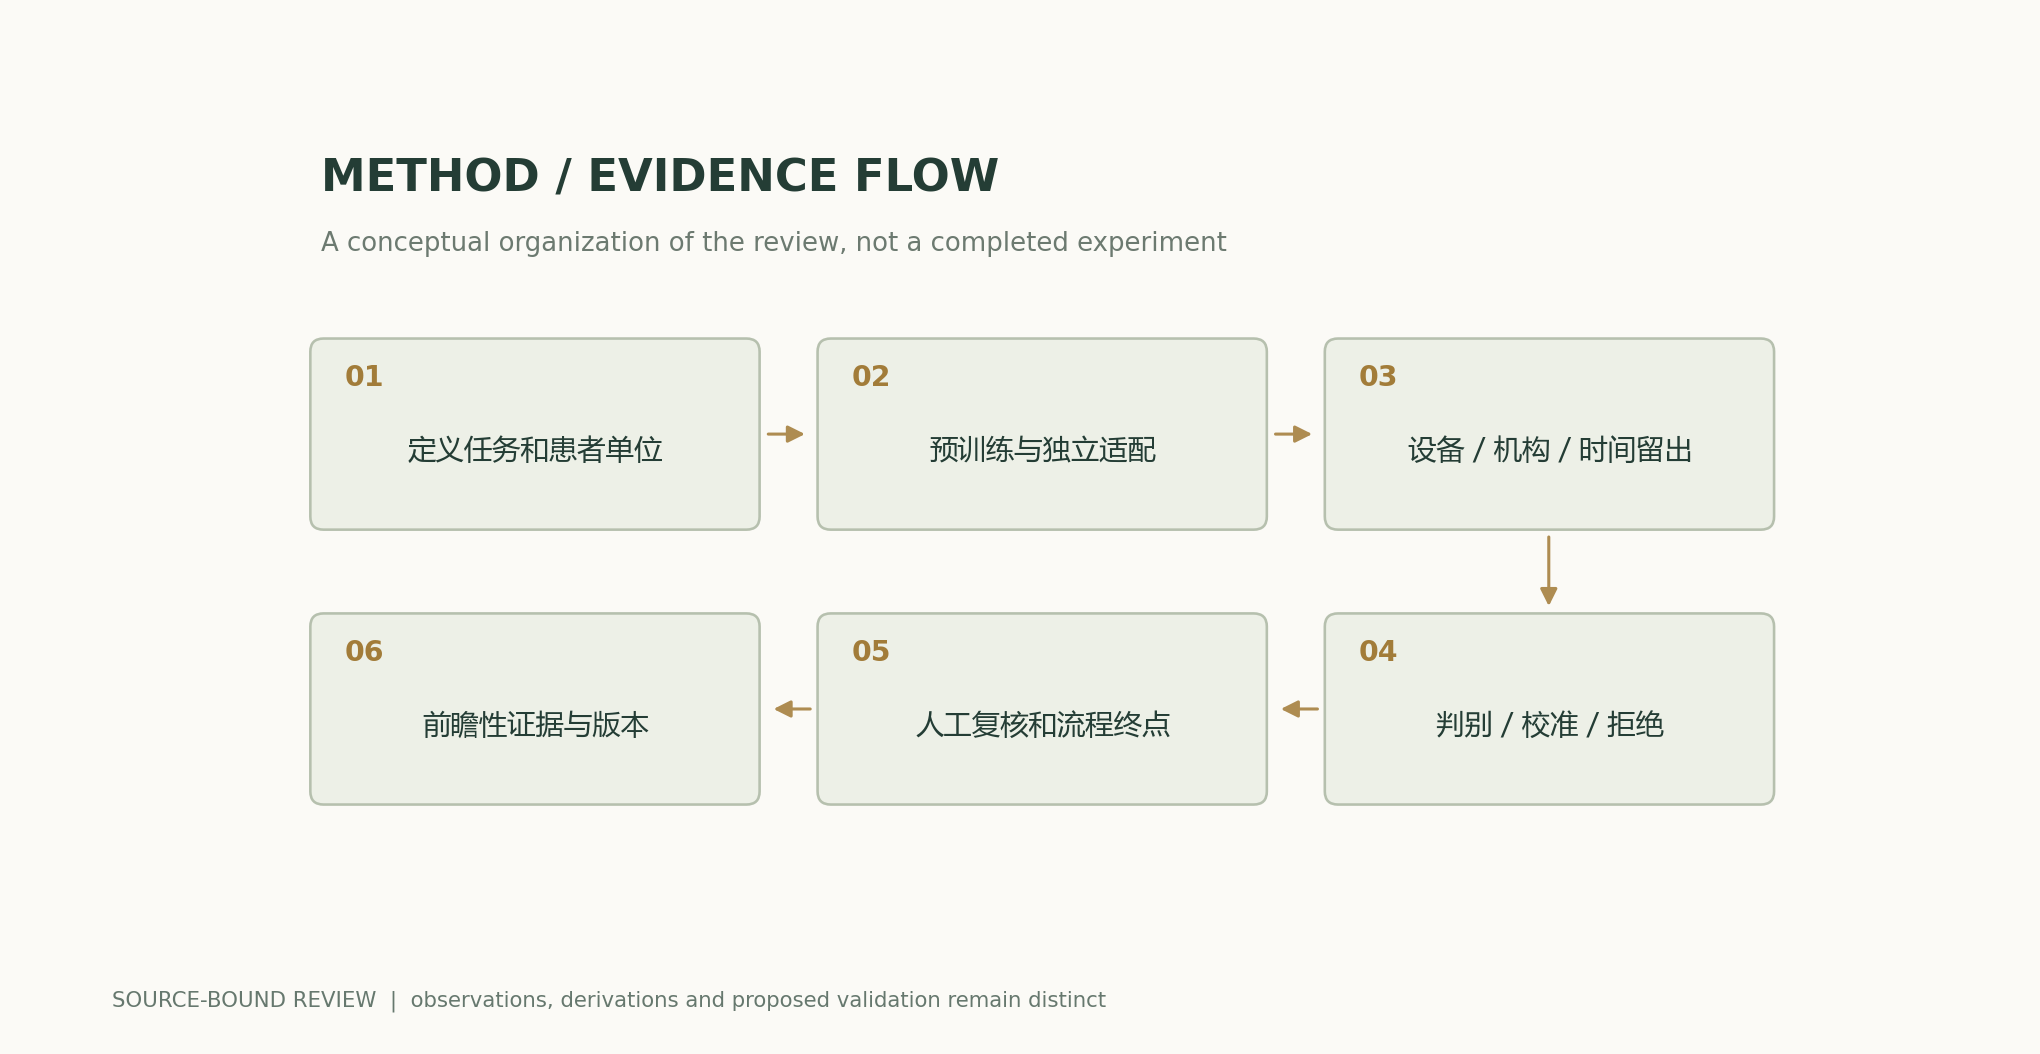
後ろ向き研究は、モデルと既に収集されたラベルとの関係を検証できるが、前向きワークフローには取得失敗、待ち時間、人手による再確認、未対応も含まれる。本稿では、モデルを固定した後にまずシャドー評価を行い、その後、事前登録した評価項目に基づいてワークフローを比較することを提案する。主要評価項目は、紹介判断の一致度、業務量、関連するアウトカムなど、研究課題に対応させるべきであり、AUCの改善を患者利益と当然視してはならない。実際のワークフロー研究は、いずれも適切な専門チームが責任を持って実施し、検証する必要がある。本稿は評価構造のみを論じており、臨床導入を実行または承認していない。作者分析与复核建议 / Author analysis
技術補足 A · マスク再構成目的と臨床評価項目
自己教師ありマスク学習は、画像の一部の復元を通じて訓練信号を得て、予測可能な構造を表現に保持させるが、画素の復元にはすべての臨床要因の理解が必要なわけではない。RETFoundは事前学習をラベル付き適応につなぐが、真に臨床的に関連する能力は依然として下流課題によって検証される。本稿では、事前学習目的、固定した表現、全面的なファインチューニングの寄与を個別に調べ、同一のラベル予算で比較することを提案する。単純な画像統計だけで改善の大部分を説明できる場合は、すべての向上を汎用的な医学知識に帰属させず、その事実を正確に報告するべきである。[1] A foundation model for generalizable disease detection
技術補足 B · 有病率の変化と概念の変化は異なる
症例の割合だけが変わり、状態を条件とした画像分布が維持される場合、一部の確率は事前確率の調整によって再較正できる。一方、装置、疾患スペクトラム、ラベル定義が変化した場合、事前確率の変更だけでは通常不十分である。本稿では、まず分布変化の種類を検証してから適応を決めることを提案する。新施設で再較正した後に良好な性能を示すシステムのエビデンスは、適応後のものと記述すべきであり、無調整の外部汎化と混同してはならない。すべての調整には独立したホールドアウト検証が必要であり、同じテストラベルで適合と評価を行うことを避ける必要がある。作者分析与复核建议 / Author analysis
技術補足 C · モデルと人間の協働は単純な平均ではない
人間はモデルの提示によって注意の向け方を変えたり、過度に依存したり、確認を繰り返したりする可能性があるため、チームの性能はモデルと人間の単独の正解率を直接足し合わせて求められるものではない。本稿では、ワークフロー研究において最終判断、修正理由、処理時間、判定不能を記録し、提示情報の可視性に関する条件を研究デザインに組み込むことを提案する。主要評価項目では実際のワークフローを比較すべきであり、一度のオフラインモデル評価のスコアを、既に臨床行動を変えたかのように扱ってはならない。説明図についても、ユーザーの好感度だけを測るのではなく、誤りの発見に役立つかを個別に検証する必要がある。作者分析与复核建议 / Author analysis
技術補足 D · 追跡課題では時間と打ち切りを扱う必要がある
将来のイベントの予測では、誰がいつリスク集合に入るのか、どの程度追跡するのか、追跡不能をどう扱うのかが関わる。追跡期間の短い対象者をイベント未発生とみなしたり、疾患が既に明らかになってから画像を取得したりすると、課題自体が変わる。本稿では、起点時刻と予測期間を固定し、打ち切りと反復受診を記録し、評価項目に適合した評価を用いることを提案する。単一時点の分類AUCが時間依存のリスク評価を自動的に代替するわけではない。基盤モデルは表現を提供できるが、データのコホート設計におけるこれらの統計的条件を取り除くことはできない。作者分析与复核建议 / Author analysis
10. 結論:基盤モデルの価値は具体的な課題で実現される必要がある
大規模な自己教師あり学習は医用画像に再利用可能な表現をもたらしたが、科学的な期待は依然として明確な課題と集団に結び付ける必要がある。本稿の有病率と業務量の導出は、順位付け能力、確率、ワークフローが同一の問題ではないことを示す。検証可能な成果物には、患者単位の分割、外部条件、閾値、判定保留、失敗症例を保存し、適応ごとにエビデンスを個別に報告するべきである。この構造は基盤モデルの価値を正確に示すと同時に、信頼できる臨床利用に向けてどのような測定を追加すべきかを後続研究に伝えることができる。作者分析与复核建议 / Author analysis
主要な数式と導出
(1) 有病率πと分類条件が共同で陽性的中率を決定する。図中のパラメータはすべて仮定である。
LaTeX
\operatorname{PPV}=\frac{\operatorname{Se}\,\pi}{\operatorname{Se}\,\pi+(1-\operatorname{Sp})(1-\pi)}(2) すべての対象者を分類できると仮定した場合の期待陽性数であり、臨床的な紹介の推奨ではない。
LaTeX
N_{\mathrm{positive}}=N[\operatorname{Se}\,\pi+(1-\operatorname{Sp})(1-\pi)](3) 確率予測の二乗誤差に基づくスコアであり、単独で群別の較正や臨床ワークフローの評価項目に代わるものではない。
LaTeX
\operatorname{Brier}=\frac1N\sum_i(p_i-y_i)^2(4) 判定保留戦略のカバレッジと受理例におけるリスク。判定保留となった対象者のその後の対応も集計する必要がある。
LaTeX
\operatorname{coverage}(\tau)=P(c(X)\ge\tau),\qquad R(\tau)=\mathbb E[\ell\mid c(X)\ge\tau]方法とエビデンスのフロー
解析図と数値例
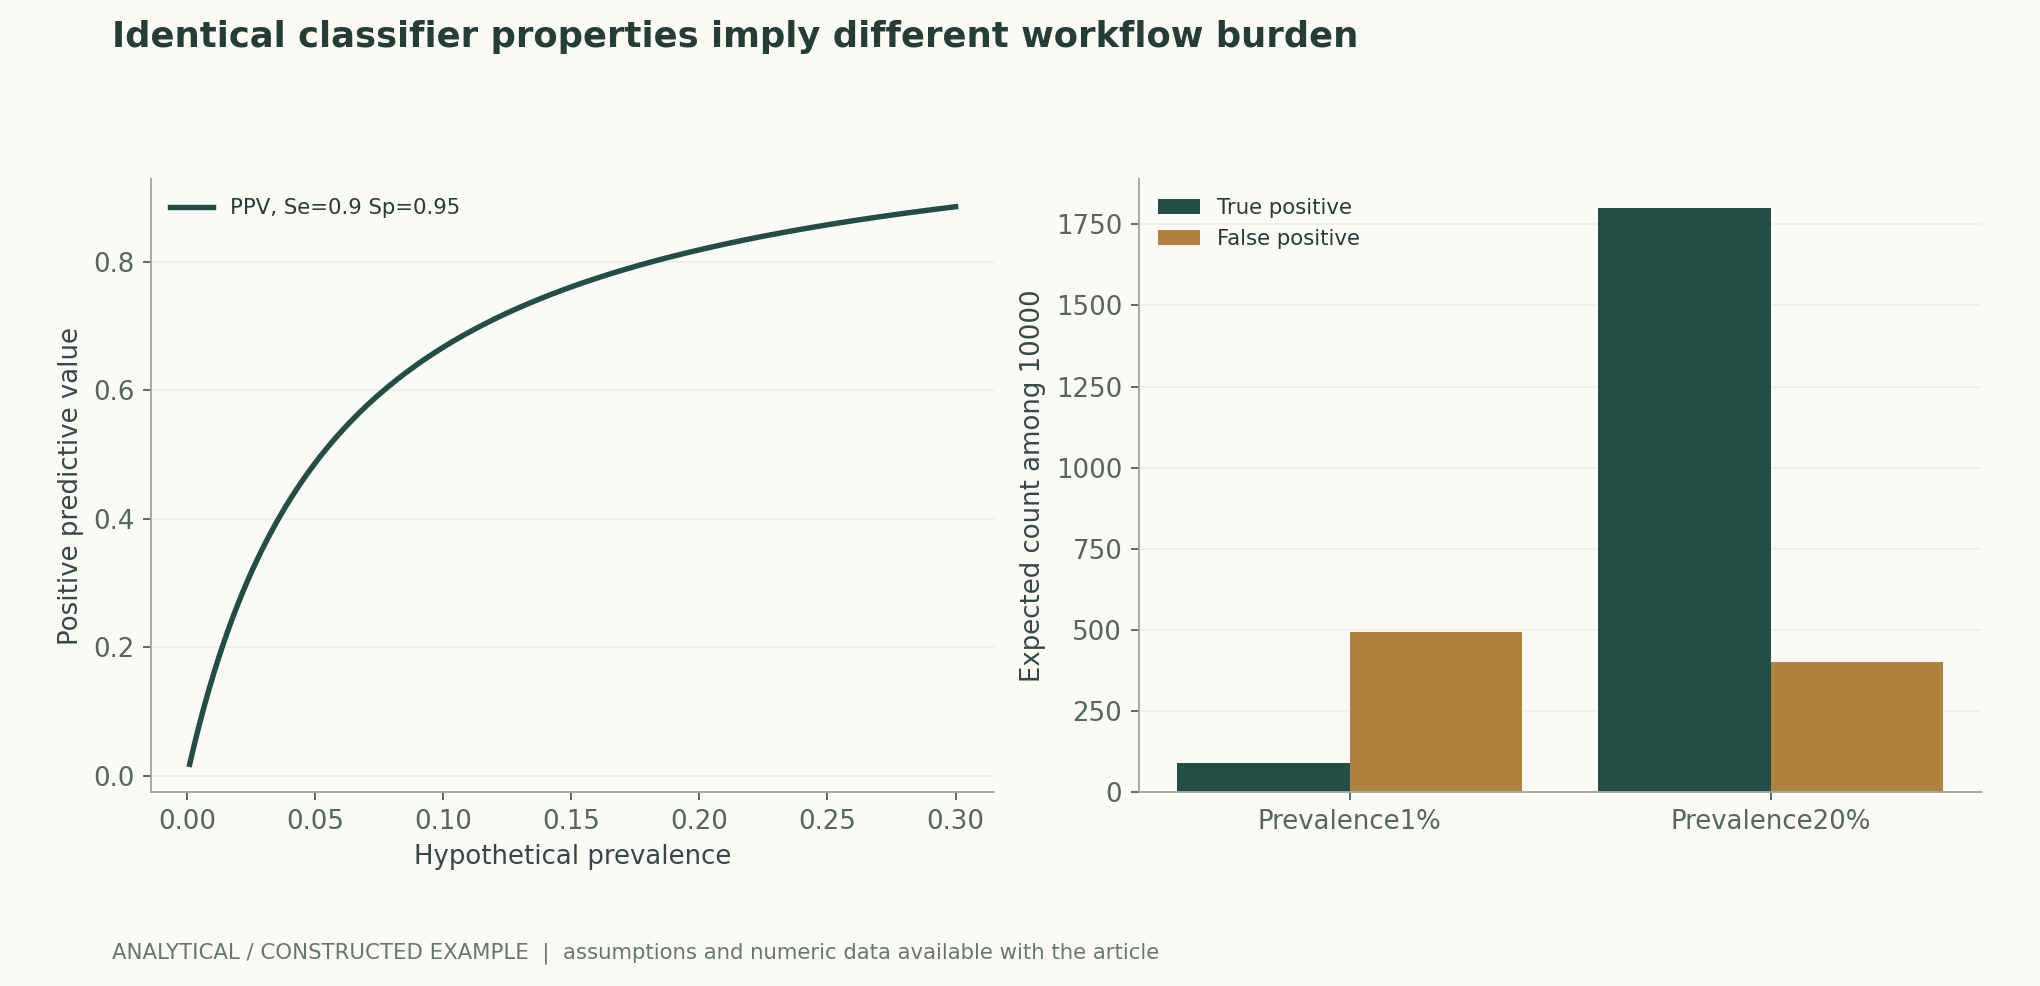
再計算可能な例題
有病率1%:TP 90、FP 495、PPV≈0.153846。有病率20%:TP 1800、FP 400、PPV≈0.818182。これらは期待件数にすぎない。
方法の比較
| 主張 | 適切なエビデンス | 代替できないもの |
|---|---|---|
| ラベル効率 | 適応予算を揃えた学習曲線 | すべての集団への汎化 |
| 疾患の順位付け | 患者単位の独立性を確保したAUC / PR | 絶対確率の較正 |
| 確率の解釈可能性 | 外部での信頼性と層別サンプル | ワークフローの閾値が既に妥当であること |
| 低品質画像への対応 | 判定保留、再確認、全対象者を含む分母 | 容易な部分集合のみの報告 |
| 外部での信頼性 | 装置 / 施設 / 時間のホールドアウト | 同一由来の画像の無作為分割 |
| 臨床的価値 | 前向きワークフローと関連する評価項目 | 後ろ向き評価におけるAUCの向上 |
検証と実験の計画
- 各適応課題について、ラベル、時間窓、モデル、入力品質の規則を固定する。
- 画像単位ではなく患者単位で訓練とテストを分離し、両眼と反復受診の関係を保持する。
- 適応とハイパーパラメータ調整の予算を揃え、事前学習データと外部データの重複を記録する。
- 装置、施設、時間、集団について、それぞれホールドアウトと層別化を行う。
- 識別、較正、事前指定した閾値、判定保留時のカバレッジを併せて報告する。
- 取得失敗と判定不能をすべてワークフローの分母に含める。
- シャドー研究または前向き研究では、専門研究チームの責任のもと、ワークフローの評価項目を別途設定する。
- 識別情報を除いた統計量と分析規則を公開する。本稿で構成した数値は個人の医療判断に使用しない。
適用範囲と限界
- 患者データも実際の医療モデルの試験もない。
- 感度と特異度は仮定値であり、RETFoundの結果ではない。
- 異なる課題と追跡評価項目を、汎用的な診断性能として統合することはできない。
- 分布変化とラベルバイアスは同時に存在しうる。
- 本稿は診断、治療、臨床導入の推奨を構成しない。
原研究のエビデンスと適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| 約160万枚のラベルなし網膜画像で事前学習し、複数の種類の課題に適応。 | 画像数は独立した患者数ではなく、普遍的な臨床検証を意味するものでもない。 | 網膜画像からの汎化可能な疾患検出のための基盤モデル要旨、モデルの開発と評価 |
| セグメンテーション中間層によって網膜疾患の紹介判断を支援し、失敗症例を提示。 | 特定の研究設定をすべての装置と集団に自動的に転用することはできない。 | 網膜疾患の診断と紹介に臨床適用可能な深層学習方法、補足資料の曖昧な事例と失敗症例 |
検証に値する研究課題
- ラベル予算と適応予算を揃えた後、どの外部装置で改善が維持されるか。
- 判定保留戦略は業務量を特定の集団へ不均衡に移していないか。
- 識別の改善は、閾値を固定した前向きワークフローにおいて実質的な利益をもたらすか。
一次資料と主張の対応
- A foundation model for generalizable disease detection from retinal imagesZhou et al. · 2023-09-131.6 million unlabeled retinal images; task-specific adaptation and diagnosis/prognosis evaluation.
- Clinically applicable deep learning for diagnosis and referral in retinal diseaseDe Fauw et al. · 2018-08-13Device-independent tissue segmentation and referral classification; ambiguities and failure examples.
- WILDS: A Benchmark of in-the-Wild Distribution Shifts, , , , , , , , , , , , , , , , , , , , , , -------------------------------------------------------------------------------- · 2020-12-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、バージョン、出典
Codex(AI)が執筆した、出典に基づく研究レビューと独自解析。原論文の実験は原研究チームに帰属し、本稿の計算は記載された数式と明示された仮定のみを検証する。当サイトには、本稿について独立した査読、または独自のモデル実験、臨床実験、物理実験の記録はまだない。
初出:AIと科学的発見に関する詳細特集。節ごとの出典、原研究のエビデンス、著者による解析の境界を保持する。
概念的表紙はImageGenが生成した。科学図は付属のコードと数値ファイルによって作成し、図の説明で各項目の仮定と測定上の定義を示す。
表紙と科学図の出典 · データ、出典、仮定 · Python · 再計算可能なコード · 公開とバージョンの履歴
ソースの改訂版: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c