
Resumen: cuánta información de secuencia contiene la corriente
El atractivo de la lectura de proteínas individuales reside en vincular el orden de los aminoácidos, las modificaciones y sus estados combinatorios dentro de una misma molécula. Sin embargo, «poder detectar un cambio en un residuo» no equivale a «poder recuperar cualquier secuencia proteica». A partir de estudios sobre relectura mediante nanoporos y lectura de cadenas proteicas largas, este artículo analiza la mezcla de contribuciones de múltiples residuos en la corriente, los pasos del movimiento, las correlaciones entre lecturas repetidas y la partición de muestras. La conclusión central es que la información identificable, las tareas de clasificación y la verdadera secuenciación de novo requieren evidencias propias.[1] Multiple rereads of single proteins at single–amino aci[2] Multi-pass, single-molecule nanopore reading of long pr
Traducción del resumen original en inglés
La lectura de proteínas mediante nanoporos convierte la ocupación molecular en trazas de corriente iónica. Distinguimos la clasificación de sustituciones controladas de la recuperación de secuencias de novo, analizamos las relecturas correlacionadas y la ambigüedad entre secuencia y señal, y derivamos un límite inferior de la varianza que muestra por qué las pasadas repetidas no pueden eliminar el sesgo contextual compartido. La validación propuesta enfatiza las particiones a nivel de molécula y la evaluación que tiene en cuenta las proteoformas.
Diferencias fundamentales entre las dos vías experimentales
Brinkerhoff y colaboradores demostraron el valor de la lectura repetida para distinguir fragmentos de proteínas individuales. Posteriormente, Motone y colaboradores utilizaron módulos de desplegamiento y translocación para leer cadenas proteicas más largas e investigaron modificaciones y señales de múltiples pasadas. Ambos trabajos aportan evidencia concreta del desarrollo tecnológico, pero difieren en sus construcciones moleculares, métodos de lectura y condiciones de clasificación. Este artículo no reformula ninguna de estas pruebas de concepto como secuenciación sin restricciones de proteomas nativos complejos, ni reúne directamente cifras de plataformas distintas en una tabla de rendimiento unificada.[1] Multiple rereads of single proteins at single–amino aci[2] Multi-pass, single-molecule nanopore reading of long pr
De la ocupación molecular a las distribuciones de corriente
La región sensora de un poro puede verse influida simultáneamente por múltiples residuos, la carga local y la conformación; por tanto, no debe suponerse que la corriente asigna un nivel único a cada aminoácido. Un mismo residuo en contextos diferentes puede producir señales distintas, mientras que combinaciones diferentes de residuos pueden producir señales similares. Para establecer la identificabilidad, hay que examinar si las distribuciones condicionales son distinguibles y si las diferencias superan los errores de medición y alineación. Si dos candidatos generan la misma distribución observable, aumentar la capacidad del clasificador no crea información de la nada.作者分析与复核建议 / Author analysis
Clasificación de candidatos conocidos y recuperación de novo
La clasificación entre un conjunto finito de secuencias conocidas de antemano permite al modelo aprovechar diferencias globales entre candidatos; la lectura de novo exige inferir regiones locales desconocidas dentro de un espacio de secuencias enorme. Aunque la primera sea precisa, no garantiza que cada posición se interprete de forma fiable. Los informes deben especificar el tamaño de la biblioteca de candidatos, la similitud de las secuencias y si se conocen la longitud y el tipo de molécula. En particular, los resultados de reconocer unos pocos códigos de barras diseñados no pueden convertirse en una exactitud uniforme para los 20 tipos de residuos en cualquier contexto.作者分析与复核建议 / Author analysis
Beneficios ideales de la relectura mediante múltiples pasadas
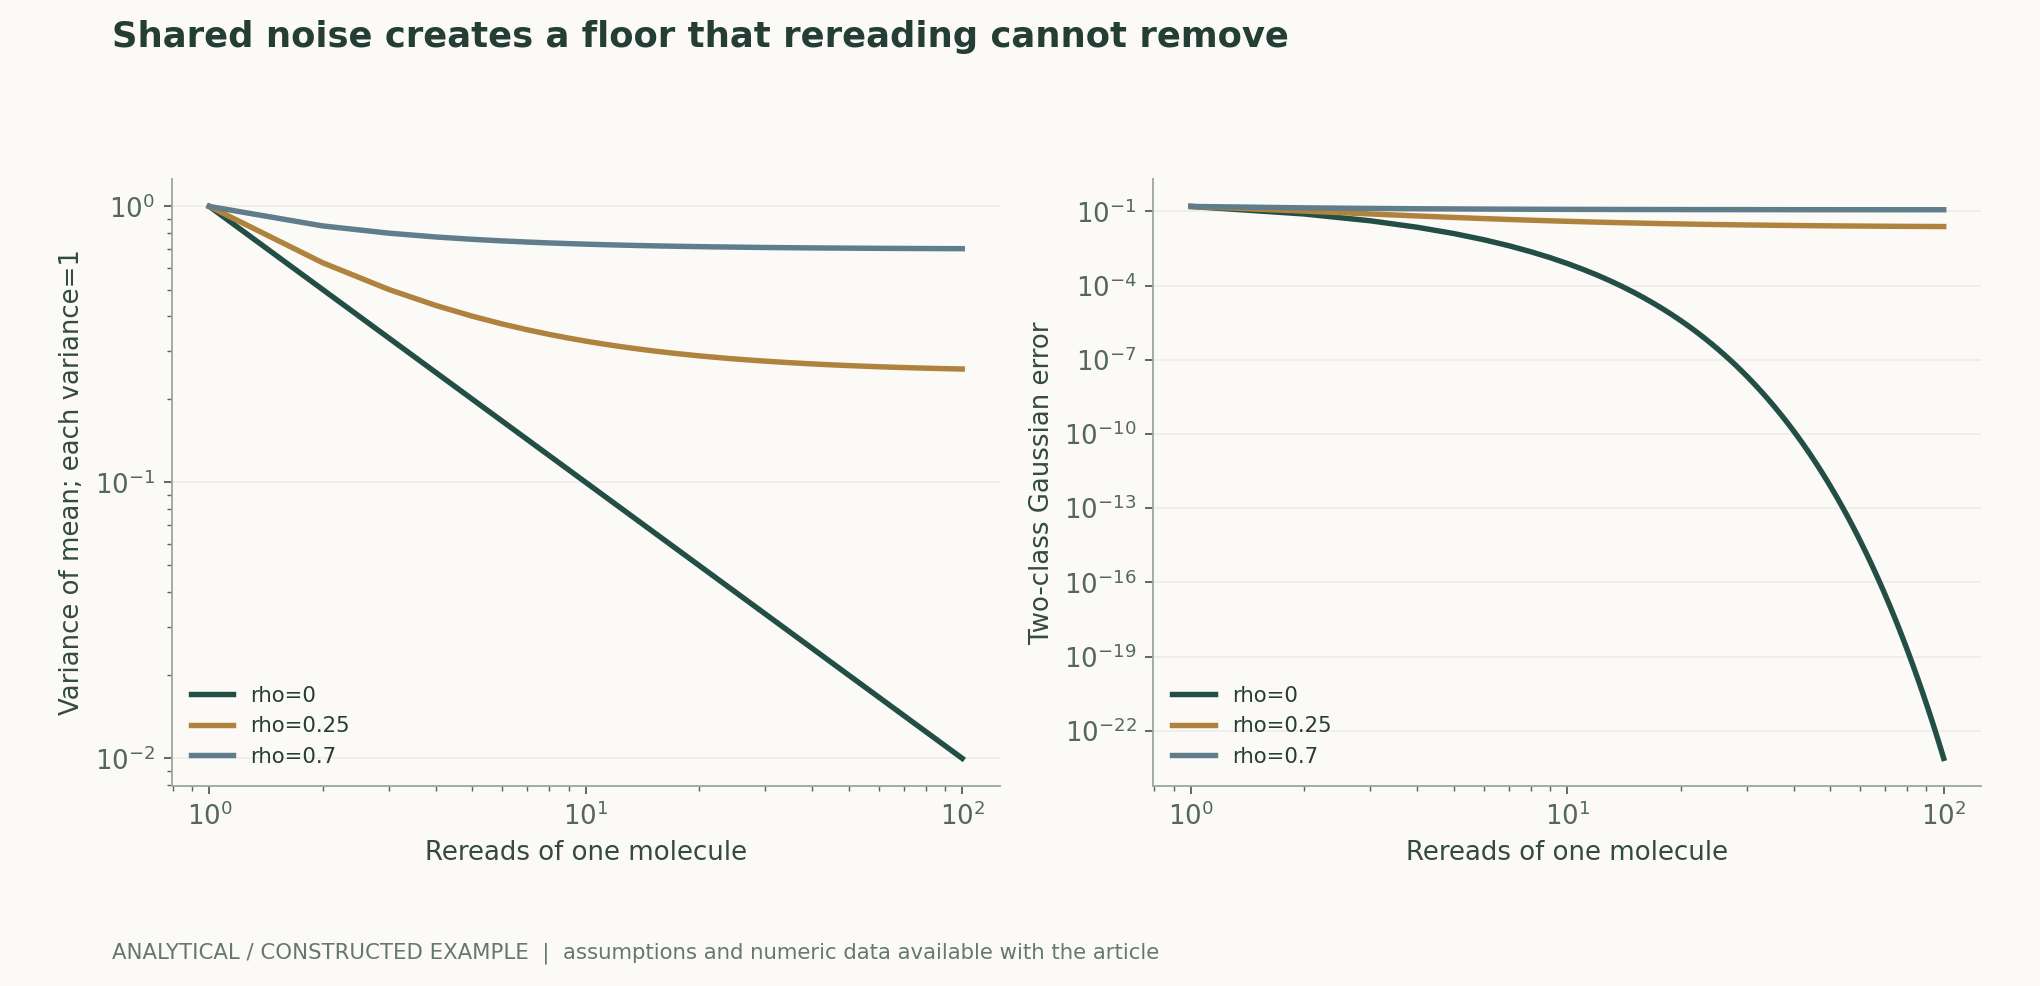
Si la medición de cada pasada tiene la misma varianza y las pasadas son mutuamente independientes, la varianza de la señal media disminuye con el número de pasadas n según 1/n. Esto explica el potencial de la relectura, pero se refiere al ruido de medición, no a errores compartidos del contexto de secuencia. En las relecturas equicorrelacionadas, la varianza también contiene un componente que no desaparece al aumentar n. La figura ilustra este límite con coeficientes de correlación fijos; no ajusta parámetros de ruido de poros o lectores reales.作者分析与复核建议 / Author analysis
Los errores compartidos establecen un límite inferior informacional
Si el error de cada pasada se descompone en un desplazamiento compartido por la molécula y una perturbación independiente, al aumentar las relecturas el componente independiente se reduce mediante el promedio, mientras que el desplazamiento compartido permanece. Si la conformación, las modificaciones o el estado del poro de una misma molécula afectan persistentemente a todas las pasadas, una votación por mayoría simple puede repetir el mismo error con gran confianza. Los estudios deben comparar las relecturas de una misma molécula con mediciones repetidas en poros y lotes distintos, para determinar qué tipo de incertidumbre se elimina y produce la mejora, en lugar de mostrar únicamente puntuaciones posteriores a la votación.作者分析与复核建议 / Author analysis
La alineación puede introducir información a priori adicional
Los pasos del movimiento molecular no tienen por qué corresponder a un residuo por paso: los retrocesos, las pausas y los saltos alteran el eje temporal. Métodos como la deformación temporal dinámica pueden facilitar la alineación, pero también pueden forzar eventos diferentes a adoptar formas similares. Es necesario conservar las trazas sin alinear y las rutas de alineación, y comprobar si el algoritmo utiliza etiquetas verdaderas o plantillas de candidatos. Si durante la prueba se conoce la secuencia que debe identificarse y después se realiza una alineación específica para ella, la tarea deja de ser una identificación a ciegas de una secuencia desconocida.作者分析与复核建议 / Author analysis
Cómo deben dividirse los datos de entrenamiento y prueba
Los registros de múltiples pasadas de una misma molécula están muy correlacionados; repartirlos aleatoriamente entre entrenamiento y prueba permite al modelo ver trazas casi duplicadas. Los niveles más estrictos de separación deben incluir moléculas, poros, lotes experimentales y familias de secuencias. Cada nivel corresponde a un objetivo de extrapolación distinto y no puede sustituir a los demás. Si un artículo pretende demostrar aplicabilidad a proteínas desconocidas, debe informar, como mínimo, del rendimiento en contextos de secuencia no vistos, en lugar de limitarse a demostrar que se reconocen de nuevo códigos de barras conocidos en trazas no vistas.作者分析与复核建议 / Author analysis
Diseño de controles para sustituciones de un solo residuo
Determinar si una señal se debe a un solo residuo exige mantener lo más constantes posible las demás diferencias controlables y examinar el contexto, las posiciones vecinas y el procesamiento molecular. Poder detectar técnicamente una diferencia no implica que pueda atribuirse de manera única a una identidad química. Este artículo propone informar por separado de cuatro tareas: detectar si existe un cambio, localizarlo, identificar la clase candidata y recuperar una secuencia desconocida. Cada nivel superior requiere anotaciones más sólidas, mayor enmascaramiento y calibración externa; no puede reutilizarse la exactitud del nivel anterior.作者分析与复核建议 / Author analysis
El espacio combinatorio de modificaciones y proteoformas
Los estudios de cadenas largas también han explorado la detección de modificaciones, lo que ofrece la posibilidad de vincular combinaciones de múltiples posiciones en una misma molécula. Sin embargo, las modificaciones pueden alterar la conformación y la translocación, produciendo efectos que van más allá de un cambio de corriente en un único sitio. Este artículo propone distinguir entre modificaciones confirmadas mediante estándares químicos, estados asignados por el modelo y señales indeterminadas. Las probabilidades marginales de varias posiciones no pueden tratarse directamente como la probabilidad de una misma proteoforma completa; los estados combinatorios siguen requiriendo vinculación molecular y mediciones ortogonales.[2] Multi-pass, single-molecule nanopore reading of long pr
Las lecturas ausentes también son resultados
Las moléculas que no se despliegan, se desprenden prematuramente o no pueden alinearse pueden compartir características. Si estas moléculas son más difíciles de leer o tienen mayor probabilidad de portar cierto tipo de modificación, calcular la exactitud únicamente sobre trazas satisfactorias distorsionará la representación de la muestra inicial. Un informe completo debe mostrar el embudo de captura, paso completo, posibilidad de alineación y posibilidad de clasificación, estratificado por tipo molecular. En muestras desconocidas, la fracción ilegible no puede interpretarse como ausencia de una proteína o modificación concreta.作者分析与复核建议 / Author analysis
Una confianza elevada requiere calibración
Las probabilidades del clasificador son salidas normalizadas internas del modelo, y sus valores no necesariamente equivalen a la frecuencia de aciertos a largo plazo. Las moléculas no utilizadas en el entrenamiento pueden agruparse por intervalos de confianza para observar el error real y después comparar sus variaciones entre poros y lotes. Ante moléculas ajenas a la biblioteca de candidatos, debe permitirse el rechazo de la clasificación o un resultado incierto. Forzar todas las trazas a encajar en clases conocidas produce un catálogo de proteoformas aparentemente completo, pero en realidad no verificable.作者分析与复核建议 / Author analysis
Los errores se acumulan a lo largo de las cadenas largas
Incluso suponiendo que cada posición sea independiente y tenga una alta probabilidad de acierto, la probabilidad de que una cadena larga entera sea correcta disminuye con su longitud. En realidad, los errores de residuos no son independientes, y las inserciones y deleciones alteran la alineación posterior; por ello, resulta especialmente arriesgado inferir la fiabilidad de una proteína completa a partir de la exactitud por posición. Este artículo propone informar conjuntamente de errores por posición, distancia de edición, éxito de la cadena completa y cobertura, y fijar la distribución de longitudes antes de comparar métodos, para evitar que las cadenas cortas y fáciles dominen el promedio.作者分析与复核建议 / Author analysis
La capacidad de procesamiento no puede medirse contando solo segmentos de corriente
Releer diez veces una misma molécula genera diez trazas, pero no equivale a leer diez proteínas independientes. Para descubrir proteoformas raras, importan más el número de moléculas independientes y la probabilidad de captura de la muestra; para mejorar la exactitud de una misma molécula, importa más el número de relecturas. Existe un compromiso en la asignación de recursos entre ambos objetivos. Es necesario informar del tiempo efectivo de poro, las moléculas independientes, las cadenas completas y el coste de la relectura para discutir la capacidad analítica real, en vez del número de señales generadas.作者分析与复核建议 / Author analysis
Cómo se comprueban los modelos analíticos
La relación de varianza de la figura puede obtenerse sumando directamente la matriz de covarianza y verificarse de forma independiente mediante operaciones matriciales deterministas. Las curvas de tasa de error para dos clases gaussianas ilustran además cómo un límite inferior del ruido restringe la discriminación entre medias, pero no incorporan el comportamiento no gaussiano de los poros reales. Los materiales de recálculo conservan explícitamente la separación entre clases, la varianza compartida, la varianza independiente y el número de pasadas. Al modificar estos supuestos, las curvas deben cambiar según las ecuaciones, y no deben confundirse con el rendimiento medido de alguna plataforma.作者分析与复核建议 / Author analysis
Objetivos fundamentales para la próxima generación de evidencia
Un desafío más valioso consiste en ocultar la identidad de las secuencias, controlar el solapamiento entre familias proteicas y permitir que distintos laboratorios comparen sus resultados sobre un mismo conjunto de prueba a ciegas a nivel molecular, utilizando además métodos ortogonales para validar modificaciones clave y la estructura de la cadena completa. Si la mejora del rendimiento solo aparece dentro de una biblioteca de candidatos conocida, debe presentarse como un logro en reconocimiento de códigos de barras. Solo una recuperación estable de secuencias desconocidas en contextos nuevos respalda una capacidad de secuenciación más amplia. Ambos avances son importantes, pero sus implicaciones científicas difieren.作者分析与复核建议 / Author analysis
Datos intercambiables y seguimiento de errores
El paquete de investigación debe vincular trazas brutas, identificadores moleculares, asignaciones de relecturas, poros y lotes, rutas de alineación y versiones del modelo, y conservar los registros no clasificables. Compartir únicamente trazas medias tras eliminar el ruido hace perder la oportunidad de identificar sesgos compartidos. Este artículo no procesó muestras proteicas reales; las construcciones numéricas adjuntas sirven para comprobar los supuestos necesarios para obtener beneficios de la relectura, no para generar nuevos datos experimentales de moléculas individuales.作者分析与复核建议 / Author analysis
Conclusión: vincular las ganancias de información con referentes observables
La lectura de proteínas mediante nanoporos está ampliando la información medible, pero su credibilidad depende de definir claramente las tareas, vincular las observaciones a cada molécula y tratar los errores compartidos. Las mejoras de rendimiento más convincentes deben mantenerse en contextos desconocidos, con denominadores completos y lotes independientes, y especificar qué incertidumbres no ha eliminado la relectura. Solo así las atractivas trazas de corriente pueden convertirse en evidencia molecular que otros equipos puedan reinterpretar y comprobar.作者分析与复核建议 / Author analysis
Ecuaciones fundamentales y derivaciones
(1) Varianza de la media de relecturas con igual varianza y equicorrelación.
LaTeX
\operatorname{Var}(\bar\epsilon)=\sigma^2[1+(n-1)\rho]/n(2) Descomposición en desplazamiento compartido y ruido independiente; el promedio no elimina el primero.
LaTeX
\epsilon_j=b+u_j,\qquad \operatorname{Var}(\bar\epsilon)=\tau^2+\sigma_u^2/n(3) Ejemplo de dos clases gaussianas con iguales probabilidades a priori e igual varianza; no representa una clasificación real de proteínas.
LaTeX
P_{\rm err}=\Phi[-\Delta/(2\sigma_{\rm mean})](4) Modelo restringido de errores independientes por posición; no puede aplicarse automáticamente a secuencias reales con inserciones y deleciones.
LaTeX
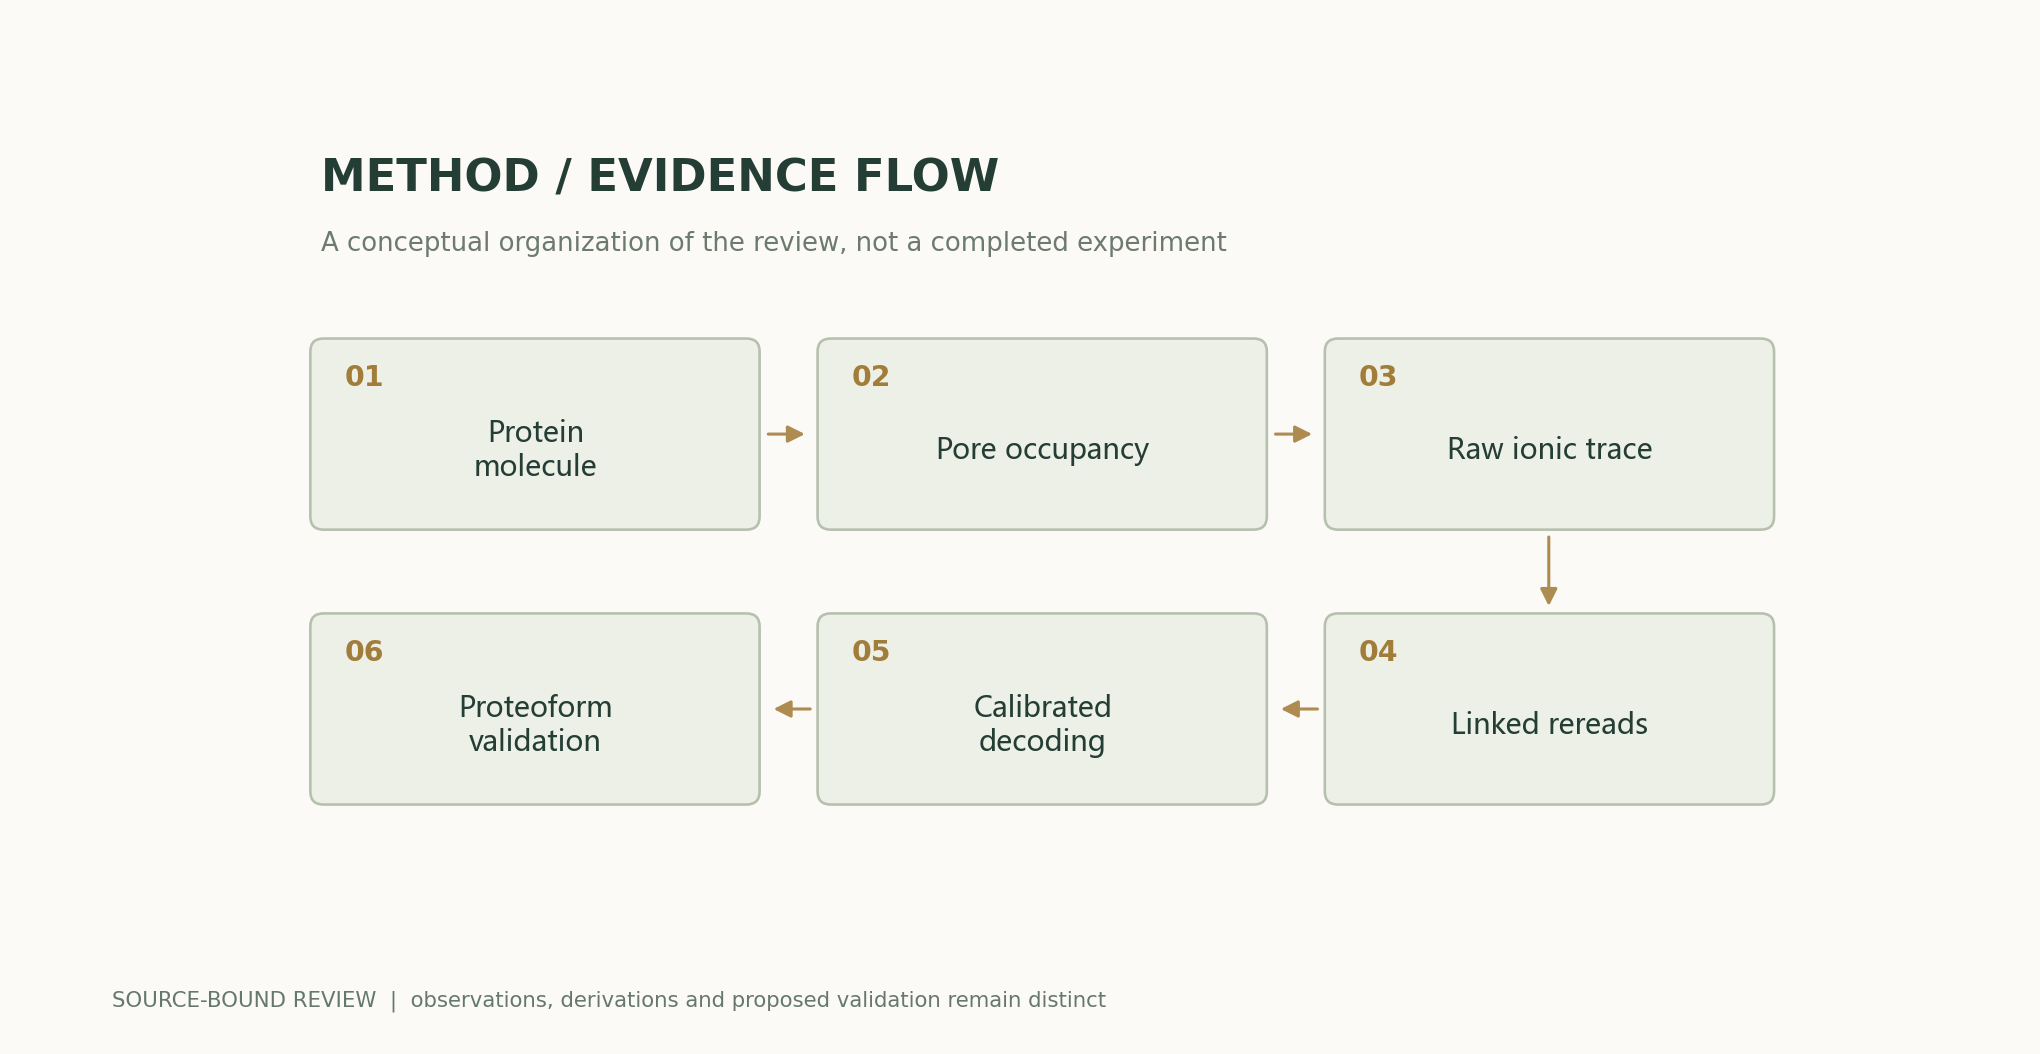
P(\mathrm{whole\ chain\ correct})=(1-e)^LFlujo de métodos y evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto reproducible
Para n=100 y rho=0.25, la varianza de la media es 0.2575, en lugar de 0.01 bajo el supuesto de independencia; cuando n tiende a infinito, la varianza se aproxima a rho. El error de las dos clases gaussianas es solo un modelo de señal restringido.
Comparación de métodos
| Método o criterio de evaluación | Qué se restringe directamente | Evidencia aún necesaria |
|---|---|---|
| Clasificación de códigos de barras conocidos | Discriminación entre un conjunto finito de candidatos | Generalización fuera de la biblioteca de candidatos |
| Detección de sustituciones de residuos | Diferencias en un contexto fijo | Identidad única en cualquier contexto |
| Relectura de una misma molécula | Reducción del ruido independiente | Desplazamientos compartidos y correlaciones |
| Reserva de poros o lotes para prueba | Transferencia entre condiciones de medición | Familias de secuencias completamente nuevas |
| Recuperación de cadenas largas | Errores por posición y de cadena completa | Fallos de cobertura y sesgo de longitud |
| Análisis de modificaciones | Estados combinatorios moleculares | Estándares químicos y confirmación ortogonal |
Plan de verificación y experimentación
- Definir y fijar la tarea: clasificación, detección de diferencias o recuperación de novo.
- Conservar la asignación de cada traza a su molécula, poro y lote.
- Separar entrenamiento y prueba por molécula y familia de secuencias.
- Fijar los procedimientos de alineación y eliminación de ruido antes de revelar las etiquetas de la prueba a ciegas.
- Calcular la correlación entre relecturas y la cobertura de moléculas independientes.
- Informar conjuntamente de errores por posición, errores de cadena completa y tasa de lecturas omitidas.
- Comprobar las modificaciones y la calibración de la confianza mediante estándares independientes.
- Compartir trazas brutas publicables, exclusiones y versiones exactas del modelo.
Ámbito de aplicación y limitaciones
- No hay nuevas mediciones de nanoporos ni de proteínas.
- El modelo de error gaussiano no describe todos los procesos biofísicos.
- El supuesto de equicorrelación se utiliza únicamente para un contraejemplo analítico.
- Los candidatos de los estudios originales difieren de las tareas relativas a proteomas nativos.
- El número de trazas de relectura no es el número de moléculas independientes.
Evidencia de los estudios originales y su ámbito de aplicación
| Resultados de los estudios originales | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| La lectura repetida de una misma molécula mejora la discriminación entre candidatos controlados. | Construcciones y contextos de candidatos limitados. | Múltiples relecturas de proteínas individuales con resolución de un solo aminoácido mediante nanoporosResumen; clasificación mediante relecturas |
| El desplegamiento y la translocación permiten la lectura de cadenas proteicas largas y de señales relacionadas con modificaciones. | Construcciones diseñadas específicas y condiciones del modelo. | Lectura de cadenas proteicas largas mediante nanoporos, con múltiples pasadas y a nivel de molécula individualResumen; figs. 2–6 |
Preguntas de investigación que merece la pena comprobar
- ¿Disminuye el ruido compartido después de repetir la medición en distintos poros?
- ¿Cómo cambian los errores de cadena completa en familias de secuencias desconocidas?
- ¿Cómo pueden optimizarse simultáneamente la exactitud de la relectura y la cobertura de proteoformas raras?
Fuentes primarias y afirmaciones correspondientes
- Multiple rereads of single proteins at single–amino acid resolution using nanoporesHenry Brinkerhoff, Albert S. W. Kang, Jingqian Liu, Aleksei Aksimentiev, Cees Dekker · 2021-12-17Abstract; reread classification
- Multi-pass, single-molecule nanopore reading of long protein strandsKeisuke Motone, Daphne Kontogiorgos-Heintz, Jasmine Wee, Kyoko Kurihara, Sangbeom Yang, Gwendolin Roote, et al. · 2024-09-11Abstract; Figs. 2–6; VR classification
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autoría, versión y fuentes
Revisión de investigación documentada y análisis original redactados por Codex (IA). Los experimentos de los artículos originales pertenecen a los equipos de investigación originales; los cálculos de este artículo solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio todavía no dispone de una revisión por pares independiente de este artículo ni de registros de modelos originales, experimentos clínicos o experimentos físicos propios de él.
Primera publicación: estudio temático en profundidad sobre evidencia científica interdisciplinaria; se mantienen los límites entre las fuentes de cada sección, la evidencia de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se elaboraron con el código y los archivos numéricos adjuntos; sus leyendas detallan individualmente los supuestos y los criterios de medición.
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Python · Código de cálculo reproducible · Historial de publicación y versiones
Revisión de la fuente: 500575872cce7c4b9c4062a12bb0692eb580c2da