
摘要:电流里有多少序列信息
单蛋白读取的吸引力在于把氨基酸顺序、修饰和同一分子的组合状态连接起来。然而“能感知一个残基改变”不等于“能恢复任意蛋白序列”。本文以纳米孔重读与长蛋白链读取研究为起点,分析电流的多残基混合、运动步进、重复读取关联及样本划分。核心结论是:可识别信息、分类任务与真正从头测序,必须分别建立证据。[1] Multiple rereads of single proteins at single–amino aci[2] Multi-pass, single-molecule nanopore reading of long pr
English abstract
Nanopore protein readout converts molecular occupancy into ionic-current traces. We distinguish controlled substitution classification from de novo sequence recovery, analyze correlated rereads and sequence-to-signal ambiguity, and derive a variance floor showing why repeated passes cannot remove shared context bias. Proposed validation emphasizes molecule-level splits and proteoform-aware evaluation.
两条实验路线的关键区别
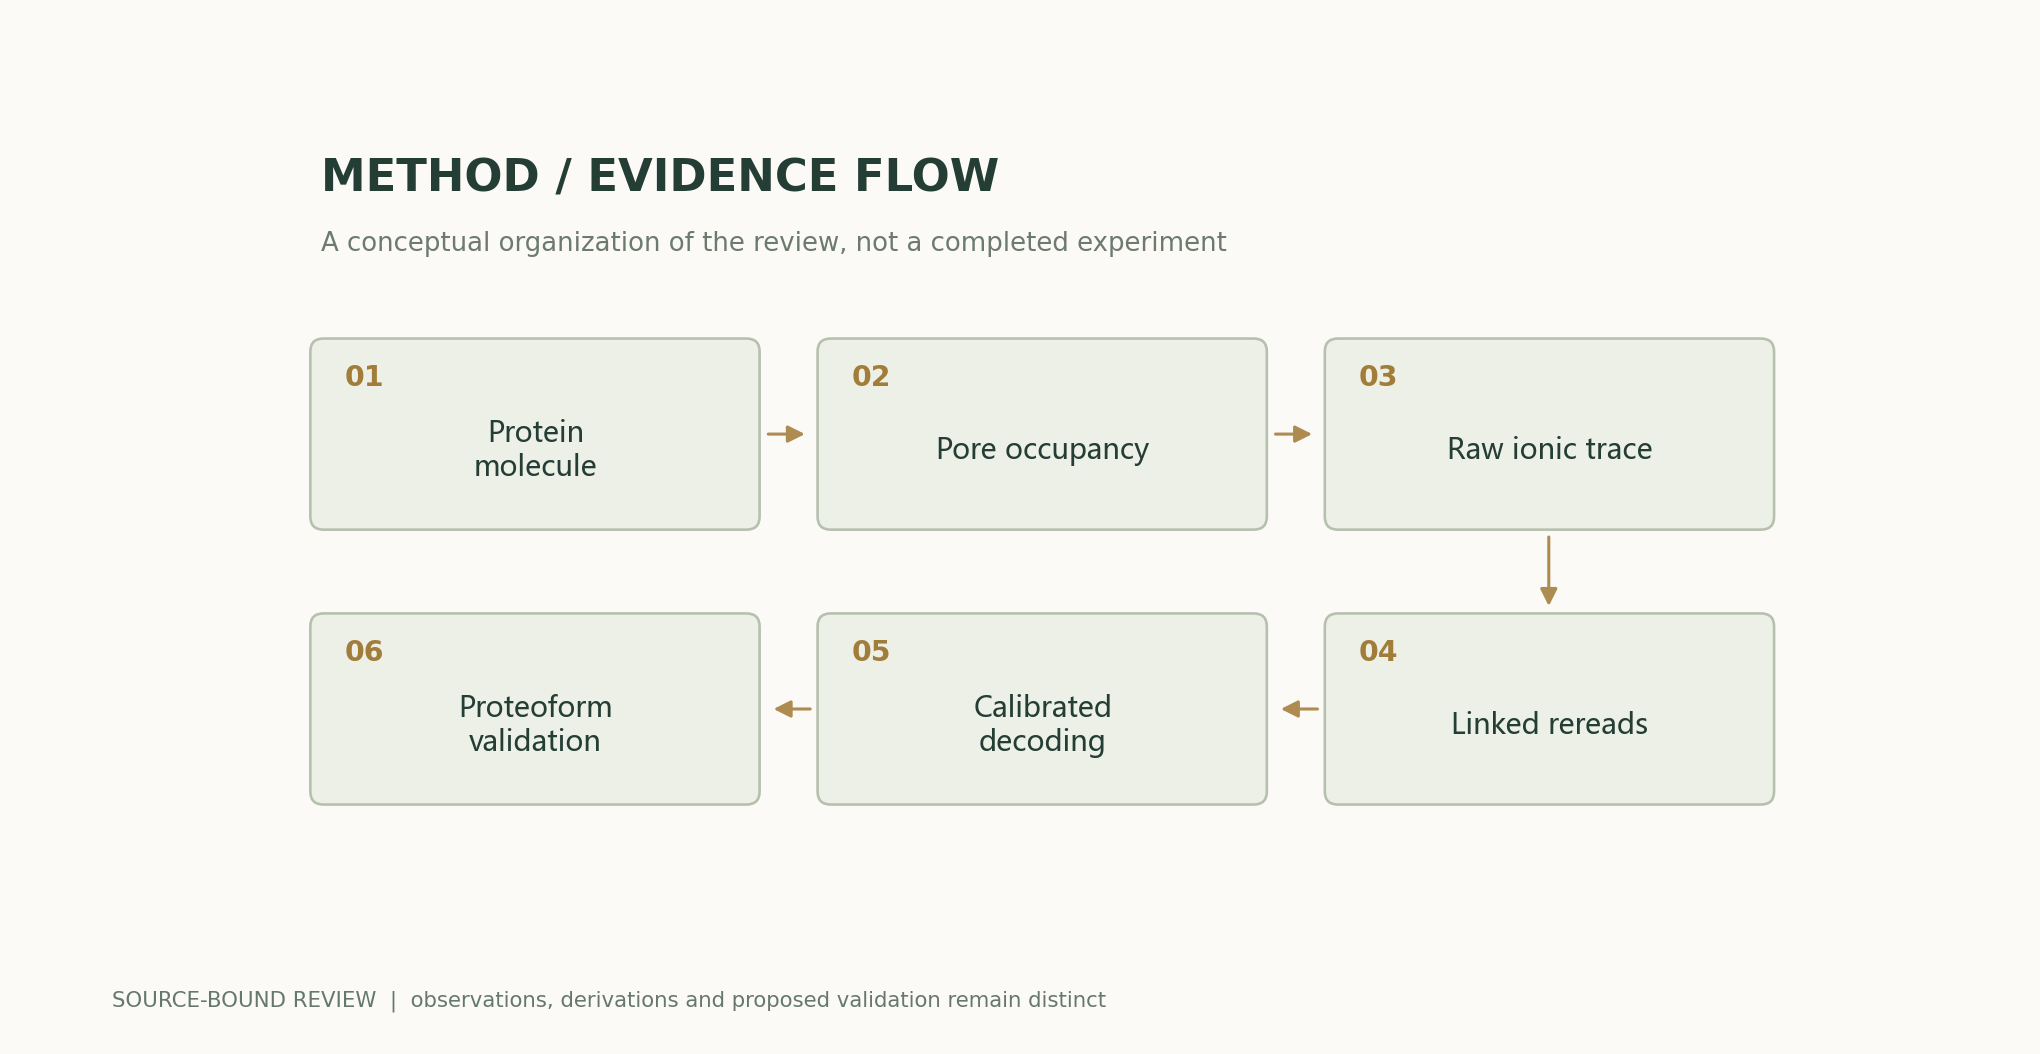
Brinkerhoff等展示了重复读取对单蛋白片段分辨的价值,Motone等进一步利用展开与转运模块读取较长蛋白链,并研究修饰和多遍信号。两项工作都为技术发展提供了具体证据,但分子构建物、读出方式和分类条件不同。本文不将任一概念验证改写为对复杂天然蛋白组无约束测序,也不把不同平台的数字直接排列成统一性能表。[1] Multiple rereads of single proteins at single–amino aci[2] Multi-pass, single-molecule nanopore reading of long pr
从分子占据到电流分布
一个孔的感知区域可能同时受到多个残基、局部电荷与构象影响,所以电流不应被视为每种氨基酸对应唯一电平。相同残基处在不同背景中可以形成不同信号,不同残基组合也可能接近。建立可辨识性时应考察条件分布是否可区分,以及差异是否大于测量和对齐误差。若两个候选给出相同可观察分布,增加分类器容量不会凭空创造信息。作者分析与复核建议 / Author analysis
已知候选分类与从头恢复
在有限个预先知道的序列之间分类,允许模型利用候选整体差异;从头读取则需要在巨大序列空间中推断未知局部。前者即使准确,也不能保证每个位置都被可靠解释。报告应明确候选库规模、序列相似性、是否知道长度和分子类型。尤其不能把识别几个工程化条码的结果,转换为所有20种残基在任意背景下的统一准确率。作者分析与复核建议 / Author analysis
多遍重读的理想收益
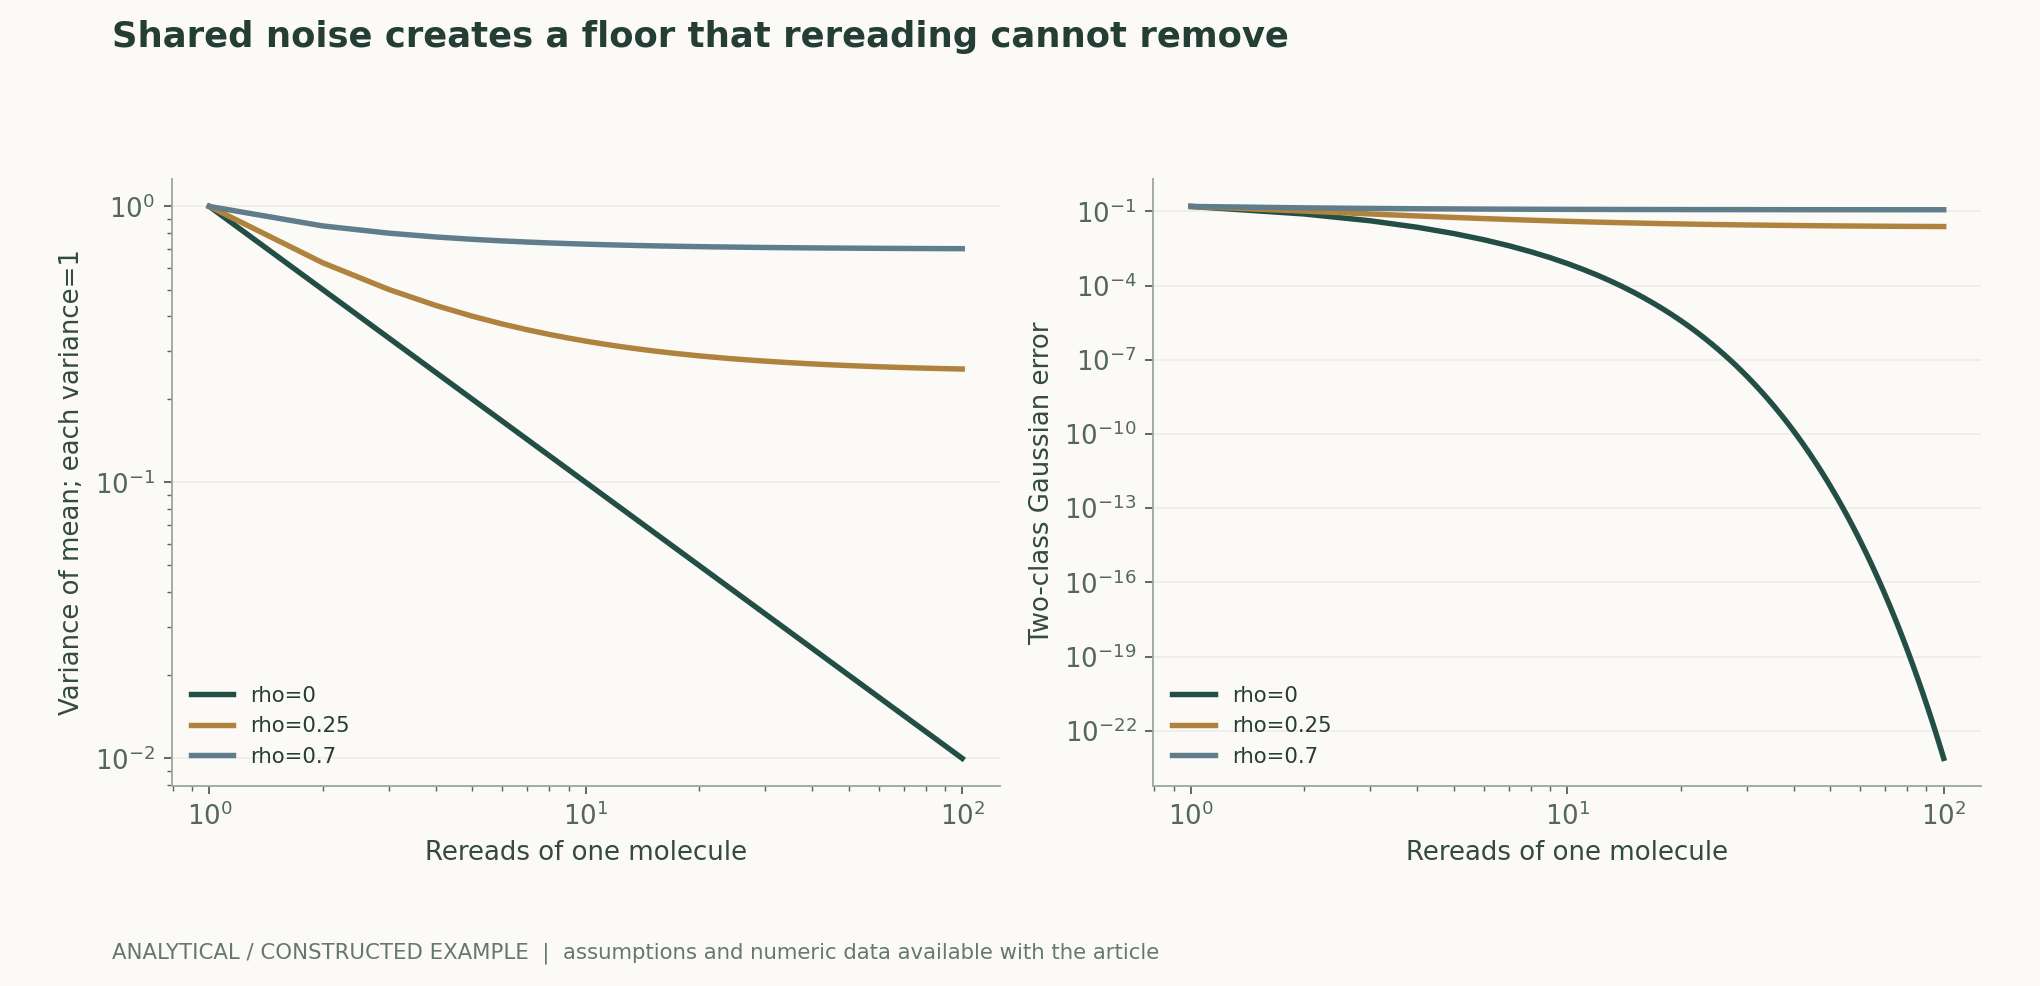
若每遍测量具有相同方差且相互独立,平均信号的方差随遍数n按1/n下降。这说明重读为什么有潜力,但它针对的是测量噪声,不是共享的序列背景错误。对于相互等相关的重读,方差中还含有不随n消失的部分。图中以固定相关系数演示这一极限,并没有拟合真实孔道或读取器的噪声参数。作者分析与复核建议 / Author analysis
共有误差形成信息下限
把每遍误差拆成分子共有偏移与独立扰动,随着重读增加,独立部分被平均,共有偏移仍保留。若同一分子的构象、修饰或孔状态持续影响所有遍次,简单多数投票可能非常自信地重复同一个错误。研究应比较同分子重读、不同孔及不同批次的重复,判断增益来自消除哪一种不确定性,而不是只展示投票后分数。作者分析与复核建议 / Author analysis
对齐过程可能引入额外先验
分子步进不必等同于一个残基一步,回退、停顿和跳跃都会改变时间轴。动态时间规整等方法可以帮助对齐,但也可能把不同事件强行拉成相似形状。需要保留未经对齐的轨迹与对齐路径,检查算法是否使用了真实标签或候选模板。若测试阶段知道待识别序列再进行专门对齐,任务就不再是盲法未知序列识别。作者分析与复核建议 / Author analysis
训练测试应按什么切分
同一分子的多遍记录高度相关;把它们随机分到训练和测试,会让模型看到接近重复的轨迹。更严格的层次应包括分子、孔、实验批次和序列家族。每一层对应不同外推目标,不能相互替代。论文若希望证明未知蛋白适用性,至少要报告未见序列背景的表现,而不是只在未见轨迹上证明复现已知条码。作者分析与复核建议 / Author analysis
单残基替换的对照设计
判断信号是否由一个残基引起,需要将其他可控差异尽量保持,并检查背景、相邻位点与分子处理过程。技术上能检测到差异,不代表差异能唯一定位到化学身份。本文建议分别报告有无改变、改变位置、候选类别和未知序列恢复四类任务。每上升一层,都需要更强的标注、盲法与外部校准,不能沿用上一层的准确率。作者分析与复核建议 / Author analysis
修饰与蛋白型的组合空间
长链研究还探索了修饰检测,使同一分子上多个位置的组合有机会被关联。然而修饰可能改变构象和转运,产生超出单点电流变化的影响。本文建议区分化学标准确认的修饰、模型分配的状态和不能确定的信号。多个位置的边际概率不能直接当作同一完整蛋白型的概率,组合状态仍需要分子关联和正交测量。[2] Multi-pass, single-molecule nanopore reading of long pr
缺失读取也是结果
失败展开、过早脱落和无法对齐的分子可能具有共同特征。如果这些分子更难读取或更容易携带某类修饰,只在成功轨迹上计算准确率会偏离起始样本。完整报告应展示捕获、完整通过、可对齐、可分类的漏斗,并按分子类型分层。对于未知样本,无法读取的部分不能被解释为不存在某种蛋白或修饰。作者分析与复核建议 / Author analysis
高置信度需要校准
分类器概率是模型内部的归一化输出,其数值未必等于长期正确频率。可以在未参与训练的分子上按置信区间分箱,观察实际误差,再比较孔和批次间的变化。遇到候选库以外的分子时,应允许拒识或不确定结果。强迫所有轨迹落入已知类别,会产生看似完整、实际不可验证的蛋白型目录。作者分析与复核建议 / Author analysis
错误沿长链累积
即使假设每个位置独立且正确率很高,整条长链完全正确的概率仍随长度下降。实际残基错误并不独立,插入删除又会改变后续对齐,因此用单位置准确率推导完整蛋白可靠性尤其危险。本文建议同时报告位置错误、编辑距离、完整链成功及覆盖率,并把长度分布固定后再做方法比较,防止短且容易的链主导平均值。作者分析与复核建议 / Author analysis
吞吐量不能只数电流片段
同一分子重读十遍形成十条轨迹,并不等于读取了十个独立蛋白。对于发现稀有蛋白型,独立分子数和样本捕获概率更关键;对于提高同分子精度,重读次数更关键。两种目标之间存在资源分配权衡。需要同时报告有效孔时间、独立分子、完整链和重读成本,才能讨论真实分析吞吐而非信号生成数量。作者分析与复核建议 / Author analysis
解析模型怎样被检验
图中的方差关系可从协方差矩阵直接求和,也可通过确定性矩阵运算独立验证。二类高斯错误率曲线进一步说明噪声下限如何限制均值分离,但没有包含真实孔道的非高斯行为。复算材料明确保存类间距、共有方差、独立方差与遍数;改变这些假设后,曲线应按公式改变,而不应被误读为某平台的实测性能。作者分析与复核建议 / Author analysis
下一代证据的关键目标
更有价值的挑战是隐藏序列身份、控制蛋白家族重叠,并让不同实验室在同一分子级盲测集上比较;同时用正交方法验证关键修饰和完整链结构。若性能提升只出现在已知候选库,应该按条码识别成果报告。若能在新背景中稳定恢复未知序列,才支持更广泛测序能力的结论。两种进展都重要,但科学含义不同。作者分析与复核建议 / Author analysis
可交换数据与误差追踪
研究包应连接原始轨迹、分子标识、重读归属、孔和批次、对齐路径及模型版本,并保留无法归类记录。只共享去噪后的平均轨迹会丢失识别共有偏差的机会。本文未处理真实蛋白样本;附带的数值构造用于检验重读收益的必要假设,而非生成新的单分子实验数据。作者分析与复核建议 / Author analysis
结论:让信息增益有可观察对象
纳米孔蛋白读取正在拓展可测量信息,但其可信性取决于明确任务、分子关联及共有误差的处理。最有说服力的性能提升应在未知背景、完整分母和独立批次中保持,并说明哪些不确定性仍未被重读消除。这样才能把漂亮电流轨迹转变为能够被其他团队重新解释和检验的分子证据。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 等方差、等相关重读的均值方差。
LaTeX
\operatorname{Var}(\bar\epsilon)=\sigma^2[1+(n-1)\rho]/n(2) 共有偏移与独立噪声分解,前者不会被平均消除。
LaTeX
\epsilon_j=b+u_j,\qquad \operatorname{Var}(\bar\epsilon)=\tau^2+\sigma_u^2/n(3) 等先验、同方差二类高斯示例;不表示真实蛋白分类。
LaTeX
P_{\rm err}=\Phi[-\Delta/(2\sigma_{\rm mean})](4) 独立位置错误的限定模型,不能自动套用存在插入删除的真实序列。
LaTeX
P(\mathrm{whole\ chain\ correct})=(1-e)^L方法与证据流程
解析图与数值示例
可复算例题
n=100、rho=0.25时均值方差0.2575,而非独立假设的0.01;n趋向无穷时方差趋近rho。两类高斯错误只是限定信号模型。
方法比较
| 方法或口径 | 直接约束 | 仍需补足的证据 |
|---|---|---|
| 已知条码分类 | 有限候选辨别 | 候选库之外的泛化 |
| 残基替换检测 | 固定背景中的差异 | 任意背景下的唯一身份 |
| 同分子重读 | 独立噪声下降 | 共有偏移与相关性 |
| 孔/批次留出 | 测量条件迁移 | 全新序列家族 |
| 长链恢复 | 位置与完整链错误 | 覆盖失败和长度偏差 |
| 修饰分析 | 分子组合状态 | 化学标准与正交确认 |
复核与实验方案
- 固定分类、差异检测或从头恢复任务。
- 保存每个轨迹的分子、孔和批次归属。
- 按分子及序列家族隔离训练与测试。
- 冻结对齐与去噪流程后再揭示盲测标签。
- 计算重读相关性及独立分子覆盖。
- 同时报告位置错误、完整链错误和漏读率。
- 用独立标准检查修饰及置信度校准。
- 共享原始可公开轨迹、排除项和准确模型版本。
适用范围与局限
- 没有新纳米孔或蛋白测量。
- 高斯错误模型不描述全部生物物理过程。
- 等相关假设仅用于解析反例。
- 原研究候选与天然蛋白组任务不同。
- 重读轨迹数不是独立分子数。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 同分子重复读取改善受控候选的分辨。 | 有限构建物及候选背景。 | Multiple rereads of single proteins at single–amino acid resolution using nanoporesAbstract; reread classification |
| 展开转运支持长蛋白链和修饰相关读出。 | 特定工程构建物与模型条件。 | Multi-pass, single-molecule nanopore reading of long protein strandsAbstract; Figs. 2–6 |
值得检验的研究问题
- 共有噪声在跨孔重测后是否下降?
- 未知序列家族上的完整链错误如何变化?
- 如何同时优化重读精度与稀有蛋白型覆盖?
一手来源与主张对应
- Multiple rereads of single proteins at single–amino acid resolution using nanoporesHenry Brinkerhoff, Albert S. W. Kang, Jingqian Liu, Aleksei Aksimentiev, Cees Dekker · 2021-12-17Abstract; reread classification
- Multi-pass, single-molecule nanopore reading of long protein strandsKeisuke Motone, Daphne Kontogiorgos-Heintz, Jasmine Wee, Kyoko Kurihara, Sangbeom Yang, Gwendolin Roote, et al. · 2024-09-11Abstract; Figs. 2–6; VR classification
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:跨学科科学证据深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: 500575872cce7c4b9c4062a12bb0692eb580c2da