
要旨:電流にはどれほどの配列情報が含まれるか
単一タンパク質読み取りの魅力は、アミノ酸の順序、修飾、および同一分子内でのそれらの組合せ状態を結び付けられることにある。しかし、「一つの残基の変化を検知できる」ことは、「任意のタンパク質配列を復元できる」ことと同義ではない。本記事は、ナノポアによる再読み取りと長いタンパク質鎖の読み取りに関する研究を出発点として、電流における複数残基の寄与の混合、運動のステップ、反復読み取り間の相関、試料の分割を分析する。中心的な結論は、識別可能な情報、分類課題、真のデノボ配列決定について、それぞれ独立にエビデンスを構築する必要があるということである。[1] Multiple rereads of single proteins at single–amino aci[2] Multi-pass, single-molecule nanopore reading of long pr
英語原文要旨の日本語訳
ナノポアによるタンパク質読み取りは、分子による占有をイオン電流トレースへ変換する。本稿では、制御された置換の分類とデノボ配列復元を区別し、相関をもつ再読み取りおよび配列と信号の対応の曖昧さを分析する。また、反復通過では共有された文脈バイアスを除去できない理由を示す分散の下限を導出する。提案する検証では、分子単位のデータ分割と、プロテオフォームを考慮した評価を重視する。
二つの実験的アプローチの重要な相違
Brinkerhoffらは、単一タンパク質断片の識別における反復読み取りの価値を示した。Motoneらはさらに、アンフォールディングと移送のモジュールを用いて、より長いタンパク質鎖を読み取り、修飾と複数回通過の信号を研究した。両研究は技術発展の具体的なエビデンスを提供するが、分子コンストラクト、読み出し方式、分類条件は異なる。本記事では、いずれの概念実証も、複雑な天然プロテオームの無制約な配列決定として読み替えず、異なるプラットフォームの数値をそのまま統一的な性能表に並べることもしない。[1] Multiple rereads of single proteins at single–amino aci[2] Multi-pass, single-molecule nanopore reading of long pr
分子による占有から電流分布へ
ポアの感知領域は、複数の残基、局所的な電荷、立体構造から同時に影響を受ける可能性があるため、各アミノ酸に固有の電流レベルが対応すると考えるべきではない。同じ残基でも周辺の文脈が異なれば異なる信号を生じ、異なる残基の組合せでも信号が近接する場合がある。識別可能性を確立する際には、条件付き分布を区別できるか、その差が測定誤差とアラインメント誤差を上回るかを検討すべきである。二つの候補が同じ観測可能な分布を与える場合、分類器の容量を増やしても、存在しない情報を生み出すことはできない。作者分析与复核建议 / Author analysis
既知候補の分類とデノボ復元
事前に知られた有限個の配列間の分類では、モデルは候補全体の差を利用できる。一方、デノボ読み取りでは、巨大な配列空間において未知の局所領域を推定する必要がある。前者が正確であっても、すべての位置が信頼性高く解釈される保証はない。報告では、候補ライブラリの規模、配列類似性、長さと分子種が既知かどうかを明示すべきである。とりわけ、少数の人工的に設計されたバーコードの識別結果を、任意の文脈における全20種類の残基の一律の正解率へ換算してはならない。作者分析与复核建议 / Author analysis
複数回の再読み取りによる理想的な利得
各通過の測定が同じ分散をもち、互いに独立であれば、平均信号の分散は通過回数nに対して1/nに従って低下する。これは再読み取りの可能性を説明するが、対象は測定ノイズであり、共有された配列文脈に由来する誤りではない。再読み取り間が等相関である場合、分散にはnの増加によって消失しない成分も含まれる。図では固定した相関係数を用いてこの限界を例示しており、実際のポアや読み取り装置のノイズパラメータを当てはめてはいない。作者分析与复核建议 / Author analysis
共通誤差が形成する情報上の下限
各通過の誤差を分子に共通するオフセットと独立な擾乱に分解すると、再読み取りが増えるにつれて独立成分は平均化される一方、共通オフセットは残る。同一分子の立体構造、修飾、またはポア状態が全通過に持続的に影響する場合、単純な多数決は同じ誤りを極めて高い信頼度で繰り返す可能性がある。研究では、同一分子の再読み取り、異なるポアでの反復、異なるバッチでの反復を比較し、投票後のスコアだけを示すのではなく、どの不確実性の低減から利得が得られたのかを判断すべきである。作者分析与复核建议 / Author analysis
アラインメント過程が追加の事前情報を導入する可能性
分子のステップ運動は、必ずしも一ステップ一残基とは限らず、後退、停止、飛び越しはいずれも時間軸を変える。動的時間伸縮法などはアラインメントに役立つ一方、異なる事象を無理に似た形状へ変形させる可能性もある。未整列のトレースとアラインメント経路を保存し、アルゴリズムが正解ラベルや候補テンプレートを使用したかを確認する必要がある。テスト段階で識別対象の配列を知ったうえで専用のアラインメントを行うなら、その課題はもはや未知配列の盲検識別ではない。作者分析与复核建议 / Author analysis
訓練とテストを何に基づいて分割すべきか
同一分子の複数回通過の記録は強く相関している。それらを訓練とテストへ無作為に割り振ると、モデルはほぼ重複したトレースを見ることになる。より厳格な分割の階層には、分子、ポア、実験バッチ、配列ファミリーを含めるべきである。各階層は異なる外挿目標に対応し、相互に代替できない。未知タンパク質への適用可能性を示そうとする論文は、未見のトレースで既知バーコードを再識別できることを示すだけでなく、少なくとも未見の配列文脈における性能を報告する必要がある。作者分析与复核建议 / Author analysis
単一残基置換の対照設計
信号が一つの残基に由来するかを判断するには、その他の制御可能な差をできる限り一定に保ち、文脈、隣接部位、分子の処理過程を確認する必要がある。技術的に差を検出できることは、その差を化学的同一性に一意に帰属できることを意味しない。本記事では、変化の有無、変化の位置、候補カテゴリー、未知配列の復元という四種類の課題を個別に報告することを提案する。上位の段階へ進むたびに、より強固なアノテーション、盲検化、外部較正が必要であり、前段階の正解率を流用してはならない。作者分析与复核建议 / Author analysis
修飾とプロテオフォームの組合せ空間
長鎖の研究では修飾検出も検討されており、同一分子上の複数位置における組合せを関連付けられる可能性が生まれている。しかし、修飾は立体構造や移送を変化させ、単一部位の電流変化を超える影響を及ぼす可能性がある。本記事では、化学標準によって確認された修飾、モデルが割り当てた状態、判定不能な信号を区別することを提案する。複数位置の周辺確率を、そのまま同一の完全なプロテオフォームの確率とみなすことはできない。組合せ状態の評価には、依然として分子単位の対応付けと直交的な測定が必要である。[2] Multi-pass, single-molecule nanopore reading of long pr
読み取りの欠落も結果である
アンフォールディングに失敗した分子、早期に脱離した分子、アラインメントできない分子は、共通の特徴をもつ可能性がある。これらの分子が読み取りにくい、あるいは特定の修飾をもちやすい場合、成功したトレースだけで正解率を計算すると、出発試料を適切に反映しなくなる。完全な報告では、捕捉、完全通過、アラインメント可能、分類可能という段階ごとの減少を示し、分子種別に層別化すべきである。未知試料では、読み取れない部分を、特定のタンパク質や修飾が存在しないことと解釈してはならない。作者分析与复核建议 / Author analysis
高い信頼度には較正が必要である
分類器の確率はモデル内部で正規化された出力であり、その値が長期的な正解頻度に等しいとは限らない。訓練に用いていない分子を信頼度の区間ごとにまとめて実際の誤りを観察し、さらにポア間やバッチ間の変化を比較できる。候補ライブラリ外の分子に遭遇した際には、識別の棄却や不確実という結果を許容すべきである。すべてのトレースを既知カテゴリーへ強制的に分類すると、見かけ上は完全でも、実際には検証不能なプロテオフォーム一覧が生じる。作者分析与复核建议 / Author analysis
長鎖に沿って蓄積する誤り
各位置が独立で正解率も高いと仮定しても、長鎖全体が完全に正しい確率は長さとともに低下する。実際の残基誤りは独立ではなく、挿入や欠失は後続のアラインメントも変えるため、単一位置の正解率から完全なタンパク質の信頼性を推定することは特に危険である。本記事では、位置ごとの誤り、編集距離、全鎖の成功率、カバレッジを併記し、長さ分布を固定してから方法を比較することを提案する。これにより、短く容易な鎖が平均を支配することを防ぐ。作者分析与复核建议 / Author analysis
スループットは電流断片の数だけでは評価できない
同じ分子を十回再読み取りして十本のトレースを得ても、独立した十個のタンパク質を読んだことにはならない。希少なプロテオフォームの発見には、独立分子数と試料の捕捉確率がより重要であり、同一分子の精度向上には再読み取り回数がより重要である。両目標の間には資源配分上のトレードオフがある。信号の生成数ではなく実際の分析スループットを議論するには、有効ポア稼働時間、独立分子数、完全鎖数、再読み取りコストを併せて報告する必要がある。作者分析与复核建议 / Author analysis
解析モデルをどのように検証するか
図中の分散関係は共分散行列の要素を直接加算して導出でき、決定論的な行列演算によって独立に検証することもできる。二クラスのガウス誤り率曲線は、ノイズの下限が平均間の識別をどのように制約するかをさらに示すが、実際のポアの非ガウス的挙動は含まない。再計算用資料には、クラス間距離、共通分散、独立分散、通過回数が明示的に保存されている。これらの仮定を変更すれば曲線も式に従って変わるべきであり、特定プラットフォームの実測性能と誤解してはならない。作者分析与复核建议 / Author analysis
次世代のエビデンスにおける主要目標
より価値のある課題は、配列の同一性を秘匿し、タンパク質ファミリー間の重複を制御したうえで、異なる研究室が同一の分子単位の盲検テストセットで比較することである。同時に、直交的な手法で主要な修飾と全鎖構造を検証する必要がある。性能向上が既知の候補ライブラリ内だけに現れるなら、バーコード識別の成果として報告すべきである。新たな文脈で未知配列を安定して復元できて初めて、より広範な配列決定能力という結論が支持される。いずれの進歩も重要だが、科学的な意味は異なる。作者分析与复核建议 / Author analysis
交換可能なデータと誤差の追跡
研究パッケージでは、生トレース、分子識別子、再読み取りの帰属、ポアとバッチ、アラインメント経路、モデルのバージョンを結び付け、分類不能な記録も保持すべきである。ノイズ除去後の平均トレースだけを共有すると、共通バイアスを特定する機会が失われる。本記事は実際のタンパク質試料を処理していない。付属の数値構成例は再読み取りの利得に必要な仮定を検証するためのものであり、新たな単一分子実験データを生成するものではない。作者分析与复核建议 / Author analysis
結論:情報利得を観測可能な対象に結び付ける
ナノポアによるタンパク質読み取りは測定可能な情報を拡張しつつあるが、その信頼性は、課題の明確化、分子単位の対応付け、共通誤差の取り扱いに依存する。最も説得力のある性能向上は、未知の文脈、完全な分母、独立したバッチにおいても維持され、再読み取りでなお除去されない不確実性を説明するものである。このようにして初めて、美しい電流トレースを、他の研究チームが再解釈し検証できる分子エビデンスへ変えられる。作者分析与复核建议 / Author analysis
主要な数式と導出
(1) 等分散・等相関の再読み取りにおける平均の分散。
LaTeX
\operatorname{Var}(\bar\epsilon)=\sigma^2[1+(n-1)\rho]/n(2) 共通オフセットと独立ノイズへの分解。前者は平均化によって除去されない。
LaTeX
\epsilon_j=b+u_j,\qquad \operatorname{Var}(\bar\epsilon)=\tau^2+\sigma_u^2/n(3) 事前確率と分散が等しい二クラスのガウス分布の例。実際のタンパク質分類を表すものではない。
LaTeX
P_{\rm err}=\Phi[-\Delta/(2\sigma_{\rm mean})](4) 位置ごとの誤りが独立であるという限定的なモデル。挿入や欠失を含む実際の配列へ自動的に適用することはできない。
LaTeX
P(\mathrm{whole\ chain\ correct})=(1-e)^L方法とエビデンスの流れ
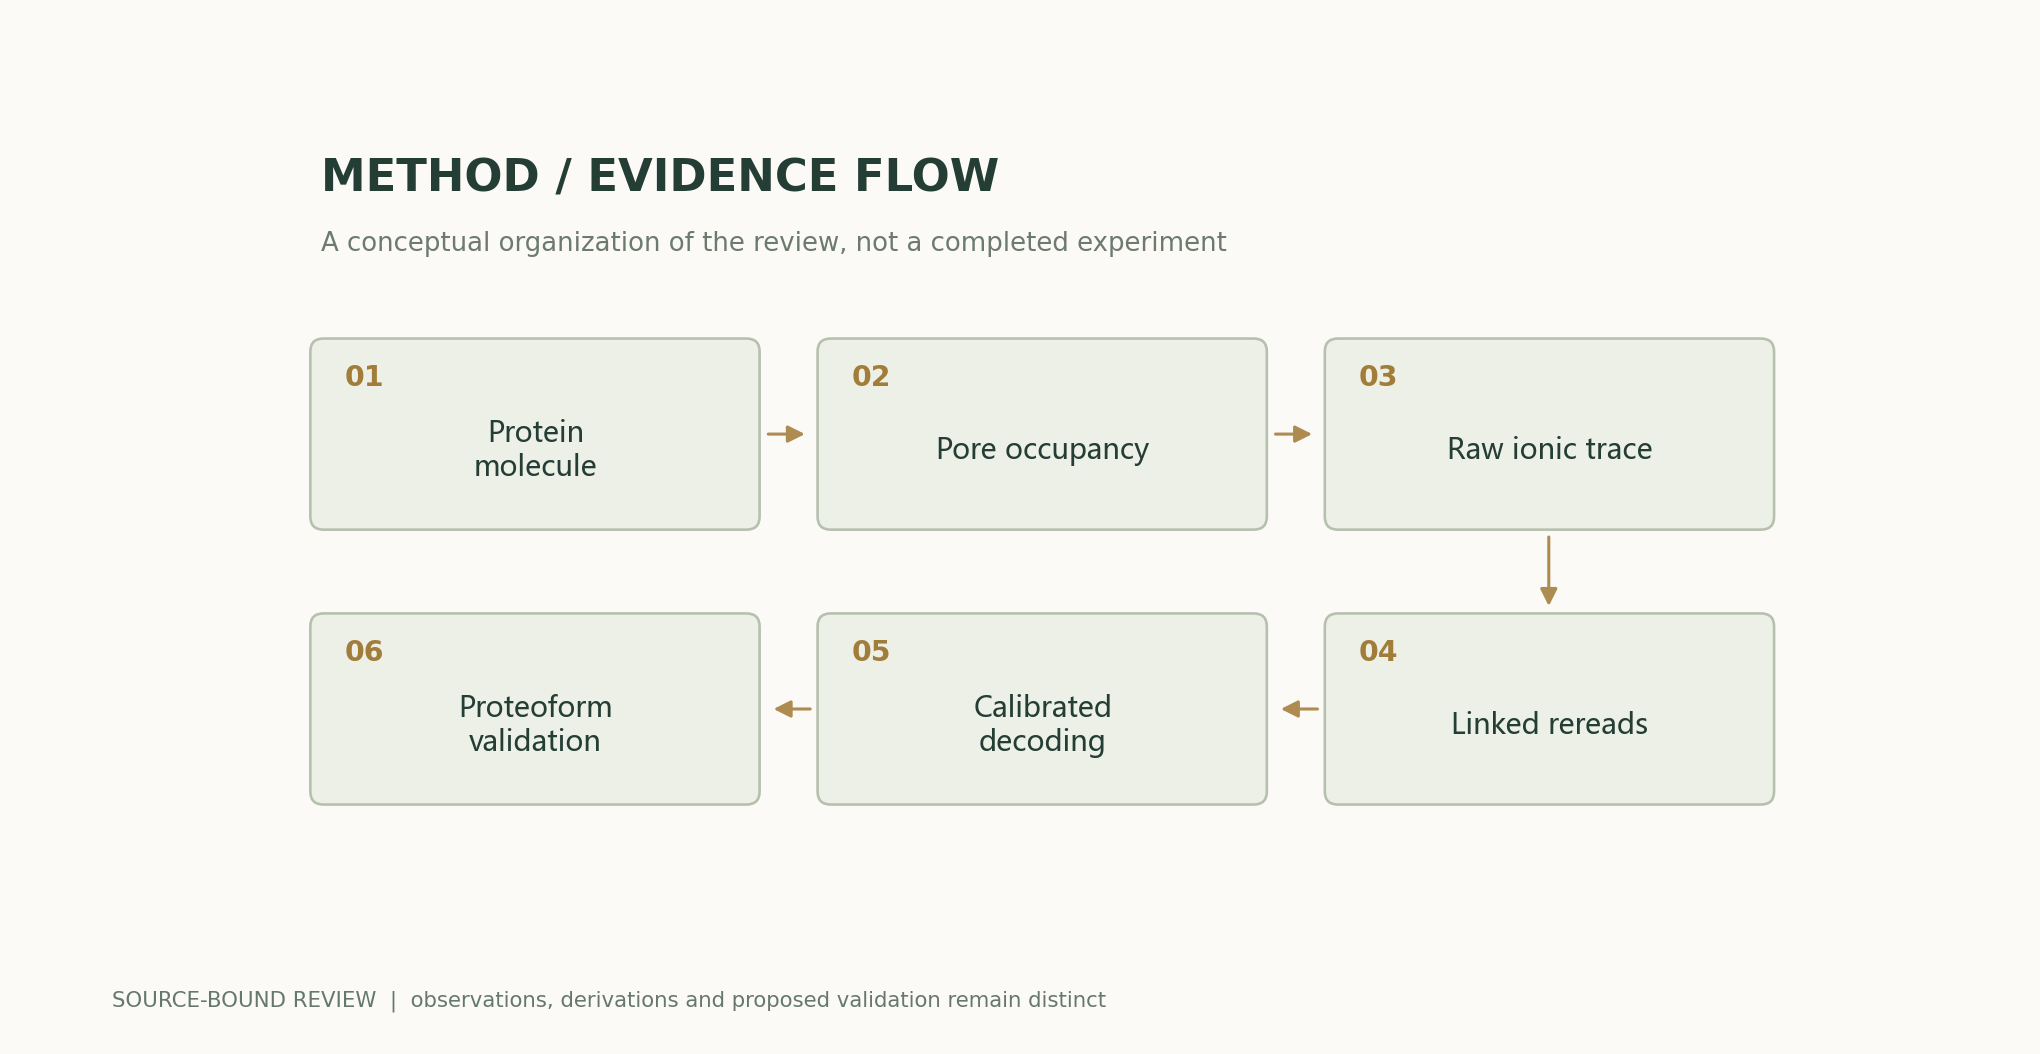
解析図と数値例
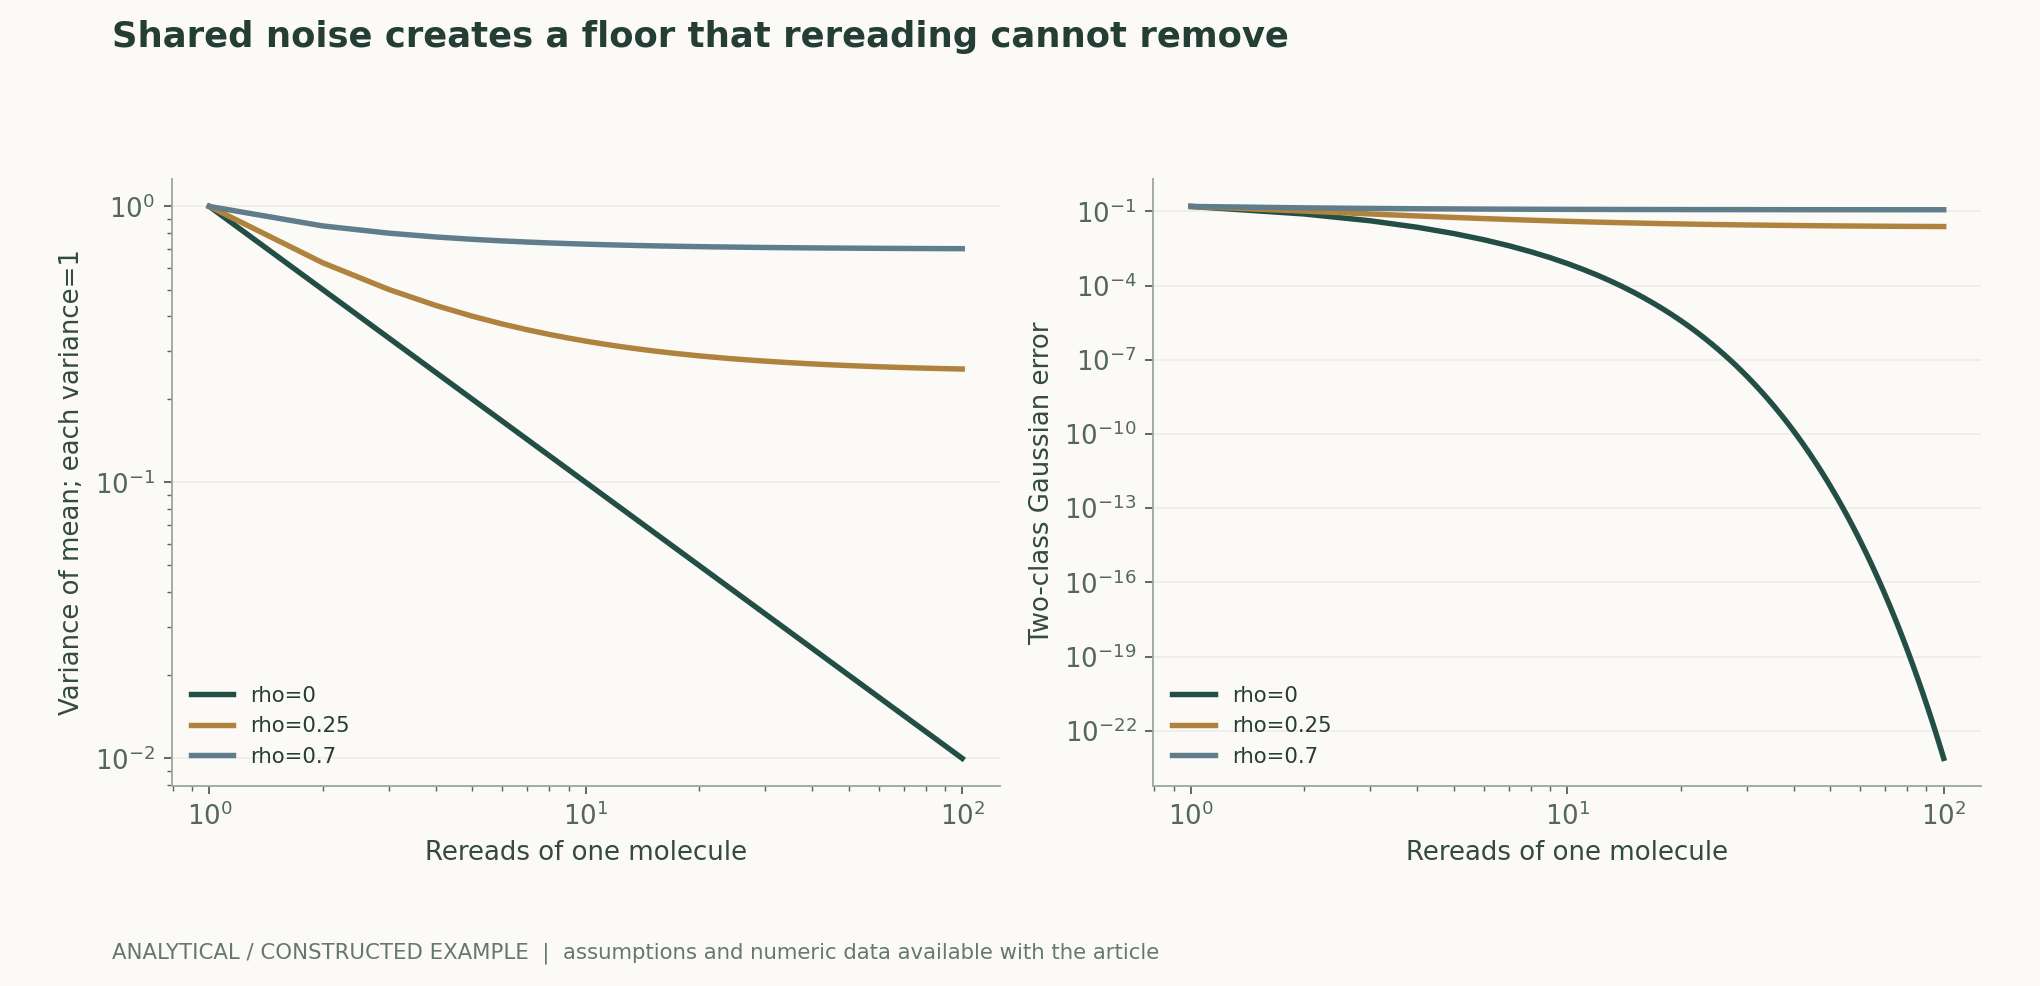
再計算可能な計算例
n=100、rho=0.25のとき、平均の分散は0.2575であり、独立性を仮定した場合の0.01ではない。nが無限大に近づくと分散はrhoに近づく。二クラスのガウス誤りは、限定された信号モデルにすぎない。
方法の比較
| 方法または評価基準 | 直接制約される事項 | なお必要なエビデンス |
|---|---|---|
| 既知バーコードの分類 | 有限候補間の識別 | 候補ライブラリ外への汎化 |
| 残基置換の検出 | 固定された文脈における差 | 任意の文脈における一意な同一性 |
| 同一分子の再読み取り | 独立ノイズの低減 | 共通オフセットと相関 |
| ポア・バッチ単位のホールドアウト | 測定条件間の転移 | まったく新しい配列ファミリー |
| 長鎖の復元 | 位置ごとの誤りと全鎖の誤り | カバレッジの欠落と長さバイアス |
| 修飾解析 | 分子の組合せ状態 | 化学標準と直交的な確認 |
再検証と実験計画
- 分類、差の検出、デノボ復元のいずれを課題とするかを定め、固定する。
- 各トレースが属する分子、ポア、バッチを保存する。
- 分子および配列ファミリー単位で訓練とテストを分離する。
- アラインメントとノイズ除去の処理を固定してから、盲検テストのラベルを開示する。
- 再読み取り間の相関と独立分子のカバレッジを計算する。
- 位置ごとの誤り、全鎖の誤り、読み取り欠落率を併せて報告する。
- 独立した標準を用いて修飾と信頼度較正を確認する。
- 公開可能な生トレース、除外項目、正確なモデルバージョンを共有する。
適用範囲と限界
- 新たなナノポア測定やタンパク質測定は行っていない。
- ガウス誤りモデルはすべての生物物理過程を記述するものではない。
- 等相関の仮定は解析的な反例にのみ用いる。
- 原研究の候補は天然プロテオームを対象とする課題とは異なる。
- 再読み取りトレース数は独立分子数ではない。
原研究のエビデンスと適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| 同一分子の反復読み取りは、制御された候補間の識別を改善する。 | 限定されたコンストラクトと候補の文脈。 | ナノポアを用いた単一アミノ酸分解能での単一タンパク質の複数回再読み取り要旨;再読み取りによる分類 |
| アンフォールディングと移送は、長いタンパク質鎖および修飾に関連する読み出しを可能にする。 | 特定の人工コンストラクトとモデル条件。 | 長いタンパク質鎖の複数回通過による単一分子ナノポア読み取り要旨;図2–6 |
検証に値する研究課題
- 異なるポアで再測定した後、共通ノイズは低下するか。
- 未知の配列ファミリーでは全鎖の誤りがどのように変化するか。
- 再読み取りの精度と希少プロテオフォームのカバレッジをどのように同時最適化できるか。
一次資料と主張の対応
- Multiple rereads of single proteins at single–amino acid resolution using nanoporesHenry Brinkerhoff, Albert S. W. Kang, Jingqian Liu, Aleksei Aksimentiev, Cees Dekker · 2021-12-17Abstract; reread classification
- Multi-pass, single-molecule nanopore reading of long protein strandsKeisuke Motone, Daphne Kontogiorgos-Heintz, Jasmine Wee, Kyoko Kurihara, Sangbeom Yang, Gwendolin Roote, et al. · 2024-09-11Abstract; Figs. 2–6; VR classification
引用と原稿のエクスポート
著者、バージョン、出典
Codex(AI)が執筆した、出典付きの研究レビューおよび独自の解析である。原論文の実験は原研究チームに帰属し、本記事の計算は記載した数式と明示した仮定のみを検証する。当サイトには現時点で、本記事に対する独立した査読、または本記事独自のモデル、臨床実験、物理実験の記録はない。
初回公開:学際的な科学的エビデンスを掘り下げる特集。節ごとの出典、原研究のエビデンス、著者による解析の境界を保持する。
概念的な表紙画像はImageGenによって生成された。科学図は付属のコードと数値ファイルから作成され、各図の説明で仮定と測定上の定義を個別に明示している。
表紙と科学図の出典 · データ、出典、仮定 · Python · 再計算可能なコード · 公開・バージョン履歴
ソースのリビジョン: 500575872cce7c4b9c4062a12bb0692eb580c2da