
Resumen
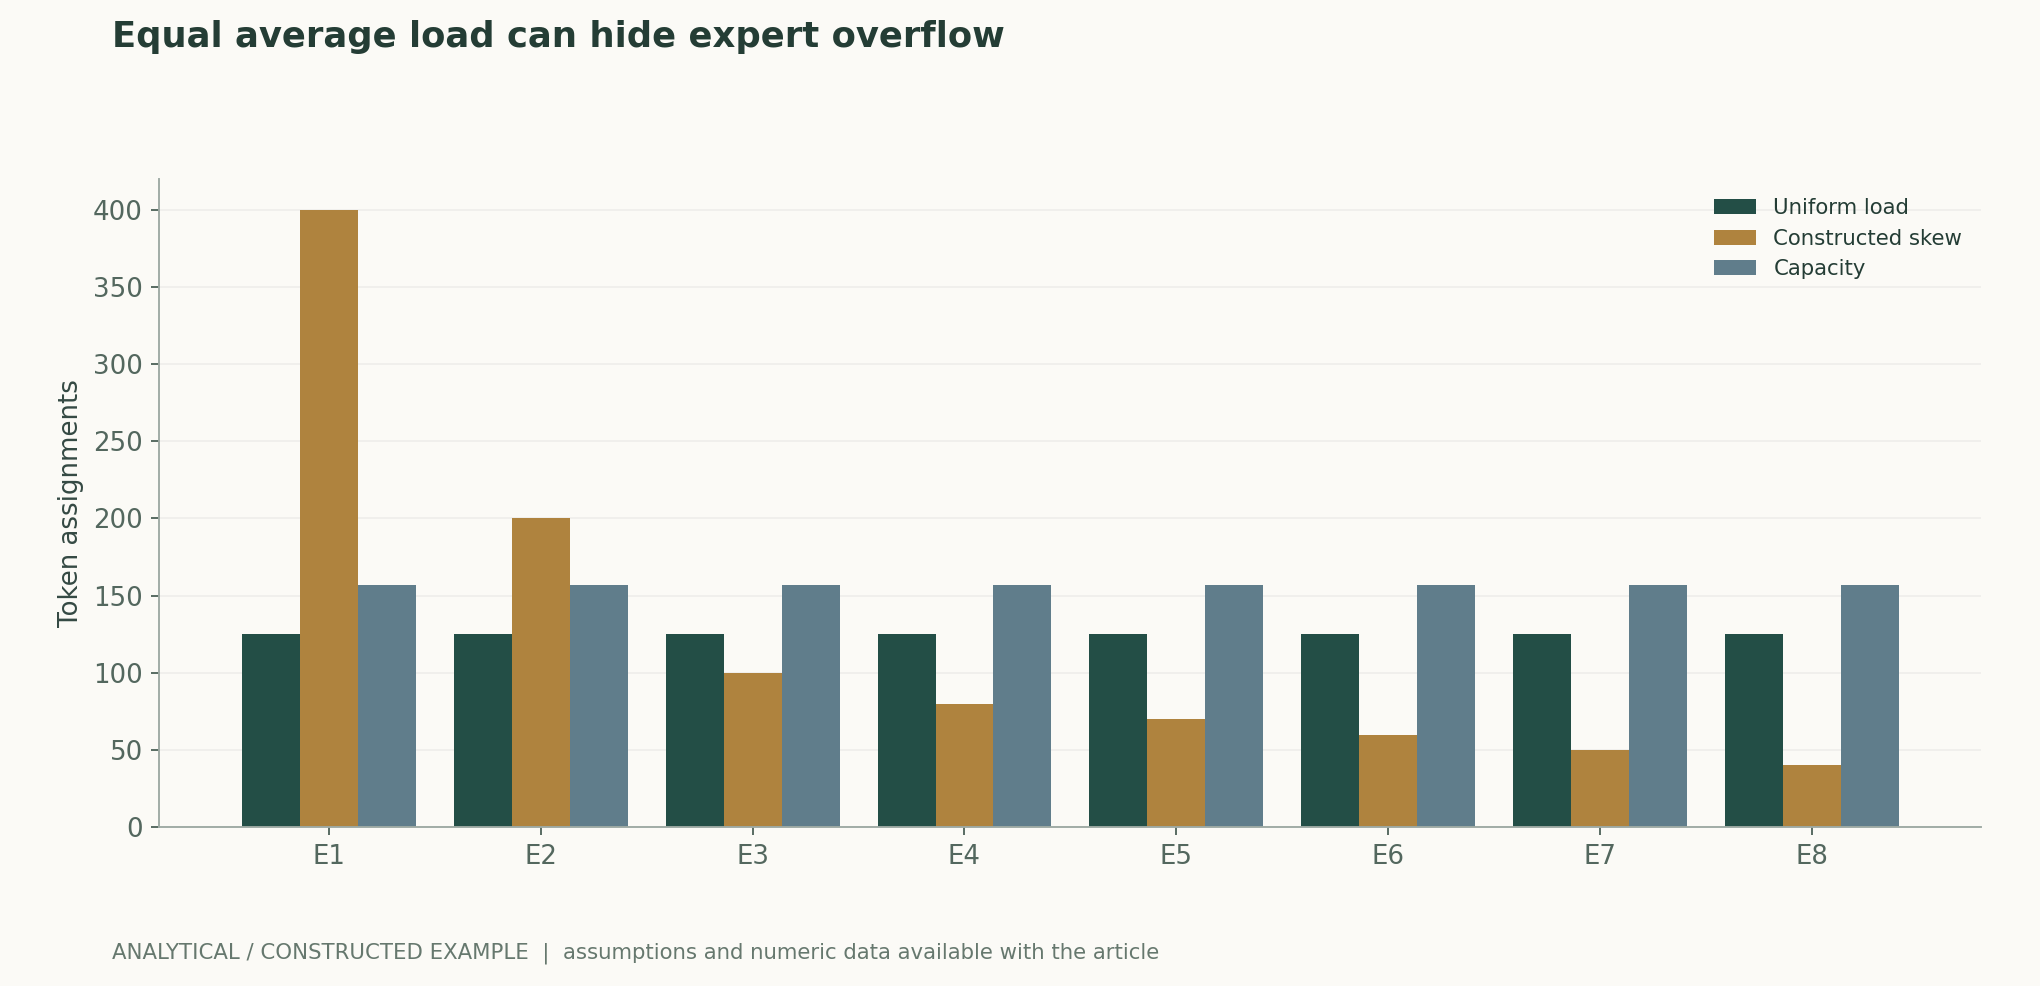
Los modelos de expertos dispersos amplían la capacidad paramétrica seleccionando un subconjunto de expertos para cada token, pero la propia selección introduce problemas de carga, capacidad y comunicación entre dispositivos. Este artículo analiza las relaciones entre los pesos de enrutamiento, el factor de capacidad, el objetivo auxiliar de equilibrio y la ubicación de los expertos, y propone un plan de verificación que registre conjuntamente el cómputo efectivo, el descarte o reenrutamiento, el tiempo de espera y la calidad. La figura adjunta realiza un cálculo determinista de capacidad con 8 expertos y 1000 tokens. Todas las cargas se han construido explícitamente y no representan distribuciones de enrutamiento ni mediciones de rendimiento de ningún modelo entrenado.[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati[3] Attention Is All You Need
Traducción del resumen original en inglés
Los modelos dispersos de mezcla de expertos asignan el cómputo de los tokens mediante enrutamiento aprendido. Esta revisión distingue la capacidad total, el cómputo activado, el desbordamiento de los expertos y la comunicación. Un cálculo determinista de cargas compara el enrutamiento uniforme y el sesgado bajo un factor de capacidad declarado; no se trata de un experimento con un enrutador entrenado. La evaluación debe informar conjuntamente de la calidad del modelo, los tokens descartados o reenrutados, la comunicación y la utilización de los dispositivos.
1. La capacidad total y el cómputo activado en cada paso constituyen presupuestos distintos
Al sustituir una capa densa de propagación hacia delante por varios expertos, cada token pasa únicamente por unos pocos expertos, lo que permite aumentar los parámetros totales sin un incremento proporcional del cómputo activado. Sin embargo, la atención, el enrutamiento, la normalización y las capas compartidas restantes deben seguir ejecutándose. Los parámetros totales afectan al almacenamiento, los puntos de control y los estados del optimizador, mientras que los parámetros activados reflejan mejor una parte del coste aritmético; ninguno de los dos representa por sí solo la tasa de procesamiento del entrenamiento. Las comparaciones deben especificar el número de capas, el tamaño de los expertos, top-k, los expertos compartidos y la referencia densa, para evitar atribuir íntegramente al mecanismo disperso las mejoras debidas a mayores recursos de entrenamiento.[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati
2. El enrutamiento convierte la selección local en un problema global de colas
El enrutador genera puntuaciones de expertos para la entrada, selecciona uno o varios expertos y combina sus resultados. Una puntuación elevada para un token no implica que el experto correspondiente siga teniendo capacidad disponible en ese lote. La capacidad suele determinarse a partir del número total de tokens de un grupo de enrutamiento, top-k y el número de expertos; los límites de los grupos, la partición entre dispositivos y el relleno modifican la utilización real. Si muchos tokens seleccionan al mismo experto, pueden producirse desbordamientos o esperas mientras otros expertos permanecen inactivos. Por tanto, informar únicamente de la carga media oculta los puntos de congestión; como mínimo, también deben comunicarse la carga máxima, los percentiles de la cola de la distribución y el número de excesos de capacidad.[1] Switch Transformers: Scaling to Trillion Parameter Mode
3. El objetivo de equilibrio mejora la utilización, pero modifica el problema de optimización
La pérdida auxiliar de equilibrio fomenta una utilización de los expertos y unas probabilidades de enrutamiento más uniformes, lo que puede aliviar la congestión persistente en unos pocos expertos; al mismo tiempo, limita la libertad con la que el enrutador puede establecer una división del trabajo a partir de los datos. El coeficiente de equilibrio, el ruido, las reglas de selección y la fase de entrenamiento influyen en este compromiso. Una carga uniforme no demuestra que los expertos hayan aprendido diferencias útiles ni que la calidad sea máxima. Es necesario explorar distintos valores del coeficiente de equilibrio con los mismos datos y presupuesto de cómputo, midiendo conjuntamente la calidad de las tareas, los desbordamientos y el uso de los expertos, para determinar si las mejoras proceden de reducir los descartes y no únicamente de cambios en las estadísticas de enrutamiento.[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati
4. La comunicación de todos a todos puede consumir el ahorro aritmético
Cuando los expertos se distribuyen entre varios dispositivos, las representaciones de los tokens deben reordenarse según el enrutamiento, enviarse, procesarse y devolverse. El volumen de comunicación depende de la dimensión oculta, la precisión, top-k y la ubicación de los expertos; además, los mensajes pequeños, los lotes de longitudes diferentes y el ancho de banda entre dispositivos influyen en la latencia. Dos despliegues con el mismo número de operaciones aritméticas pueden tener tiempos de espera de comunicación completamente distintos. Deben registrarse por separado los tiempos de distribución, cómputo de los expertos, combinación y sincronización, e indicarse la topología real y la estrategia de paralelismo; los resultados de multiplicación dispersa en un solo acelerador no pueden representar directamente el rendimiento del entrenamiento en varias máquinas ni del servicio en línea.[2] GShard: Scaling Giant Models with Conditional Computati[1] Switch Transformers: Scaling to Trillion Parameter Mode
5. Los excesos de capacidad deben formar parte del registro de calidad
Cuando un experto alcanza su capacidad máxima, la implementación puede descartar esa ruta, conservar únicamente la conexión residual o reenrutar hacia un experto de siguiente preferencia. Las distintas estrategias modifican el cómputo real del modelo y pueden afectar de forma desigual a lenguas minoritarias, tareas poco frecuentes o secuencias largas. Una tasa global de descarte baja también puede ocultar tasas elevadas en grupos específicos. La evaluación debe estratificarse por tarea, longitud e idioma, y deben conservarse las diferencias entre las rutas candidatas y las realmente ejecutadas. Si el entrenamiento y la inferencia emplean capacidades o algoritmos de selección diferentes, deben considerarse condiciones de funcionamiento distintas; la comparación no puede basarse únicamente en que los archivos de pesos sean idénticos.[1] Switch Transformers: Scaling to Trillion Parameter Mode
6. Las conclusiones sobre costes deben incorporar restricciones conjuntas de sistema y calidad
La pregunta adecuada para la comparación es cuánto cómputo de entrenamiento, memoria de dispositivo, comunicación y latencia requiere un enfoque disperso para alcanzar los mismos objetivos de calidad y servicio. Ampliar los parámetros no demuestra automáticamente una mayor eficiencia muestral, y la activación dispersa tampoco demuestra automáticamente una reducción del coste total. El gráfico de cargas construido en este artículo solo ilustra cómo se producen los excesos de capacidad. Para los enrutadores reales, deben conservarse estadísticas de los grupos de cada capa sin registrar el texto privado de los tokens, y después confirmar los cuellos de botella mediante ejecuciones repetidas y mediciones a nivel de dispositivo. Separar los recuentos verificables de las mediciones reales del sistema permite explicar las diferencias de rendimiento.[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati[3] Attention Is All You Need
Ecuaciones fundamentales y derivaciones
(1) Las salidas de los expertos se combinan utilizando los pesos posteriores a la selección; la implementación especifica por separado la normalización, el tratamiento de los excesos de capacidad y las rutas compartidas.
LaTeX
y(x)=\sum_{e\in\operatorname{TopK}(g(x))}p_e(x)E_e(x)(2) T es el número de tokens del mismo grupo de enrutamiento, k es el número de envíos por token, E es el número de expertos y c es el factor de capacidad; O cuenta los envíos que exceden la capacidad y no equivale automáticamente al número final de tokens descartados.
LaTeX
C_e=\left\lceil c\frac{Tk}{E}\right\rceil,\qquad O=\sum_e\max(0,L_e-C_e)(3) Los puntos de congestión se cuantifican mediante la razón entre la carga del experto más ocupado y la carga media ideal. Dos lotes con exactamente la misma carga media pueden presentar puntos de congestión distintos.
LaTeX
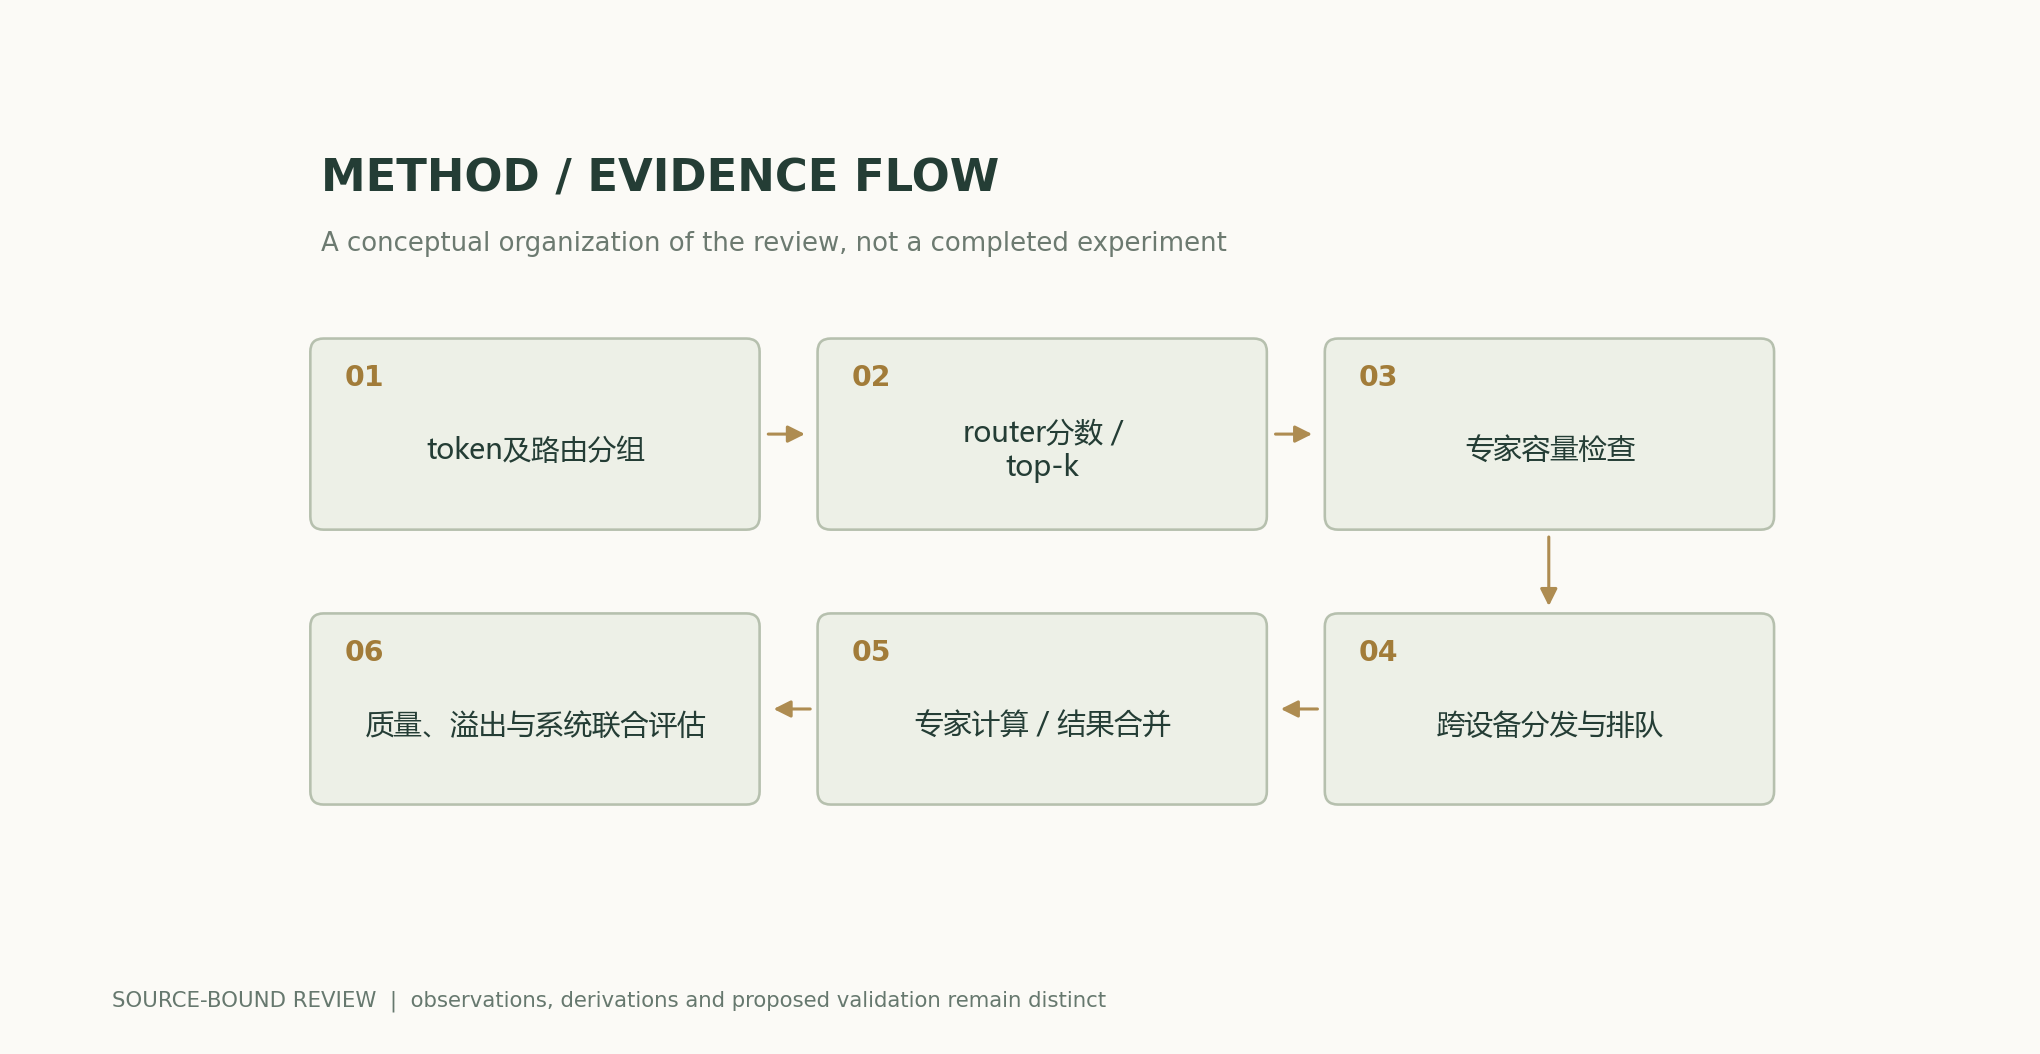
\rho_{\max}=\frac{\max_e L_e}{Tk/E}Flujo metodológico y de evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto reproducible
Ambos grupos tienen 1000 envíos y una capacidad de 157. El grupo uniforme no presenta excesos de capacidad; en el grupo sesgado, un total de 286 envíos excede la capacidad. El descarte final, el reenrutamiento y la calidad dependen de la implementación y no quedan determinados automáticamente por los recuentos.
Comparación de métodos
| Método o criterio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Parámetros totales | Desglosar todos los expertos, las capas compartidas y los estados del optimizador | No equivalen al cómputo activado por token |
| Equilibrio del enrutamiento | Registrar la carga de cada experto y los desbordamientos estratificados | La uniformidad no garantiza una división eficaz del trabajo entre expertos |
| Factor de capacidad | Fijar los grupos de enrutamiento y las reglas de tratamiento de desbordamientos | Aumentar la capacidad también incrementa la memoria o el relleno |
| Tasa de procesamiento distribuido | Medir la distribución, el cómputo, la combinación y la latencia en los percentiles altos de la distribución. | Los FLOPs no caracterizan la comunicación ni la espera |
Plan de verificación y experimentación
- Fijar la referencia densa, la estructura de capas, el tamaño de los expertos, top-k y los datos de entrenamiento, y publicar las reglas para igualar los presupuestos.
- Especificar los grupos de enrutamiento de tokens, el factor de capacidad, la normalización de los pesos y el tratamiento al alcanzar la capacidad máxima.
- Conservar la carga de cada experto, la razón entre el máximo y la media y los desbordamientos de cada capa, estratificados por idioma y longitud.
- Explorar distintos valores del coeficiente de equilibrio y de la capacidad, comparando conjuntamente la calidad y las rutas de tokens realmente ejecutadas.
- Registrar la topología de los dispositivos, los bytes de comunicación, la proporción de relleno, el máximo de memoria y el tiempo empleado en cada etapa.
- Repetir las mediciones con tamaños de lote y distribuciones de longitud del servicio real, distinguiendo los recuentos ilustrativos de este artículo de la tasa de procesamiento en producción.
Ámbito de aplicación y limitaciones
- Las cargas ilustrativas no proceden de un modelo entrenado.
- La ecuación de capacidad depende de la definición de los grupos de enrutamiento.
- Los parámetros totales y el cómputo activado no representan el gasto total.
- El equilibrio, la especialización y la calidad de las tareas deben medirse empíricamente de forma conjunta.
Fuentes primarias y afirmaciones correspondientes
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, , · 2021-01-11Abstract; 原文方法、理论和实验章节见作者原始论文链接
- GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding, , , , , , , , · 2020-06-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autoría, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas a partir de la bibliografía primaria indicada. Este sitio no dispone de registros de revisión independiente por pares ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag no cambia. El texto, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se presenta separada de las figuras científicas; estas se calculan mediante ecuaciones públicas y supuestos explícitos, y los resultados de los artículos originales se atribuyen a sus fuentes.
Autoría, versión e historial de correcciones · /guides/sparse-mixture-experts/v1/
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770