
要旨
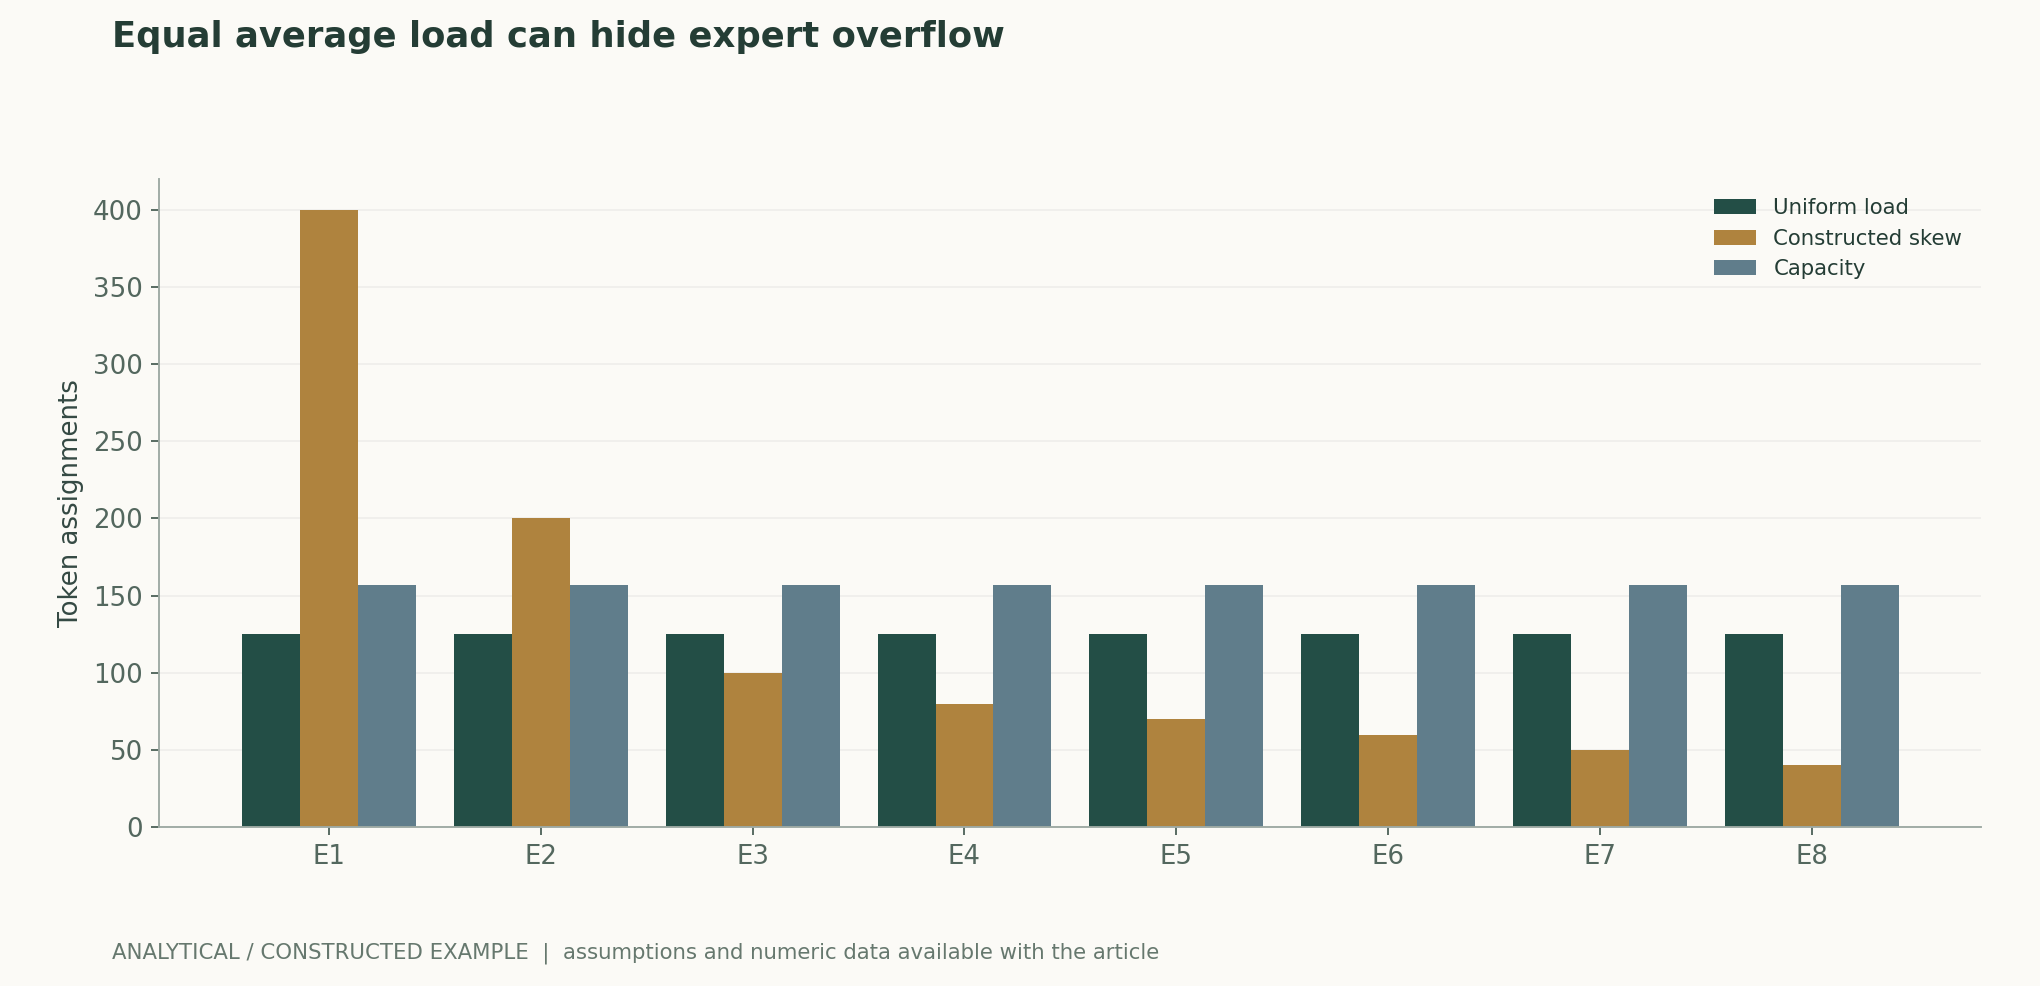
疎なエキスパートモデルは、トークンごとに一部のエキスパートを選択することでパラメータ容量を拡大するが、選択そのものが負荷、容量、デバイス間通信の問題をもたらす。本稿では、ルーティング重み、容量係数、補助的な均衡化目的関数、エキスパート配置の関係を分析し、実効的な計算、破棄または再ルーティング、待ち時間、品質を併せて記録する検証計画を提案する。図では、8個のエキスパートと1000個のトークンを用いて決定論的な容量計算を行う。すべての負荷は明示的に構成したものであり、学習済みモデルのルーティング分布や性能測定値ではない。[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati[3] Attention Is All You Need
英語要旨の日本語訳
疎な混合エキスパートモデルは、学習されたルーティングを通じてトークンの計算を割り当てる。本レビューでは、総容量、活性化計算量、エキスパートの容量超過、通信を区別する。決定論的な負荷計算により、明示した容量係数の下で均一なルーティングと偏りのあるルーティングを比較する。これは学習済みルーターを用いた実験ではない。評価では、モデル品質、破棄または再ルーティングされたトークン、通信、デバイス利用率を併せて報告しなければならない。
1. 総容量と各ステップの活性化計算量は別個の予算である
密なフィードフォワード層を複数のエキスパートに置き換えると、各トークンは少数のエキスパートだけを通過するため、活性化計算量を比例的に増やすことなく総パラメータ数を増加させられる。ただし、残りの注意機構、ルーティング、正規化、共有層は依然として実行する必要がある。総パラメータ数はストレージ、チェックポイント、オプティマイザの状態に影響し、活性化パラメータ数は演算コストの一部をよりよく反映するが、いずれも単独では学習スループットを表せない。比較では、層数、エキスパートのサイズ、top-k、共有エキスパート、密なベースラインを明示し、学習資源の追加による利得をすべて疎な機構に帰属させないようにすべきである。[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati
2. ルーティングは局所的な選択を大域的な待ち行列問題に変える
ルーターは入力に対するエキスパートのスコアを生成し、単一または複数のエキスパートを選択して結果を結合する。あるトークンに対するスコアが高くても、対応するエキスパートにそのバッチで利用可能な容量が残っているとは限らない。容量は通常、同一ルーティンググループ内の総トークン数、top-k、エキスパート数に基づいて決定される。グループの境界、デバイスの分割、パディングはいずれも実際の利用率を変化させる。多数のトークンが同じエキスパートを選択すると、容量超過や待ちが発生する一方で、ほかのエキスパートが遊休状態になる可能性がある。したがって、平均負荷だけを示すと負荷の集中が隠れるため、少なくとも最大負荷、裾の分位点、容量超過件数も報告すべきである。[1] Switch Transformers: Scaling to Trillion Parameter Mode
3. 均衡化の目的関数は利用率を改善するが、最適化問題を変える
補助的な均衡化損失は、エキスパートの利用率とルーティング確率をより均一にするよう促し、少数のエキスパートにおける持続的な混雑を緩和しうる。同時に、ルーターがデータに応じて自由に分業を形成する方法を制約する。均衡化係数、ノイズ、選択規則、学習段階がこのトレードオフに影響する。負荷が均一であることは、エキスパートが有用な差異を学習したことも、品質が最高であることも証明しない。同一のデータと計算予算の下で均衡化係数を走査し、タスク品質、容量超過、エキスパートの利用を同時に測定することで、利得が単なるルーティング統計の変化ではなく、破棄の減少に由来するかを確認する必要がある。[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati
4. 全対全通信が演算量の削減効果を打ち消す可能性がある
エキスパートを複数のデバイスに配置すると、トークン表現をルーティングに従って並べ替え、送信し、計算した後に戻す必要がある。通信量は隠れ次元、精度、top-k、エキスパート配置に依存し、小さなメッセージ、長さの異なるバッチ、デバイス間の帯域幅もレイテンシに影響する。算術演算数が同じでも、異なるデプロイ構成では通信待ち時間がまったく異なる可能性がある。配送、エキスパート計算、結合、同期の時間を個別に記録し、実際のトポロジーと並列化戦略を報告すべきである。単一アクセラレータでの疎な乗算の結果は、複数マシンによる学習やオンラインサービスの性能を直接表すものではない。[2] GShard: Scaling Giant Models with Conditional Computati[1] Switch Transformers: Scaling to Trillion Parameter Mode
5. 容量超過を品質記録の一部に含める必要がある
エキスパートが容量上限に達した場合、実装によっては、その経路を破棄する、残差経路のみを残す、あるいは次候補のエキスパートへ再ルーティングする。異なる方策はモデルの実際の計算を変化させ、少数言語、まれなタスク、長い系列に不均等な影響を及ぼす可能性がある。全体の破棄率が低くても、特定の集団における高い破棄率が隠れている場合がある。評価はタスク、長さ、言語ごとに層別化し、候補経路と実際に実行された経路の差異を保存する必要がある。学習と推論で容量や選択アルゴリズムが異なる場合は、異なる動作条件として扱うべきであり、重みファイルが同一であることだけに基づいて比較してはならない。[1] Switch Transformers: Scaling to Trillion Parameter Mode
6. コストに関する結論にはシステムと品質の同時制約を含めるべきである
適切な比較で問うべきなのは、同じ品質目標とサービス目標を達成する際に、疎な方式がどれだけの学習計算量、デバイスメモリ、通信、レイテンシを必要とするかである。パラメータの拡大はサンプル効率の向上を自動的に証明せず、疎な活性化も総コストの低下を自動的に証明しない。本稿で構成した負荷図は、容量超過がどのように生じるかを示すためだけのものである。実際のルーターでは、非公開のトークン本文を記録せずに各層のグループ統計を保持し、反復実行とデバイス単位の測定によってボトルネックを確認すべきである。検証可能な計数とシステムの実測を分離することで、性能差を説明できる。[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati[3] Attention Is All You Need
主要な数式と導出
(1) エキスパートの出力は選択後の重みに従って結合する。正規化方式、容量超過の処理、共有経路は実装で別途規定する。
LaTeX
y(x)=\sum_{e\in\operatorname{TopK}(g(x))}p_e(x)E_e(x)(2) Tは同一ルーティンググループ内のトークン数、kはトークンごとの配送回数、Eはエキスパート数、cは容量係数である。Oは容量を超える配送を数えるものであり、最終的に破棄されるトークン数と自動的に等しくなるわけではない。
LaTeX
C_e=\left\lceil c\frac{Tk}{E}\right\rceil,\qquad O=\sum_e\max(0,L_e-C_e)(3) 最も混雑しているエキスパートの負荷と理想的な平均負荷との比で負荷の集中を測る。平均負荷が完全に同じバッチ同士でも、負荷の集中は異なりうる。
LaTeX
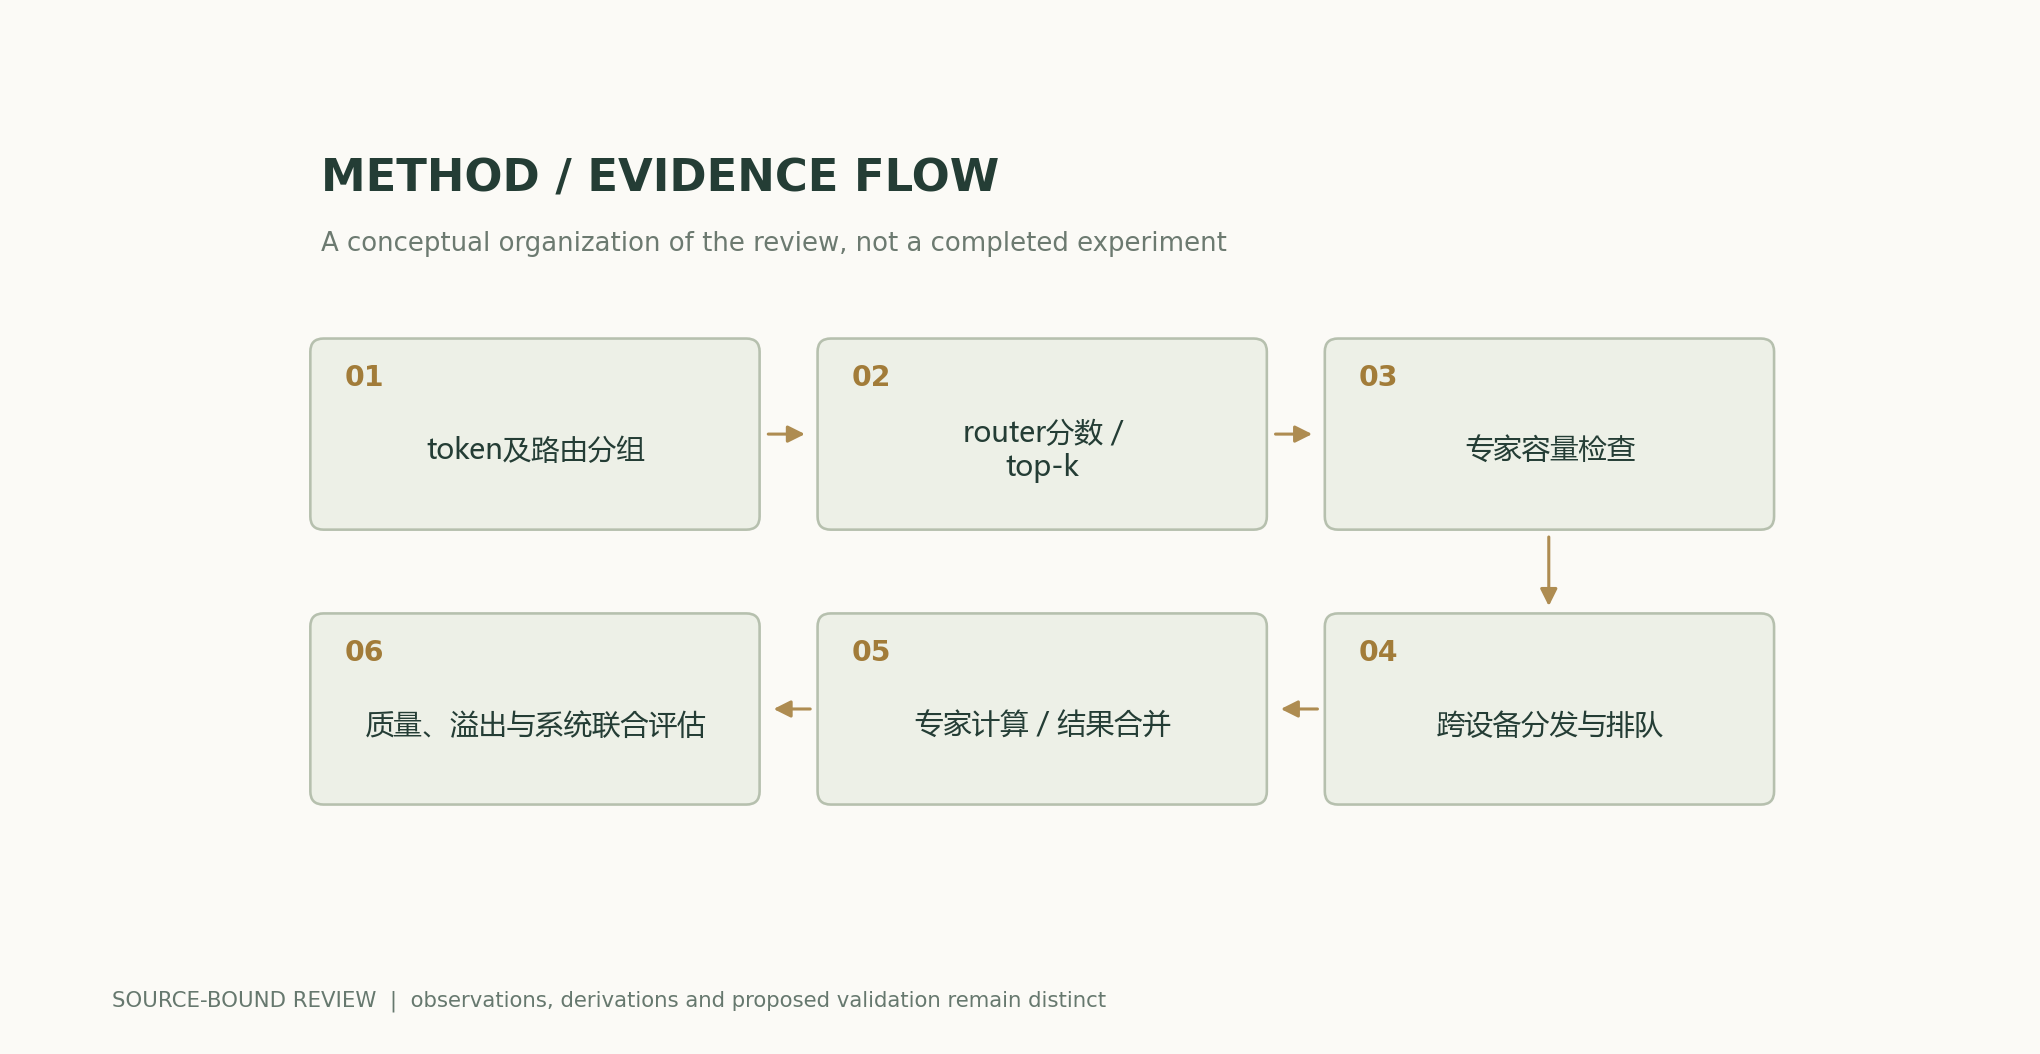
\rho_{\max}=\frac{\max_e L_e}{Tk/E}方法とエビデンスのフロー
解析図と数値例
再計算可能な例題
両グループの配送数はともに1000、容量はともに157である。均一なグループには容量超過がないが、偏りのあるグループでは計286件の配送が容量を超過する。最終的な破棄、再ルーティング、品質は実装に依存し、計数から自動的に決まるものではない。
方法の比較
| 方法または判断 | 制御変数と測定 | 成立しない条件と解釈 |
|---|---|---|
| 総パラメータ数 | 全エキスパート、共有層、オプティマイザの状態を分けて示す | トークンごとの活性化計算量とは等しくない |
| ルーティングの均衡 | エキスパートごとの負荷と層別化した容量超過を記録する | 均一性はエキスパートの有効な分業を保証しない |
| 容量係数 | ルーティンググループと容量超過の処理規則を固定する | 容量の増加はメモリまたはパディングも増加させる |
| 分散スループット | 配送、計算、結合、テールレイテンシを測定する | FLOPsでは通信と待ち時間を捉えられない |
検証と実験の計画
- 密なベースライン、層構造、エキスパートのサイズ、top-k、学習データを固定し、予算を一致させる規則を公開する。
- トークンのルーティンググループ、容量係数、重みの正規化、容量上限到達時の処理を明示する。
- 各層のエキスパートごとの負荷、最大負荷と平均負荷の比、容量超過を保存し、言語と長さで層別化する。
- 均衡化係数と容量を走査し、品質と実際に実行されたトークン経路を併せて比較する。
- デバイストポロジー、通信バイト数、パディング率、ピークメモリ使用量、各段階の所要時間を記録する。
- 実際のサービスのバッチサイズと長さ分布を用いて再測定し、本稿の計数による例示と本番環境のスループットを区別する。
適用範囲と限界
- 例示した負荷は学習済みモデルに由来しない。
- 容量の式はルーティンググループの定義に依存する。
- 総パラメータ数と活性化計算量は総費用を表さない。
- 均衡、専門化、タスク品質は併せて実測する必要がある。
一次資料と主張の対応
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, , · 2021-01-11Abstract; 原文方法、理论和实验章节见作者原始论文链接
- GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding, , , , , , , , · 2020-06-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
引用と原稿のエクスポート
著者、版、出典
AI支援による研究レビュー。Codex(AI)が、掲載した一次文献に基づいて執筆し、解析的な導出を行った。本サイトには、本稿について独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同じ場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前版の内容を維持している。
概念的な表紙画像と科学図は区別する。科学図は公開された数式と明示した仮定に基づいて計算し、原論文の結果にはすべて帰属を明記する。
著者、版、訂正履歴 · /guides/sparse-mixture-experts/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開・版の履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770