
摘要
稀疏专家以按token选择部分专家的方式扩大参数容量,但选择本身引入了负载、容量和跨设备通信问题。本文分析路由权重、容量因子、辅助均衡目标与专家放置之间的关系,并提出将有效计算、丢弃或重路由、等待时间和质量联合记录的验证方案。配图以8个专家和1000个token进行确定性容量核算,所有负载均为显式构造,不是任何已训练模型的路由分布或性能测量。[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati[3] Attention Is All You Need
English abstract
Sparse mixture-of-experts models allocate token computation through learned routing. This review separates total capacity, activated computation, expert overflow and communication. A deterministic load calculation compares uniform and skewed routing under a declared capacity factor; it is not a trained-router experiment. Evaluation must jointly report model quality, dropped or rerouted tokens, communication and device utilization.
1. 总容量与每步激活计算是两个预算
将一个稠密前馈层替换成多个专家后,每个token仅进入少数专家,可以在不同比例增加激活计算的情况下增加总参数。但其余注意力、路由、归一化和共享层仍需运行。总参数影响存储、检查点和优化器状态,激活参数更接近部分算术成本;两者都不能单独表示训练吞吐。对比时应明确层数、专家大小、top-k、共享专家以及稠密基线,防止把更多训练资源带来的收益完全归给稀疏机制。[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati
2. 路由把局部选择变成全局排队问题
路由器为输入产生专家分数,再选出一个或多个专家并组合结果。某个token的分数很高,并不意味着对应专家在这个批次还有容量。容量通常按一个路由分组内的token总数、top-k和专家数确定;分组边界、设备划分与padding都会改变实际利用率。若大量token选择同一专家,会造成溢出或等待,其他专家却可能空闲。因此只给平均负载会掩盖热点,至少还应报告最大负载、尾部分位数和容量溢出数量。[1] Switch Transformers: Scaling to Trillion Parameter Mode
3. 均衡目标改善利用率但改变优化问题
辅助均衡损失鼓励专家使用率与路由概率更加均匀,可以缓解少数专家长期拥塞;它同时也限制了路由器根据数据自由形成分工的方式。均衡系数、噪声、选择规则及训练阶段会影响折中。负载均匀不证明专家学习到了有用差异,也不证明质量最高。需要在相同数据和计算预算下扫描均衡系数,同时测任务质量、溢出和专家使用,观察收益是否来自减少丢弃,而非仅有路由统计上的变化。[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati
4. all-to-all通信可能吞掉算术节省
专家分布到多张设备时,token表示需要按路由重排、发送、计算再返回。通信量与隐藏维度、精度、top-k及专家放置有关,且小消息、不同长度批次和设备间带宽会影响时延。算术操作数相同的两个部署,可能有完全不同的通信等待。应分别记录分发、专家计算、合并及同步时间,并报告实际拓扑和并行策略;单卡稀疏乘法结果不能直接代表多机训练或在线服务表现。[2] GShard: Scaling Giant Models with Conditional Computati[1] Switch Transformers: Scaling to Trillion Parameter Mode
5. 容量超限必须成为质量记录的一部分
当专家满载时,实现可能丢弃该路径、只保留残差,或重路由到次选专家。不同策略改变了实际模型计算,可能对少数语种、罕见任务或长序列产生不均匀影响。总体丢弃率较低也可能隐藏特定群体高丢弃。评估时要按任务、长度和语言分层,并保存从候选路由到真正执行路由的差异。训练和推理若采用不同容量或选择算法,应视为不同运行条件,不能只比较相同权重文件。[1] Switch Transformers: Scaling to Trillion Parameter Mode
6. 成本结论应包含系统和质量的联合约束
合适的比较问题是:在达到同一质量与服务目标时,稀疏方案需要多少训练计算、设备内存、通信和延迟。参数扩大不自动证明样本效率提高,稀疏激活也不自动证明总成本降低。本篇构造负载图只用于展示容量溢出如何出现;对真实路由器,应保留每层分组统计而不记录私有token正文,再用重复运行和设备级测量确认瓶颈。把可复核计数与系统实测分开,才能解释性能差异。[1] Switch Transformers: Scaling to Trillion Parameter Mode[2] GShard: Scaling Giant Models with Conditional Computati[3] Attention Is All You Need
核心公式与推导
(1) 专家输出按选择后的权重组合;归一化方式、容量溢出和共享路径由实现另外规定。
LaTeX
y(x)=\sum_{e\in\operatorname{TopK}(g(x))}p_e(x)E_e(x)(2) T是同一路由组token数,k是每token派发次数,E是专家数,c是容量因子;O计算超过容量的派发,而非自动等于最终丢弃的token数。
LaTeX
C_e=\left\lceil c\frac{Tk}{E}\right\rceil,\qquad O=\sum_e\max(0,L_e-C_e)(3) 用最繁忙专家相对于理想平均负载的比例衡量热点。平均负载完全相同的两个批次也可能有不同热点。
LaTeX
\rho_{\max}=\frac{\max_e L_e}{Tk/E}方法与证据流程
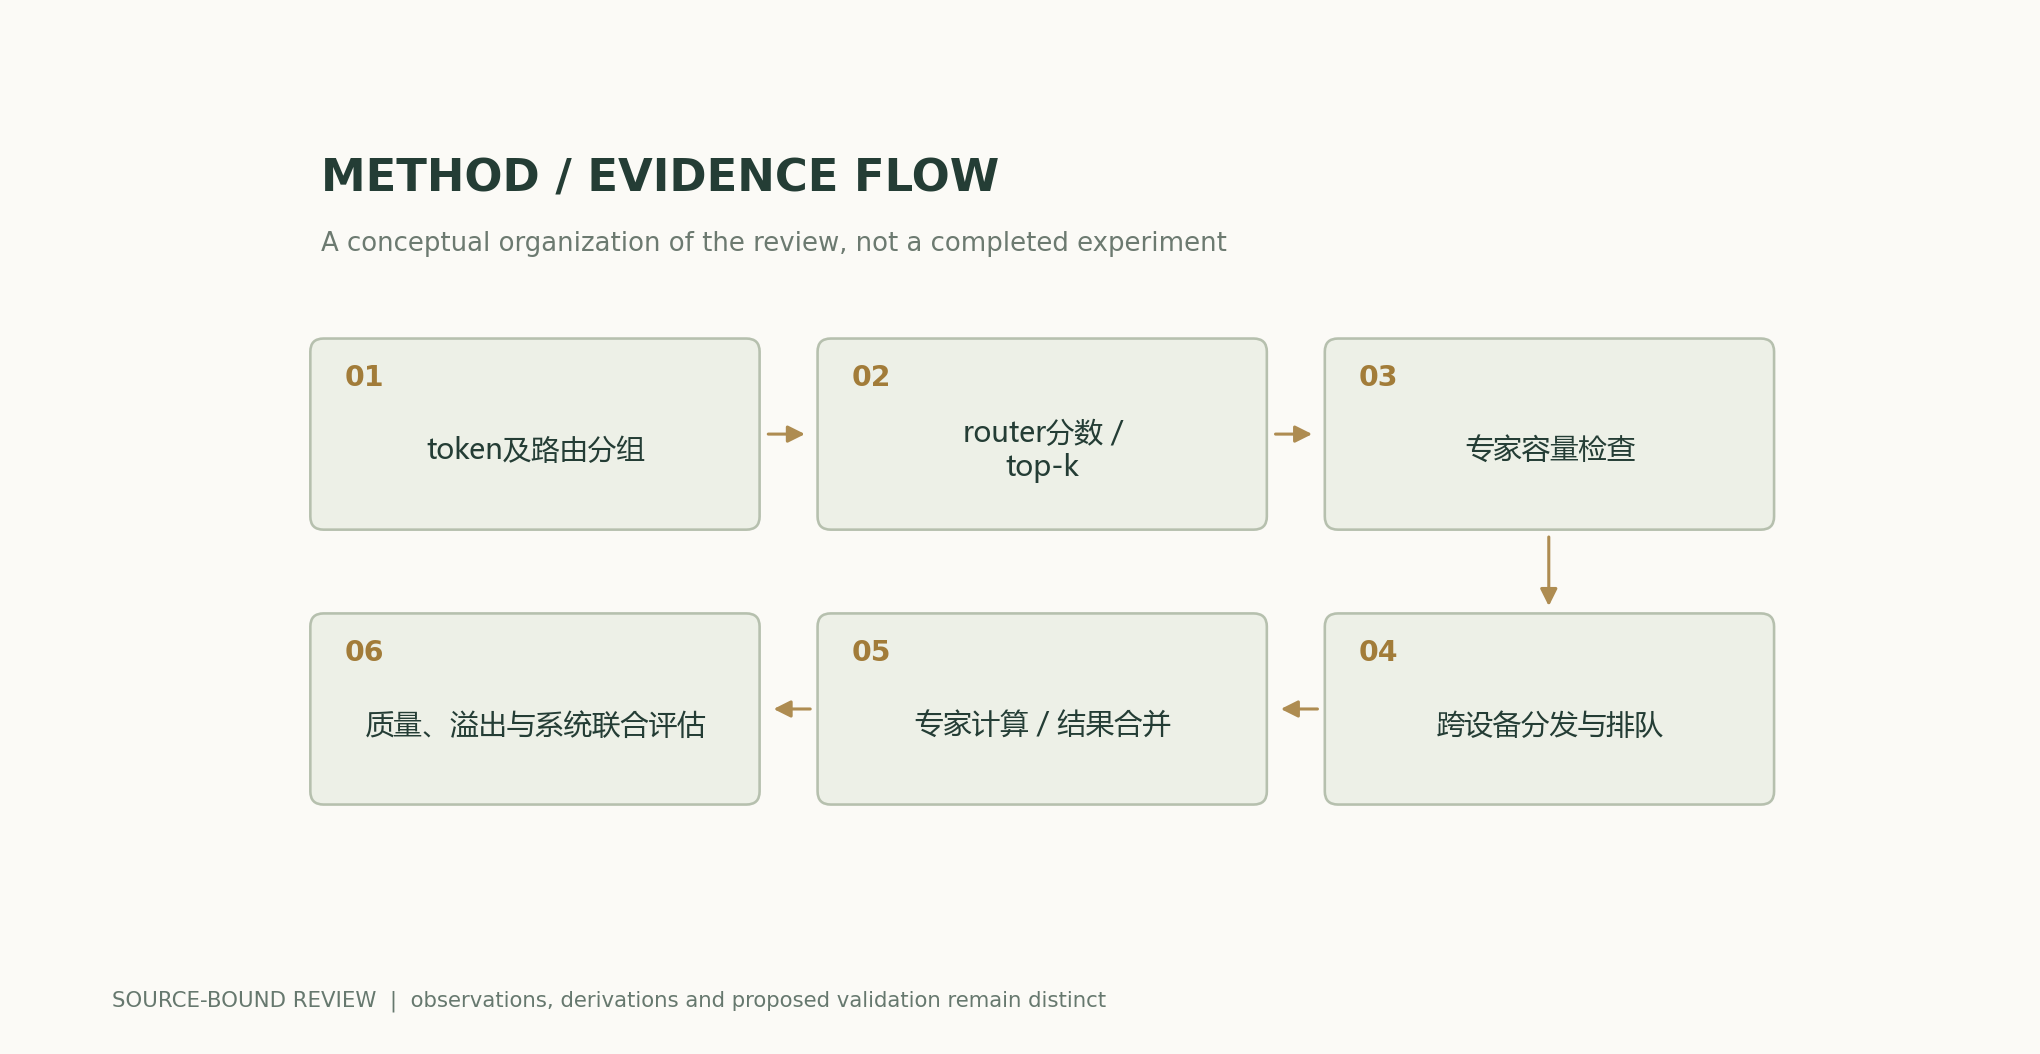
解析图与数值示例
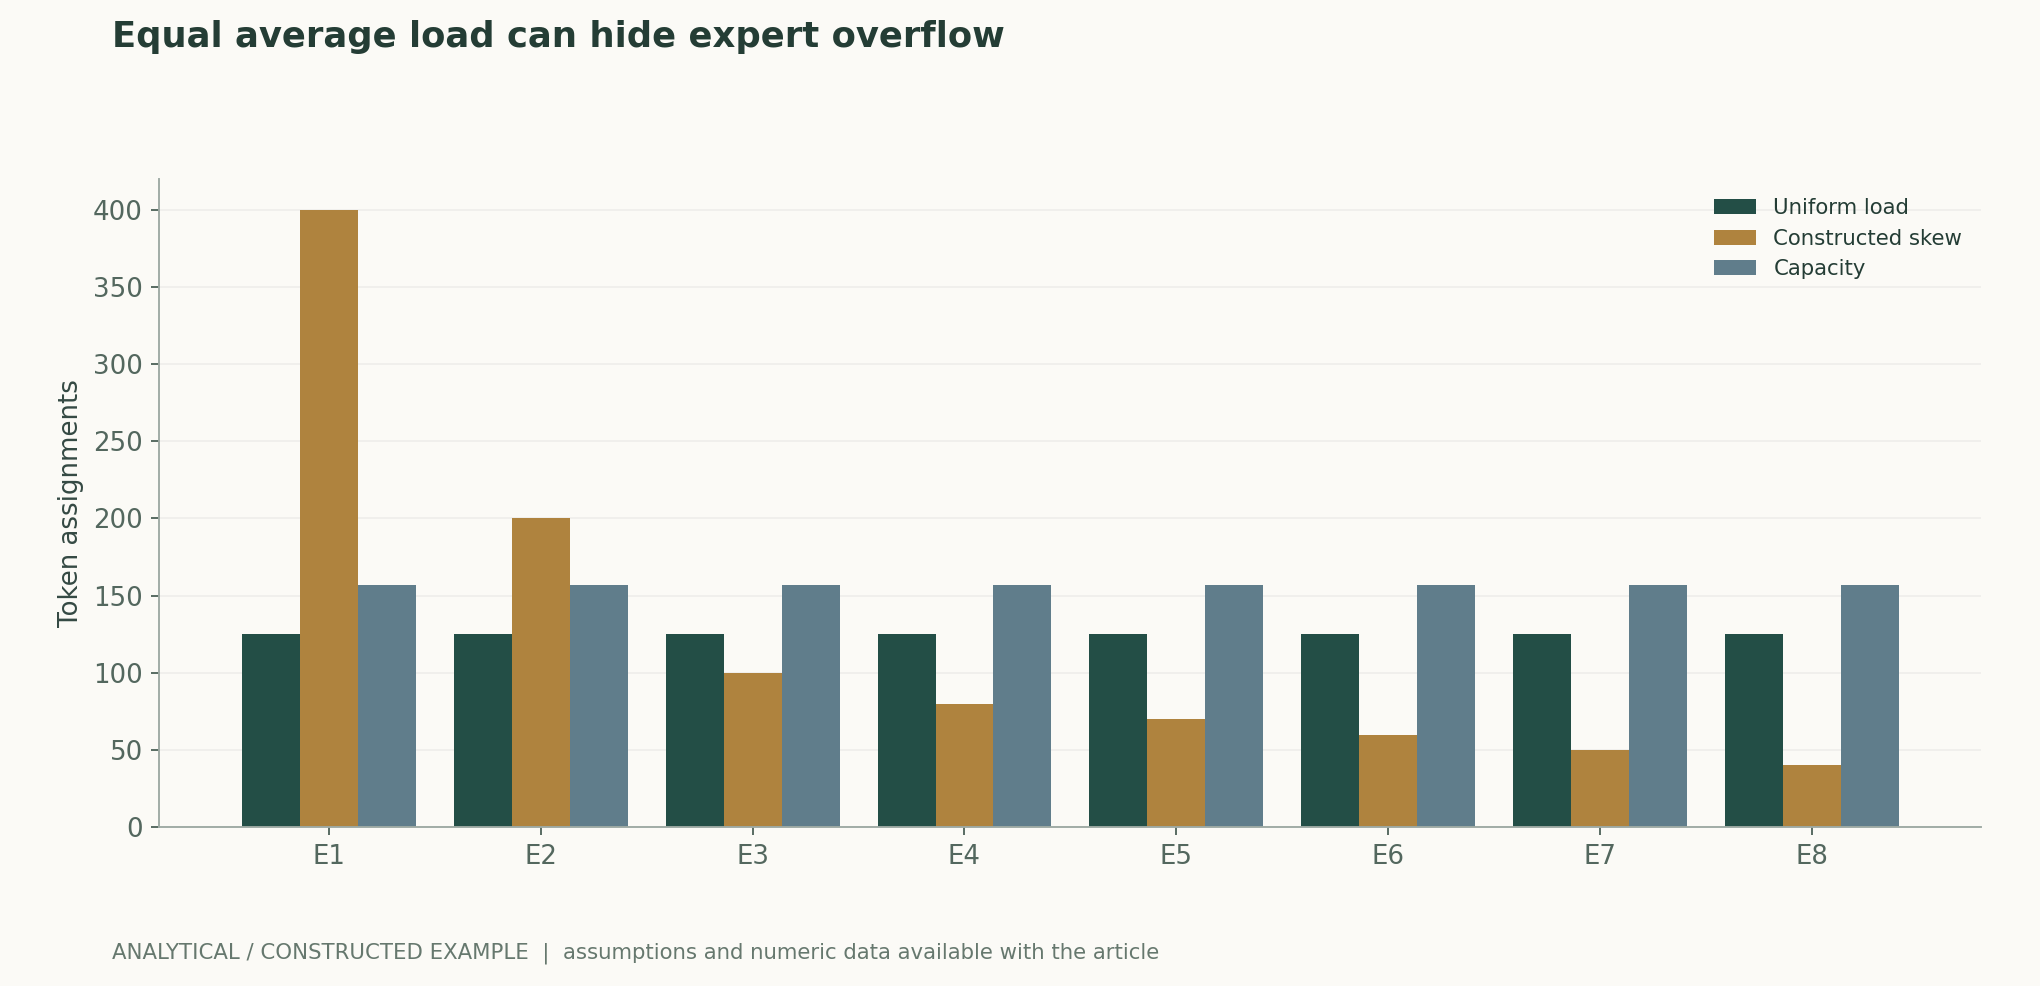
可复算例题
两组派发数都为1000,容量均157。均匀组没有超限;偏斜组超限派发共286次。最终丢弃、重路由与质量取决于实现,不由计数自动决定。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 总参数 | 分列全部专家、共享层与优化器状态 | 不等于每token激活计算 |
| 路由均衡 | 记录每专家负载与分层溢出 | 均匀不保证专家有效分工 |
| 容量因子 | 固定路由组与溢出处理规则 | 增加容量也增加内存或padding |
| 分布式吞吐 | 测分发、计算、合并和尾延迟 | FLOPs无法刻画通信与等待 |
复核与实验方案
- 固定稠密基线、层结构、专家大小、top-k和训练数据,公开匹配预算规则。
- 明确token路由组、容量因子、权重归一化和满载后的处理。
- 保存各层每专家负载、最大/平均比与溢出,按语种和长度分层。
- 扫描均衡系数和容量,联合比较质量及真正执行的token路径。
- 记录设备拓扑、通信字节、padding比例、峰值内存和各阶段耗时。
- 用真实服务批量及长度分布复测,区分本篇计数示意与生产吞吐。
适用范围与局限
- 示意负载没有来自已训练模型。
- 容量公式依赖路由分组定义。
- 总参数与激活计算不代表总费用。
- 均衡、专业化和任务质量需联合实测。
一手来源与主张对应
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, , · 2021-01-11Abstract; 原文方法、理论和实验章节见作者原始论文链接
- GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding, , , , , , , , · 2020-06-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
阅读器性能修订:新近 HEAD 返回 200 且 ETag 相同时也复用已读页面。正文、公式、来源和科学图的数据保持上一版本内容。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/sparse-mixture-experts/v1/
Source revision: 6251a250b27bb8b449f59b392f81abd355383770