
Resumen: qué viene después de decodificar el texto
Las interfaces cerebro-computadora del habla vinculan la actividad neural asociada al intento de hablar con texto, voz u otras salidas, y constituyen una importante línea de investigación para la comunicación asistida. Sin embargo, una baja tasa de error y una salida rápida con un vocabulario determinado no demuestran por sí solas que la comunicación real sea fluida, controlable y estable a largo plazo. Esta revisión relaciona dos estudios sobre neuroprótesis del habla de alto rendimiento, distingue la información neural, las probabilidades a priori lingüísticas, la latencia y la carga de corrección, y utiliza modelos analíticos transparentes para examinar cómo pasar de las métricas experimentales a los resultados de comunicación real.[1] A high-performance speech neuroprosthesis[2] A high-performance neuroprosthesis for speech decoding
Traducción del resumen en inglés
Las neuroprótesis del habla combinan la decodificación neural con probabilidades a priori lingüísticas y comunicación interactiva. Comparamos demostraciones intracorticales y de superficie cortical, derivamos ejemplos de errores en oraciones y de tiempo de corrección, y distinguimos la precisión en tareas indicadas de la comunicación espontánea controlada por el usuario. La revisión destaca las pruebas en sesiones excluidas del entrenamiento, la latencia y la evidencia específica de cada participante.
Alcance de la evidencia de dos demostraciones
Willett y colaboradores y Metzger y colaboradores demostraron avances en la decodificación del habla mediante distintas vías de registro y salida; los segundos también investigaron salidas de voz y de rostro virtual. Estos estudios aportan evidencia importante bajo condiciones específicas de participantes, entrenamiento y tareas. Esta revisión no presenta los resultados individuales como un rendimiento universal para todas las personas que han perdido la capacidad de hablar, ni ordena simplemente las cifras obtenidas con distintos vocabularios, indicaciones y modelos de lenguaje en una clasificación de superioridad clínica.[1] A high-performance speech neuroprosthesis[2] A high-performance neuroprosthesis for speech decoding
Evidencia neural y probabilidades a priori lingüísticas
Los decodificadores suelen combinar la verosimilitud de las señales neurales con la probabilidad a priori de un modelo de lenguaje. Esta última puede corregir errores comunes, pero también favorecer oraciones más frecuentes que no corresponden a lo que el usuario quiere expresar. La fluidez de la salida no demuestra automáticamente que todas las palabras tengan el mismo respaldo neural. La investigación debe comparar la intensidad de las probabilidades a priori lingüísticas y realizar pruebas con palabras infrecuentes y expresiones sin sentido pero lingüísticamente válidas, conservando la incertidumbre. La asistencia lingüística y la decodificación neural aportan contribuciones diferentes que deben comunicarse por separado, en lugar de mostrar únicamente la oración final.作者分析与复核建议 / Author analysis
Definición de la tasa de error de palabras
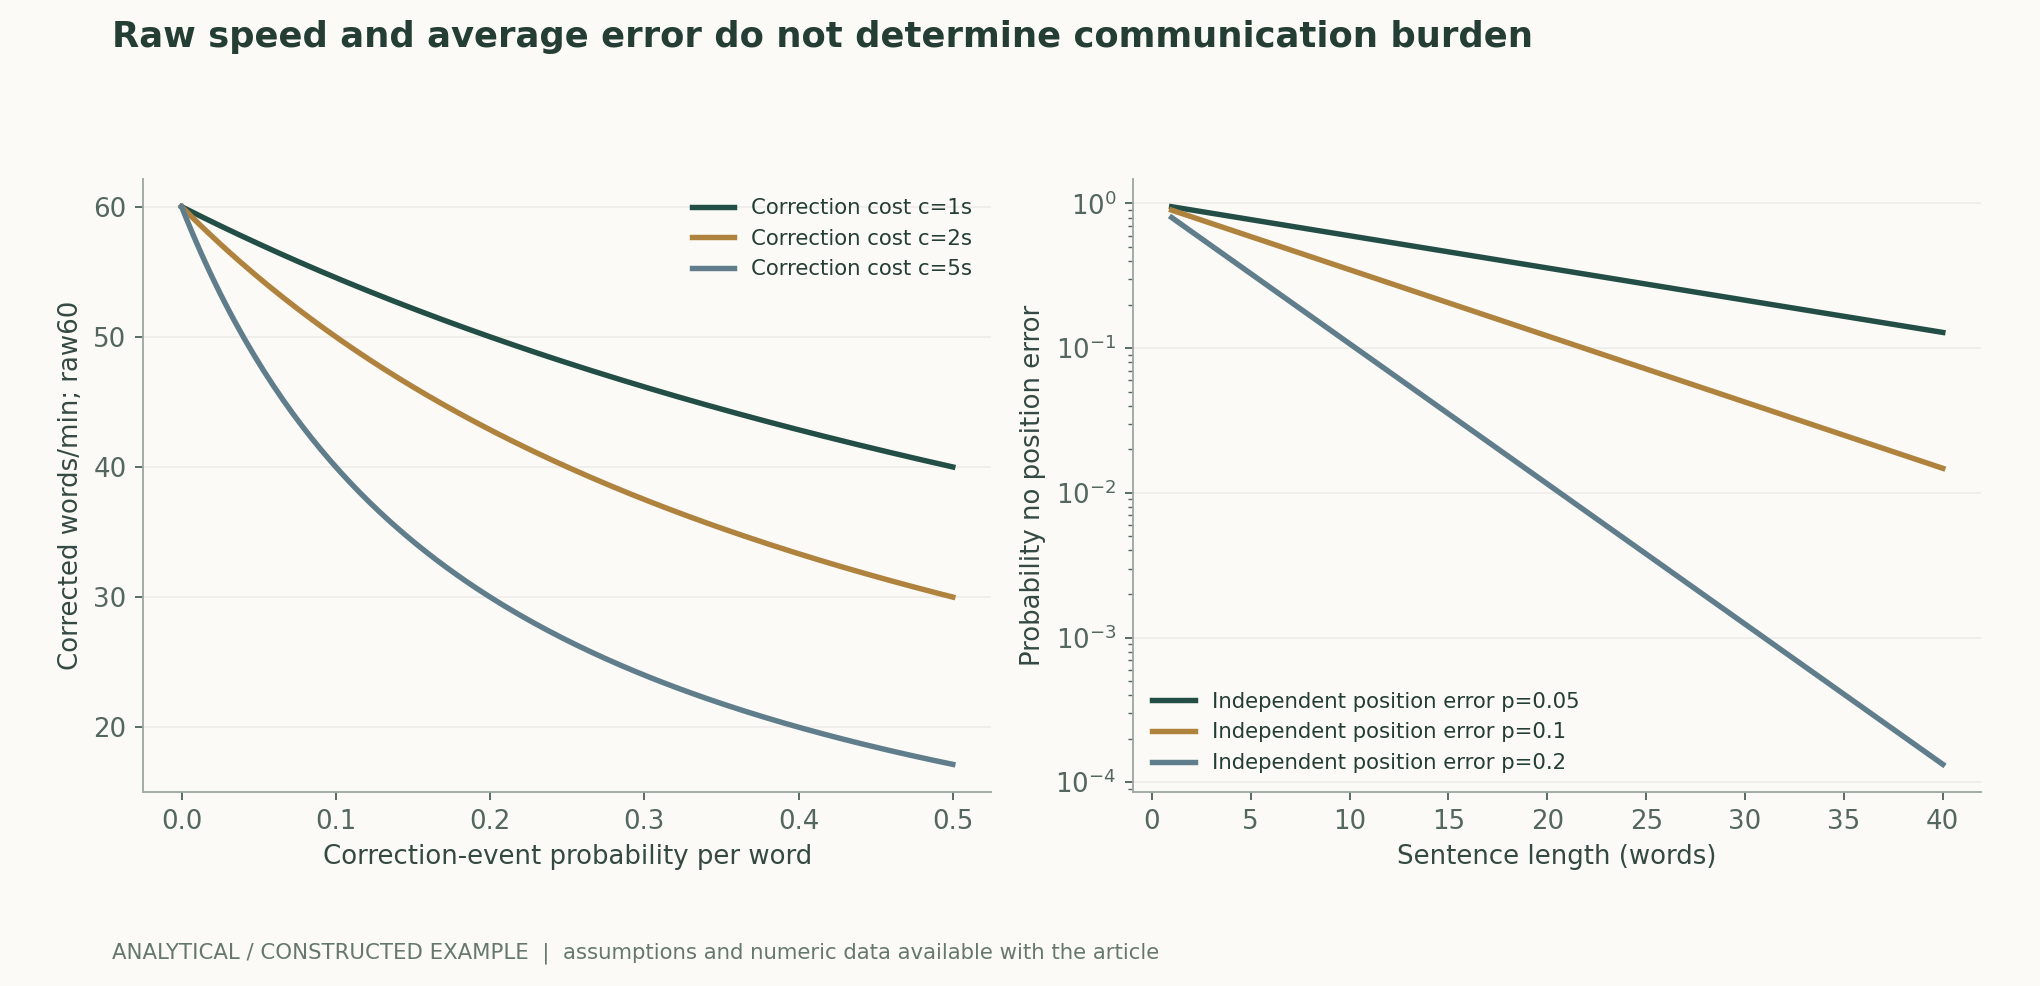
La tasa de error de palabras suele calcularse dividiendo el total de sustituciones, eliminaciones e inserciones entre el número de palabras de referencia. No es una probabilidad de error independiente por palabra y puede incluso superar 100% cuando hay muchas inserciones. Por tanto, una WER medida no puede introducirse directamente en un modelo de oraciones basado en ensayos de Bernoulli independientes. El gráfico de oraciones de esta revisión utiliza una tasa de error independiente por posición supuesta explícitamente, únicamente para explicar la acumulación en oraciones largas; no se ajusta a los estudios originales ni sustituye la alineación real y el análisis de los tipos de error.作者分析与复核建议 / Author analysis
Consecuencias distintas de una misma tasa media de error
Un error puede afectar a un artículo, al nombre de una persona, a una negación o a una necesidad fundamental, con consecuencias comunicativas distintas. La investigación debe analizar las categorías de error y su impacto semántico protegiendo la privacidad, y permitir al usuario confirmar o retirar la salida. Mejorar únicamente la fluidez lingüística puede reducir los errores superficiales y, al mismo tiempo, alterar el significado original. El objetivo del sistema debe ser preservar el control de quien se expresa, en vez de considerar la continuación lingüística más probable como su intención real.作者分析与复核建议 / Author analysis
Un contraejemplo con oraciones largas y errores independientes
Si se supone que la probabilidad de acierto en cada posición es 1−p y que las posiciones son independientes, la probabilidad de que una oración de longitud L sea completamente correcta es (1−p) elevado a L. Incluso con un buen rendimiento por posición, la probabilidad de que una oración larga no contenga errores puede disminuir. Los errores reales presentan correlaciones, inserciones, eliminaciones y restricciones lingüísticas, por lo que esta fórmula es solo un contraejemplo mínimo. El gráfico no contiene datos neurales reales ni datos de pacientes; recuerda que también deben comunicarse criterios de valoración a nivel de oración, semántica e interacción.作者分析与复核建议 / Author analysis
El tiempo de corrección modifica la velocidad efectiva
Si la velocidad bruta es v, la probabilidad por palabra de un evento que exige corrección es e y cada evento añade c segundos, la velocidad media de palabras tras la corrección completa puede expresarse como 60 dividido entre la suma del tiempo bruto por palabra y el tiempo esperado de corrección. Este modelo construido muestra que la carga de corrección puede contrarrestar una salida bruta más rápida. La comunicación real también incluye selección, confirmación y pausas, por lo que debe medirse directamente el tiempo de finalización de la tarea, en lugar de considerar únicamente las palabras brutas por minuto como la experiencia final.作者分析与复核建议 / Author analysis
La latencia debe comunicarse como una distribución
La latencia media puede ocultar pausas largas ocasionales, especialmente importantes en la conversación en tiempo real. Deben distinguirse la ventana neural, el cálculo, la búsqueda lingüística, la síntesis de voz y la transmisión por red, y comunicarse la cola de la distribución. La salida continua también puede pronunciar contenido anticipadamente que luego requiera revisión; si el usuario no puede retirarlo, surgen otros problemas de control. La investigación debe mostrar los compromisos entre precisión, latencia y estrategias de modificación, en vez de presentar el ejemplo más rápido como rendimiento típico.作者分析与复核建议 / Author analysis
Oraciones indicadas y comunicación espontánea
Intentar pronunciar oraciones conocidas que aparecen en una pantalla permite obtener una referencia experimental precisa, pero presenta una distribución distinta de la comunicación espontánea del usuario. Pueden cambiar la longitud de las oraciones, el vocabulario, las pausas y los objetivos comunicativos. La investigación debe especificar claramente el tipo de tarea y validar progresivamente una comunicación más natural en condiciones apropiadas. El éxito en tareas indicadas es importante, pero, sin nueva evidencia, no puede convertirse automáticamente en una capacidad para mantener cualquier diálogo abierto.作者分析与复核建议 / Author analysis
Vocabulario y solapamiento con las pruebas
Los vocabularios limitados y abiertos implican dificultades distintas. Los patrones oracionales del entrenamiento y las distribuciones de palabras infrecuentes y homófonos también afectan al rendimiento. Si el entrenamiento y la prueba comparten muchas oraciones o expresiones, las probabilidades a priori lingüísticas pueden facilitar su reconocimiento repetido. Los datos deben dividirse por familias de oraciones y sesiones temporales, y debe comunicarse el comportamiento ante palabras fuera del vocabulario. Cuando no puede producirse una palabra desconocida, el sistema necesita un mecanismo explícito de rechazo del reconocimiento o una alternativa, y no debe sustituirla siempre por una palabra común.作者分析与复核建议 / Author analysis
Deriva entre sesiones y adaptación a largo plazo
Los registros neurales y las estrategias del usuario pueden cambiar de un día a otro, y la recalibración del modelo también puede afectar a la evaluación. La investigación debe separar el rendimiento entre días de un modelo congelado del obtenido con reentrenamiento continuo, y registrar los datos utilizados en cada actualización. Recuperar el rendimiento tras el reentrenamiento no significa que el modelo original se mantuviera estable y sin cambios a largo plazo; ambos pueden tener valor práctico, pero difieren en la carga de mantenimiento y en el significado de la evidencia.作者分析与复核建议 / Author analysis
Participantes y unidades experimentales
Un gran número de oraciones, ventanas temporales y canales de electrodos no equivale a un gran número de participantes independientes. Las repeticiones dentro de una persona permiten evaluar la estabilidad, pero no determinan automáticamente los efectos en distintas poblaciones. Deben conservarse los niveles jerárquicos de participante, sesión y oración, evitando intervalos excesivamente estrechos derivados de tratar todas las ventanas temporales como muestras independientes. Los antecedentes patológicos, los lugares de registro y los métodos previos de comunicación de los participantes también pueden influir en los resultados y no deben ignorarse.作者分析与复核建议 / Author analysis
Rechazo del reconocimiento y activación involuntaria
Además de decodificar correctamente los intentos de expresión, el sistema debe reconocer cuándo no existe intención de comunicarse. Evaluar únicamente después de una señal de inicio conocida omite las activaciones involuntarias del uso cotidiano. Deben medirse de forma independiente las salidas durante el reposo, otros movimientos y estados no objetivo, y permitir al usuario iniciar, pausar y confirmar de forma explícita. Esta revisión solo aborda criterios de valoración de investigación y no ofrece procedimientos de implantación ni de uso individual.作者分析与复核建议 / Author analysis
Salidas de voz y de rostro virtual
Una voz natural y los movimientos faciales pueden potenciar la expresión, pero la inteligibilidad, el parecido con la identidad de la persona y el control emocional son objetivos diferentes. También deben evaluarse por separado la precisión de las transcripciones de los oyentes y la valoración del usuario sobre si se ha expresado su intención original. Una voz generada más fluida no implica mayor evidencia de control neural. La investigación debe documentar los modelos de síntesis, las fuentes de entrenamiento y el alcance de la autorización del usuario, y permitir que quien se expresa decida cómo se presentan su voz y su imagen.作者分析与复核建议 / Author analysis
Resultados fuera de línea y en línea
Los modelos fuera de línea pueden utilizar contexto futuro o segmentación precisa, mientras que los sistemas en línea deben producir salidas dentro de restricciones temporales causales. Presentar los mejores resultados fuera de línea como capacidad en tiempo real ignora las restricciones de ventanas y cálculo. Debe fijarse la información disponible en línea, registrarse la secuencia temporal real de ejecución y distinguirse las correcciones de posprocesamiento. Los equipos de cálculo y las condiciones de red también forman parte de la reproducibilidad; la complejidad algorítmica por sí sola no representa la latencia real.作者分析与复核建议 / Author analysis
Límites interpretativos de la personalización mediante IA
La personalización puede mejorar el rendimiento aprovechando el vocabulario y los hábitos del usuario, pero también puede aumentar la dependencia del modelo respecto al lenguaje histórico en lugar de las señales actuales. Debe compararse la contribución neural con y sin personalización, y permitir al usuario modificar o borrar los datos correspondientes. Las actualizaciones del modelo deben ser trazables, sin considerar automáticamente una única respuesta de retroalimentación como una intención permanente. El objetivo de investigación es examinar el equilibrio entre asistencia y control, no asumir que cuanto más activamente complete el sistema lo que quiere decir el usuario, mejor.作者分析与复核建议 / Author analysis
Privacidad y autonomía de quien se expresa
Las señales neurales y el contenido comunicativo son sumamente personales, y la investigación y las demostraciones deben respetar los permisos y los límites de los datos. Los errores generados automáticamente no deben difundirse como opiniones del propio participante sin su confirmación. Al compartir materiales de verificación pueden utilizarse resúmenes anonimizados obtenidos legalmente, conservando suficiente información sobre las tareas y los errores. Esta revisión no ha accedido a datos neurales reales ni a conversaciones personales, ni considera una demostración técnica como consejo terapéutico para ninguna persona.作者分析与复核建议 / Author analysis
Recálculo analítico y criterios de valoración reales
El modelo de oraciones puede verificarse directamente mediante la probabilidad binomial, y el modelo de corrección puede calcularse de forma independiente sumando los tiempos por palabra. Ambos suponen probabilidades o costes fijos y no incluyen la carga cognitiva real, las correlaciones entre errores ni el aprendizaje. Su función es mostrar que las distintas métricas no son automáticamente intercambiables. La investigación real debe complementarse con evaluaciones participativas de finalización de tareas, inteligibilidad y sensación de control, en vez de sustituir la experiencia humana por curvas analíticas.作者分析与复核建议 / Author analysis
La siguiente comparación falsable
Si un nuevo decodificador reduce la WER, pero aumenta la latencia de cola o los errores semánticos importantes, determinar si mejora la comunicación exige medirlo directamente. Las comparaciones deben especificar de antemano las tareas, los mecanismos de confirmación y la frecuencia de mantenimiento, y evaluar modelos congelados en sesiones no vistas. Un sistema realmente mejor debe reducir la carga comunicativa global con los mismos límites de información, preservando la capacidad del usuario para elegir y corregir, en lugar de limitarse a generar texto más fluido.作者分析与复核建议 / Author analysis
Conclusión y paquete de investigación
Los materiales verificables deben incluir resúmenes legales de las tareas, particiones de sesiones, vocabulario, modelos de lenguaje, alineaciones de errores, latencia, actualizaciones y reglas de interacción. El progreso de las interfaces cerebro-computadora del habla debe desembocar en una comunicación que quien se expresa pueda controlar de manera fiable, y no en un récord algorítmico aislado. Distinguir y conectar la evidencia neural, la asistencia lingüística y la experiencia humana puede ayudar a que demostraciones importantes avancen hacia aplicaciones más amplias por una vía verificable.作者分析与复核建议 / Author analysis
Ecuaciones fundamentales y derivaciones
(1) Total de sustituciones, eliminaciones e inserciones dividido entre el número de palabras de referencia; no es una probabilidad independiente por posición.
LaTeX
\mathrm{WER}=(S+D+I)/N(2) Modelo supuesto con errores por posición explícitamente independientes; no utiliza directamente la WER medida.
LaTeX
P(\mathrm{error\!\ free})=(1-p)^L(3) Modelo con un coste adicional fijo de corrección por palabra, suponiendo que todos los errores terminan corrigiéndose.
LaTeX
v_{\rm corrected}=60/(60/v+ec)(4) Evidencia neural y probabilidades a priori lingüísticas; la arquitectura concreta de decodificación puede variar.
LaTeX
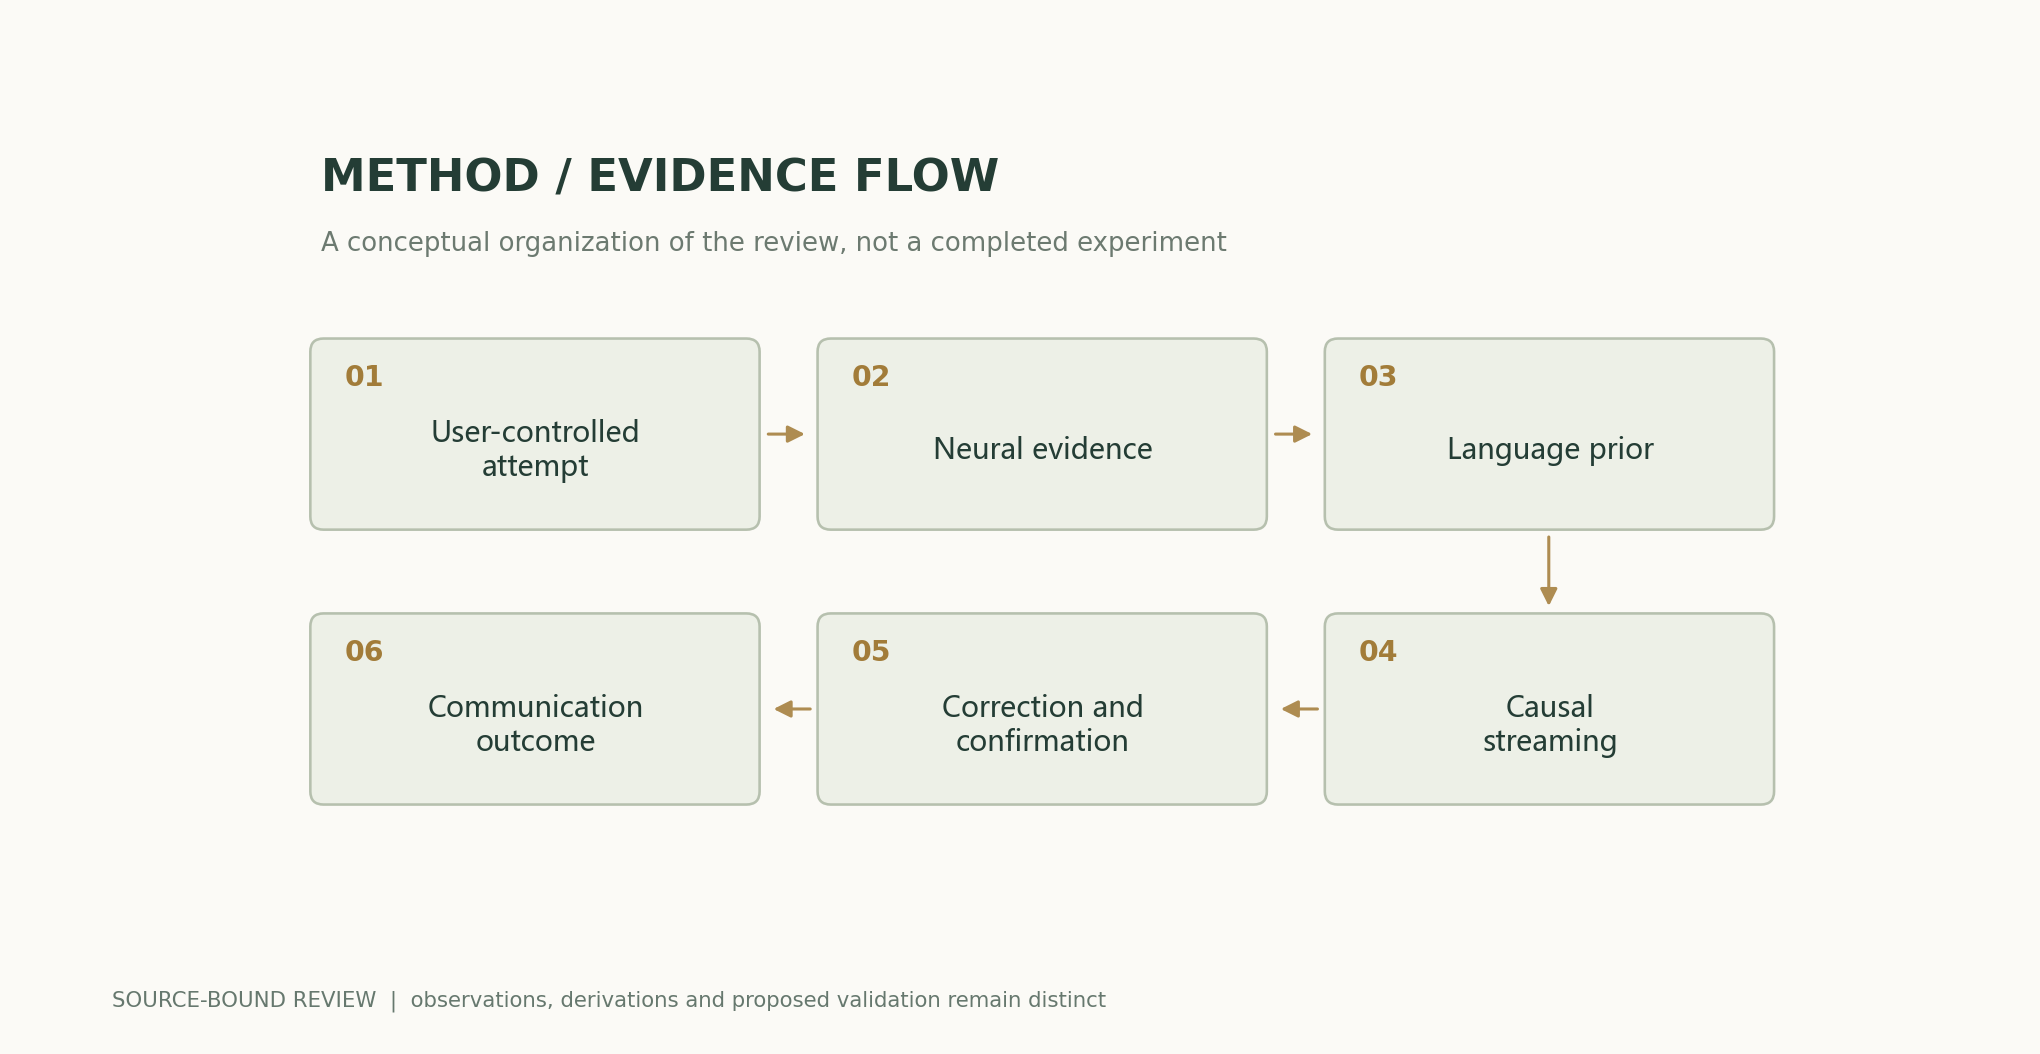
P(w\mid s)\propto P(s\mid w)P_{\rm LM}(w)Flujo de métodos y evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto que puede recalcularse
Con una velocidad bruta de 60 palabras/min, una tasa de eventos de corrección de 0.2 y 2 segundos por evento, la velocidad efectiva construida es de 42.8571 palabras/min; con una tasa de error independiente por posición de 0.2, la probabilidad de que las 20 palabras sean correctas es 0.8^20=0.0115292.
Comparación de métodos
| Método o criterio de medición | Qué limita directamente | Evidencia aún necesaria |
|---|---|---|
| Tasa de error de palabras | Errores de edición respecto al texto de referencia | Consecuencias semánticas e interactivas |
| Velocidad bruta de palabras | Tasa de salida | Corrección y pausas |
| Corrección de la oración | Resultados de oraciones cortas completas | Expresión espontánea abierta |
| Latencia media | Respuesta típica | Colas largas y activación involuntaria |
| Pruebas entre días con el modelo congelado | Estabilidad del modelo fijo | Mantenimiento y aprendizaje continuo |
| Rendimiento del usuario en la tarea | Carga comunicativa real | Mayor diversidad de participantes y uso a largo plazo |
Plan de verificación y experimentación
- Fijar las tareas indicadas o espontáneas y los criterios de valoración principales.
- Documentar las sesiones obtenidas legalmente, el vocabulario y los textos de referencia.
- Separar entrenamiento y prueba por sesiones y patrones oracionales.
- Comparar por separado las contribuciones neurales y de las probabilidades a priori lingüísticas.
- Conservar las alineaciones de errores, las categorías semánticas y los rechazos del reconocimiento.
- Medir directamente la latencia de cola y los costes de corrección y confirmación.
- Distinguir los resultados del modelo congelado de los obtenidos mediante actualizaciones continuas.
- Publicar resúmenes legales, versiones de los modelos y reglas de control del usuario.
Ámbito de aplicación y limitaciones
- No hay nuevos registros neurales, implantaciones ni ensayos clínicos.
- Los resultados de los participantes de los estudios originales no representan a todos los usuarios.
- El modelo de oraciones no trata la WER como una tasa de error independiente.
- El coste fijo de corrección es un supuesto, no una medición de la experiencia.
- La generación fluida no equivale automáticamente a expresar correctamente la intención.
Evidencia de los estudios originales y ámbito de aplicación
| Resultados de los estudios originales | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| Las señales neurales permiten decodificar el habla con vocabularios amplios en participantes específicos. | Condiciones originales de tarea, entrenamiento y registro. | Una neuroprótesis del habla de alto rendimientoResumen; decodificación en línea |
| Registros de superficie combinados con salidas de texto, voz y rostro virtual. | Participantes originales y alcance de la evaluación de las distintas salidas. | Una neuroprótesis de alto rendimiento para la decodificación del habla y el control de avataresResumen; evaluación multimodal |
Preguntas de investigación que conviene someter a prueba
- ¿La reducción de la WER disminuye también la carga de la comunicación real?
- ¿Cómo cuantificar la deriva del modelo entre días y su mantenimiento?
- ¿Cuándo mejoran las probabilidades a priori lingüísticas la forma, pero alteran el significado original?
Correspondencia entre fuentes primarias y afirmaciones
- A high-performance speech neuroprosthesisFrancis R. Willett, Erin M. Kunz, Chaofei Fan, Donald T. Avansino, Guy H. Wilson, Eun Young Choi, et al. · 2023-08-23Abstract; online text decoding
- A high-performance neuroprosthesis for speech decoding and avatar controlSean L. Metzger, Kaylo T. Littlejohn, Alexander B. Silva, David A. Moses, Margaret P. Seaton, Ran Wang, et al. · 2023-08-23Abstract; speech/text/avatar evaluation
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación documentada y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a los equipos de investigación originales; los cálculos de esta revisión solo comprueban las ecuaciones enumeradas y los supuestos explícitos. Este sitio aún no dispone de una revisión por pares independiente de este artículo ni de registros de experimentos originales con modelos, clínicos o físicos.
Primera publicación: monográfico en profundidad sobre evidencia científica interdisciplinaria; se mantienen los límites entre las fuentes de cada sección, la evidencia de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos adjuntos; sus leyendas explican, elemento por elemento, los supuestos y los criterios de medición.
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Python · Código para recalcular · Historial de publicación y versiones
Revisión de la fuente: 500575872cce7c4b9c4062a12bb0692eb580c2da