
要旨:文字のデコードの先にあるもの
発話ブレイン・コンピュータ・インターフェースは、発話を試みる際の神経活動を文字、音声、その他の出力につなぎ、コミュニケーション支援の重要な研究方向を提供する。しかし、ある語彙集合における低い誤り率と高速な出力だけでは、実際のコミュニケーションがすでに流暢で、制御可能であり、長期的に安定しているとはいえない。本稿では、高性能な発話神経補綴に関する二つの研究を関連づけ、神経情報、言語事前分布、遅延、訂正負担を分けて検討し、透明性のある解析モデルを用いて、実験指標から実際のコミュニケーション成果へと進む方法を論じる。[1] A high-performance speech neuroprosthesis[2] A high-performance neuroprosthesis for speech decoding
原文の英語要旨の日本語訳
発話神経補綴は、神経デコードと言語事前分布、対話的コミュニケーションを組み合わせる。本稿では、皮質内記録と皮質表面記録による実証研究を比較し、文の誤りと訂正時間の例を導出するとともに、提示課題における正確さと、ユーザーが制御する自発的コミュニケーションを区別する。本総説は、セッション単位で学習から除外したデータによるテスト、遅延、参加者固有のエビデンスを重視する。
二つの実証研究におけるエビデンスの範囲
WillettらとMetzgerらは、それぞれ異なる記録・出力経路による発話デコードの進展を示し、後者は音声と仮想顔の出力も研究した。これらは、特定の参加者、学習、課題条件下における重要なエビデンスを提供する。本稿では、個人の結果を発話能力を失ったすべての人に共通する性能として扱わず、異なる語彙、提示条件、言語モデルのもとで得られた数値を、単純に臨床的優劣の順位表に並べることもしない。[1] A high-performance speech neuroprosthesis[2] A high-performance neuroprosthesis for speech decoding
神経エビデンスと言語事前分布
デコーダは通常、神経信号の尤度と言語モデルの事前分布を組み合わせる。後者は一般的な誤りを訂正できる一方、ユーザーが表現したい内容とは異なる、より頻度の高い文を優先する可能性もある。システム出力の流暢さは、各単語が同等の神経的裏づけを持つことを自動的に証明しない。研究では、言語事前分布の強さを比較し、低頻度語や、無意味だが言語的には適格な表現を用いたテストを行い、不確実性を保持すべきである。言語支援と神経デコードの寄与は異なるため、最終的な文だけを示すのではなく、それぞれを報告する必要がある。作者分析与复核建议 / Author analysis
単語誤り率の定義
単語誤り率は通常、置換、削除、挿入の総数を参照単語数で割って求める。これは各単語の独立した誤り確率ではなく、挿入が多い場合には100%を超えることさえある。したがって、実測WERを独立ベルヌーイ試行に基づく文モデルに直接代入することはできない。本稿の文の図では、明示的に仮定した独立な位置ごとの誤り率を用い、長文における蓄積のみを説明する。原研究への当てはめを行うものでも、実際のアラインメントや誤り種別の分析を代替するものでもない。作者分析与复核建议 / Author analysis
同じ平均誤り率がもたらす異なる帰結
誤りは冠詞の場合もあれば、人名、否定語、重要な要求の場合もあり、コミュニケーションへの帰結は同じではない。研究では、プライバシーを保護しつつ誤りの分類と意味への影響を分析し、ユーザーによる確認や撤回を可能にする必要がある。言語的な流暢さだけを高めると、表面的な誤りが減る一方で本来の意味が変わる可能性がある。システムの目標は表現者の制御を保持することであり、最も確率の高い言語的続きを真の意図とみなすことではない。作者分析与复核建议 / Author analysis
独立した誤りを仮定した長文の反例
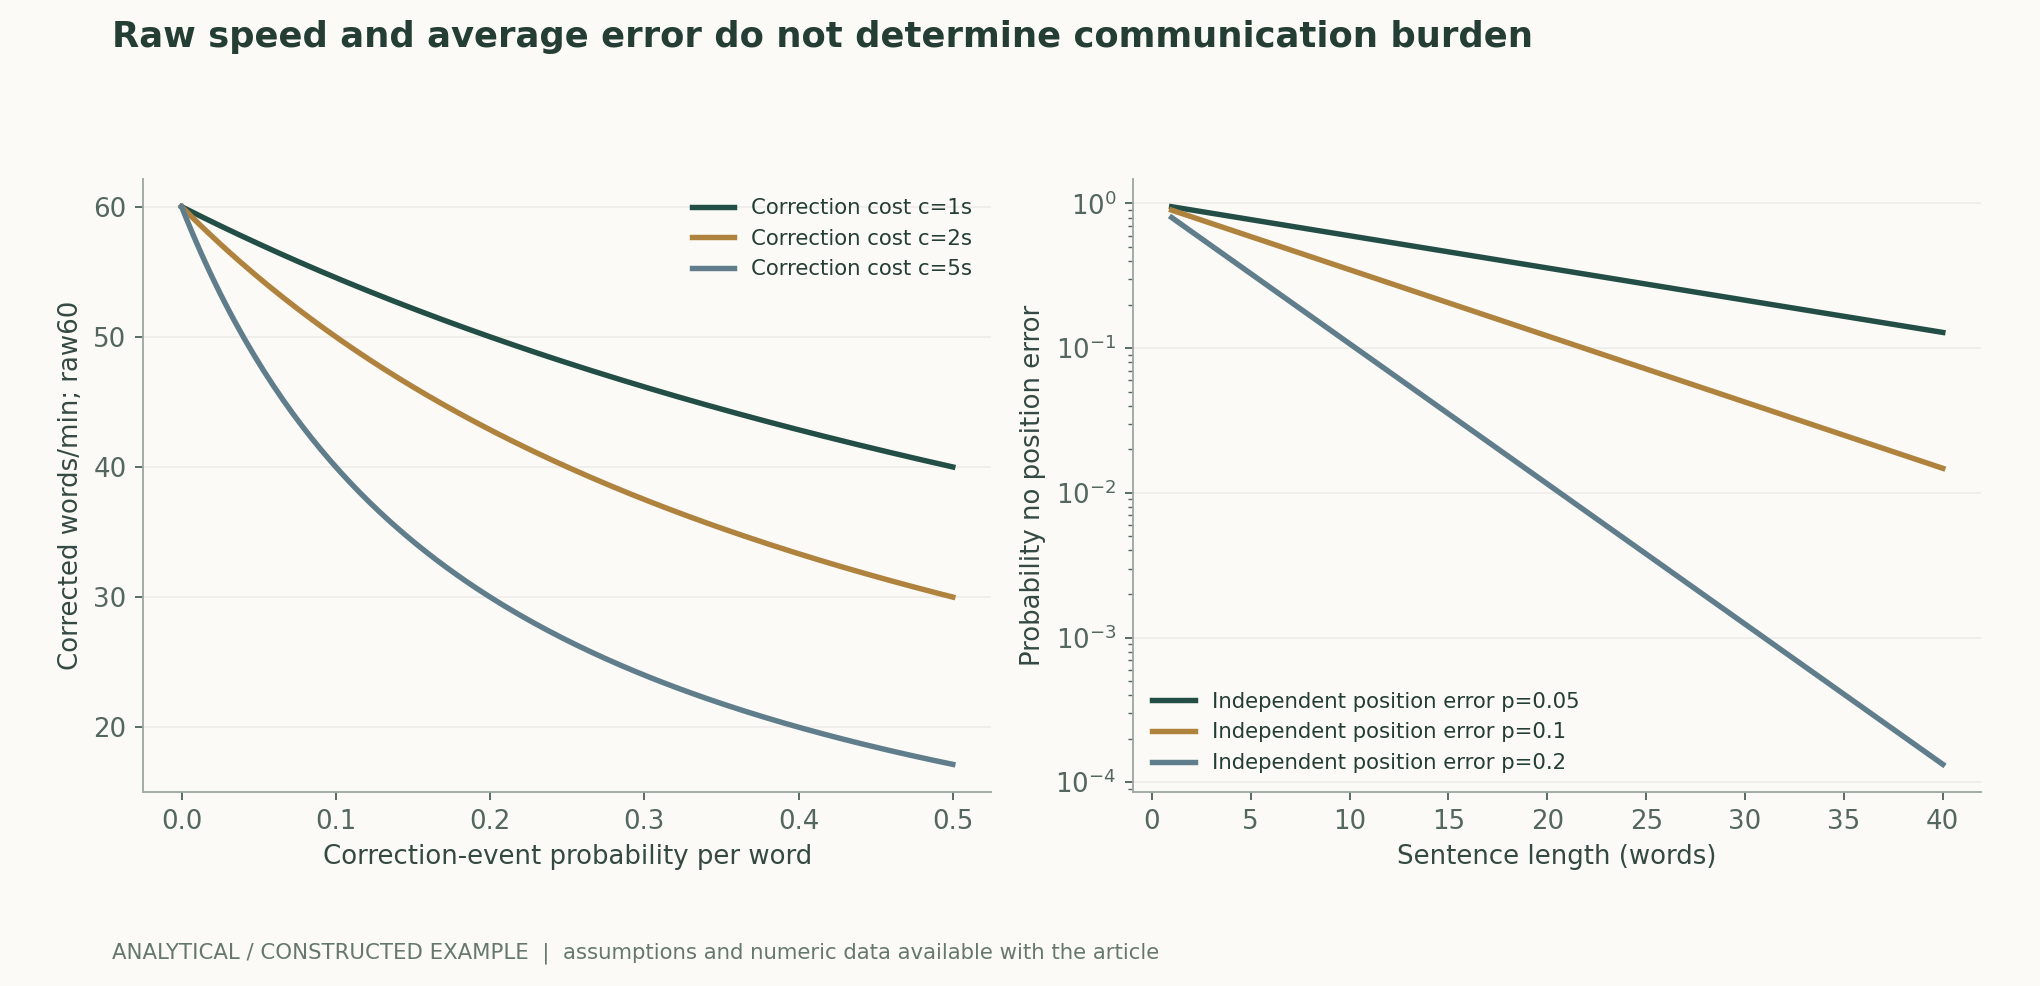
各位置が正しい確率を1−pとし、位置間が独立であると仮定すると、長さLの文がすべて正しい確率は(1−p)のL乗となる。個々の位置での性能が良好でも、長文が無誤りである確率は低下しうる。現実の誤りには相関、挿入・削除、言語的制約があるため、この式は最小限の反例にすぎない。図には実際の神経データや患者データは含まれず、文、意味、相互作用の各水準の評価項目も併せて報告すべきことを示している。作者分析与复核建议 / Author analysis
訂正時間が実効速度を変える
生の速度をv、単語ごとに訂正を要する事象が生じる確率をe、各事象に追加で要する時間をc秒と仮定すると、完全に訂正した後の平均単語速度は、60を、単語あたりの生の所要時間と期待訂正時間の和で割ったものとして表せる。この構成モデルは、生の出力が速くなっても訂正負担によって相殺されうることを示す。実際のコミュニケーションには選択、確認、休止も含まれるため、生の毎分単語数だけを最終的な体験とみなすのではなく、課題完了時間を実測すべきである。作者分析与复核建议 / Author analysis
遅延は分布として報告すべきである
平均遅延は、ときおり生じる長い休止を隠す可能性があり、これはリアルタイムの対話で特に重要である。神経信号の時間窓、計算、言語探索、音声合成、ネットワーク伝送を区別し、分布の裾を報告すべきである。ストリーミング出力では、先に発話された内容が後から修正を要することもあり、ユーザーが撤回できなければ別の制御上の問題が生じる。研究では、最速の例を典型的性能とみなすのではなく、正確さ、遅延、修正方針の間のトレードオフを示す必要がある。作者分析与复核建议 / Author analysis
提示文と自発的コミュニケーション
画面に提示された既知の文を発話しようとする課題では、実験の参照文を正確に得られるが、ユーザーの自発的コミュニケーションとは分布が異なる。文長、語彙、休止、表現の目的はいずれも変わりうる。研究では課題の種類を明示し、適切な条件のもとで、より自然なコミュニケーションを段階的に検証すべきである。提示課題での成功は重要だが、新たなエビデンスなしに、任意のオープンな対話能力へと自動的に拡張して解釈することはできない。作者分析与复核建议 / Author analysis
語彙とテストの重複
限定語彙とオープン語彙では難易度が異なる。学習文の構文、低頻度語、同音異義語の分布もモデル性能に影響する。学習とテストで多数の文や句を共有している場合、言語事前分布が再認識を助ける可能性がある。文の系列と時間的なセッションに基づいてデータを分割し、語彙外語に対する挙動を報告すべきである。未知語を出力できない場合、システムには明示的な認識棄却または代替機構が必要であり、常に一般的な語で置き換えてはならない。作者分析与复核建议 / Author analysis
セッション間ドリフトと長期的適応
神経記録とユーザーの方略は日によって変化しうるほか、モデルの再較正も評価に影響する。研究では、凍結モデルの日をまたぐ性能と、継続的に再学習する場合の性能を分け、各更新で使用した資料を記録すべきである。再学習後に性能が回復しても、元のモデルが変更なしに長期安定性を保ったことにはならない。どちらにも実用的価値はありうるが、保守負担とエビデンスの意味は異なる。作者分析与复核建议 / Author analysis
参加者と実験単位
多数の文、時間窓、電極チャネルは、多数の独立した参加者と同義ではない。個人内の反復は安定性を評価できるが、集団をまたぐ効果を自動的に確定するものではない。参加者、セッション、文の階層構造を保持し、すべての時間窓を独立標本として扱うことで過度に狭い区間を生み出すことを避けるべきである。参加者ごとの疾患背景、記録部位、従来のコミュニケーション手段も結果に影響しうるため、無視できない。作者分析与复核建议 / Author analysis
認識棄却と意図しない起動
システムには、表現の試みを正しくデコードするだけでなく、表現の意図がないときを識別することも求められる。既知の開始信号の後だけで評価すると、日常使用時の誤起動を見落とす。安静時、他の動作中、非標的状態における出力を独立に測定し、ユーザーが明示的に開始、一時停止、確認できるようにすべきである。本稿は研究上の評価項目のみを論じ、埋め込みや個人使用の操作手順は一切提供しない。作者分析与复核建议 / Author analysis
音声と仮想顔の出力
自然な音声や顔の動きは表現を豊かにする可能性があるが、了解度、本人らしさ、感情表現の制御は異なる目標である。聞き手による書き起こしの正確さと、意図した意味が表現されたとユーザーが感じるかどうかも、別々に評価する必要がある。生成音声が流暢になるほど、神経制御のエビデンスが強くなるわけではない。研究では合成モデル、学習データの出所、ユーザーの許諾範囲を記録し、自身の声や姿をどのように提示するかを表現者が決められるようにすべきである。作者分析与复核建议 / Author analysis
オフラインとオンラインの結果
オフラインモデルは将来の文脈や精密な区間分割を利用できるが、オンラインシステムは因果的な時間制約のもとで出力しなければならない。最良のオフライン結果をリアルタイム能力として記述すると、時間窓や計算の制約が無視される。オンラインで利用可能な情報を固定し、実稼働時の時系列を記録し、後処理による修正を区別すべきである。計算機器やネットワーク条件も再現可能性の範囲に含まれ、アルゴリズムの計算量だけで実際の遅延を表すことはできない。作者分析与复核建议 / Author analysis
AIによる個人適応の解釈上の限界
個人適応はユーザーの語彙や習慣を利用して性能を高められるが、モデルが現在の信号より過去の言語に依存する度合いを強める可能性もある。個人適応の有無による神経的寄与を比較し、ユーザーが関連資料を変更・消去できるようにすべきである。モデル更新は追跡可能でなければならず、一度のフィードバックを自動的に恒久的な意図とみなしてはならない。研究の目標は支援と制御の均衡を検証することであり、システムがユーザーに代わって積極的に補完するほどよいとすることではない。作者分析与复核建议 / Author analysis
プライバシーと表現者の主体性
神経信号とコミュニケーション内容はきわめて個人的であり、研究や公開実演では許諾とデータの範囲を尊重すべきである。自動生成された誤りを、確認なしに参加者本人の見解として広めてはならない。検証資料を共有する際には、十分な課題・誤り情報を保持しながら、適法な匿名化要約を用いることができる。本稿は実際の神経データや個人の対話資料を閲覧しておらず、技術的実証を特定個人への治療助言とみなすものでもない。作者分析与复核建议 / Author analysis
解析的な再計算と実際の評価項目
文モデルは二項確率を用いて直接検算でき、訂正モデルは単語ごとの時間内訳を独立に加算して確認できる。いずれも確率またはコストが固定であると仮定し、実際の認知負担、誤りの相関、学習は含まない。その役割は、異なる指標を自動的に相互置換できないことを示す点にある。実際の研究では、解析曲線で人間の体験を置き換えるのではなく、ユーザーが参加する課題完了、了解度、制御感の評価によって補完すべきである。作者分析与复核建议 / Author analysis
反証可能な次の比較
新しいデコーダがWERを低下させても、裾の遅延や重要な意味上の誤りを増やす場合、コミュニケーションをなお改善するかどうかは実測を要する。比較では、課題、確認機構、保守頻度を事前に規定し、未見のセッションに対してモデルを凍結した状態で評価すべきである。真に優れたシステムは、同じ情報境界のもとで全体的なコミュニケーション負担を軽減し、ユーザーの選択・訂正能力を保持するものでなければならず、より滑らかな文章を生成するだけでは不十分である。作者分析与复核建议 / Author analysis
結論と研究パッケージ
検証可能な資料には、適法な課題要約、セッション分割、語彙、言語モデル、誤りアラインメント、遅延、更新、相互作用の規則を含めるべきである。発話ブレイン・コンピュータ・インターフェースの進歩は、最終的には表現者が確実に制御できるコミュニケーションに結びつく必要があり、単一のアルゴリズム指標の記録にとどまるべきではない。神経エビデンス、言語支援、人間の体験を区別しつつ結びつけることで、重要な実証研究を検証可能な道筋に沿って、より広い応用へと進められる。作者分析与复核建议 / Author analysis
主要な式と導出
(1) 置換、削除、挿入の総数を参照単語数で割ったもの。独立な位置ごとの確率ではない。
LaTeX
\mathrm{WER}=(S+D+I)/N(2) 位置ごとの誤りの独立性を明示した仮定モデルであり、実測WERを直接用いない。
LaTeX
P(\mathrm{error\!\ free})=(1-p)^L(3) 単語ごとの追加訂正コストを固定し、最終的にすべて訂正されると仮定するモデル。
LaTeX
v_{\rm corrected}=60/(60/v+ec)(4) 神経エビデンスと言語事前分布。具体的なデコード構造は異なりうる。
LaTeX
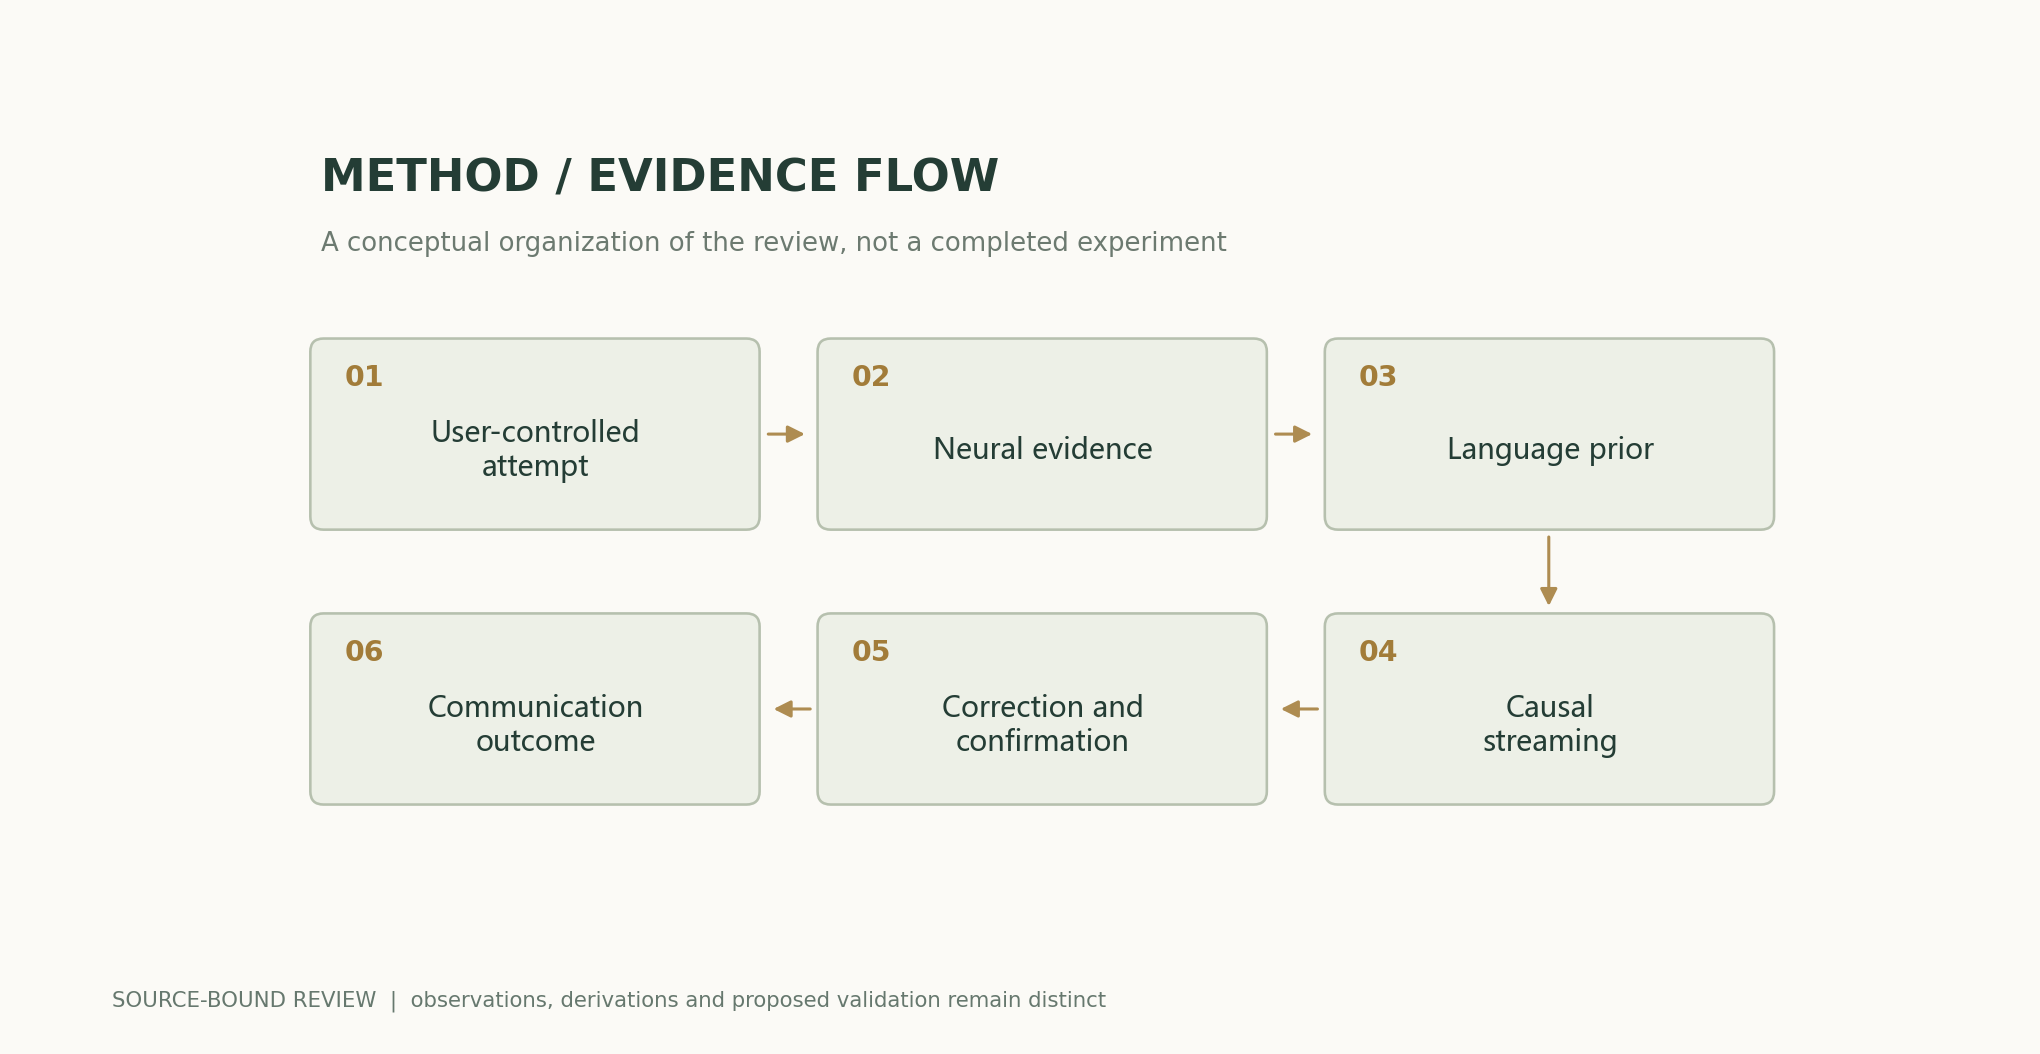
P(w\mid s)\propto P(s\mid w)P_{\rm LM}(w)方法とエビデンスのフロー
解析図と数値例
再計算可能な例題
生の速度が毎分60語、訂正事象率が0.2、各事象に2秒を要するとき、構成モデルの実効速度は毎分42.8571語となる。独立な位置ごとの誤り率が0.2の場合、20語すべてが正しい確率は0.8^20=0.0115292である。
方法の比較
| 方法または測定基準 | 直接制約する対象 | なお補完が必要なエビデンス |
|---|---|---|
| 単語誤り率 | 参照文に対する編集誤り | 意味と相互作用への帰結 |
| 生の単語速度 | 出力速度 | 訂正と休止 |
| 文の正しさ | 短文全体の結果 | オープンな自発的表現 |
| 平均遅延 | 典型的な応答 | 長い裾と意図しない起動 |
| 日をまたぐ凍結モデルのテスト | 固定モデルの安定性 | 保守と継続学習 |
| ユーザーの課題遂行成績 | 実際のコミュニケーション負担 | より幅広い参加者と長期使用 |
検証と実験の計画
- 提示課題または自発課題と主要評価項目を固定する。
- 適法なセッション、語彙、参照文を記録する。
- セッションと文型に基づいて学習とテストを分離する。
- 神経情報と言語事前分布の寄与をそれぞれ比較する。
- 誤りアラインメント、意味分類、認識棄却を保存する。
- 裾の遅延、訂正、確認のコストを実測する。
- 凍結モデルと継続更新の結果を区別する。
- 適法な要約、モデルの版、ユーザー制御の規則を公開する。
適用範囲と限界
- 新たな神経記録、埋め込み、臨床試験はない。
- 原研究の参加者の結果は、すべてのユーザーを代表するものではない。
- 文モデルはWERを独立した誤り率として扱わない。
- 訂正コストの固定は仮定であり、体験の測定ではない。
- 流暢な生成が、意図の正しい表現と自動的に等しくなるわけではない。
原研究のエビデンスと適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| 神経信号は、特定の参加者における大語彙の発話デコードを支える。 | 原研究の課題、学習、記録条件。 | 高性能な発話神経補綴要旨;オンラインデコード |
| 表面記録と文字、音声、仮想顔の出力の組み合わせ。 | 原研究の参加者と各種出力の評価範囲。 | 発話デコードとアバター制御のための高性能神経補綴要旨;マルチモーダル評価 |
検証すべき研究課題
- WERの低下は、実際のコミュニケーション負担も軽減するか。
- 日をまたぐモデルのドリフトと保守をどのように定量化するか。
- 言語事前分布は、どのような場合に形式を改善する一方で本来の意味を変えるか。
一次資料と主張の対応
- A high-performance speech neuroprosthesisFrancis R. Willett, Erin M. Kunz, Chaofei Fan, Donald T. Avansino, Guy H. Wilson, Eun Young Choi, et al. · 2023-08-23Abstract; online text decoding
- A high-performance neuroprosthesis for speech decoding and avatar controlSean L. Metzger, Kaylo T. Littlejohn, Alexander B. Silva, David A. Moses, Margaret P. Seaton, Ran Wang, et al. · 2023-08-23Abstract; speech/text/avatar evaluation
引用と原稿のエクスポート
著者、版、出典
Codex(AI)が執筆した、出典に基づく研究総説と独自の解析。原論文の実験は原研究チームに帰属し、本稿の計算は列挙した式と明示した仮定のみを検証する。本サイトには、現時点で本稿の独立した査読、または独自のモデル実験、臨床実験、物理実験の記録はない。
初公開:学際的な科学的エビデンスを掘り下げる特集。各節の出典、原研究のエビデンス、著者の解析の境界を保持する。
概念的な表紙画像はImageGenが生成した。科学図は付属のコードと数値ファイルを用いて作成し、図注では仮定と測定基準を項目ごとに説明している。
表紙と科学図の出典 · データ、出典、仮定 · Python · 再計算可能なコード · 公開・版の履歴
ソースの改訂: 500575872cce7c4b9c4062a12bb0692eb580c2da