
摘要:解码文字之后还有什么
语音脑机接口将尝试说话的神经活动连接到文字、声音或其他输出,为辅助沟通提供重要研究方向。但一个词表上的低错误率和快速输出,并不单独说明真实交流已经流畅、可控且长期稳定。本文连接两项高性能语音神经假体研究,拆开神经信息、语言先验、时延和纠错负担,用透明解析模型讨论怎样从实验指标走向真实沟通效果。[1] A high-performance speech neuroprosthesis[2] A high-performance neuroprosthesis for speech decoding
English abstract
Speech neuroprostheses combine neural decoding with language priors and interactive communication. We compare intracortical and cortical-surface demonstrations, derive sentence-error and correction-time examples, and distinguish prompted accuracy from spontaneous, user-controlled communication. The review emphasizes session-held-out testing, latency and participant-specific evidence.
两项示范的证据范围
Willett等与Metzger等分别展示不同记录与输出路径下的语音解码进展,其中后者还研究声音与虚拟面部输出。它们提供了特定参与者、训练与任务条件下的重要证据。本文不将个体结果直接写成所有失语者的通用性能,也不把不同词表、提示和语言模型下的数字简单排成一张临床优劣榜。[1] A high-performance speech neuroprosthesis[2] A high-performance neuroprosthesis for speech decoding
神经证据与语言先验
解码器通常把神经信号似然与语言模型先验结合,后者能纠正常见错误,也可能偏向更常见却不是用户想表达的句子。系统输出流畅不自动证明每个词都有同等神经支持。研究应比较语言先验强度、罕见词及无意义但合法的测试,并保留不确定性。语言辅助与神经解码贡献不同,应分别报告而不是只展示最终句子。作者分析与复核建议 / Author analysis
词错误率的定义
词错误率通常将替换、删除和插入总数除以参考词数。它不是每词独立错误概率,插入较多时甚至可以超过100%。因此不能把某个实测WER直接代入独立伯努利句子模型。本文的句子图使用明确假定的独立位置错误率,仅解释长句累积,不拟合原研究,也不替代真实对齐和错误类型分析。作者分析与复核建议 / Author analysis
相同平均错误率的不同后果
一个错误可能是冠词,也可能是人名、否定词或关键需求,沟通后果并不相同。研究需要在保护隐私的前提下分析错误类别与语义影响,并允许用户确认或撤回。仅提高语言流畅度可能减少表面错误却改变原意。系统目标应是保留表达者控制,而不是把最可能的语言续写当作真实意图。作者分析与复核建议 / Author analysis
独立错误的长句反例
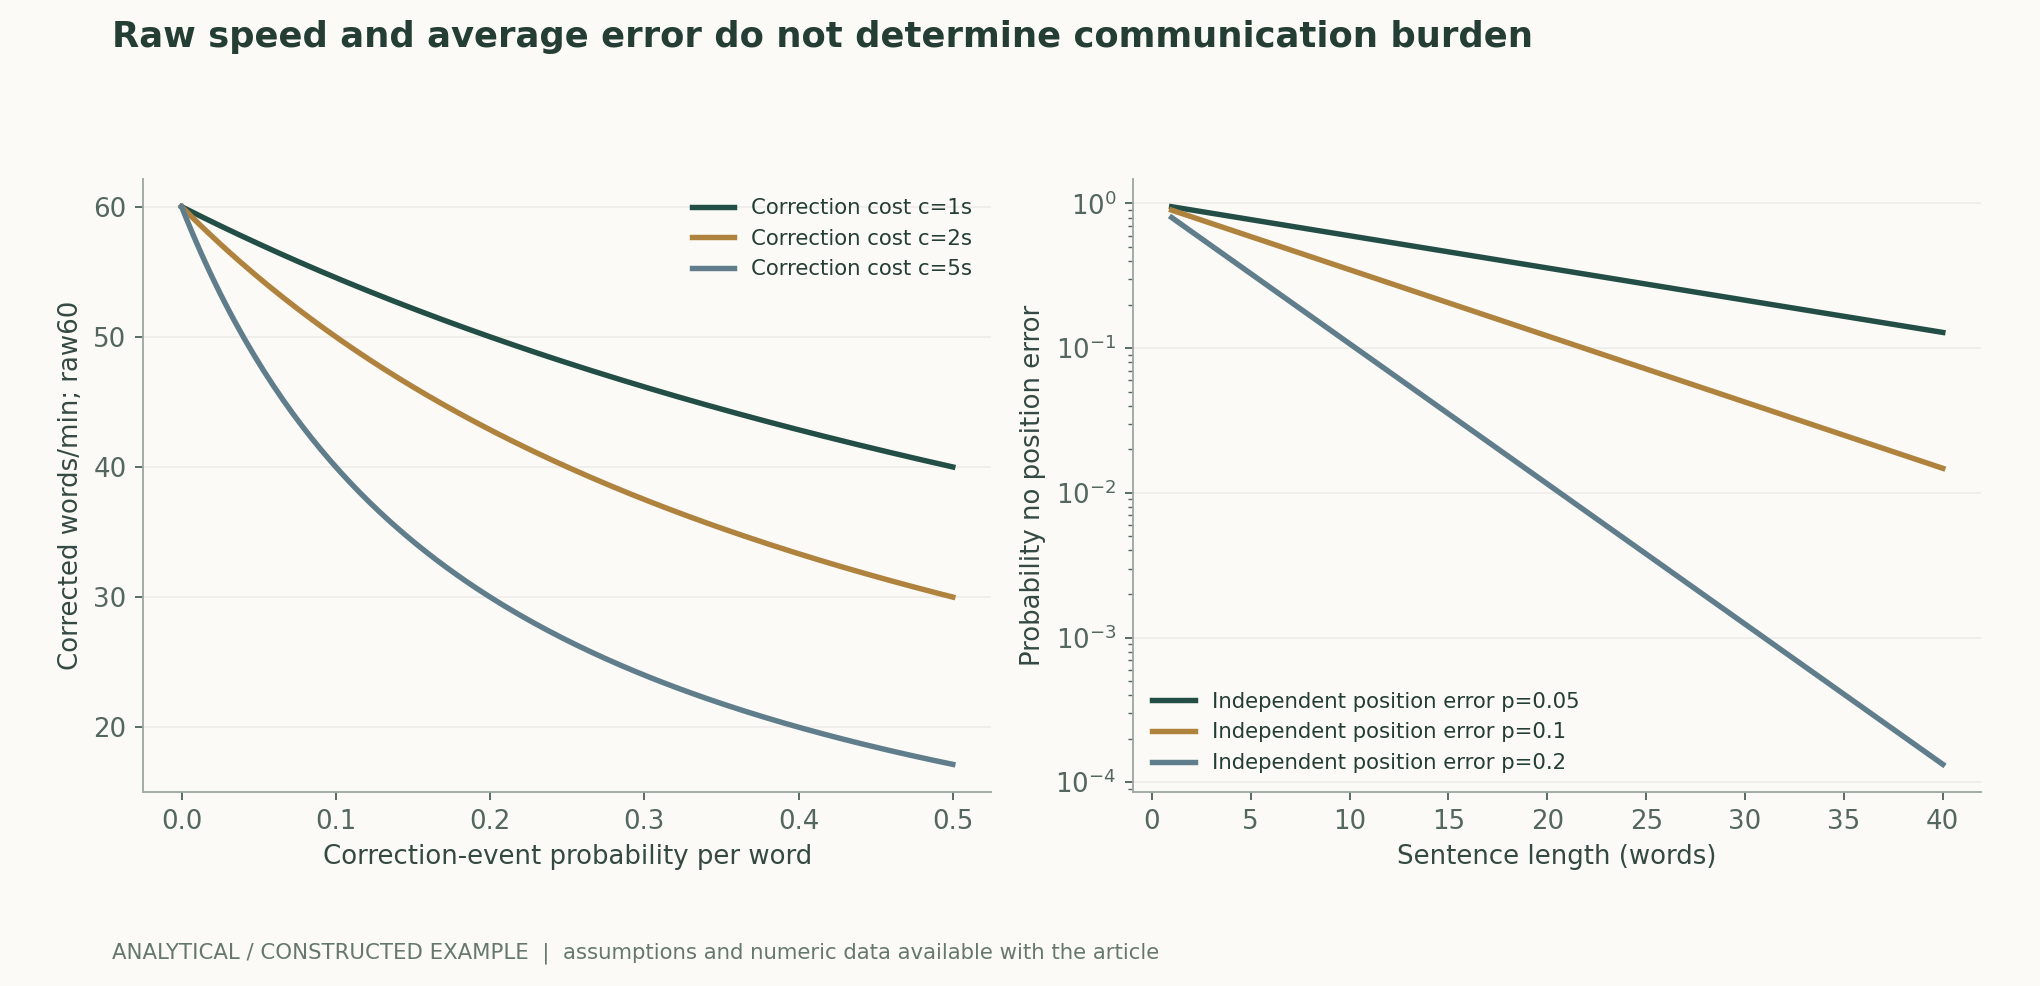
假定每个位置正确概率为1−p且相互独立,长度L的句子全部正确概率为(1−p)的L次方。即使单位置表现较好,长句无误率仍可能下降。现实错误存在相关、插入删除与语言约束,因此该公式只是最小反例。图中没有真实神经或患者数据,它提醒研究同时报告句子、语义和交互层终点。作者分析与复核建议 / Author analysis
纠错时间改变有效速度
假定原始速度为v,每词发生需纠正事件的概率为e,每次额外花c秒,完整纠正后的平均词速可写成60除以每词原始时间与期望纠错时间之和。这个构造模型显示更快原始输出可能被纠错负担抵消。真实交流还包含选择、确认和停顿,因此应实测任务完成时间,而不能只把原始每分钟词数视为最终体验。作者分析与复核建议 / Author analysis
时延应分布化报告
平均延迟可能隐藏偶发长停顿,对实时对话尤其重要。应区分神经窗口、计算、语言搜索、声音合成和网络传输,并报告尾部。流式输出还涉及提前说出但后来需要修订的内容;若用户无法撤回,就会有不同控制问题。研究应在准确率、时延和修改策略之间展示权衡,而不是把最快样例当作典型性能。作者分析与复核建议 / Author analysis
提示句与自发沟通
照着屏幕尝试说已知句子,允许实验精确获得参考,但与用户自发交流具有不同分布。句长、词汇、停顿及表达目的都会改变。研究应明确任务类型,并在适当条件下逐步验证更自然交流。提示任务的成功很重要,却不能在没有新证据时自动升级为任意开放对话能力。作者分析与复核建议 / Author analysis
词表与测试重叠
有限词表和开放词表对应不同难度。训练句式、罕见词和同音词分布也会影响模型表现。若训练和测试共享大量句子或短语,语言先验可能帮助重识别。应按句子家族和时间会话划分,并报告词表外行为。未知词无法被输出时,系统需要明确拒识或替代机制,不能总用常见词覆盖。作者分析与复核建议 / Author analysis
会话漂移与长期适应
神经记录和用户策略可能随日期变化,模型重新校准也会影响评估。研究应将冻结模型的跨日表现与持续重训练的表现分开,记录每次更新使用了哪些资料。重训练后恢复不等于原模型长期不变稳定;两者都可以有实际价值,但维护负担和证据含义不同。作者分析与复核建议 / Author analysis
参与者与实验单位
大量句子、时间窗和电极通道并不等同大量独立参与者。个体内重复可评价稳定性,但不能自动确定跨人群效果。应保留参与者、会话和句子层级,避免用所有时间窗作为独立样本制造过窄区间。不同参与者的疾病背景、记录位置和既往沟通方式也可能影响结果,不能忽略。作者分析与复核建议 / Author analysis
拒识与意外触发
系统除了正确解码尝试表达,还需要辨认何时没有表达意图。只在已知开始信号后评价,会漏掉日常使用的误触发。应独立测量静息、其他动作和非目标状态下的输出,并允许用户明确启动、暂停和确认。本文只讨论研究终点,不提供任何植入或个体使用操作。作者分析与复核建议 / Author analysis
声音与虚拟面部输出
自然声音和面部动作可能增强表达,但可理解性、身份相似与情感控制是不同目标。听者转写准确率和用户认为是否表达原意也需要分别评价。生成声音越流畅,不意味着神经控制证据越强。研究应记录合成模型、训练来源及用户授权范围,并允许表达者决定如何呈现其声音和形象。作者分析与复核建议 / Author analysis
离线与在线结果
离线模型可以使用未来上下文或精确切分,在线系统则必须在因果时间内输出。把离线最佳结果写成实时能力,会忽略窗口和计算约束。应固定在线可用信息,记录真实运行时序,并区分后处理修正。计算设备与网络条件也属于可复现范围,不能只给算法复杂度来代表实际时延。作者分析与复核建议 / Author analysis
AI个性化的可解释边界
个性化可以利用用户词汇与习惯提高表现,但也可能让模型更依赖历史语言而非当前信号。应比较有无个性化的神经贡献,并允许用户修改或清除相应资料。模型更新需要可追溯,不应把一次反馈自动当成永久意图。研究层面的目标是检验辅助与控制之间的平衡,而非让系统越主动替用户补全越好。作者分析与复核建议 / Author analysis
隐私与表达者主体性
神经信号和沟通内容具有高度个人性,研究与展示应尊重许可和数据范围。自动生成的错误不应未经确认就作为参与者本人观点传播。共享复核材料时可以采用合法匿名摘要,同时保留足够任务与误差信息。本文没有读取真实神经或个人对话资料,也不把技术示范作为对任何个体的治疗建议。作者分析与复核建议 / Author analysis
解析复算与真实终点
句子模型可通过二项概率直接核对,纠错模型可按每词时间账本独立求和。两者均假设固定概率或成本,不包含真实认知负担、错误关联和学习。它们的作用是说明不同指标之间不能自动互换。真实研究应以用户参与的任务完成、可理解性和控制感评价补足,而不是用解析曲线替代人类体验。作者分析与复核建议 / Author analysis
可证伪的下一步比较
若新解码器降低WER,却增加尾部时延或重要语义错误,是否仍改善沟通需要实测。比较应预先规定任务、确认机制和维护频率,并在未见会话中冻结评价。一个真正更好的系统,应在相同信息边界下减轻整体交流负担,同时让用户保留选择和纠错能力,而不只是生成更顺滑的文本。作者分析与复核建议 / Author analysis
结论与研究包
可复核材料应包含合法任务摘要、会话划分、词表、语言模型、错误对齐、时延、更新和交互规则。语音脑机接口的进步,最终要落在表达者可以可靠控制的沟通,而不是单项算法纪录。将神经证据、语言帮助和人类体验分开又连接,能够让重要示范沿着可验证路径走向更广泛应用。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 替换、删除、插入总数除以参考词数;不是独立位置概率。
LaTeX
\mathrm{WER}=(S+D+I)/N(2) 明确独立位置错误的假定模型,不直接使用实测WER。
LaTeX
P(\mathrm{error\!\ free})=(1-p)^L(3) 每词固定额外纠错成本模型,假定最终全部纠正。
LaTeX
v_{\rm corrected}=60/(60/v+ec)(4) 神经证据与语言先验;具体解码结构可能不同。
LaTeX
P(w\mid s)\propto P(s\mid w)P_{\rm LM}(w)方法与证据流程
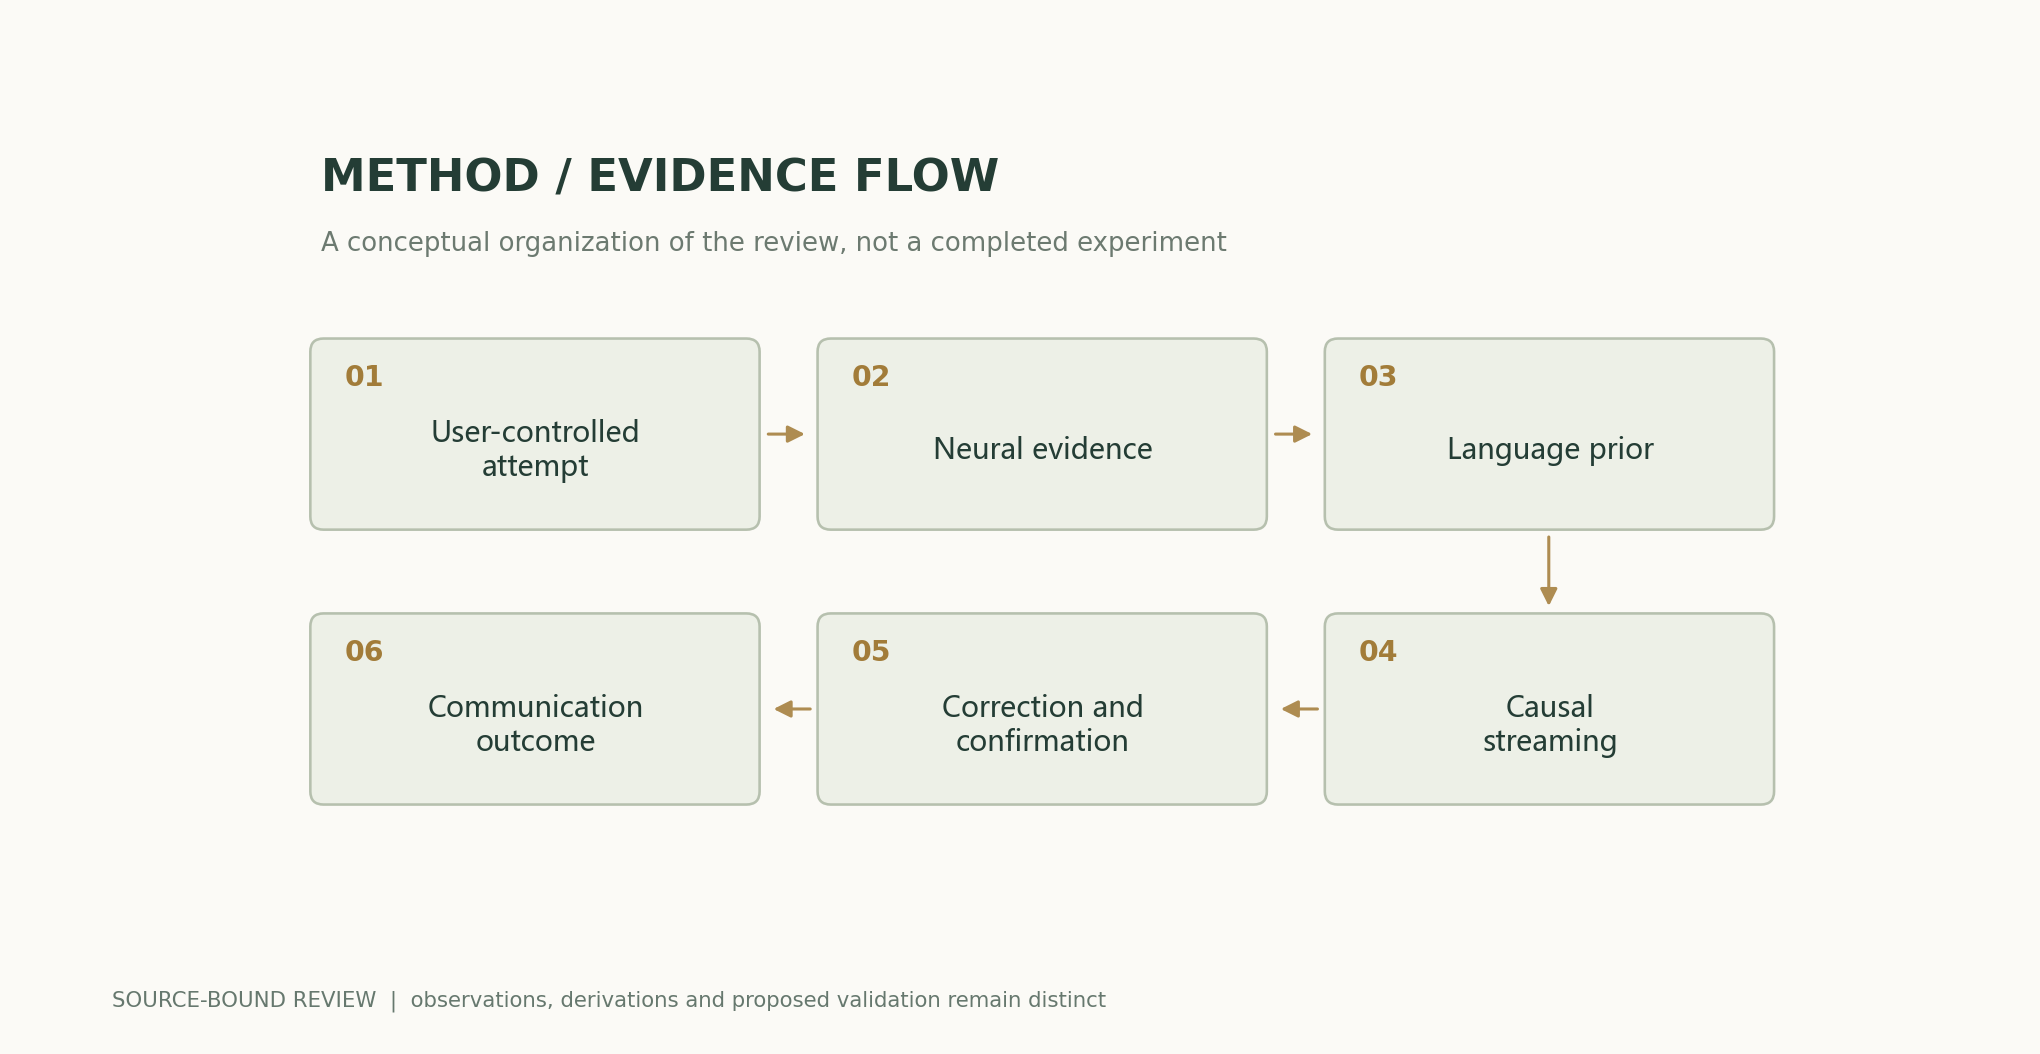
解析图与数值示例
可复算例题
60原始词/分、纠错事件率0.2且每次2秒,构造有效速度42.8571词/分;独立位置错0.2时20词全对概率0.8^20=0.0115292。
方法比较
| 方法或口径 | 直接约束 | 仍需补足的证据 |
|---|---|---|
| 词错误率 | 参考文本编辑错误 | 语义与交互后果 |
| 原始词速 | 输出速率 | 纠错与停顿 |
| 句子正确 | 完整短句结果 | 开放自发表达 |
| 平均时延 | 典型响应 | 长尾和意外触发 |
| 跨日冻结测试 | 固定模型稳定 | 维护与持续学习 |
| 用户任务表现 | 真实沟通负担 | 更广参与者与长期使用 |
复核与实验方案
- 固定提示或自发任务及主要终点。
- 记录合法会话、词表和参考文本。
- 按会话与句式隔离训练和测试。
- 分别比较神经与语言先验贡献。
- 保存错误对齐、语义类别及拒识。
- 实测尾部时延、纠错和确认成本。
- 区分冻结模型与持续更新结果。
- 公开合法摘要、模型版本及用户控制规则。
适用范围与局限
- 无新神经记录、植入或临床试验。
- 原研究参与者结果不能代表所有用户。
- 句子模型不把WER当独立错误率。
- 纠错成本固定是假定而非体验测量。
- 流畅生成不自动等于正确表达意图。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 神经信号支持特定参与者的大词表语音解码。 | 原任务、训练和记录条件。 | A high-performance speech neuroprosthesisAbstract; online decoding |
| 表面记录结合文字、声音及虚拟面部输出。 | 原参与者及不同输出的评价范围。 | A high-performance neuroprosthesis for speech decoding and avatar controlAbstract; multimodal evaluation |
值得检验的研究问题
- WER下降是否同时降低真实交流负担?
- 模型跨日漂移与维护如何量化?
- 语言先验何时改善形式却改变原意?
一手来源与主张对应
- A high-performance speech neuroprosthesisFrancis R. Willett, Erin M. Kunz, Chaofei Fan, Donald T. Avansino, Guy H. Wilson, Eun Young Choi, et al. · 2023-08-23Abstract; online text decoding
- A high-performance neuroprosthesis for speech decoding and avatar controlSean L. Metzger, Kaylo T. Littlejohn, Alexander B. Silva, David A. Moses, Margaret P. Seaton, Ran Wang, et al. · 2023-08-23Abstract; speech/text/avatar evaluation
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:跨学科科学证据深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: 500575872cce7c4b9c4062a12bb0692eb580c2da