
الملخص
قد تغيّر عينات التدريب المتكررة سلوك الحفظ، وقد يؤدي دخول محتوى الاختبار في التدريب إلى تشويه تقييم التعميم، لكنهما مسألتان مختلفتان. يميّز هذا المقال بين التكرارات التامة وعائلات العينات شبه المتطابقة والتداخل الدلالي وتسرب بيانات التقييم، ويقترح مسارًا يبدأ بالتقسيم بحسب عائلات المصدر، ثم تدقيق المطابقات القائمة على التشابه. لا تعرض الرسوم التحليلية سوى مزج الدرجات تحت نسب تلوث مفترضة، ولا تتهم أي نموذج أو مجموعة بيانات فعلية.[1] Deduplicating Training Data Makes Language Models Bette[2] Documenting Large Webtext Corpora: A Case Study on the [3] Holistic Evaluation of Language Models
ترجمة الملخص الإنجليزي الأصلي
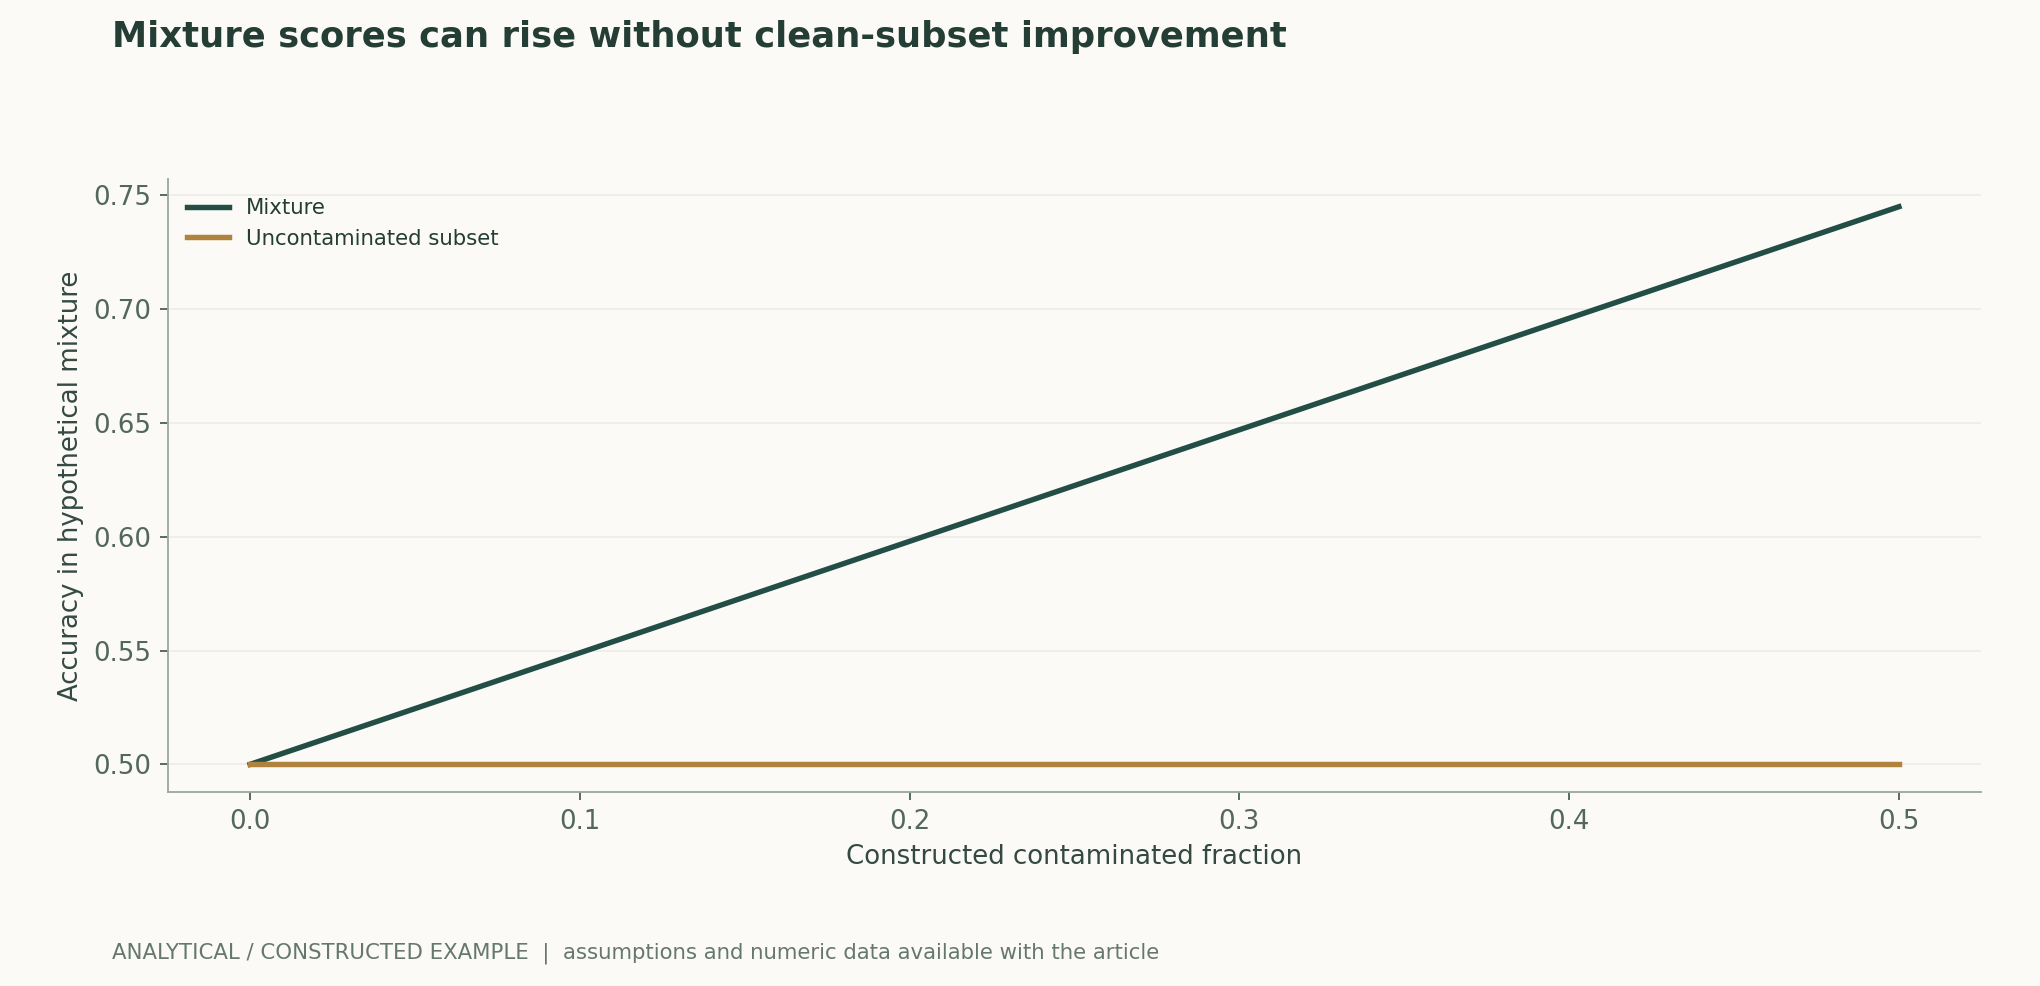
إزالة التكرار وتلوث الاختبارات المعيارية مسألتان منفصلتان في التدقيق. نحلل المطابقات التامة وعائلات العينات شبه المتطابقة والحفظ المرتبط بالخصوصية وتسرب بيانات التقييم. يوضح نموذج مزج مُصرَّح به كيف يمكن للعناصر الملوثة أن ترفع الدرجة دون تحسين الدقة على العناصر غير الملوثة. لا يشكل الشكل دليلًا يتعلق بأي نموذج أو اختبار معياري قائم.
1. ينبغي توضيح أهداف إزالة التكرار أولًا
قد يختلف تعريف التكرار باختلاف الهدف، سواء أكان تقليل التدريب المتكرر، أم خفض مخاطر حفظ المعلومات الخاصة، أم منع تلوث الاختبار. فظهور الحقيقة العامة نفسها في مصادر متعددة لا يشكل بالضرورة غشًا في التقييم؛ لكن إعادة صياغة طفيفة للسؤال نفسه قد تسرّب الإجابة. تُظهر أبحاث إزالة التكرار آثار البيانات المتكررة في التدريب والتقييم، بينما تركز أبحاث استخراج بيانات التدريب على مخاطر التسرب الناجم عن الحفظ. وعند تصميم التدقيق، ينبغي تحديد ما يُراد حمايته ووحدة الحكم، وتجنب استخدام عتبة تشابه واحدة بديلًا عن جميع السياسات.[1] Deduplicating Training Data Makes Language Models Bette[2] Documenting Large Webtext Corpora: A Case Study on the
2. المطابقة التامة موثوقة لكن تغطيتها محدودة
يمكن للتجزئة بعد التطبيع أن تحدد بكفاءة النصوص المتطابقة تمامًا، لكن المسافات البيضاء والتنسيق والترجمة وإعادة الصياغة تغيّر جميعها البايتات. وفي المقابل، قد يؤدي التطبيع المفرط إلى دمج شيفرات أو مسائل رياضية مختلفة أصلًا. ينبغي حفظ قيم تجزئة النصوص الأصلية وقواعد التطبيع ومواضع المطابقة، بحيث يمكن تتبع كل عملية حذف. ويمكن للمطابقة التقريبية أن توسّع التغطية، لكن يجب تقدير النتائج الإيجابية الكاذبة والسلبية الكاذبة، ولا سيما في الأسئلة التي تتشارك القالب وتختلف في الحالة المحددة؛ فلا يكفي عرض بضعة أمثلة لتكرارات اكتُشفت بنجاح.[1] Deduplicating Training Data Makes Language Models Bette
3. التقسيم على مستوى العائلات أهم من التقسيم العشوائي لكل عينة على حدة
ينبغي التعامل مع إعادة الصياغة والترجمات والشروح للوثيقة أو السؤال أو التجربة الأصلية نفسها بوصفها عائلة مترابطة. فإذا أُجري التقسيم العشوائي لكل عينة على حدة أولًا، ثم أُزيلت التكرارات التامة، فقد تكون المتغيرات قد توزعت بالفعل بين التدريب والاختبار. ينبغي تحديد علاقات المصدر أو التوليد قبل التقسيم، وإسناد المجموعة بأكملها إلى الجانب نفسه. وعندما يتعذر تحديد العائلة، ينبغي الاحتفاظ بعلامات عدم اليقين وإتاحة المراجعة البشرية، بدلًا من وصف ما لم يكتشفه الكاشف مباشرة بأنه غير ملوث. كما تُعد فهارس الأنظمة المعززة بالاسترجاع من مصادر البيانات التي تستلزم التدقيق.[1] Deduplicating Training Data Makes Language Models Bette[3] Holistic Evaluation of Language Models
4. الدرجات المختلطة تحجب القدرة على العينات غير الملوثة
لنفترض أن نسبة العينات الملوثة هي c، وأن دقتها هي a1، وأن دقة العينات الأخرى هي a0؛ عندئذ تكون الدرجة الكلية المتوسط المرجح لهما. وحتى إن بقيت a0 دون أي تغيير، فقد تؤدي زيادة c إلى ارتفاع الدرجة الكلية. يثبت شكل هذا المقال a0=0.5 وa1=0.99 لعرض علاقة التطابق هذه؛ ولا يقدّر أي معدل تلوث فعلي. وينبغي للتدقيق الفعلي أن يجري التقسيم الطبقي بحسب قوة المطابقة وزمن المصدر، وأن يعرض الدرجات وأعداد العينات قبل الاستبعاد وبعده كلًّا على حدة، مع الإقرار بعدم اكتمال الكشف.[3] Holistic Evaluation of Language Models[1] Deduplicating Training Data Makes Language Models Bette
5. حفظ المعلومات الخاصة وتسرب الإجابات يتطلبان أدلة مختلفة
إن قدرة النموذج على إخراج مقاطع من بيانات التدريب لا تثبت تلقائيًا أن درجة اختبار معياري بعينه ناجمة عن التلوث؛ كما أن ظهور أسئلة الاختبار في التدريب لا يعني أنها تتضمن بالضرورة معلومات شخصية خاصة. تتطلب الحالة الأولى استخراجًا مضبوطًا وتقييمًا للخصوصية، بينما تتطلب الثانية أدلة تتعلق بالزمن والمصدر والعلاقة بالإجابة. لا ينفذ هذا المقال أي استخراج لبيانات شخصية فعلية. وينبغي للتقارير البحثية أن تنشر الحد الأدنى الضروري فقط من البيانات الوصفية للمطابقة والمقاطع التي يجوز عرضها قانونًا، لتجنب إعادة نشر مواد حساسة بغرض إثبات المخاطر.[2] Documenting Large Webtext Corpora: A Case Study on the [1] Deduplicating Training Data Makes Language Models Bette
6. ينبغي أن يتيح التدقيق الموثوق مراجعة قرارات الحذف
ينبغي حفظ إصدار الكاشف والعتبات والعائلات المتطابقة واستنتاجات المراجعة وأسباب الحذف، وفحص عينات من جانبي الاحتفاظ والحذف. وينبغي أيضًا استخدام عينات مستقلة أحدث عهدًا، أو مضبوطة المصدر، أو خاصة ولكن مصرَّح باستخدامها قانونًا، مع تثبيت بروتوكول التقييم. يؤكد HELM التقييم متعدد الأبعاد والشفافية، وبناءً على ذلك ينبغي في هذه المهمة الإبلاغ معًا عن قيود كشف التلوث والفروق بين المقاييس. فعدم العثور على مطابقات لا يثبت انعدام التداخل، ولا يمكن لدرجة إجمالية واحدة أن تحل محل تدقيق التلوث.[3] Holistic Evaluation of Language Models[1] Deduplicating Training Data Makes Language Models Bette
المعادلات الأساسية واشتقاقاتها
(1) متطابقة الترجيح الطبقي؛ القيمتان A0=0.5 وA1=0.99 في الشكل افتراضيتان، وليستا قياسين لنموذج.
LaTeX
A_{\mathrm{mix}}=(1-c)A_0+cA_1(2) لا يعبّر عن الفرق بين الدرجة المختلطة وA0 إلا إذا انطبقت تعريفات الطبقات المذكورة، ولا يجوز الاستدلال منه عكسيًا على معدل التلوث الفعلي.
LaTeX
\Delta A=c(A_1-A_0)(3) يجب تقدير النتائج الإيجابية الكاذبة والسلبية الكاذبة لكاشف المطابقات باستخدام عينات موسومة بشريًا أو عينات أُدرجت بطريقة مضبوطة، مع توضيح أسلوب أخذ العينات.
LaTeX
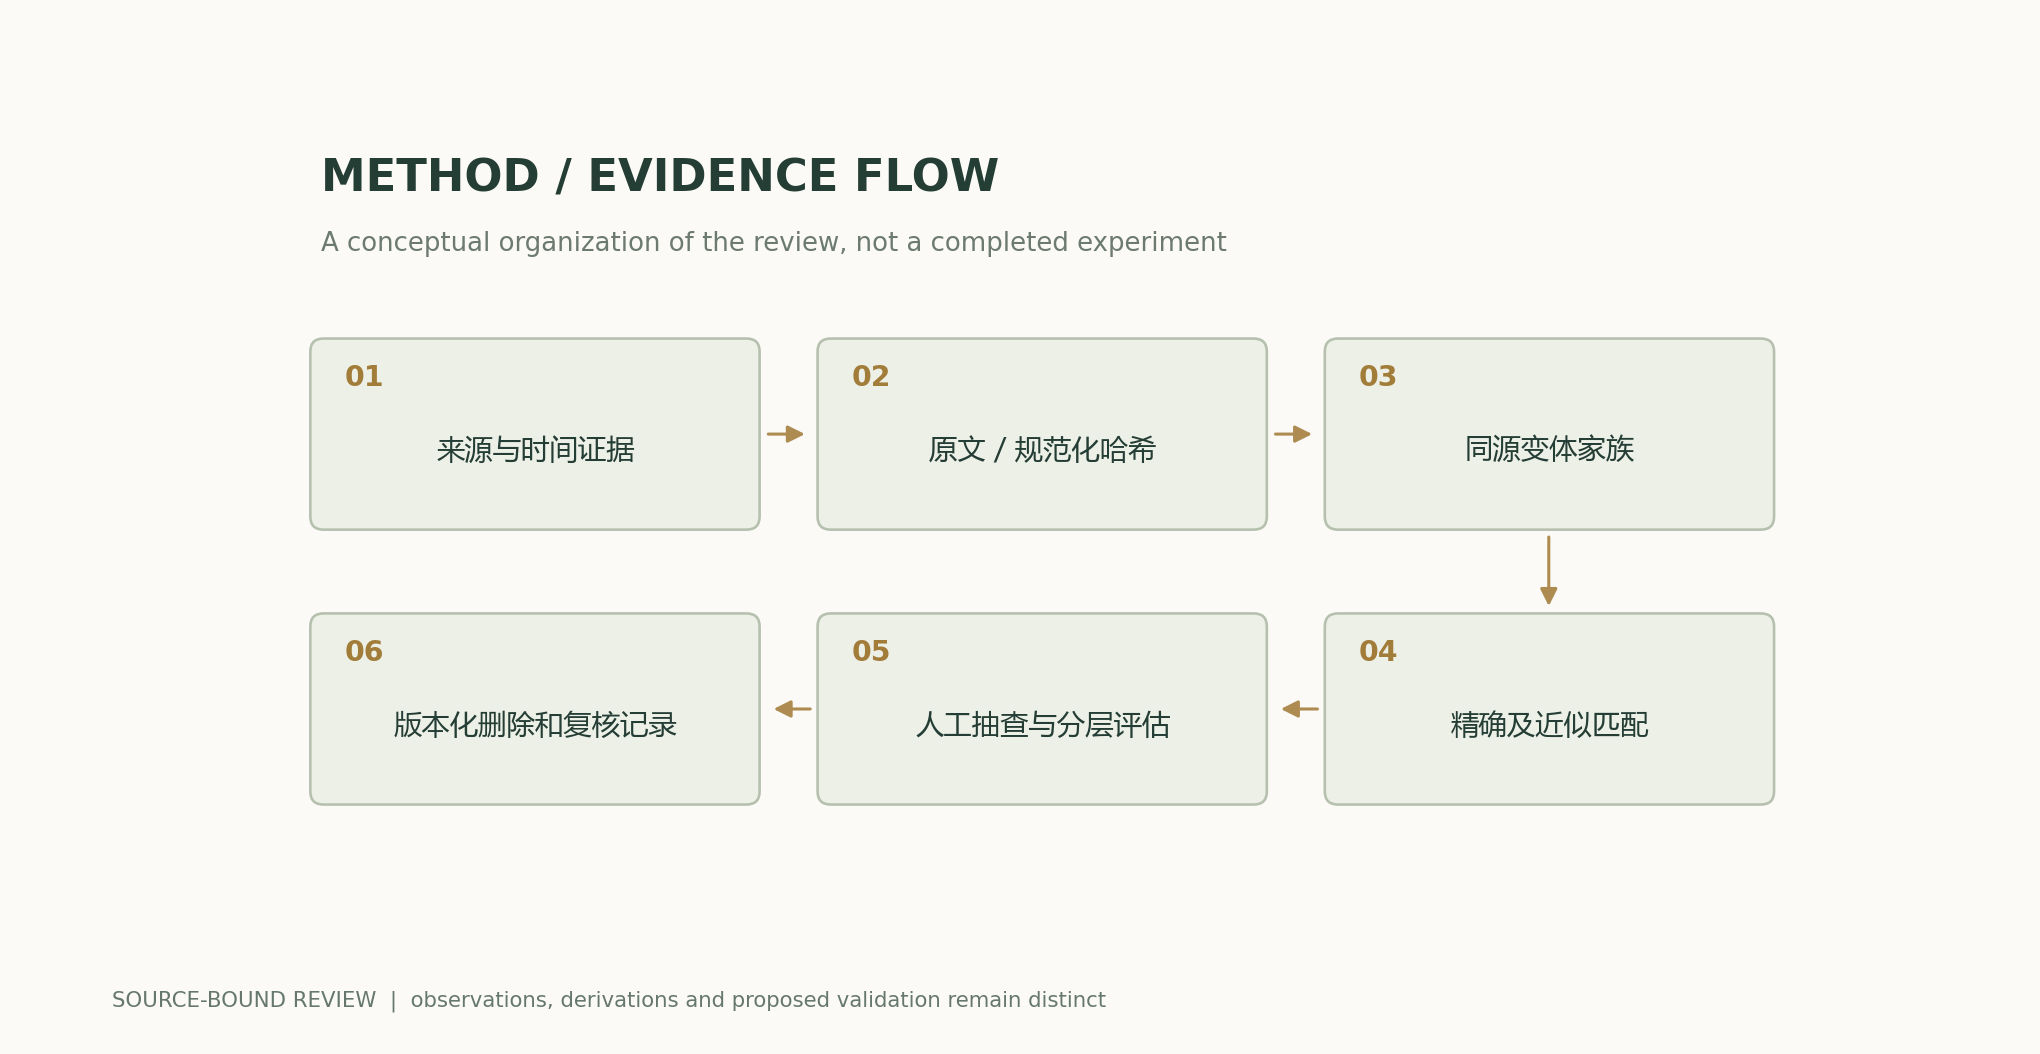
\mathrm{precision}=\frac{TP}{TP+FP},\qquad\mathrm{recall}=\frac{TP}{TP+FN}مسار المنهج والأدلة
رسوم تحليلية وأمثلة عددية
مثال محلول يمكن إعادة حسابه
بافتراض أن دقة الجزء الملوث هي 0.99 ودقة الباقي هي 0.50، فعندما تبلغ نسبة التلوث 20% تكون الدرجة الكلية 0.598، بينما تظل القدرة على العينات غير الملوثة 0.50. وهذه مجرد علاقة تطابق قائمة على الترجيح، ولا يمكن الاستدلال منها عكسيًا على معدل التلوث الفعلي.
مقارنة المناهج
| المنهج أو الحكم | المتغيرات المضبوطة والقياس | شروط الإخفاق وتفسيرها |
|---|---|---|
| التكرارات التامة | حفظ قواعد التطبيع وقيم التجزئة | يفوّت الترجمات وإعادة الصياغة |
| المطابقة التقريبية | فحص الإحكام والاستدعاء باستخدام عينات طبقية | قد يؤدي تشابه القوالب إلى حذف خاطئ |
| التقسيم بحسب العائلات | تجميع المتغيرات ذات الأصل المشترك قبل التقسيم | قد يؤدي التقسيم العشوائي لكل عينة على حدة إلى التسرب |
| التقييم الطبقي بحسب التلوث | عرض الدرجات وأعداد العينات قبل الاستبعاد وبعده | عدم العثور على مطابقات لا يثبت غياب التلوث |
خطة المراجعة والتجارب
- تحديد الأهداف المختلفة لإزالة التكرار وتدقيق التلوث، وتثبيت وحدة الكشف والسياسات.
- تسجيل تجزئات النصوص الأصلية وزمن المصدر وإصدارات التطبيع والكاشف.
- التقسيم أولًا بحسب عائلات الوثائق أو الأسئلة أو التوليد، ثم إجراء المطابقة التامة والتقريبية.
- أخذ عينات طبقية من جانبي الاحتفاظ والحذف لتقدير النتائج الإيجابية الكاذبة والسلبية الكاذبة وعدم اليقين.
- الإبلاغ عن طبقات التلوث والمقاييس قبل الاستبعاد وبعده، والتحقق باستخدام مجموعة اختبار مستقلة ومضبوطة.
- نشر الحد الأدنى الضروري من البيانات الوصفية للتدقيق، مع الإبقاء على مسار قانوني للمراجعة وتجنب تسريب المواد الخاصة.
نطاق التطبيق والقيود
- لا يقدّر رسم المزج معدل التلوث الفعلي.
- لا يثبت التشابه تلقائيًا تسرب الإجابات.
- قد يؤدي الكشف إلى حذف خاطئ وفوات اكتشاف حالات في آن واحد.
- لم يُجرَ استخراج لمحتوى خاص فعلي.
مطابقة المصادر الأولية بالادعاءات
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus, , , , , , , · 2021-04-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Holistic Evaluation of Language ModelsLiang et al. · 2022-11-16v2 abstract; seven dimensions and evaluation coverage
الاستشهاد وتصدير المخطوط
BibTeXRISCSL JSONTXTالمقال JSON
التأليف والإصدار والمصادر
مراجعة بحثية بمساعدة الذكاء الاصطناعي؛ كتبها Codex (ذكاء اصطناعي) وأجرى اشتقاقاتها التحليلية استنادًا إلى المراجع الأولية المدرجة. لا يتضمن هذا الموقع سجلًا لمراجعة أقران مستقلة لهذا المقال أو لتجارب أصلية على نماذج.
تعديل أداء القارئ: يُعاد أيضًا استخدام الصفحات المقروءة عندما يعيد طلب HEAD حديث الحالة 200 وتكون قيمة ETag مطابقة. يحتفظ المتن والمعادلات والمصادر وبيانات الأشكال العلمية بمحتوى الإصدار السابق.
يُفصل الغلاف المفاهيمي عن الأشكال العلمية؛ وتُحسب الأشكال العلمية انطلاقًا من معادلات متاحة علنًا وافتراضات معلنة، مع إسناد جميع نتائج الأوراق الأصلية إلى أصحابها.
سجل التأليف والإصدارات والتصحيحات · /guides/data-dedup-contamination/v1/
مصادر الغلاف والأشكال العلمية · البيانات والمصادر والافتراضات · سجل النشر والإصدارات
مراجعة المصدر: 6251a250b27bb8b449f59b392f81abd355383770