
摘要
重复训练样本可能改变记忆行为,测试内容进入训练又可能使泛化评估失真,但二者不是同一个问题。本文区分精确重复、近似家族、语义重叠和评测泄漏,提出先按来源家族划分、再审计相似匹配的流程。解析图仅展示假设污染比例下的分数混合,不指控任何真实模型或数据集。[1] Deduplicating Training Data Makes Language Models Bette[2] Documenting Large Webtext Corpora: A Case Study on the [3] Holistic Evaluation of Language Models
English abstract
Deduplication and benchmark contamination are separate audit questions. We analyze exact matches, near-duplicate families, privacy-related memorization and evaluation leakage. A declared mixture model illustrates how contaminated items can inflate a score without improving uncontaminated accuracy. The figure is not evidence about any existing model or benchmark.
1. 去重目标应先写清楚
减少重复训练、降低隐私记忆风险与防止测试污染,对重复的定义可能不同。同一公开事实出现在多个来源不必然构成评测作弊;同一道题的轻微改写却可能泄漏答案。去重研究展示了重复数据对训练与评估的影响,训练数据提取研究则关注记忆泄露风险。设计审计时应明确保护对象和判断单位,避免用一个相似度阈值代替所有政策。[1] Deduplicating Training Data Makes Language Models Bette[2] Documenting Large Webtext Corpora: A Case Study on the
2. 精确匹配可靠但覆盖有限
规范化后哈希能高效识别完全一致文本,但空白、格式、翻译和改写都会改变字节。过强规范化又可能把本来不同的代码或数学题合并。应保存原文哈希、规范化规则和匹配位置,使每次删除可回溯。近似匹配可以补充覆盖,但必须估计误报和漏报,特别是模板相同而实例不同的题目,不能只展示几个成功找到的重复案例。[1] Deduplicating Training Data Makes Language Models Bette
3. 家族划分比逐条随机划分更重要
同一原始文档、题目或实验的改写、翻译与解释应作为相关家族处理。若先逐条随机划分,再去除精确重复,变体可能已横跨训练和测试。应在划分前建立来源或生成关系,并把整组分配到同一侧。无法确定家族时,要保留不确定标记和人工复核,而不是把未命中检测器直接称为无污染。检索增强系统的索引也属于需要审计的数据来源。[1] Deduplicating Training Data Makes Language Models Bette[3] Holistic Evaluation of Language Models
4. 混合分数掩盖了未污染能力
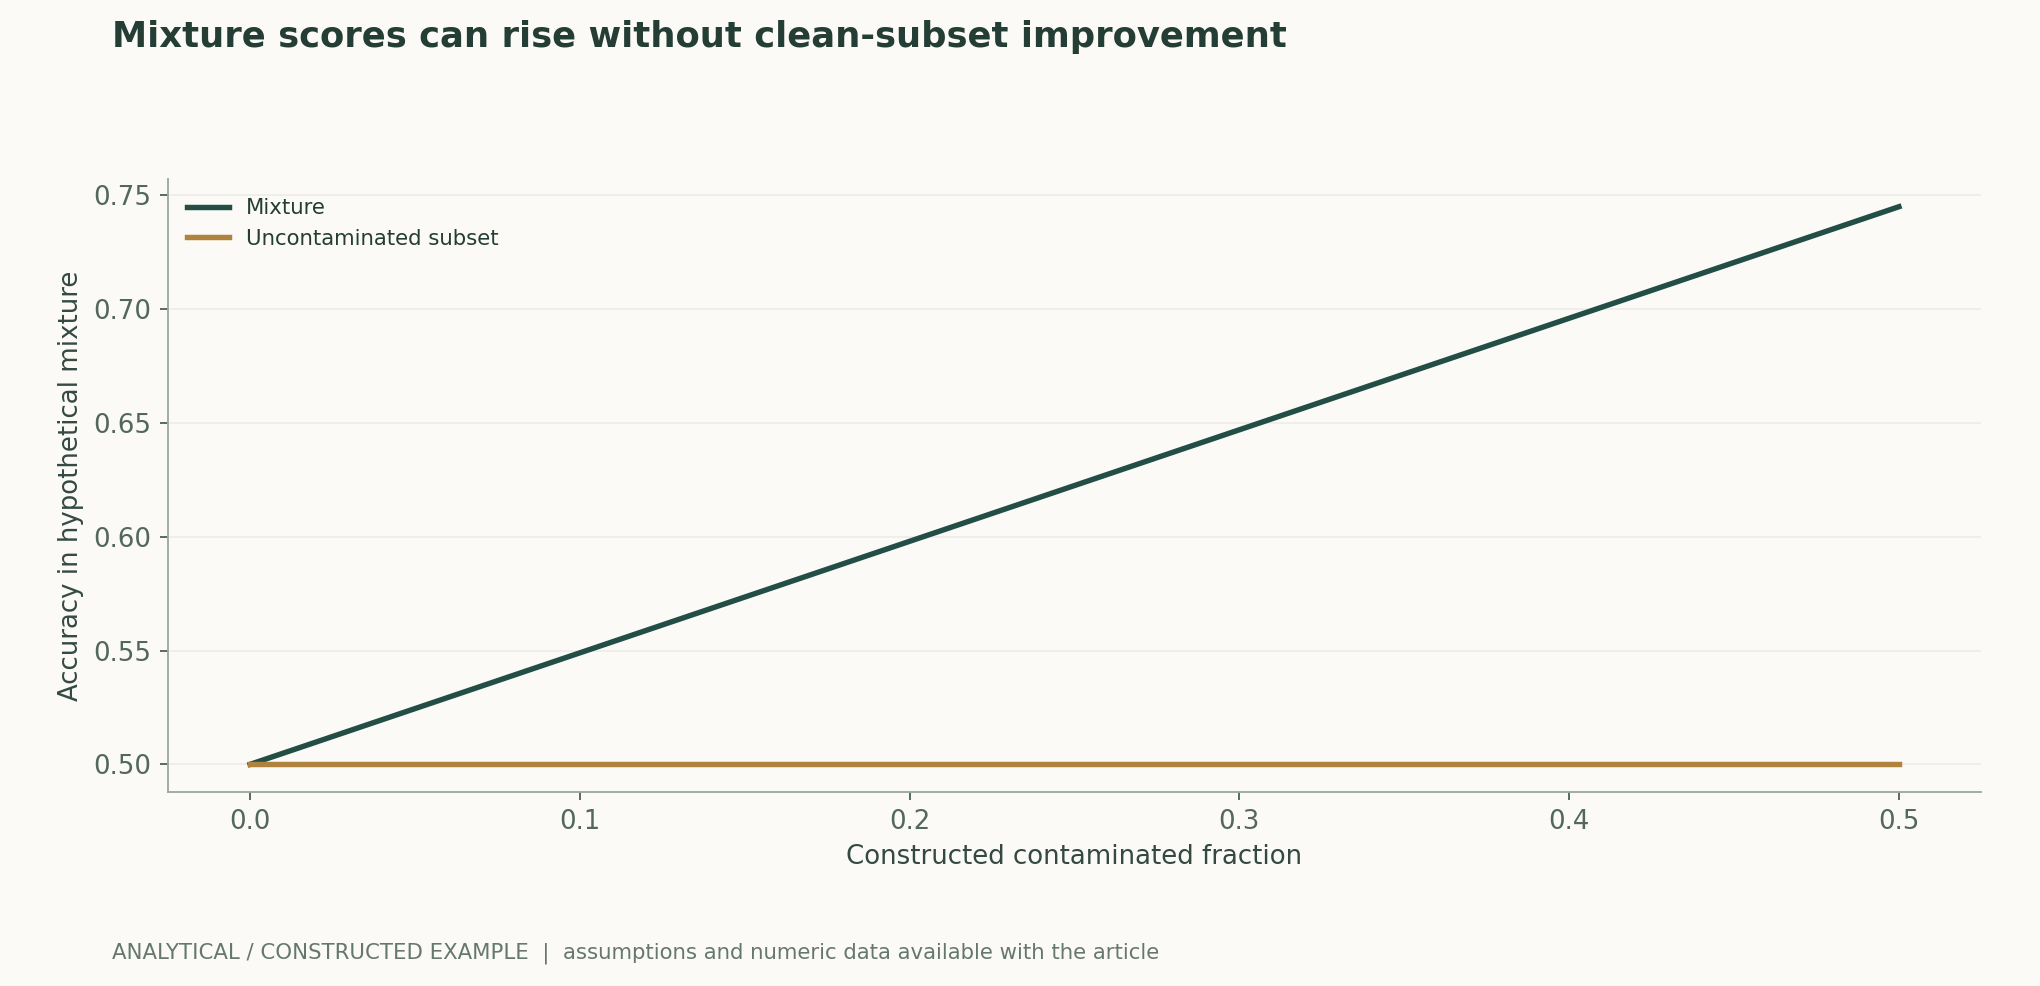
设污染样本占比c,其准确率为a1,其他样本为a0,总分是二者的加权平均。即便a0完全不变,c增加也能让总分上升。本篇图固定a0=0.5、a1=0.99,展示这个恒等关系;它不估计任何真实污染率。实际审计应按匹配强度和时间来源分层,分别报告排除前后分数与样本数,并承认检测不完整。[3] Holistic Evaluation of Language Models[1] Deduplicating Training Data Makes Language Models Bette
5. 隐私记忆与答题泄漏需要不同证据
模型能输出训练片段,不自动证明某次 benchmark 分数由污染造成;测试题出现在训练中,也不意味着其中一定含个人隐私。前者需要受控提取与隐私评估,后者需要时间、来源和答案关系的证据。本篇不执行任何真实个人数据提取。研究报告应仅公开最小必要的匹配元数据和合法可展示片段,避免为了证明风险再次传播敏感材料。[2] Documenting Large Webtext Corpora: A Case Study on the [1] Deduplicating Training Data Makes Language Models Bette
6. 一个可信审计应允许复核删除决定
保存检测版本、阈值、匹配家族、复核结论和删除理由,抽样检查保留与删除两侧。评测同时使用较新、来源受控或私有但合法授权的独立样本,并固定评估协议。HELM强调多维评价与透明性,本任务中应据此同时报告污染检测局限和指标差异。没有命中不等于证明没有重叠,污染审计也不能由一个总体分数代替。[3] Holistic Evaluation of Language Models[1] Deduplicating Training Data Makes Language Models Bette
核心公式与推导
(1) 分层加权恒等式;图示A0=0.5、A1=0.99均为假设,不是模型测量。
LaTeX
A_{\mathrm{mix}}=(1-c)A_0+cA_1(2) 只有在所列分层定义成立时,表示混合分数相对于A0的差异,不能据此反推真实污染率。
LaTeX
\Delta A=c(A_1-A_0)(3) 匹配检测器需以人工标注或受控注入样本估计误报漏报,并说明抽样方式。
LaTeX
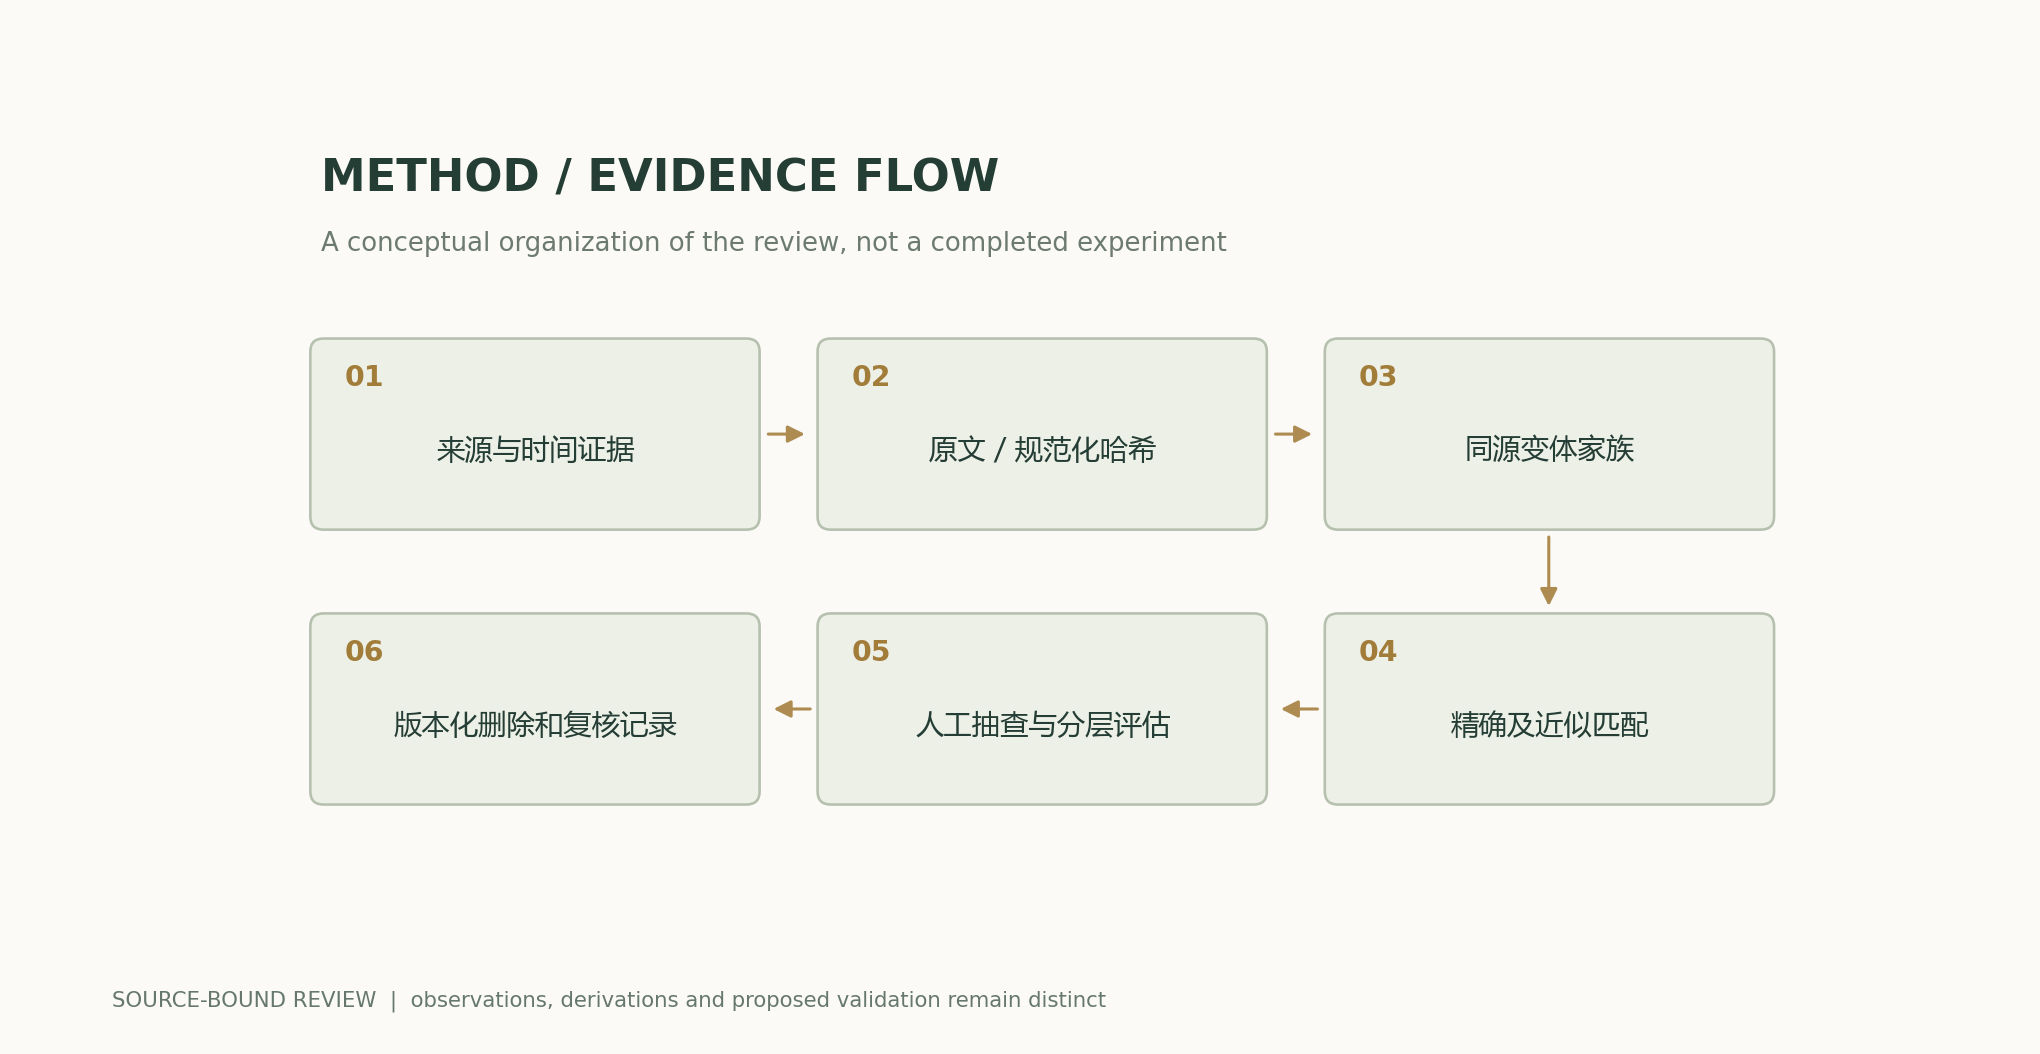
\mathrm{precision}=\frac{TP}{TP+FP},\qquad\mathrm{recall}=\frac{TP}{TP+FN}方法与证据流程
解析图与数值示例
可复算例题
假设污染部分准确率0.99、其余0.50,污染占20%时总分0.598,而未污染能力仍0.50。这只是加权恒等关系,不能反推出真实污染率。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 精确重复 | 保留规范化规则与哈希 | 漏掉翻译和改写 |
| 近似匹配 | 分层抽查精确率和召回率 | 模板相似可能造成误删 |
| 家族划分 | 先聚合同源变体再划分 | 逐条随机划分可能泄漏 |
| 污染分层评估 | 列出排除前后分数与样本数 | 未命中不能证明无污染 |
复核与实验方案
- 定义去重与污染的不同目标,固定检测单位及政策。
- 记录原文哈希、来源时间、规范化和检测器版本。
- 先按文档/题目/生成家族划分,再执行精确与近似匹配。
- 对保留和删除两侧分层抽样,估计误报、漏报及不确定性。
- 报告污染分层与排除前后指标,使用独立受控测试集复核。
- 发布最小必要审计元数据,保留合法复核路径并避免泄露私人材料。
适用范围与局限
- 混合图不估计真实污染率。
- 相似度不自动证明答案泄漏。
- 检测可能同时误删和漏检。
- 没有进行真实隐私内容提取。
一手来源与主张对应
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus, , , , , , , · 2021-04-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Holistic Evaluation of Language ModelsLiang et al. · 2022-11-16v2 abstract; seven dimensions and evaluation coverage
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
阅读器性能修订:新近 HEAD 返回 200 且 ETag 相同时也复用已读页面。正文、公式、来源和科学图的数据保持上一版本内容。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/data-dedup-contamination/v1/
Source revision: 6251a250b27bb8b449f59b392f81abd355383770