
要旨
訓練サンプルの重複は記憶挙動を変える可能性があり、テスト内容の訓練への混入は汎化評価を歪める可能性があるが、両者は同じ問題ではない。本稿は完全重複、近似重複ファミリー、意味的重複、評価データの漏洩を区別し、まず出所ファミリー単位で分割し、その後に類似一致を監査する手順を提案する。解析図は仮定した汚染割合の下でのスコアの混合のみを示し、実在のモデルやデータセットに対する告発を意図しない。[1] Deduplicating Training Data Makes Language Models Bette[2] Documenting Large Webtext Corpora: A Case Study on the [3] Holistic Evaluation of Language Models
原文英語要旨の日本語訳
重複除去とベンチマーク汚染は、監査における別個の問題である。本稿では、完全一致、近似重複ファミリー、プライバシーに関わる記憶、および評価データの漏洩を分析する。明示した混合モデルにより、汚染された項目が非汚染項目の正解率を改善せずにスコアを押し上げ得ることを例示する。この図は、既存のモデルやベンチマークに関する証拠ではない。
1. 重複除去の目的を先に明確にする
重複した訓練の削減、私的情報の記憶リスクの低減、テスト汚染の防止では、重複の定義が異なる場合がある。同じ公開事実が複数の情報源に現れることは必ずしも評価上の不正を構成しないが、同じ問題の軽微な言い換えは解答を漏洩させる可能性がある。重複除去の研究は重複データが訓練と評価に及ぼす影響を示す一方、訓練データ抽出の研究は記憶による漏洩リスクに焦点を当てる。監査設計では保護対象と判断単位を明確にし、単一の類似度閾値であらゆる方針を代替することを避けるべきである。[1] Deduplicating Training Data Makes Language Models Bette[2] Documenting Large Webtext Corpora: A Case Study on the
2. 完全一致は信頼できるが、網羅性には限界がある
正規化後のハッシュ化は完全に同一のテキストを効率的に識別できるが、空白、書式、翻訳、言い換えはいずれもバイト列を変える。一方、過度の正規化は、本来異なるコードや数学問題を同一視するおそれがある。各削除を追跡できるよう、原文ハッシュ、正規化規則、一致箇所を保存する必要がある。近似照合は網羅性を補完できるが、偽陽性と偽陰性を推定しなければならない。とりわけ、テンプレートが同じでも個別事例が異なる問題では、検出に成功した重複例を少数示すだけでは不十分である。[1] Deduplicating Training Data Makes Language Models Bette
3. 個別サンプルのランダム分割よりもファミリー単位の分割が重要である
同じ原文書、問題、実験に由来する言い換え、翻訳、説明は、関連するファミリーとして扱うべきである。個別サンプルをランダムに分割してから完全重複を除去すると、変種がすでに訓練とテストにまたがっている可能性がある。分割前に出所または生成関係を確立し、グループ全体を同じ側に割り当てる必要がある。ファミリーを特定できない場合には、検出器が検出しなかったものを直ちに非汚染と呼ぶのではなく、不確実性の標識と人手による再検証を維持する必要がある。検索拡張システムのインデックスも、監査を要するデータ源に含まれる。[1] Deduplicating Training Data Makes Language Models Bette[3] Holistic Evaluation of Language Models
4. 混合スコアは非汚染サンプルにおける能力を覆い隠す
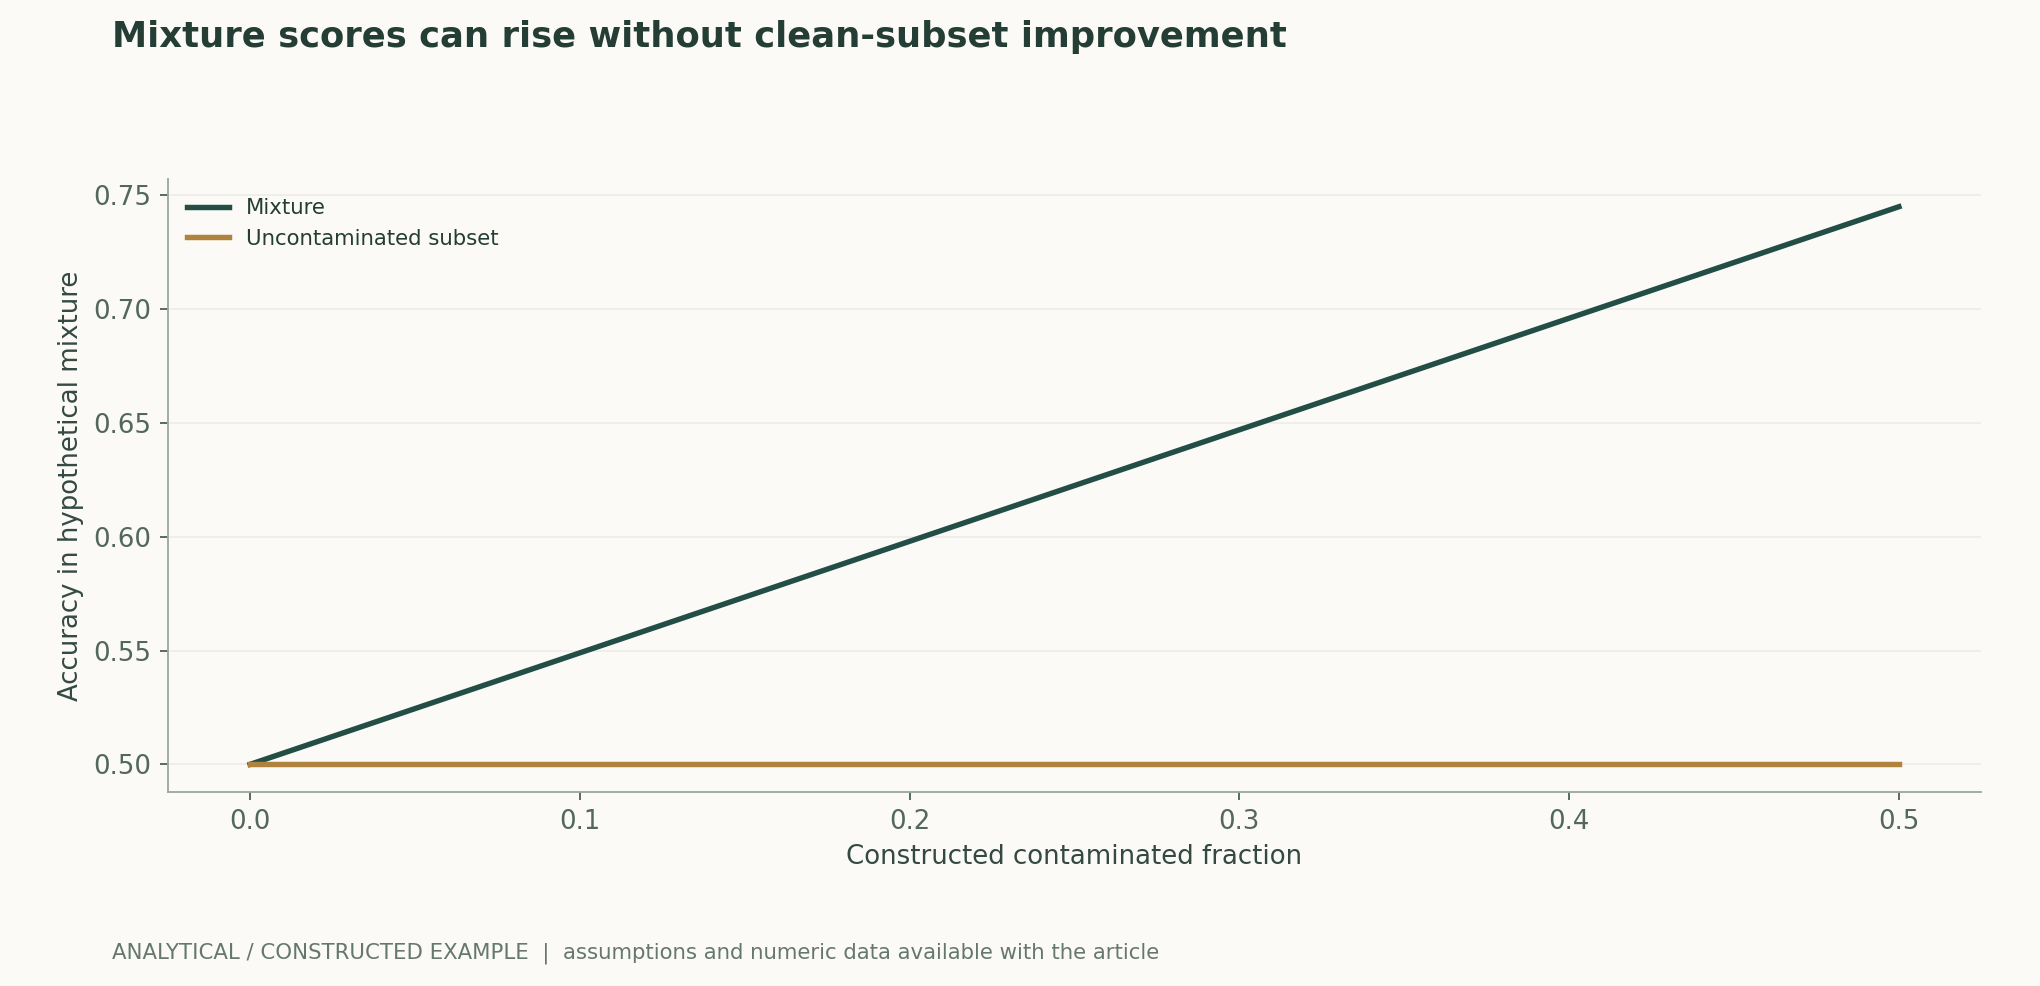
汚染サンプルの割合をc、その正解率をa1、その他のサンプルの正解率をa0とすると、総合スコアは両者の加重平均となる。a0がまったく変わらなくても、cの増加によって総合スコアは上昇し得る。本稿の図はa0=0.5とa1=0.99を固定し、この恒等関係を示すものであり、実際の汚染率を推定するものではない。実際の監査では、一致の強さと出所の時期に基づいて層別化し、除外前後のスコアとサンプル数をそれぞれ報告するとともに、検出が不完全であることを認める必要がある。[3] Holistic Evaluation of Language Models[1] Deduplicating Training Data Makes Language Models Bette
5. 私的情報の記憶と解答漏洩には異なる証拠が必要である
モデルが訓練データの断片を出力できることは、特定のベンチマークスコアが汚染によって生じたことを自動的に証明しない。また、テスト問題が訓練に含まれることも、そこに必ず個人の私的情報が含まれることを意味しない。前者には統制された抽出とプライバシー評価が必要であり、後者には時期、出所、解答との関係に関する証拠が必要である。本稿では実際の個人データの抽出を一切行わない。研究報告では、必要最小限の一致メタデータと合法的に提示できる断片のみを公開し、リスクを立証するために機微な資料を再拡散することを避けるべきである。[2] Documenting Large Webtext Corpora: A Case Study on the [1] Deduplicating Training Data Makes Language Models Bette
6. 信頼できる監査では削除判断を再検証できる必要がある
検出器のバージョン、閾値、一致したファミリー、再検証の結論、削除理由を保存し、保持側と削除側の双方を抽出検査する。評価では、より新しいサンプル、出所が管理されたサンプル、または非公開だが合法的に利用を許諾された独立サンプルも使用し、評価プロトコルを固定する。HELMは多次元評価と透明性を重視しており、本課題でもこれに基づき、汚染検出の限界と指標の差異を併せて報告すべきである。一致が検出されないことは重複がないことの証明ではなく、単一の総合スコアで汚染監査を代替することもできない。[3] Holistic Evaluation of Language Models[1] Deduplicating Training Data Makes Language Models Bette
主要な数式と導出
(1) 層別加重の恒等式。図中のA0=0.5とA1=0.99はいずれも仮定であり、モデルの測定値ではない。
LaTeX
A_{\mathrm{mix}}=(1-c)A_0+cA_1(2) 記載した層の定義が成立する場合に限り、混合スコアとA0との差を表す。これを用いて実際の汚染率を逆算することはできない。
LaTeX
\Delta A=c(A_1-A_0)(3) 一致検出器では、人手でラベル付けしたサンプルまたは統制下で注入したサンプルを用いて偽陽性と偽陰性を推定し、抽出方法を説明する必要がある。
LaTeX
\mathrm{precision}=\frac{TP}{TP+FP},\qquad\mathrm{recall}=\frac{TP}{TP+FN}方法と証拠の処理フロー
解析図と数値例
再計算可能な例題
汚染部分の正解率を0.99、残りを0.50と仮定すると、汚染割合が20%のとき総合スコアは0.598となる一方、非汚染サンプルにおける能力は0.50のままである。これは加重平均の恒等関係にすぎず、実際の汚染率を逆算することはできない。
方法の比較
| 方法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| 完全重複 | 正規化規則とハッシュを保持する | 翻訳や言い換えを見逃す |
| 近似照合 | 層別抽出検査によって適合率と再現率を確認する | テンプレートの類似が誤削除を引き起こす可能性がある |
| ファミリー単位の分割 | 同一出所の変種をまとめてから分割する | 個別サンプルのランダム分割は漏洩を招く可能性がある |
| 汚染に基づく層別評価 | 除外前後のスコアとサンプル数を示す | 未検出は非汚染の証明にならない |
再検証と実験の計画
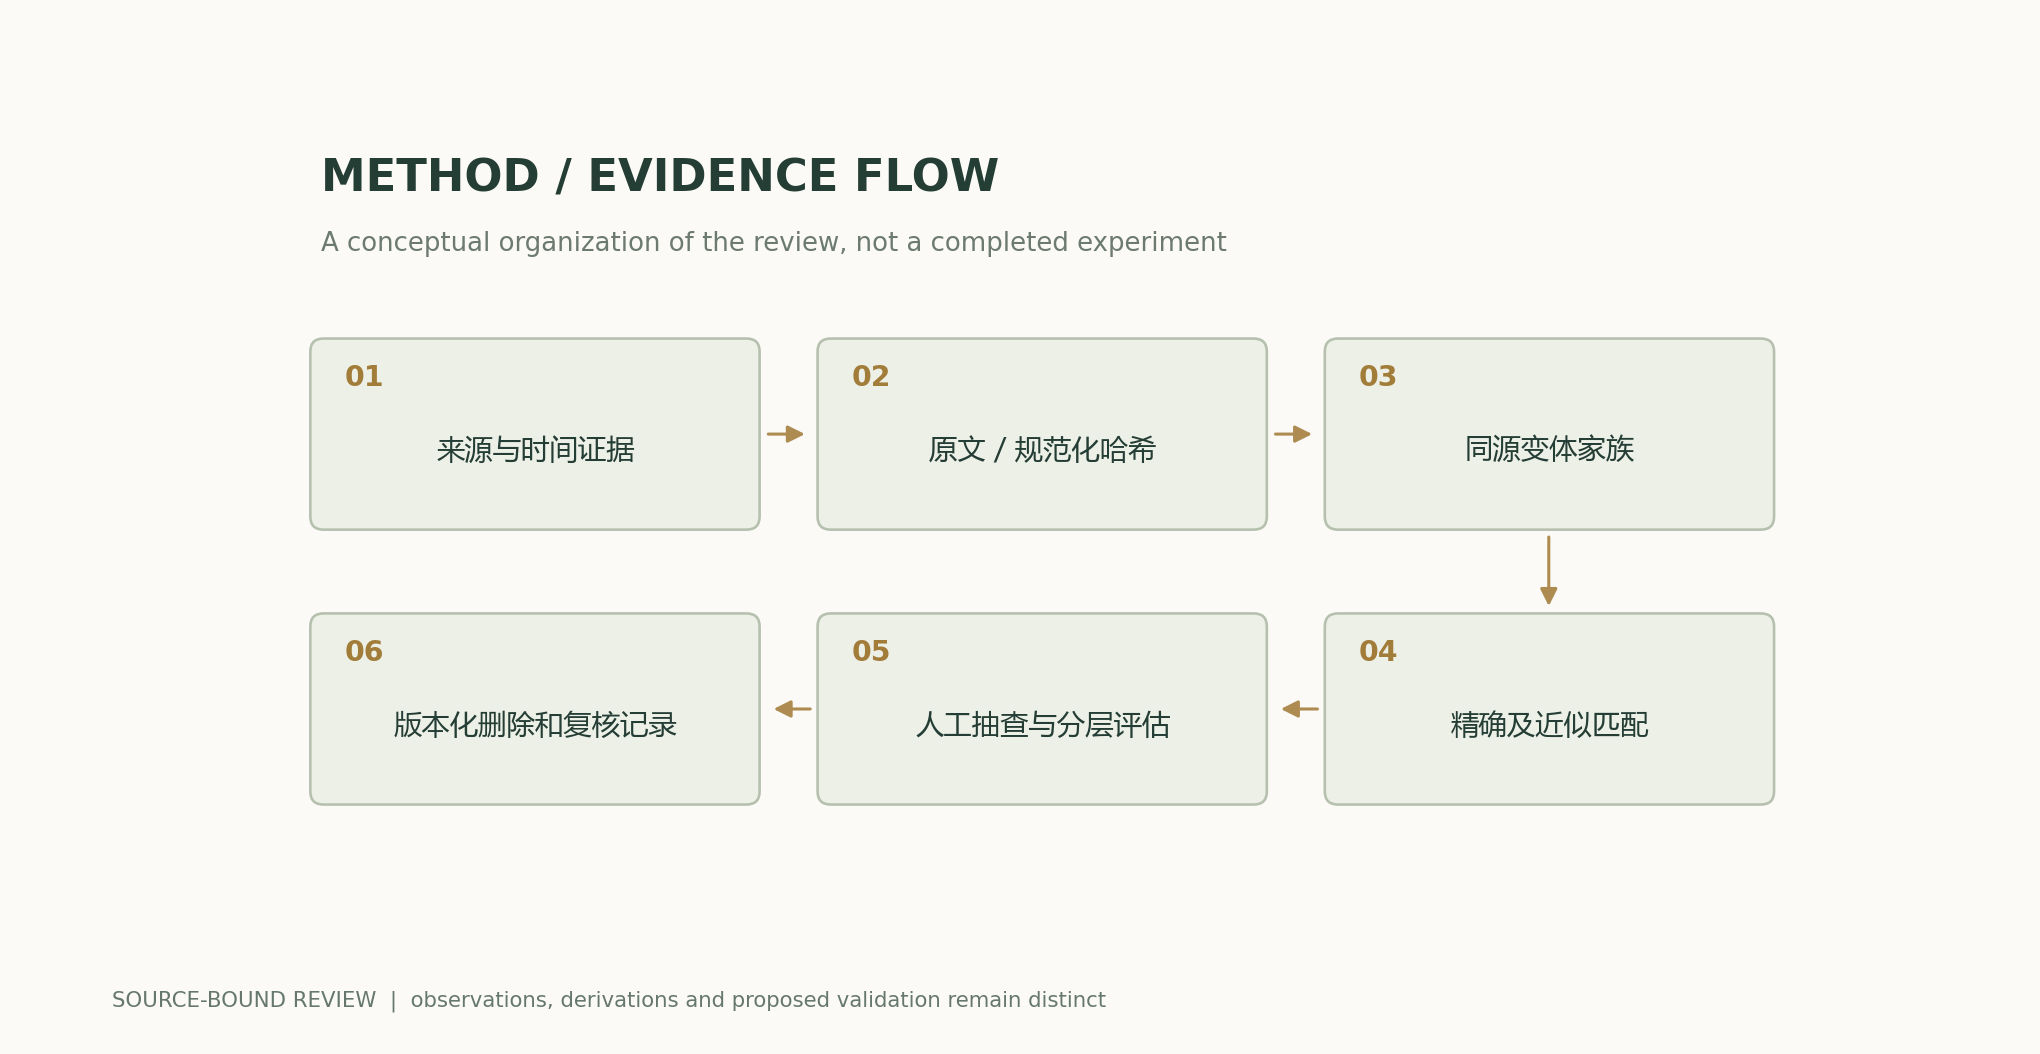
- 重複除去と汚染監査の異なる目的を定義し、検出単位と方針を固定する。
- 原文ハッシュ、出所の時期、正規化および検出器のバージョンを記録する。
- 文書/問題/生成ファミリー単位で先に分割し、その後に完全照合と近似照合を行う。
- 保持側と削除側の双方で層別抽出を行い、偽陽性、偽陰性、不確実性を推定する。
- 汚染の層別結果と除外前後の指標を報告し、独立した管理下のテストセットで再検証する。
- 必要最小限の監査メタデータを公開し、合法的な再検証経路を確保するとともに、私的資料の漏洩を避ける。
適用範囲と限界
- 混合図は実際の汚染率を推定しない。
- 類似性は解答漏洩を自動的に証明しない。
- 検出では誤削除と見逃しが同時に生じる可能性がある。
- 実際の私的内容の抽出は行っていない。
一次資料と主張の対応
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus, , , , , , , · 2021-04-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Holistic Evaluation of Language ModelsLiang et al. · 2022-11-16v2 abstract; seven dimensions and evaluation coverage
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、記載した一次文献に基づいて執筆し、解析的導出を行った。当サイトには、本稿の独立した査読または独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一の場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前バージョンの内容を維持している。
概念的な表紙と科学図は区別されている。科学図は公開された数式と明示された仮定から計算されており、原著論文の結果にはすべて帰属先を明記している。
著者、バージョン、訂正履歴 · /guides/data-dedup-contamination/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開・バージョン履歴
ソース改訂: 6251a250b27bb8b449f59b392f81abd355383770