
Resumen
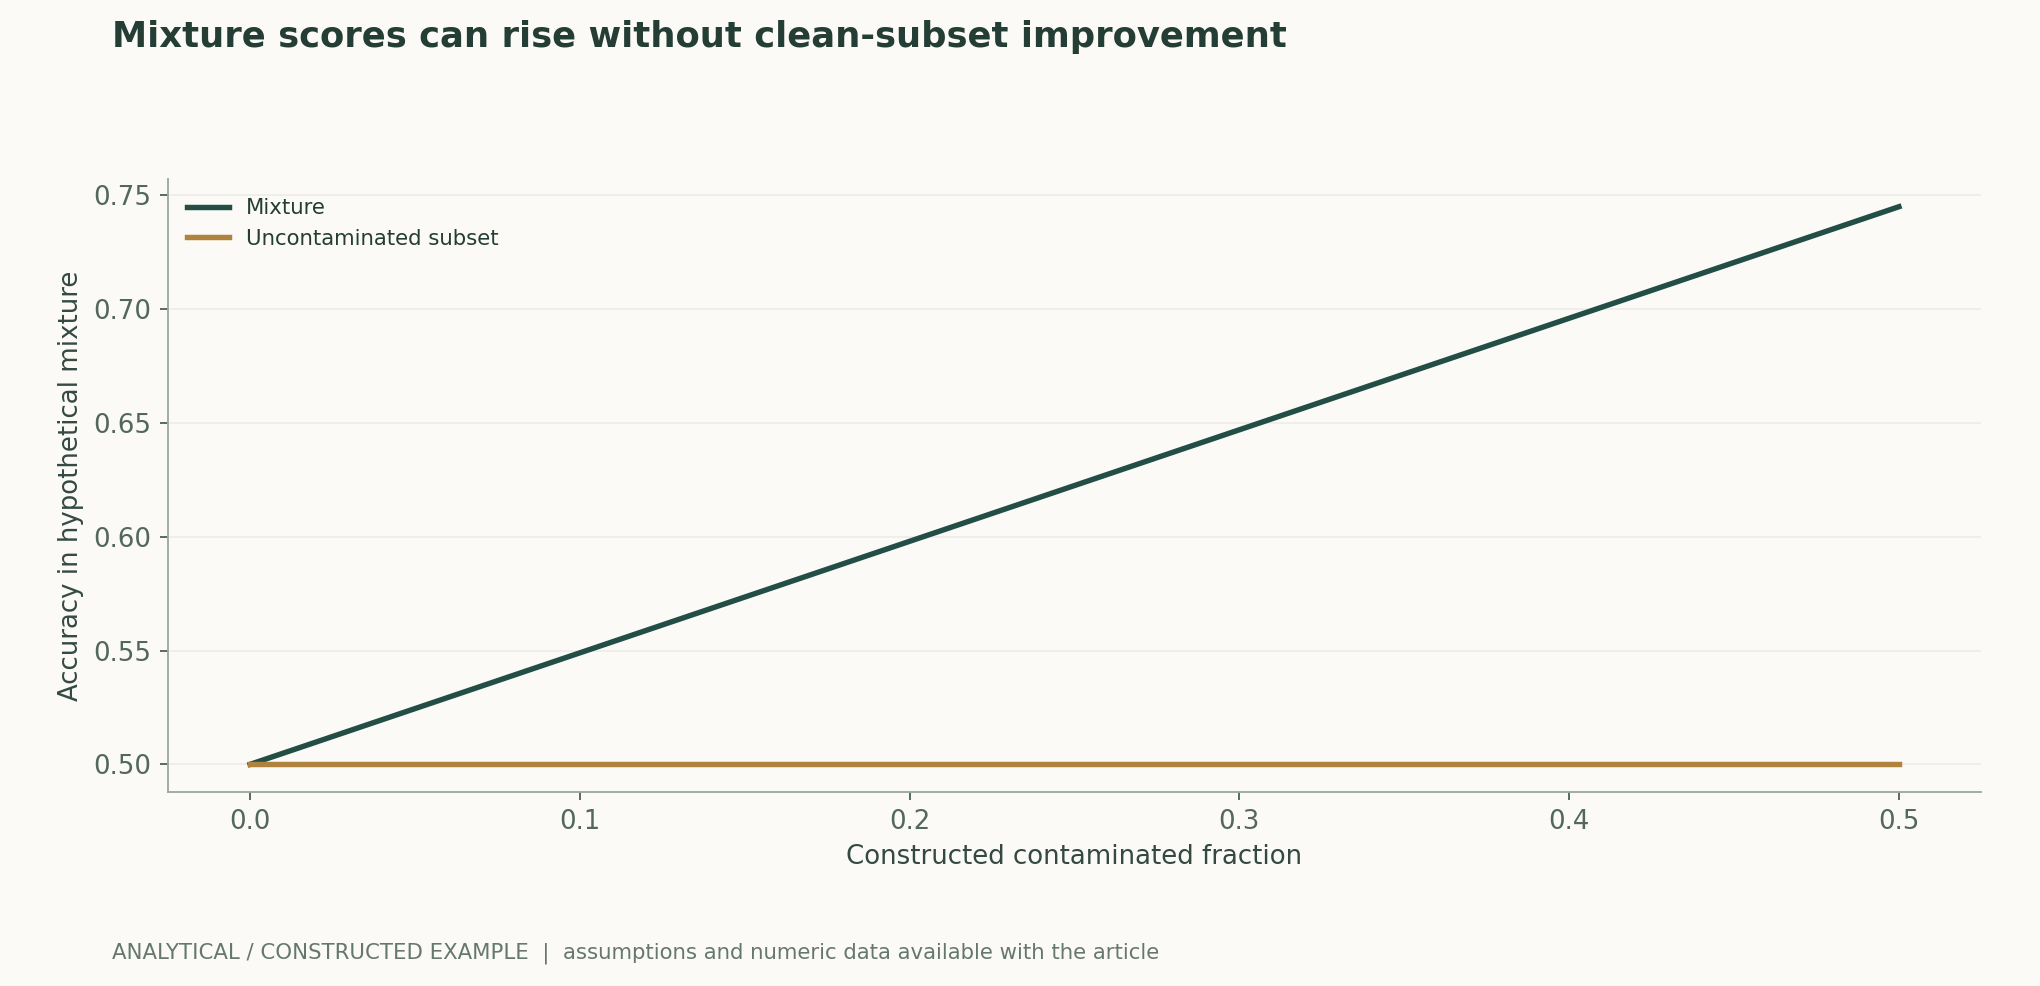
Las muestras de entrenamiento repetidas pueden modificar el comportamiento de memorización, mientras que la incorporación de contenido de prueba al entrenamiento puede distorsionar la evaluación de la generalización; sin embargo, son problemas distintos. Este artículo distingue entre duplicados exactos, familias de muestras casi duplicadas, solapamiento semántico y filtración de datos de evaluación, y propone un procedimiento que primero divide por familias de procedencia y después audita las coincidencias por similitud. El gráfico analítico únicamente muestra la mezcla de puntuaciones bajo proporciones de contaminación supuestas; no formula acusaciones sobre ningún modelo ni conjunto de datos real.[1] Deduplicating Training Data Makes Language Models Bette[2] Documenting Large Webtext Corpora: A Case Study on the [3] Holistic Evaluation of Language Models
Traducción del resumen original en inglés
La deduplicación y la contaminación de los bancos de pruebas son cuestiones de auditoría distintas. Analizamos las coincidencias exactas, las familias de muestras casi duplicadas, la memorización relacionada con la privacidad y la filtración de datos de evaluación. Un modelo de mezcla declarado ilustra cómo los elementos contaminados pueden inflar una puntuación sin mejorar la exactitud sobre los elementos no contaminados. La figura no constituye evidencia sobre ningún modelo o banco de pruebas existente.
1. Primero deben explicitarse los objetivos de deduplicación
Reducir el entrenamiento repetido, disminuir el riesgo de memorización de información privada y evitar la contaminación del conjunto de prueba pueden exigir definiciones distintas de duplicación. La aparición del mismo hecho público en varias fuentes no constituye necesariamente una trampa en la evaluación; en cambio, una ligera reformulación de la misma pregunta puede filtrar la respuesta. La investigación sobre deduplicación muestra los efectos de los datos repetidos en el entrenamiento y la evaluación, mientras que la investigación sobre extracción de datos de entrenamiento se centra en el riesgo de filtración por memorización. Al diseñar una auditoría deben especificarse el objeto de protección y la unidad de juicio, evitando sustituir todas las políticas por un único umbral de similitud.[1] Deduplicating Training Data Makes Language Models Bette[2] Documenting Large Webtext Corpora: A Case Study on the
2. La coincidencia exacta es fiable, pero su cobertura es limitada
El cálculo de hashes tras la normalización permite identificar eficientemente textos idénticos, pero los espacios en blanco, el formato, la traducción y la paráfrasis modifican los bytes. A su vez, una normalización excesiva puede fusionar códigos o problemas matemáticos que en realidad son diferentes. Deben conservarse los hashes del texto original, las reglas de normalización y las ubicaciones de las coincidencias para que cada eliminación sea trazable. La coincidencia aproximada puede ampliar la cobertura, pero deben estimarse los falsos positivos y los falsos negativos, especialmente en preguntas con la misma plantilla pero instancias distintas; no basta con mostrar unos pocos duplicados detectados con éxito.[1] Deduplicating Training Data Makes Language Models Bette
3. Dividir por familias es más importante que dividir aleatoriamente las muestras individuales
Las paráfrasis, traducciones y explicaciones de un mismo documento, pregunta o experimento original deben tratarse como una familia relacionada. Si primero se dividen aleatoriamente las muestras individuales y después se eliminan los duplicados exactos, las variantes pueden haberse distribuido ya entre entrenamiento y prueba. Antes de dividir, deben establecerse las relaciones de procedencia o generación y asignarse cada grupo completo al mismo lado. Cuando no pueda determinarse la familia, deben mantenerse las marcas de incertidumbre y la revisión humana, en lugar de calificar directamente como no contaminadas las muestras que el detector no identifica. Los índices de los sistemas aumentados por recuperación también son fuentes de datos que requieren auditoría.[1] Deduplicating Training Data Makes Language Models Bette[3] Holistic Evaluation of Language Models
4. Las puntuaciones de mezcla ocultan la capacidad sobre muestras no contaminadas
Sea c la proporción de muestras contaminadas, a1 su exactitud y a0 la exactitud de las demás muestras; la puntuación total es su media ponderada. Aunque a0 permanezca completamente invariable, un aumento de c puede elevar la puntuación total. La figura de este artículo fija a0=0.5 y a1=0.99 para mostrar esta identidad; no estima ninguna tasa real de contaminación. Una auditoría real debe estratificar por intensidad de la coincidencia y cronología de las fuentes, informar por separado de las puntuaciones y los tamaños muestrales antes y después de la exclusión, y reconocer que la detección es incompleta.[3] Holistic Evaluation of Language Models[1] Deduplicating Training Data Makes Language Models Bette
5. La memorización de información privada y la filtración de respuestas requieren pruebas diferentes
Que un modelo pueda reproducir fragmentos de entrenamiento no demuestra automáticamente que una determinada puntuación en un banco de pruebas se deba a la contaminación; que las preguntas de prueba aparezcan en el entrenamiento tampoco significa que necesariamente contengan información personal privada. Lo primero requiere extracción controlada y evaluación de la privacidad; lo segundo exige evidencias sobre cronología, procedencia y relación con las respuestas. Este artículo no realiza ninguna extracción de datos personales reales. Los informes de investigación deben divulgar únicamente los metadatos mínimos necesarios de las coincidencias y los fragmentos que puedan mostrarse legalmente, evitando volver a difundir material sensible para demostrar el riesgo.[2] Documenting Large Webtext Corpora: A Case Study on the [1] Deduplicating Training Data Makes Language Models Bette
6. Una auditoría fiable debe permitir revisar las decisiones de eliminación
Deben conservarse las versiones del detector, los umbrales, las familias coincidentes, las conclusiones de la revisión y los motivos de eliminación, e inspeccionarse muestras tanto del grupo conservado como del eliminado. La evaluación también debe utilizar muestras independientes más recientes, de procedencia controlada o privadas pero autorizadas legalmente, manteniendo fijo el protocolo de evaluación. HELM destaca la evaluación multidimensional y la transparencia; en consecuencia, en esta tarea deben comunicarse tanto las limitaciones de la detección de contaminación como las diferencias entre métricas. La ausencia de coincidencias detectadas no demuestra la ausencia de solapamiento, y una única puntuación global no puede sustituir una auditoría de contaminación.[3] Holistic Evaluation of Language Models[1] Deduplicating Training Data Makes Language Models Bette
Ecuaciones fundamentales y derivaciones
(1) Identidad de ponderación estratificada; tanto A0=0.5 como A1=0.99 en la figura son supuestos, no mediciones de un modelo.
LaTeX
A_{\mathrm{mix}}=(1-c)A_0+cA_1(2) Representa la diferencia entre la puntuación de mezcla y A0 únicamente cuando se cumplen las definiciones de los estratos indicadas; no permite deducir la tasa real de contaminación a partir de esa diferencia.
LaTeX
\Delta A=c(A_1-A_0)(3) El detector de coincidencias debe estimar los falsos positivos y los falsos negativos mediante muestras anotadas por humanos o introducidas de forma controlada, y explicar el método de muestreo.
LaTeX
\mathrm{precision}=\frac{TP}{TP+FP},\qquad\mathrm{recall}=\frac{TP}{TP+FN}Flujo de métodos y evidencias
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto cuyo cálculo puede reproducirse
Supóngase una exactitud de 0.99 en la parte contaminada y de 0.50 en el resto. Cuando la contaminación representa 20%, la puntuación total es 0.598, mientras que la capacidad sobre las muestras no contaminadas sigue siendo 0.50. Se trata únicamente de una identidad ponderada, que no permite deducir la tasa real de contaminación a partir de la puntuación total.
Comparación de métodos
| Método o juicio | Variables controladas y medición | Condiciones de fallo e interpretación |
|---|---|---|
| Duplicados exactos | Conservar las reglas de normalización y los hashes | No detecta traducciones ni paráfrasis |
| Coincidencia aproximada | Comprobar la precisión y la exhaustividad mediante muestreo estratificado | La similitud de plantillas puede provocar eliminaciones erróneas |
| División por familias | Agrupar las variantes de origen común antes de dividir | La división aleatoria de muestras individuales puede causar filtraciones |
| Evaluación estratificada por contaminación | Indicar las puntuaciones y los tamaños muestrales antes y después de la exclusión | La ausencia de coincidencias detectadas no demuestra la ausencia de contaminación |
Plan de revisión y experimentación
- Definir los distintos objetivos de la deduplicación y de la auditoría de contaminación, y fijar la unidad de detección y las políticas.
- Registrar los hashes del texto original, la cronología de las fuentes y las versiones de la normalización y del detector.
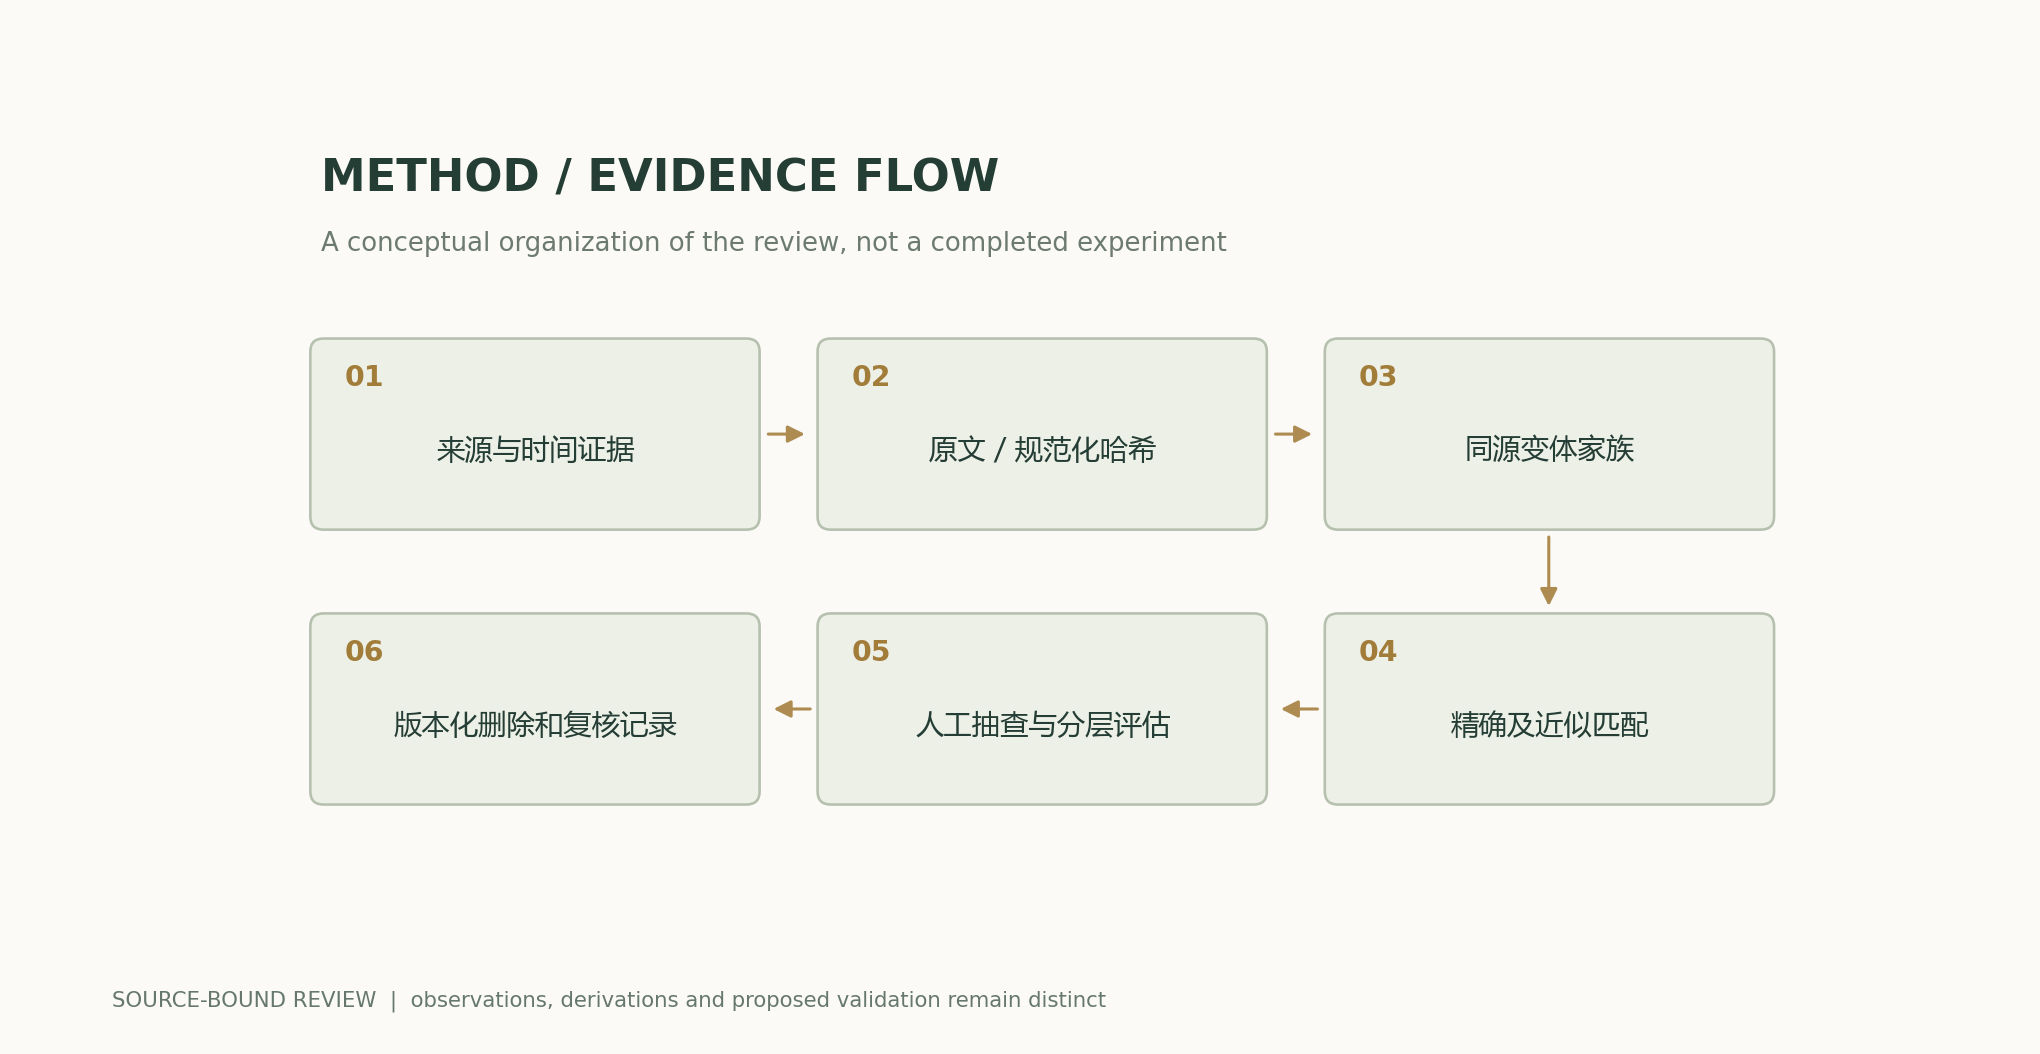
- Dividir primero por familias de documentos, preguntas o generación, y después realizar las coincidencias exactas y aproximadas.
- Aplicar muestreo estratificado tanto al grupo conservado como al eliminado para estimar falsos positivos, falsos negativos e incertidumbre.
- Informar de los estratos de contaminación y de las métricas antes y después de la exclusión, y verificar con un conjunto de prueba independiente y controlado.
- Publicar los metadatos mínimos necesarios de auditoría, mantener una vía legal de revisión y evitar la divulgación de material privado.
Ámbito de aplicación y limitaciones
- El gráfico de mezcla no estima la tasa real de contaminación.
- La similitud no demuestra automáticamente la filtración de respuestas.
- La detección puede producir tanto eliminaciones erróneas como omisiones.
- No se realizó ninguna extracción de contenido privado real.
Correspondencia entre fuentes primarias y afirmaciones
- Deduplicating Training Data Makes Language Models Better, , , , , , · 2021-07-14Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus, , , , , , , · 2021-04-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Holistic Evaluation of Language ModelsLiang et al. · 2022-11-16v2 abstract; seven dimensions and evaluation coverage
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autoría, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas basándose en la bibliografía primaria enumerada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y coincide el ETag. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se presenta por separado de las figuras científicas; estas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales incluyen su atribución.
Historial de autoría, versiones y correcciones · /guides/data-dedup-contamination/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770