
Resumen
El diseño generativo de proteínas está pasando de «predecir una estructura a partir de una secuencia dada» a «proponer secuencias y estructuras a partir de restricciones dadas». Sin embargo, el éxito del diseño debe atravesar varias etapas distintas: el esqueleto satisface las restricciones, la secuencia es compatible con el esqueleto, se puede obtener la muestra, la conformación es correcta y la función es medible. Este artículo, centrado en RFdiffusion y ProteinMPNN, establece un marco de evaluación basado en probabilidades condicionales y registros completos de descartes. Derivamos el embudo de diseño, la correlación entre candidatos y cotas superiores estadísticas para ensayos sin fallos, y mostramos que no existe una equivalencia automática entre predicciones autoconsistentes, recuperación de secuencias y función real. Las figuras computacionales del artículo son análisis presupuestarios, no nuevos diseños de proteínas ni resultados experimentales realizados por este sitio.[1] De novo design of protein structure and function with R[2] Robust deep learning–based protein sequence design usin
Traducción del resumen original en inglés
El diseño de proteínas es un problema inverso cuyo éxito requiere una cadena que va desde la generación geométrica hasta la compatibilidad de secuencia, la expresión y la función medida. Presentamos una síntesis de RFdiffusion y ProteinMPNN, distinguiendo la autoconsistencia de la validación independiente. Un embudo condicional y un cálculo de una biblioteca correlacionada muestran por qué un gran número de candidatos generados no equivale a muchas oportunidades experimentales independientes. Proponemos una evaluación prospectiva con presupuestos equiparados, contabilización completa de los descartes y criterios de valoración funcionales ortogonales.
1. Un problema inverso no tiene una única respuesta correcta
Las restricciones funcionales de una proteína suelen admitir muchas secuencias y conformaciones. La tarea del diseño inverso no consiste en recuperar una secuencia natural, sino en buscar, dentro del conjunto factible, candidatos capaces de alcanzar el objetivo. RFdiffusion utiliza la eliminación de ruido del esqueleto en diversas condiciones de diseño; ProteinMPNN genera secuencias condicionadas a un esqueleto dado. Ambos resuelven problemas adyacentes, pero diferentes. Por ello, una probabilidad o puntuación de una etapa no puede interpretarse como la tasa de éxito de toda la cadena de diseño. Este artículo recomienda expresar primero el objetivo mediante criterios de valoración medibles y errores admisibles, y distinguir después los motivos que deben conservarse, las regiones variables y los criterios de cribado posteriores, para evitar que, tras la generación, la tarea se reformule retrospectivamente en función de aquello que los candidatos hacen bien por casualidad.[1] De novo design of protein structure and function with R[2] Robust deep learning–based protein sequence design usin
2. Los modelos generativos aprenden distribuciones y condiciones, no teoremas físicos
RFdiffusion adapta una red de predicción estructural a una tarea de eliminación de ruido y demuestra capacidades de diseño que incluyen proteínas de unión y ensamblajes simétricos. Su mecanismo de condicionamiento permite incorporar restricciones geométricas locales al proceso de generación, pero el modelo sigue limitado por las estructuras de entrenamiento y la configuración de la tarea. Satisfacer las restricciones no garantiza las propiedades del paisaje energético, la cinética de plegamiento ni el comportamiento en disolución. La cuestión metodológica clave es la intensidad de las restricciones: si son demasiado débiles, los candidatos pueden alejarse de la geometría funcional; si son demasiado fuertes, puede quedar solo una familia muy estrecha de diseños similares entre sí. La evaluación debe mostrar tanto los errores respecto de las restricciones como el número de familias de diseño, en lugar de exhibir únicamente la conformación individual más refinada.[1] De novo design of protein structure and function with R
3. La recuperación de secuencias explica parte de la consistencia del modelo
ProteinMPNN comunicó una recuperación de secuencias relativamente elevada en las pruebas con esqueletos nativos del artículo original y evaluó los diseños mediante diversos experimentos estructurales y de ensamblaje. La recuperación de la secuencia nativa permite medir parte de la capacidad de modelado condicional, pero no constituye una condición suficiente para lograr una función nueva: muchas secuencias diferentes pueden formar esqueletos similares, mientras que un cambio en un único sitio clave puede afectar al plegamiento o a la actividad. La evaluación del diseño debe conservar conjuntamente el esqueleto, la distribución condicional de secuencias y los sitios preservados. Si se utiliza un predictor estructural como filtro, también debe registrarse la relación entre el entrenamiento del predictor y el del generador, para evitar considerar como apoyo independiente una concordancia derivada del mismo sesgo.[2] Robust deep learning–based protein sequence design usin[1] De novo design of protein structure and function with R
4. Derivación de este artículo: el denominador del embudo de éxito debe comenzar en la generación
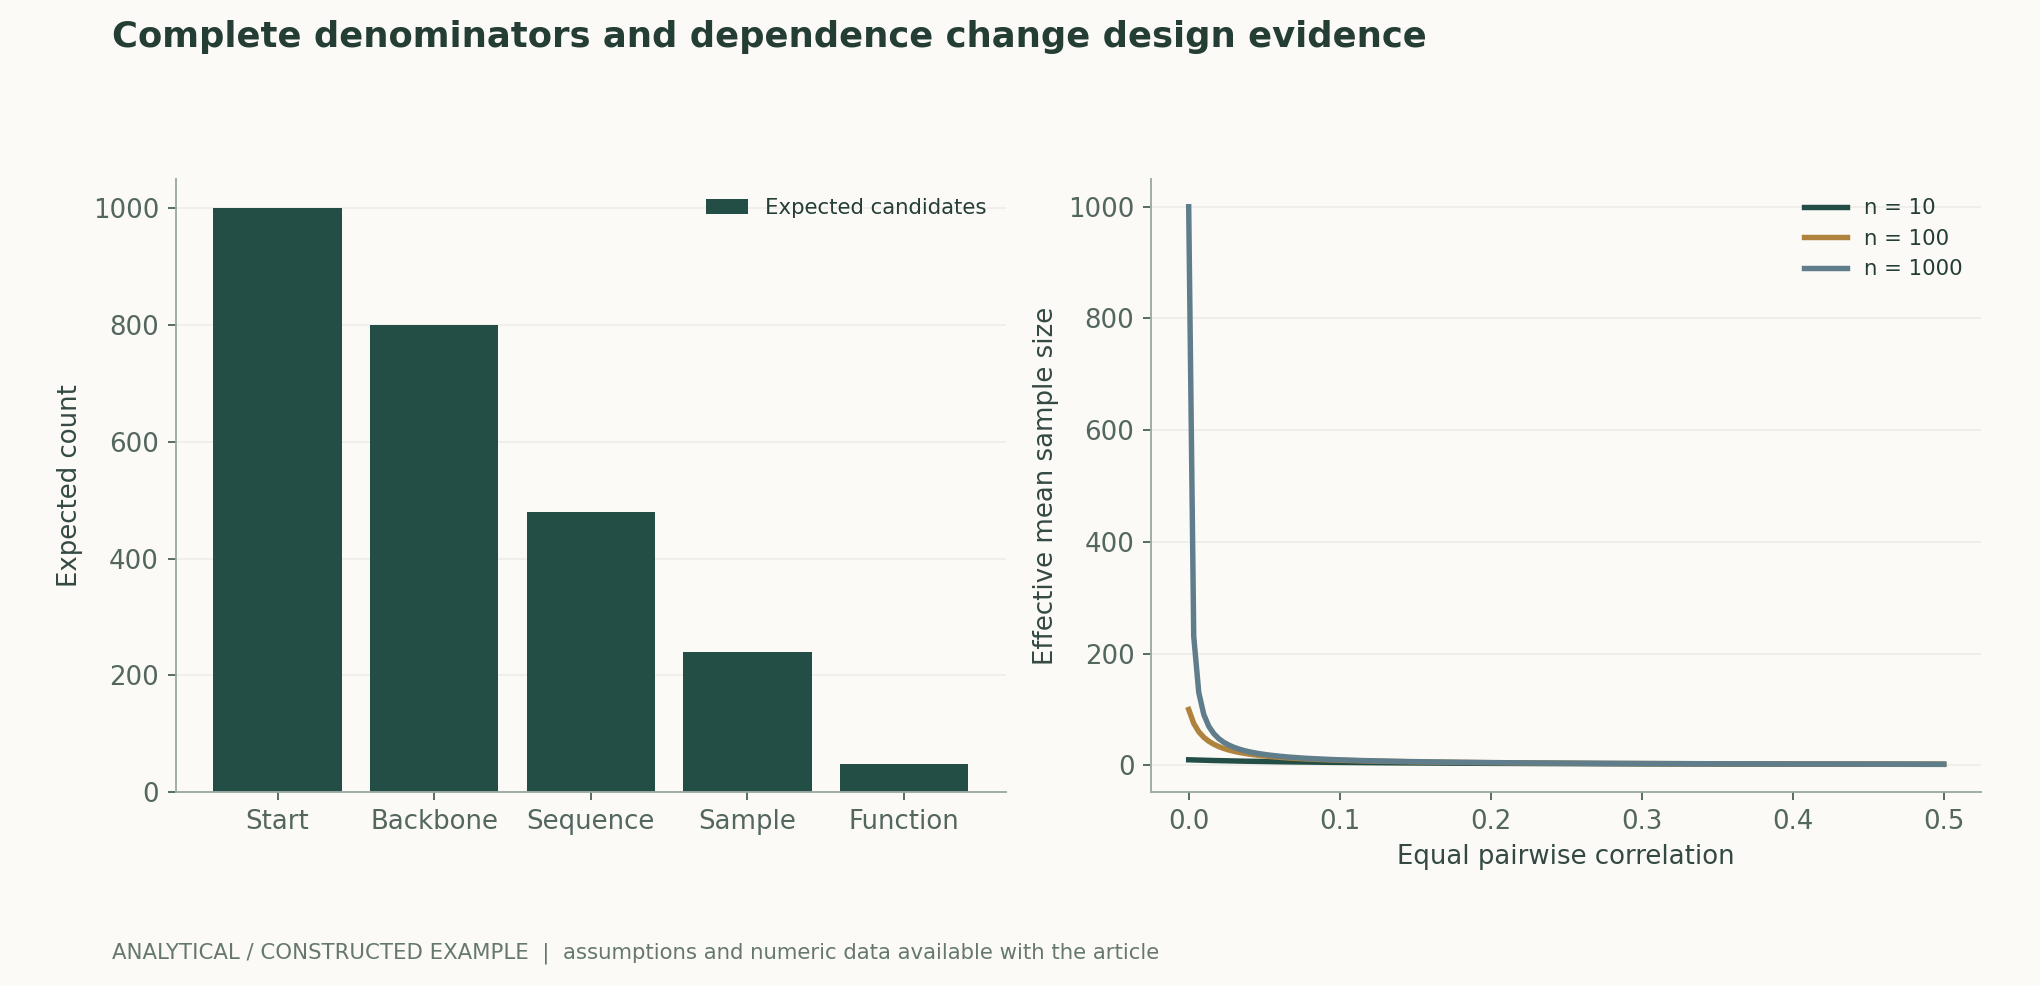
Supongamos cuatro etapas sucesivas: aceptación del esqueleto, aceptación de la secuencia, disponibilidad de la muestra y aceptación funcional, con la probabilidad de cada paso condicionada a superar los anteriores. La tasa de éxito de toda la cadena es el producto de estas probabilidades condicionales y no requiere suponer adicionalmente independencia marginal entre etapas. En el ejemplo construido se toman, sucesivamente, 0.8, 0.6, 0.5 y 0.2, de modo que 1000 candidatos iniciales corresponden a un número esperado de 48 aciertos funcionales. Si solo se cuenta entre las 240 muestras finales, se comunicará 20%, que responde a una pregunta distinta de 4.8%, calculado sobre los candidatos iniciales. La figura presenta ambos denominadores en paralelo para ayudar a distinguir la eficiencia del cribado del rendimiento de principio a fin.作者分析与复核建议 / Author analysis
5. Análisis de este artículo: el número de archivos no puede sustituir a la diversidad de secuencias
Si un conjunto de candidatos comparte el mismo esqueleto, patrón de contactos y rasgos principales de secuencia, sus éxitos y fracasos pueden estar muy correlacionados. Este artículo utiliza el tamaño muestral efectivo para estimar una media con correlaciones iguales como advertencia presupuestaria: bajo una condición construida con coeficiente de correlación 0.2, 100 candidatos contribuyen a la precisión de la media solo tanto como aproximadamente 4.81 muestras independientes. Esta fórmula no describe con exactitud el éxito o fracaso binario del diseño ni equipara directamente la similitud entre familias con el coeficiente de correlación; indica que se debe agrupar conjuntamente por esqueleto, secuencia e interfaz y comunicar tasas de éxito entre familias. La diversidad debe incorporarse al objetivo de selección de candidatos, y no quedar como un mero adjetivo adicional al presentar los resultados.作者分析与复核建议 / Author analysis
6. Cómo utilizar el filtrado estructural por autoconsistencia
Tras la generación, utilizar un predictor estructural para comprobar si la secuencia vuelve al esqueleto objetivo es un paso de filtrado valioso y de bajo coste; los trabajos relacionados con RFdiffusion y ProteinMPNN combinan el cribado computacional con la caracterización experimental. Su limitación radica en que el predictor puede compartir preferencias estructurales con el generador y pasar por alto ciertos estados desordenados, agregados u oligoméricos incorrectos. Por ello, este artículo propone etiquetar la autoconsistencia como un campo de evidencia computacional y registrar por separado la evidencia estructural y funcional externa. Tras miles de rondas de optimización frente al mismo filtro, debe comprobarse la transferencia más allá de los candidatos sujetos a las reglas de cribado congeladas; las puntuaciones altas tras la adaptación mediante entrenamiento no pueden tratarse como descubrimientos completamente nuevos.[1] De novo design of protein structure and function with R[2] Robust deep learning–based protein sequence design usin[3] Accurate structure prediction of biomolecular interacti
7. Derivación de este artículo: siguen siendo necesarios intervalos aunque no se observen fallos
Bajo el supuesto de ensayos independientes e idénticamente distribuidos, si no se observa ningún fallo de un tipo dado en n ensayos, la cota superior unilateral del 95% es 1−0.05^(1/n). Con n=30, la cota superior sigue siendo aproximadamente 9.50%, y con n=300, aproximadamente 0.994%. Por tanto, «todos superaron la prueba» debe acompañarse del tamaño muestral, la independencia y la definición del criterio de valoración. La correlación entre miembros de una familia en las bibliotecas de diseño debilita aún más el supuesto de independencia. Recomendamos comunicar los resultados por lote experimental y familia de diseño, conservar los fallos de expresión, las muestras impuras y los casos no medibles, y evitar declarar ausencia de fallos después de eliminarlos. Esta derivación trata únicamente la base del cómputo estadístico; no estima la tasa de fallo de ningún modelo publicado.作者分析与复核建议 / Author analysis
8. Los aciertos estructurales y funcionales requieren controles diferentes
Una proteína diseñada puede adoptar la forma prevista y carecer de la función deseada, o presentar varias conformaciones y aun así mostrar una determinada función. Para comprender las causas del éxito del diseño, deben establecerse controles que pongan a prueba por separado la geometría y el mecanismo, por ejemplo, comparando candidatos que conservan el esqueleto pero modifican condiciones locales clave, y registrando de forma independiente el estado de la muestra. Los estudios concretos también deben examinar la selectividad respecto de otras dianas y la reproducibilidad entre lotes. Este artículo presenta estos puntos como requisitos de diseño de investigación, no como resultados de experimentos no realizados. Solo cuando los controles permiten distinguir entre «el modelo generó por casualidad una proteína estable» y «el modelo cumplió la función especificada» puede la narración del diseño convertirse en una explicación científica fiable.作者分析与复核建议 / Author analysis
9. Una evaluación más rigurosa con presupuestos equiparados
Proponemos asignar a las distintas cadenas de trabajo el mismo presupuesto de generación y el mismo presupuesto de validación posterior, fijando de antemano el conjunto de objetivos, el número de ajustes permitidos y las reglas de parada. El criterio principal de valoración es el número de familias funcionales independientes obtenidas por unidad de presupuesto experimental, complementado por la tasa de éxito calculada a partir de todos los candidatos iniciales. La comparación debe incluir una referencia simple y ablaciones con cambios solo del esqueleto, solo de la secuencia y con el circuito cerrado completo, registrando jerárquicamente las causas de fallo. Si un método mejora la tasa de aciertos en la fase final, pero aumenta sustancialmente los costes de cribado iniciales, la conclusión debe presentar conjuntamente costes y resultados, sin proclamar una superioridad general basándose solo en una proporción elevada entre muestras seleccionadas.作者分析与复核建议 / Author analysis
Suplemento técnico A · Simetrías de coordenadas en la eliminación de ruido estructural
La rotación y la traslación globales de las coordenadas del esqueleto proteico no cambian su identidad física, por lo que la generación debe tratar adecuadamente estas simetrías. Vincular el ruido de coordenadas, los marcos locales y los motivos de condicionamiento permite al modelo explorar distintos esqueletos bajo restricciones geométricas; sin embargo, fijar determinadas posiciones también modifica el conjunto factible. Este artículo recomienda aplicar transformaciones de cuerpo rígido a una misma entrada, comprobar si las distribuciones de salida mantienen la relación correspondiente tras la transformación inversa y separar el error del motivo, la geometría de los enlaces y el plegamiento global. Esta prueba valida la implementación y la representación; no sustituye las mediciones externas de si una proteína se expresa, es soluble o tiene función.[1] De novo design of protein structure and function with R
Suplemento técnico B · Orden de decodificación de las probabilidades condicionales de secuencia
Dado un esqueleto, la distribución de secuencias puede factorizarse en un producto de probabilidades condicionales siguiendo distintos órdenes de posiciones. Con decodificación autorregresiva, las posiciones ya elegidas afectan a los candidatos posteriores; la temperatura y el muestreo repetido cambian la forma de explorar, pero no modifican automáticamente la distribución experimental final. En ensamblajes simétricos pueden vincularse posiciones equivalentes, lo que reduce los grados de libertad y modifica la diversidad efectiva. Este artículo recomienda registrar conjuntamente el orden de decodificación, los residuos fijos, los vínculos por simetría, la temperatura y las semillas, y eliminar duplicados según las secuencias finales y las familias estructurales. Publicar únicamente una probabilidad media de secuencia no permite explicar las correlaciones ni las diferencias funcionales entre candidatos.[2] Robust deep learning–based protein sequence design usin
Suplemento técnico C · El valor de la información importa más que continuar el muestreo
Si repetidamente no se pueden obtener muestras de una familia de diseño, continuar muestreando esa familia puede limitarse a añadir fallos similares. Este artículo propone que la siguiente medición se dirija a mecanismos de fallo aún no discriminados: por ejemplo, determinar primero si la limitación reside en la estabilidad del esqueleto, el estado de la muestra o la geometría funcional, y decidir después qué etapa modificar. Esta idea puede formularse como ganancia condicional de información, en lugar de seleccionar simplemente la puntuación más alta del modelo. La evaluación debe registrar cómo las mediciones modifican la distribución de candidatos posteriores y comparar el muestreo puro con las estrategias de retroalimentación según objetivos prerregistrados. Sin experimentos reales de retroalimentación, solo puede proponerse un diseño; no debe afirmarse que el aprendizaje activo ha mejorado los aciertos reales.作者分析与复核建议 / Author analysis
Suplemento técnico D · Del éxito dentro de una familia a la transferencia entre dianas
Obtener varios candidatos exitosos similares para una diana demuestra que existen soluciones factibles en ese espacio local de diseño; la transferencia a nuevas dianas exige mantener la eficacia con superficies, geometrías y condiciones de medición diferentes. Este artículo recomienda organizar los datos con las dianas en el nivel externo, las familias de diseño en el intermedio y los candidatos en el interno, comunicando por separado la variación de los tres niveles. Si hay muy pocas dianas, no puede utilizarse el número total de candidatos para proporcionar intervalos extremadamente estrechos entre dianas. La equiparación presupuestaria también debe realizarse al nivel de las dianas, para evitar que un método invierta más únicamente en las fáciles. Así puede distinguirse con claridad la capacidad de la plataforma de diseño de la optimización detallada de un caso de éxito individual.作者分析与复核建议 / Author analysis
10. ¿Qué deben entregar los resultados de diseño verificables?
El paquete público más valioso no se limita a ofrecer la mejor estructura, sino que conecta las especificaciones del objetivo, las condiciones de generación, las familias de candidatos, el registro de cribado, las identidades de las muestras y los criterios de valoración funcionales. Las ecuaciones y figuras de este artículo expresan la eficiencia del diseño mediante relaciones verificables entre denominadores; los resultados experimentales de los artículos originales siguen correspondiendo a sus equipos originales. Las reproducciones posteriores deben conservar las diferencias respecto de las configuraciones originales y permitir asociar resultados negativos a candidatos y versiones precisos. De este modo, una plataforma de diseño puede pasar de ejemplos de éxito repetidos a un sistema científico y de ingeniería que acumule conocimiento: el lector sabe qué se ha medido y qué pregunta debe responder el siguiente experimento más informativo.作者分析与复核建议 / Author analysis
Ecuaciones fundamentales y derivaciones
(1) Factorización de la cadena de trabajo para el esqueleto x, la secuencia s y las restricciones c; es una forma de organizar el modelado, no una garantía de validez física o funcional.
LaTeX
p(x,s\mid c)=p_\theta(x\mid c)\,p_\phi(s\mid x,c)(2) Cadena condicional de cuatro etapas, correspondientes a la aceptación del esqueleto, la secuencia, la muestra y la función; no requiere independencia marginal.
LaTeX
P(F)=P(B)P(S\mid B)P(E\mid S,B)P(F\mid E,S,B)(3) Tamaño muestral efectivo de una media con varianzas y correlaciones iguales, utilizado como advertencia analítica para bibliotecas de diseño correlacionadas, no como ajuste a éxitos y fracasos reales.
LaTeX
n_{\mathrm{eff}}=\frac{n}{1+(n-1)\rho}(4) Cota superior exacta unilateral del 95% para ausencia de fallos en n ensayos independientes e idénticamente distribuidos; no puede aplicarse directamente a muestras correlacionadas.
LaTeX
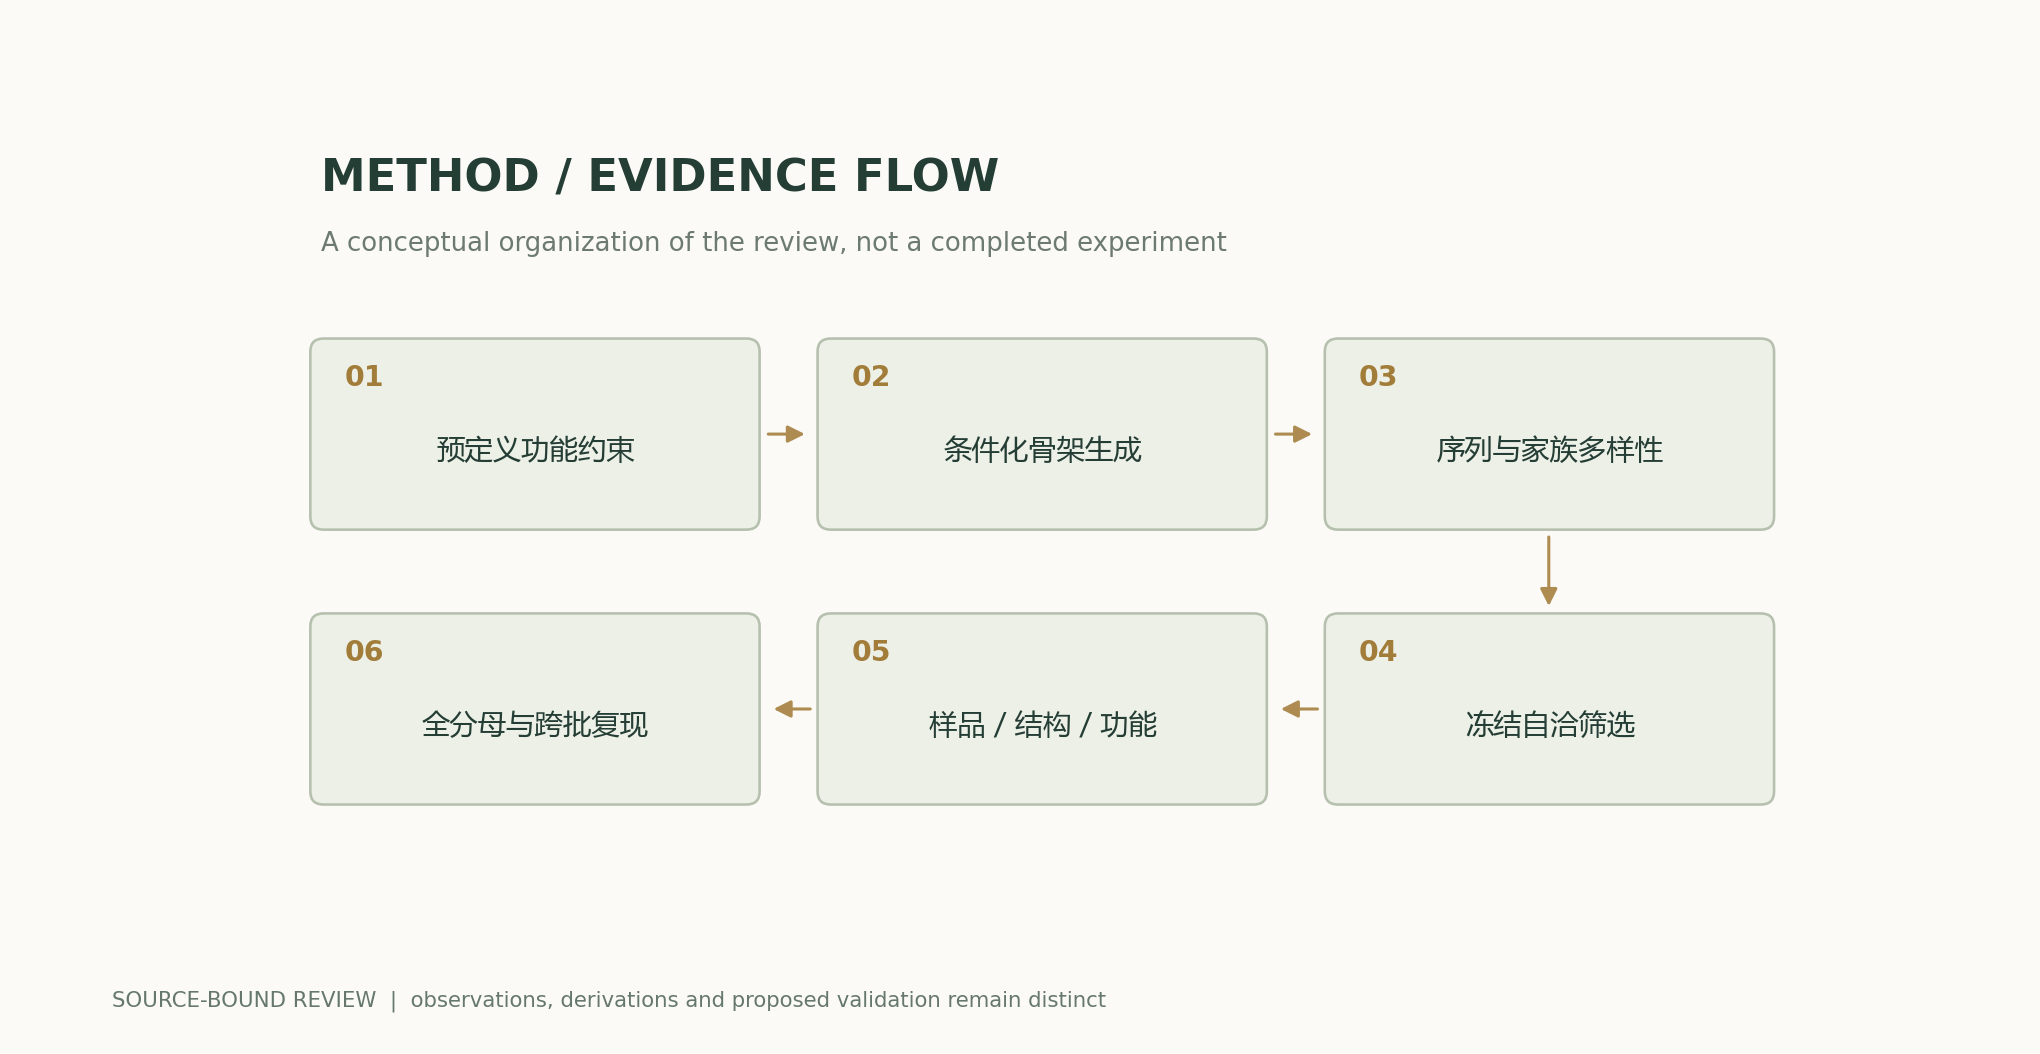
p_{\mathrm{failure,upper}}=1-0.05^{1/n}Flujo de métodos y evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto cuyo cálculo puede reproducirse
1000×0.8×0.6×0.5×0.2=48, con 4.8% respecto del denominador inicial y 20% respecto de las muestras finales; 100 muestras con igual correlación, cuando rho=0.2, tienen un tamaño muestral efectivo de aproximadamente 4.80769.
Comparación de métodos
| Etapa de entrega | Evidencia medible | Fallos y denominadores que deben conservarse |
|---|---|---|
| Esqueleto restringido | Error geométrico y factibilidad | Todos los esqueletos generados y los no válidos |
| Secuencia condicional | Posiciones fijas y distribución de secuencias | Candidatos correspondientes a todos los esqueletos |
| Predicción autoconsistente | Retorno a la estructura objetivo y puntuación de la interfaz | Versión del predictor y descartes del cribado |
| Obtención de muestras | Expresión, pureza e identidad | Casos no obtenibles y no medibles |
| Acierto funcional | Criterios de valoración y controles predefinidos | Todas las muestras enviadas a ensayo y las familias independientes |
| Generalización y coste | Nuevas dianas, evaluación entre lotes y presupuesto | Número de ajustes, intervención humana y tiempo empleado |
Plan de verificación y experimentación
- Prerregistrar los objetivos, los cambios geométricos permitidos, los criterios principales de valoración funcional y el límite superior del cribado de candidatos.
- Fijar el modelo y la configuración de generación condicional, y entregar esqueletos, secuencias, semillas y resúmenes.
- Agrupar los candidatos por secuencia, esqueleto y geometría de contacto, registrando todos los miembros de cada familia.
- Equiparar los presupuestos de generación y validación independiente entre métodos y conservar una referencia simple.
- Congelar el filtro de autoconsistencia y sus umbrales, y registrar el motivo de descarte en cada paso.
- Incluir en los denominadores correspondientes tanto las muestras no obtenibles como las no medibles, sin eliminarlas de forma silenciosa.
- Confirmar por separado los criterios de valoración estructurales y funcionales, y presentar intervalos por lote y familia.
- Publicar los fallos y las diferencias de reproducción; registrar las validaciones incompletas solo como planes, sin contarlas como logros de diseño funcional.
Ámbito de aplicación y limitaciones
- No se ejecutaron modelos ni se prepararon proteínas nuevas.
- Las probabilidades del embudo son entradas construidas y no representan la tasa de aciertos de RFdiffusion.
- La fórmula del tamaño muestral efectivo se aplica al análisis de medias con correlaciones iguales; no es una ley de similitud de secuencias.
- La cota superior con ausencia de fallos requiere independencia, distribución idéntica y un criterio de valoración fijo.
- La estructura, la expresión y la función siguen estando limitadas por el sistema concreto y las condiciones de medición.
Evidencia de los estudios originales y su ámbito de aplicación
| Resultados de los estudios originales | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| Demuestra varias clases de diseño condicional de proteínas y caracteriza experimentalmente las estructuras y funciones diseñadas. | Los experimentos solo respaldan las dianas, muestras y condiciones evaluadas en el estudio original. | Diseño de novo de la estructura y la función de proteínas con RFdiffusionResumen; tareas de diseño y caracterización |
| Recuperación de secuencias sobre esqueletos nativos y diversas pruebas experimentales de diseños. | La recuperación de secuencias no es una condición suficiente para una función nueva. | Diseño robusto de secuencias de proteínas basado en aprendizaje profundo mediante ProteinMPNNResultados y conclusión |
Preguntas de investigación que merece la pena someter a prueba
- Con un presupuesto fijo, ¿la diversidad entre familias aumenta la producción de familias funcionales independientes?
- ¿Puede transferirse entre generadores la calibración de la autoconsistencia computacional en objetivos nuevos?
- ¿Qué etapas de fallo justifican más mediciones adicionales en lugar de seguir aumentando el muestreo?
Correspondencia entre fuentes primarias y afirmaciones
- De novo design of protein structure and function with RFdiffusionWatson et al. · 2023-07-11Abstract; conditional backbone generation, experimental characterization and limitations.
- Robust deep learning–based protein sequence design using ProteinMPNNDauparas et al. · 2022-09-15Abstract and Results; native sequence recovery is distinct from folding and functional validation.
- Accurate structure prediction of biomolecular interactions with AlphaFold 3Abramson et al. · 2024-05-08Nature 2024; diffusion module and limitations
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación documentada y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a los equipos de investigación originales; los cálculos de este artículo solo comprueban las ecuaciones indicadas y los supuestos explícitos. Este sitio aún no dispone de registros de revisión por pares independiente de este artículo ni de modelos originales o experimentos clínicos o físicos originales vinculados a él.
Primera publicación: especial en profundidad sobre IA y descubrimiento científico; se conservan las fuentes de cada sección y los límites entre la evidencia de las investigaciones originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se elaboraron con el código y los archivos numéricos adjuntos; sus leyendas especifican, punto por punto, los supuestos y las bases de medición.
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Python · Código para reproducir los cálculos · Historial de publicación y versiones
Revisión de la fuente: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c