
要旨
生成的タンパク質設計は、「配列を与えて構造を予測する」ことから「制約を与えて配列と構造を提案する」ことへと進展しつつある。しかし、設計が成功するには、骨格が制約を満たし、配列が骨格と適合し、試料が得られ、立体配座が正しく、機能が測定可能であるという、複数の異なる段階を通過しなければならない。本稿はRFdiffusionとProteinMPNNを中心に、条件付き確率と完全な脱落記録を中核とする評価枠組みを構築する。設計ファネル、候補間の相関、失敗が観測されない試験の統計的上限を導出し、自己整合的な予測、配列回復、実際の機能が自動的に等価になるわけではないことを示す。本稿の計算図は予算分析であり、当サイトが実施した新規タンパク質設計や実験の結果ではない。[1] De novo design of protein structure and function with R[2] Robust deep learning–based protein sequence design usin
原文英語要旨の日本語訳
タンパク質設計は逆問題であり、その成功には、幾何学的生成から配列の適合性、発現、測定された機能へと至る連鎖が必要である。本稿ではRFdiffusionとProteinMPNNを総合的に論じ、自己整合性と独立した検証を区別する。条件付きファネルと相関のあるライブラリーの計算によって、生成候補が多数存在することが、独立した実験機会が多数存在することと同じではない理由を示す。完全な脱落集計と直交的な機能評価項目を備えた、予算を揃えた前向き評価を提案する。
1. 逆問題に唯一の正解はない
タンパク質の機能制約は、多くの場合、複数の配列や立体配座を許容する。逆設計の課題は天然配列を復元することではなく、実行可能集合の中から目標を達成できる候補を見いだすことである。RFdiffusionはさまざまな設計条件のもとで骨格のノイズ除去を行い、ProteinMPNNは与えられた骨格を条件として配列を生成する。両者は隣接するが異なる問題を解いている。したがって、ある段階の確率やスコアを、設計連鎖全体の成功率と解釈することはできない。本稿では、まず目標を測定可能な評価項目と許容誤差として記述し、次に保持すべきモチーフ、変更可能な領域、後続のスクリーニング基準を区別することを推奨する。これにより、生成後に、候補がたまたま得意とする内容へ課題が事後的に書き換えられることを防ぐ。[1] De novo design of protein structure and function with R[2] Robust deep learning–based protein sequence design usin
2. 生成モデルが学習するのは分布と条件であり、物理定理ではない
RFdiffusionは構造予測ネットワークをノイズ除去課題に適応させ、結合タンパク質や対称的集合体を含む設計能力を示した。条件付けの仕組みにより、研究者は局所的な幾何制約を生成過程に組み込めるが、モデルは依然として学習に用いた構造と課題設定に制約される。制約の充足は、エネルギー地形、折りたたみ動態、溶液中の挙動を保証しない。ここでの主要な方法論的問題は制約の強さである。制約が弱すぎると、候補は機能に必要な幾何から逸脱する可能性があり、強すぎると、互いによく似た極めて狭い設計ファミリーしか残らない可能性がある。評価では、最も洗練された単一の立体配座だけを示すのではなく、制約誤差と設計ファミリー数を併せて示すべきである。[1] De novo design of protein structure and function with R
3. 配列回復率が説明するのはモデルの整合性の一部である
ProteinMPNNは、原論文の天然骨格を用いた試験で比較的高い配列回復を報告し、さまざまな構造および集合体の実験によって設計を検証した。天然配列の回復率は、条件付きモデリング能力の一部を測定できるが、新たな機能の成功に対する十分条件にはならない。多くの異なる配列が類似した骨格を形成しうる一方、重要な部位の変更一つでも折りたたみや活性に影響する可能性があるためである。設計評価では、骨格、条件付き配列分布、保持した部位を併せて保存すべきである。構造予測器をフィルターとして用いる場合には、同じバイアスに由来する一致を独立した支持と見なさないよう、予測器と生成器の学習上の関連も記録する必要がある。[2] Robust deep learning–based protein sequence design usin[1] De novo design of protein structure and function with R
4. 本稿の導出:成功ファネルの分母は生成段階から数えなければならない
骨格の合格、配列の合格、試料の入手可能性、機能の合格を連続する四段階とし、各段階の確率は、それ以前の段階を通過したことを条件とする。連鎖全体の成功率はこれらの条件付き確率の積であり、各段階の周辺独立性を追加で仮定する必要はない。構成した例では、順に0.8、0.6、0.5、0.2とすると、初期候補1000件に対し、機能合格数の期待値は48件となる。最後の240試料だけを分母にして数えると20%と報告されるが、これは初期候補を基準とする4.8%とは異なる問いに答えている。図では二つの分母を並べ、スクリーニング効率と全工程を通じた収率の違いを読者が識別できるようにする。作者分析与复核建议 / Author analysis
5. 本稿の分析:配列の多様性をファイル数で代替することはできない
候補群が同じ骨格、接触様式、主要な配列特徴を共有している場合、その成否は強く相関する可能性がある。本稿では、等相関の平均推定における有効サンプルサイズを、予算上の注意喚起として用いる。相関係数を0.2とした構成条件では、100件の候補が平均の精度に寄与する程度は、独立標本約4.81件に相当するにすぎない。この式は、設計の二値的な成否を厳密に記述するものではなく、ファミリーの類似度を相関係数と直接同一視するものでもない。骨格、配列、界面に基づく共同クラスタリングを行い、ファミリーをまたぐ成功率を報告すべきことを示唆している。多様性は、結果を示す際の付加的な形容詞にとどめず、候補選択の目的に組み込むべきである。作者分析与复核建议 / Author analysis
6. 自己整合性に基づく構造フィルタリングをどう用いるべきか
生成後に構造予測器で配列が目標骨格へ戻るかを確認することは、有用で低コストなフィルタリング工程である。RFdiffusionとProteinMPNNに関連する研究は、計算によるスクリーニングと実験的な特性評価を組み合わせている。その限界は、予測器が生成器と構造上の選好を共有する可能性や、一部の無秩序状態、凝集状態、誤ったオリゴマー状態を見落とす可能性にある。このため本稿は、自己整合性を計算エビデンスの一項目として明示し、外部の構造・機能エビデンスを別に登録することを提唱する。同じフィルターに対して何千回も最適化した後には、凍結したスクリーニング規則の対象となる候補の外でも転移能力を検証すべきであり、学習による適応後の高スコアを、まったく新しい発見と見なすことはできない。[1] De novo design of protein structure and function with R[2] Robust deep learning–based protein sequence design usin[3] Accurate structure prediction of biomolecular interacti
7. 本稿の導出:失敗が観測されなくても区間は必要である
試行が独立同分布であるという仮定のもとで、n回の試行である種類の失敗が一度も観測されなかった場合、片側95%上限は1−0.05^(1/n)である。n=30でも上限はなお約9.50%であり、n=300では約0.994%となる。したがって、「すべて合格した」という記述には、標本数、独立性、評価項目の定義を併記しなければならない。設計ライブラリー内のファミリー相関は、独立性の仮定をさらに弱める。実験バッチと設計ファミリーごとに結果を報告し、発現失敗、不純な試料、測定不能な対象を残すことで、これらを削除した後に失敗なしと宣言することを避けるよう推奨する。この導出が扱うのは統計上の集計基準のみであり、公表済みモデルの失敗率を推定するものではない。作者分析与复核建议 / Author analysis
8. 構造的ヒットと機能的ヒットには異なる対照が必要である
設計タンパク質は、期待した形状を形成しても目標機能を欠くことがあり、複数の立体配座をとりながら特定の機能を示すこともある。設計が成功した理由を理解するには、骨格を保持したまま重要な局所条件を変更した候補を比較するなど、幾何と機構をそれぞれ検証できる対照を設け、試料の状態を独立に記録すべきである。個別の研究では、他の標的に対する選択性やバッチ間の再現性も検討する必要がある。本稿はこれらを、未実施の実験結果ではなく、研究計画上の要件として提示する。「モデルがたまたま安定なタンパク質を生成した」ことと「モデルが指定された機能を満たした」ことを対照によって区別できて初めて、設計の物語は信頼できる科学的説明となる。作者分析与复核建议 / Author analysis
9. 予算を揃えた、より厳密な評価
異なるパイプラインに同一の生成予算と同一の後続検証予算を割り当て、目標集合、許容される調整回数、停止規則を事前に固定することを提案する。主要評価項目は、実験予算の単位当たりに得られる独立した機能ファミリー数とし、すべての初期候補から算出した成功率を補助的に用いる。比較には単純なベースラインに加え、骨格のみを変更する条件、配列のみを変更する条件、完全な閉ループといったアブレーションを含め、失敗原因を階層的に記録すべきである。ある手法が最終段階のヒット率を高めても、前段のスクリーニング費用を大幅に増やす場合、結論では費用と成果を同時に示すべきであり、厳選された試料における高い割合だけから普遍的な優位性を主張してはならない。作者分析与复核建议 / Author analysis
技術補足 A · 構造のノイズ除去における座標対称性
タンパク質骨格座標の全体的な回転と並進は、その物理的同一性を変えないため、生成過程ではこれらの対称性を適切に扱わなければならない。座標ノイズ、局所座標系、条件付けに用いるモチーフを結び付けることで、モデルは幾何制約下で多様な骨格を探索できる。ただし、一部の位置を固定することも実行可能集合を変化させる。本稿では、同じ入力に剛体変換を施し、逆変換後の出力分布が対応する関係を保つか確認するとともに、モチーフ誤差、結合幾何、全体的な折りたたみを分けて扱うことを推奨する。この試験は実装と表現の検証に属し、タンパク質が発現するか、可溶であるか、機能をもつかという外部測定の代わりにはならない。[1] De novo design of protein structure and function with R
技術補足 B · 条件付き配列確率のデコード順序
骨格が与えられたとき、配列分布は、位置のさまざまな順序に従って条件付き確率の積へ分解できる。自己回帰的デコードを用いる場合、先に選択された位置が後続の候補に影響する。温度と反復サンプリングが変えるのは探索方法であり、最終的な実験分布が自動的に変わるわけではない。対称的集合体では等価な位置を結び付けることがあり、これは自由度を減らすとともに有効な多様性も変える。本稿では、デコード順序、固定残基、対称性に基づく結び付け、温度、シードを併せて記録し、最終配列と構造ファミリーに基づいて重複を除去することを推奨する。平均配列確率を一つ公表するだけでは、候補間の相関や機能差を説明できない。[2] Robust deep learning–based protein sequence design usin
技術補足 C · サンプリングの継続より情報価値が重要である
ある設計ファミリーで試料を得られない事態が繰り返されている場合、同じファミリーからのサンプリングを続けても、類似した失敗を増やすだけかもしれない。本稿では、まだ区別されていない失敗機構を次の測定対象とすることを提案する。例えば、まず制約が骨格の安定性、試料の状態、機能に必要な幾何のいずれにあるかを判断し、その後で変更すべき段階を決める。この考え方は、単にモデルスコアが最高のものを選ぶのではなく、条件付き情報利得として記述できる。評価では、測定が後続候補の分布をどのように変えたかを記録し、事前登録した目標に基づいて純粋なサンプリングとフィードバック戦略を比較すべきである。実際のフィードバック実験がない場合、計画を提案することはできても、能動学習が実際のヒットを改善したと主張してはならない。作者分析与复核建议 / Author analysis
技術補足 D · ファミリー内の成功から標的間の転移へ
一つの標的に対して互いに近い成功候補が複数得られたことは、その局所的な設計空間に実行可能解が存在することを示す。一方、新しい標的への転移には、異なる表面、幾何、測定条件でも有効であることが求められる。本稿では、標的を外側、設計ファミリーを中間、候補を内側とする階層でデータを整理し、三階層の変動をそれぞれ報告することを推奨する。標的数が少ない場合、候補総数を用いて標的間の極めて狭い区間を提示することはできない。予算の整合も標的単位で行い、ある手法が容易な標的だけに多くの資源を投入することを避けるべきである。これにより、設計プラットフォームの能力と、単一の成功例に対する精緻な最適化とを明確に区別できる。作者分析与复核建议 / Author analysis
10. 検証可能な設計成果には何を含めるべきか
最も価値のある公開パッケージは、最良の構造だけを提供するものではなく、目標仕様、生成条件、候補ファミリー、スクリーニング台帳、試料の同一性、機能評価項目を結び付けるものである。本稿の数式と図表は、設計効率を検査可能な分母の関係として記述するものであり、原論文の実験結果は引き続き原研究チームに帰属する。その後の再現研究では、原設定との差異を保存し、陰性結果を正確な候補とバージョンに紐付けられるようにすべきである。こうして設計プラットフォームは、成功例を繰り返し示すものから、知識を蓄積できる工学・科学システムへと移行できる。読者は、何がすでに測定されているのかに加え、次の最も情報量の多い実験がどの問いに答えるべきかも理解できる。作者分析与复核建议 / Author analysis
主要な数式と導出
(1) 骨格x、配列s、制約cに関するパイプラインの分解。これはモデリングの整理形式であり、物理的・機能的な成立を保証するものではない。
LaTeX
p(x,s\mid c)=p_\theta(x\mid c)\,p_\phi(s\mid x,c)(2) 骨格、配列、試料、機能の合格にそれぞれ対応する四段階の条件付き連鎖。周辺独立性は必要ない。
LaTeX
P(F)=P(B)P(S\mid B)P(E\mid S,B)P(F\mid E,S,B)(3) 等分散・等相関の標本平均に対する有効サンプルサイズ。相関をもつ設計ライブラリーに対する解析的な注意喚起に用いるものであり、実際の成否への当てはめではない。
LaTeX
n_{\mathrm{eff}}=\frac{n}{1+(n-1)\rho}(4) 独立同分布のn回の試行で失敗が観測されない場合の、片側95%の厳密な上限。相関のある標本には直接適用できない。
LaTeX
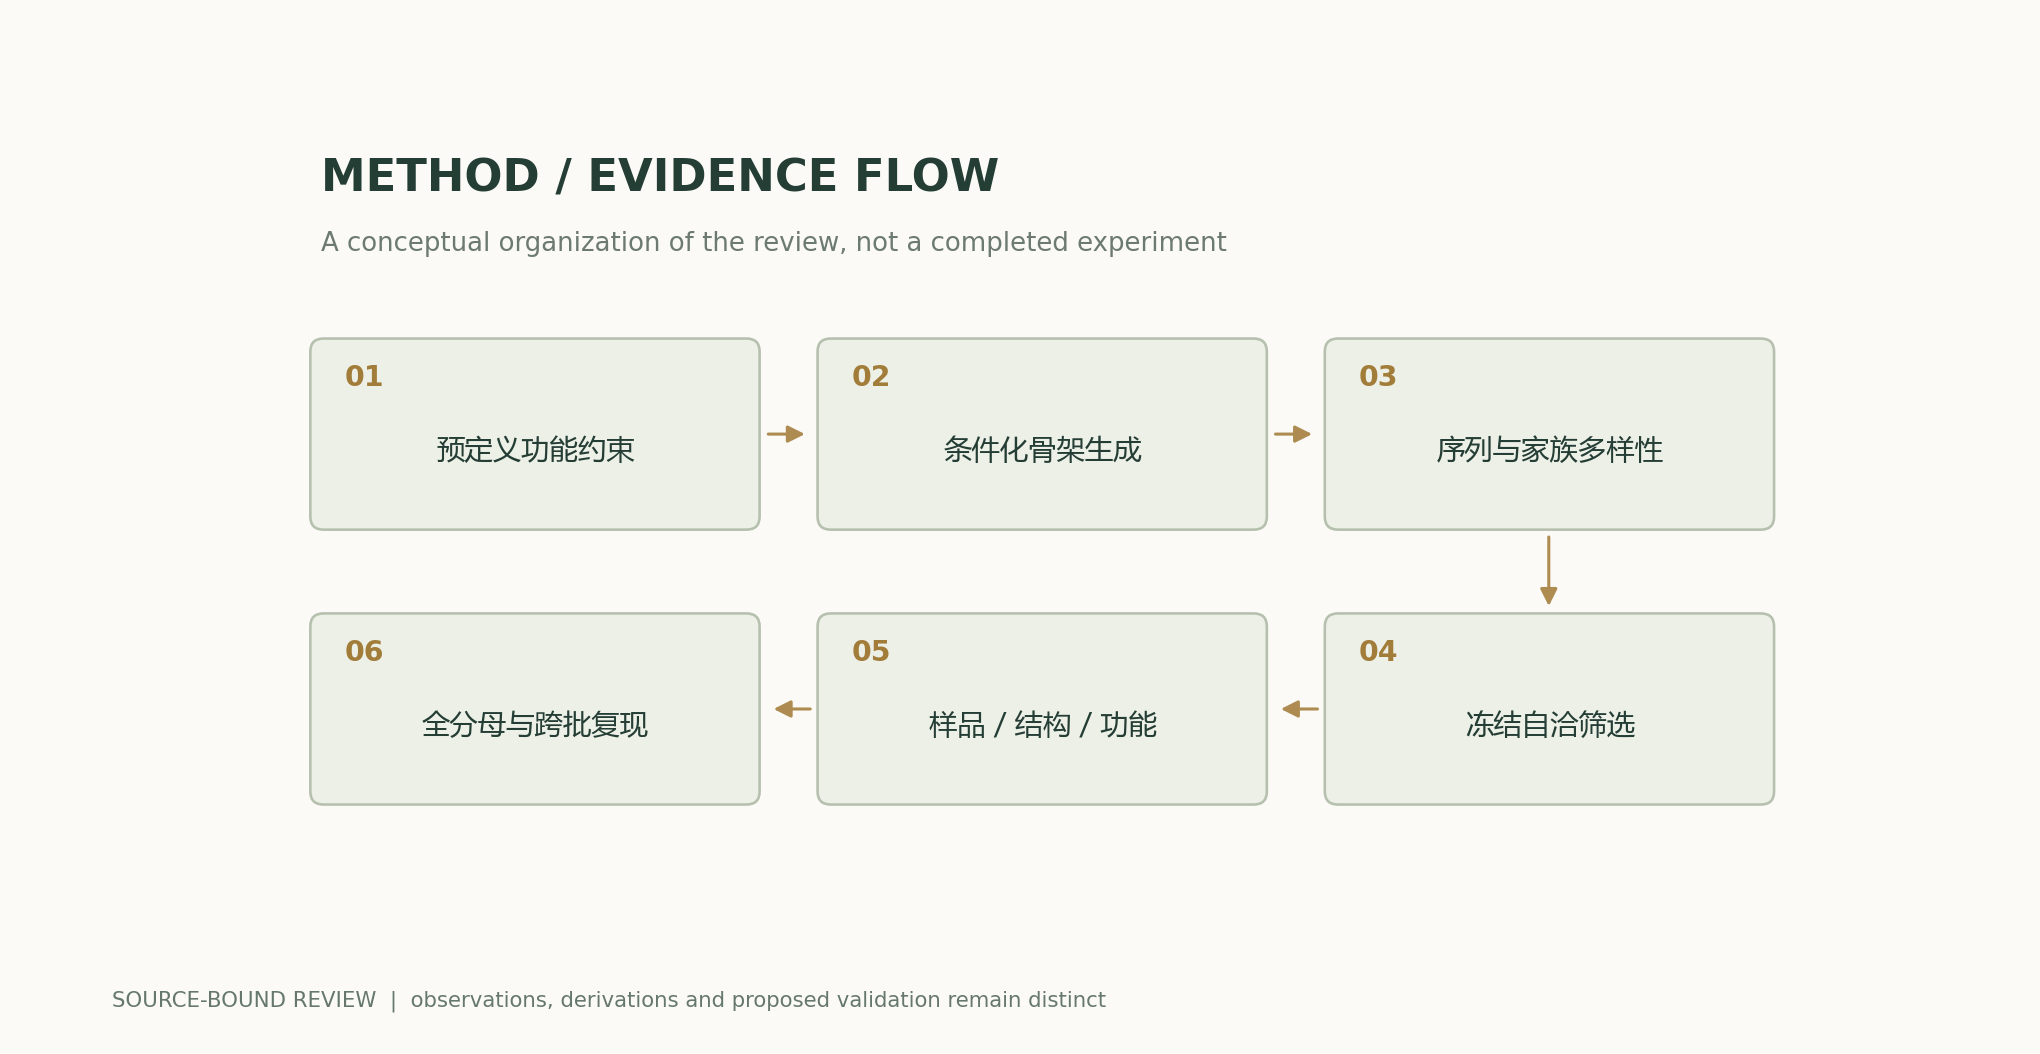
p_{\mathrm{failure,upper}}=1-0.05^{1/n}手法とエビデンスのフロー
解析図と数値例
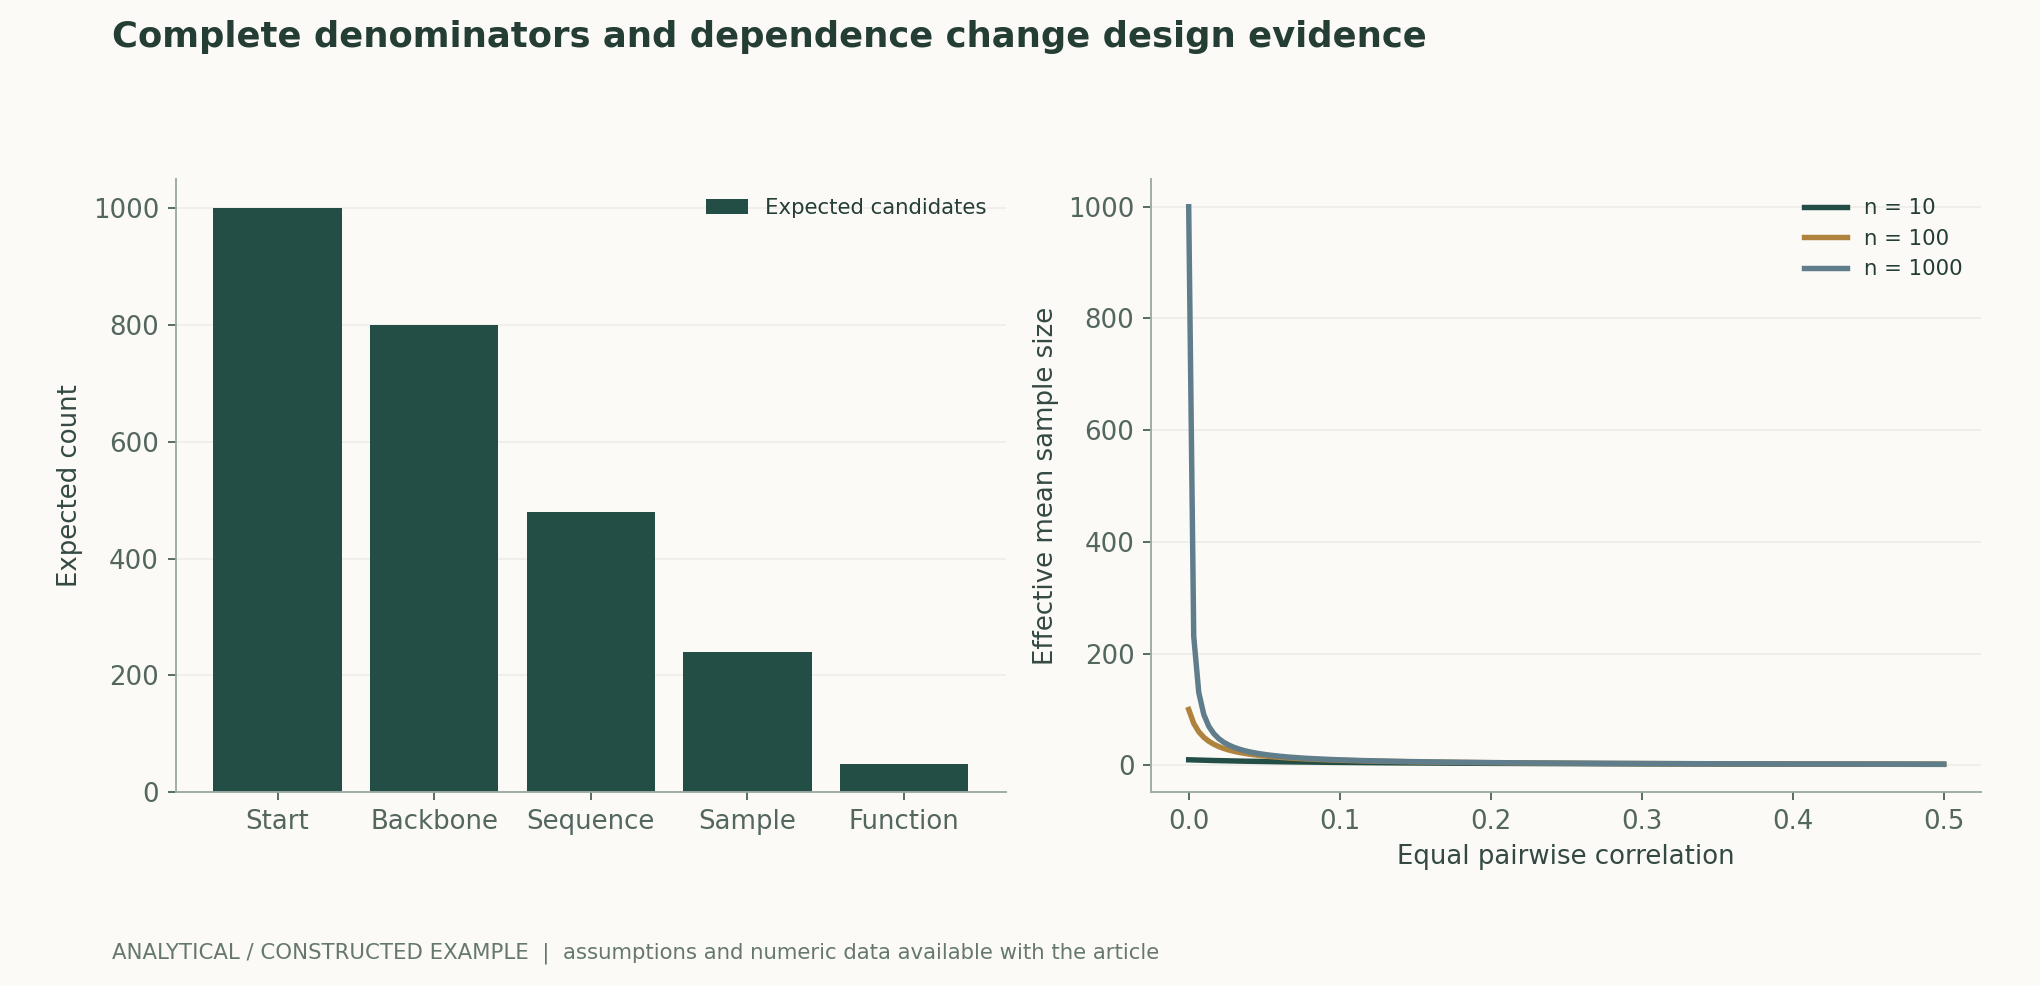
再計算可能な例題
1000×0.8×0.6×0.5×0.2=48であり、初期候補を基準とすると4.8%、最終試料を基準とすると20%となる。等相関の標本100件は、rho=0.2のとき、有効サンプルサイズが約4.80769となる。
手法の比較
| 成果の提供段階 | 測定可能なエビデンス | 保存すべき失敗と分母 |
|---|---|---|
| 制約付き骨格 | 幾何誤差と実行可能性 | 生成されたすべての骨格と無効な骨格 |
| 条件付き配列 | 固定位置、配列分布 | すべての骨格に対応する候補 |
| 自己整合的予測 | 目標構造への復帰と界面スコアリング | 予測器のバージョンとスクリーニングによる脱落 |
| 試料の取得 | 発現、純度、同一性 | 取得不能・測定不能な対象 |
| 機能的ヒット | 事前定義した評価項目と対照 | 試験に提出した全試料と独立したファミリー |
| 汎化と費用 | 新規標的、バッチ間評価、予算 | パラメータ調整回数、人手による介入、所要時間 |
検証および実験計画
- 目標、許容する幾何変化、主要な機能評価項目、候補スクリーニングの上限を事前登録する。
- モデルと条件付き生成の設定を固定し、骨格、配列、シード、概要を提供する。
- 候補を配列、骨格、接触幾何に基づいてクラスタリングし、各ファミリーの全メンバーを記録する。
- 異なる手法の生成予算と独立検証予算を揃え、単純なベースラインを保持する。
- 自己整合性フィルターと閾値を凍結し、各工程の脱落理由を記録する。
- 試料の取得不能と測定不能をいずれも対応する分母に含め、黙って削除しない。
- 構造と機能の評価項目を別々に確認し、バッチおよびファミリーごとに区間を提示する。
- 失敗と再現時の差異を公開する。未完了の検証は計画としてのみ登録し、機能設計の成果には数えない。
適用範囲と限界
- モデルの実行や新規タンパク質の調製は行っていない。
- ファネル内の確率は構成した入力値であり、RFdiffusionのヒット率を表すものではない。
- 有効サンプルサイズの式は等相関の平均の分析に適用されるものであり、配列類似性の法則ではない。
- 失敗が観測されない場合の上限には、独立同分布と固定された評価項目が必要である。
- 構造、発現、機能は、依然として個別の系と測定条件に制約される。
原研究のエビデンスと適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| 複数の種類の条件付きタンパク質設計を示し、設計された構造と機能を実験的に特性評価した。 | 実験が支持するのは、原研究で試験された標的、試料、条件のみである。 | RFdiffusionによるタンパク質構造と機能のde novo設計要旨、設計課題および特性評価 |
| 天然骨格における配列回復と、さまざまな実験による設計の検証。 | 配列回復は新しい機能の十分条件ではない。 | ProteinMPNNを用いた深層学習に基づく頑健なタンパク質配列設計結果と結論 |
検証に値する研究課題
- 固定予算のもとで、ファミリー間の多様性は独立した機能ファミリーの獲得数を増やすか。
- 新しい目標における計算的自己整合性の較正は、生成器をまたいで転移できるか。
- サンプリングをさらに増やすよりも、追加測定を行う価値が最も高い失敗段階はどこか。
一次資料と主張の対応
- De novo design of protein structure and function with RFdiffusionWatson et al. · 2023-07-11Abstract; conditional backbone generation, experimental characterization and limitations.
- Robust deep learning–based protein sequence design using ProteinMPNNDauparas et al. · 2022-09-15Abstract and Results; native sequence recovery is distinct from folding and functional validation.
- Accurate structure prediction of biomolecular interactions with AlphaFold 3Abramson et al. · 2024-05-08Nature 2024; diffusion module and limitations
引用と原稿のエクスポート
著者、バージョン、出典
Codex(AI)が執筆した、出典に基づく研究レビューおよび独自の解析である。原論文の実験は原研究チームに帰属し、本稿の計算は記載した数式と明示した仮定のみを検証する。当サイトには現時点で、本稿に関する独立した査読、または独自のモデル、臨床実験、物理実験の記録はない。
初出:AIと科学的発見の詳細特集。節ごとの出典を保持し、原研究のエビデンスと著者による解析の境界を明確にしている。
概念的な表紙画像はImageGenが生成した。科学図は付属のコードと数値ファイルを用いて作成し、図注では仮定と測定基準を項目ごとに説明している。
表紙と科学図の出典 · データ、出典、仮定 · Python · 再計算可能なコード · 公開・バージョン履歴
ソースの改訂版: b7b48f7205d705b2a3d3e8de0be5e1b458e4869c